Manage Data | CodeCut
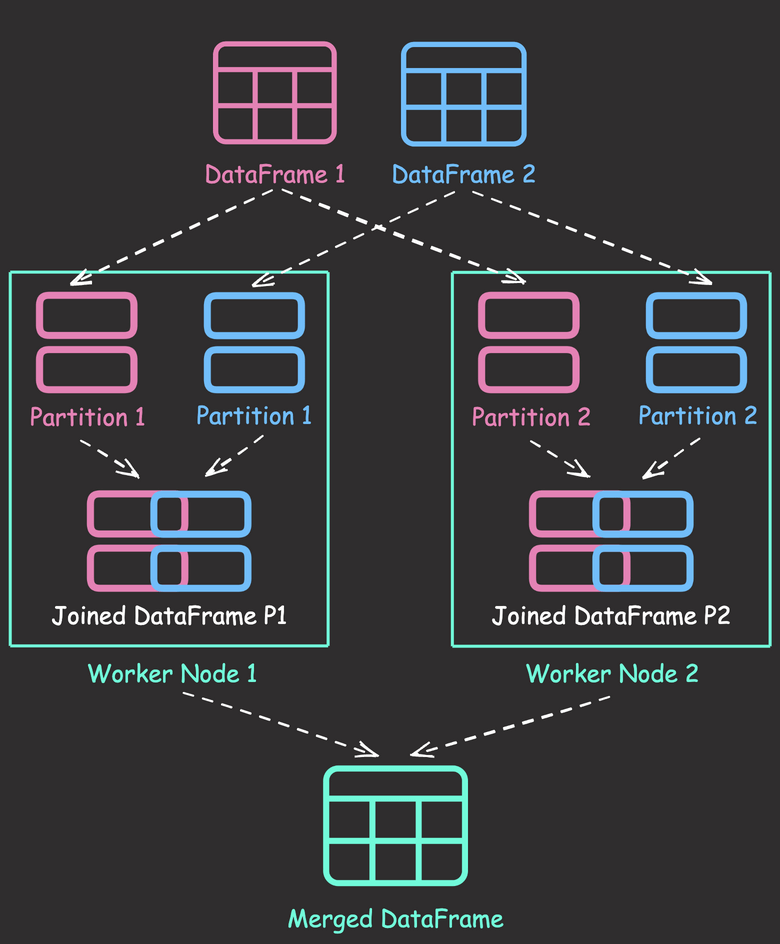
Distributed Data Joining with Shuffle Joins in PySpark | CodeCut
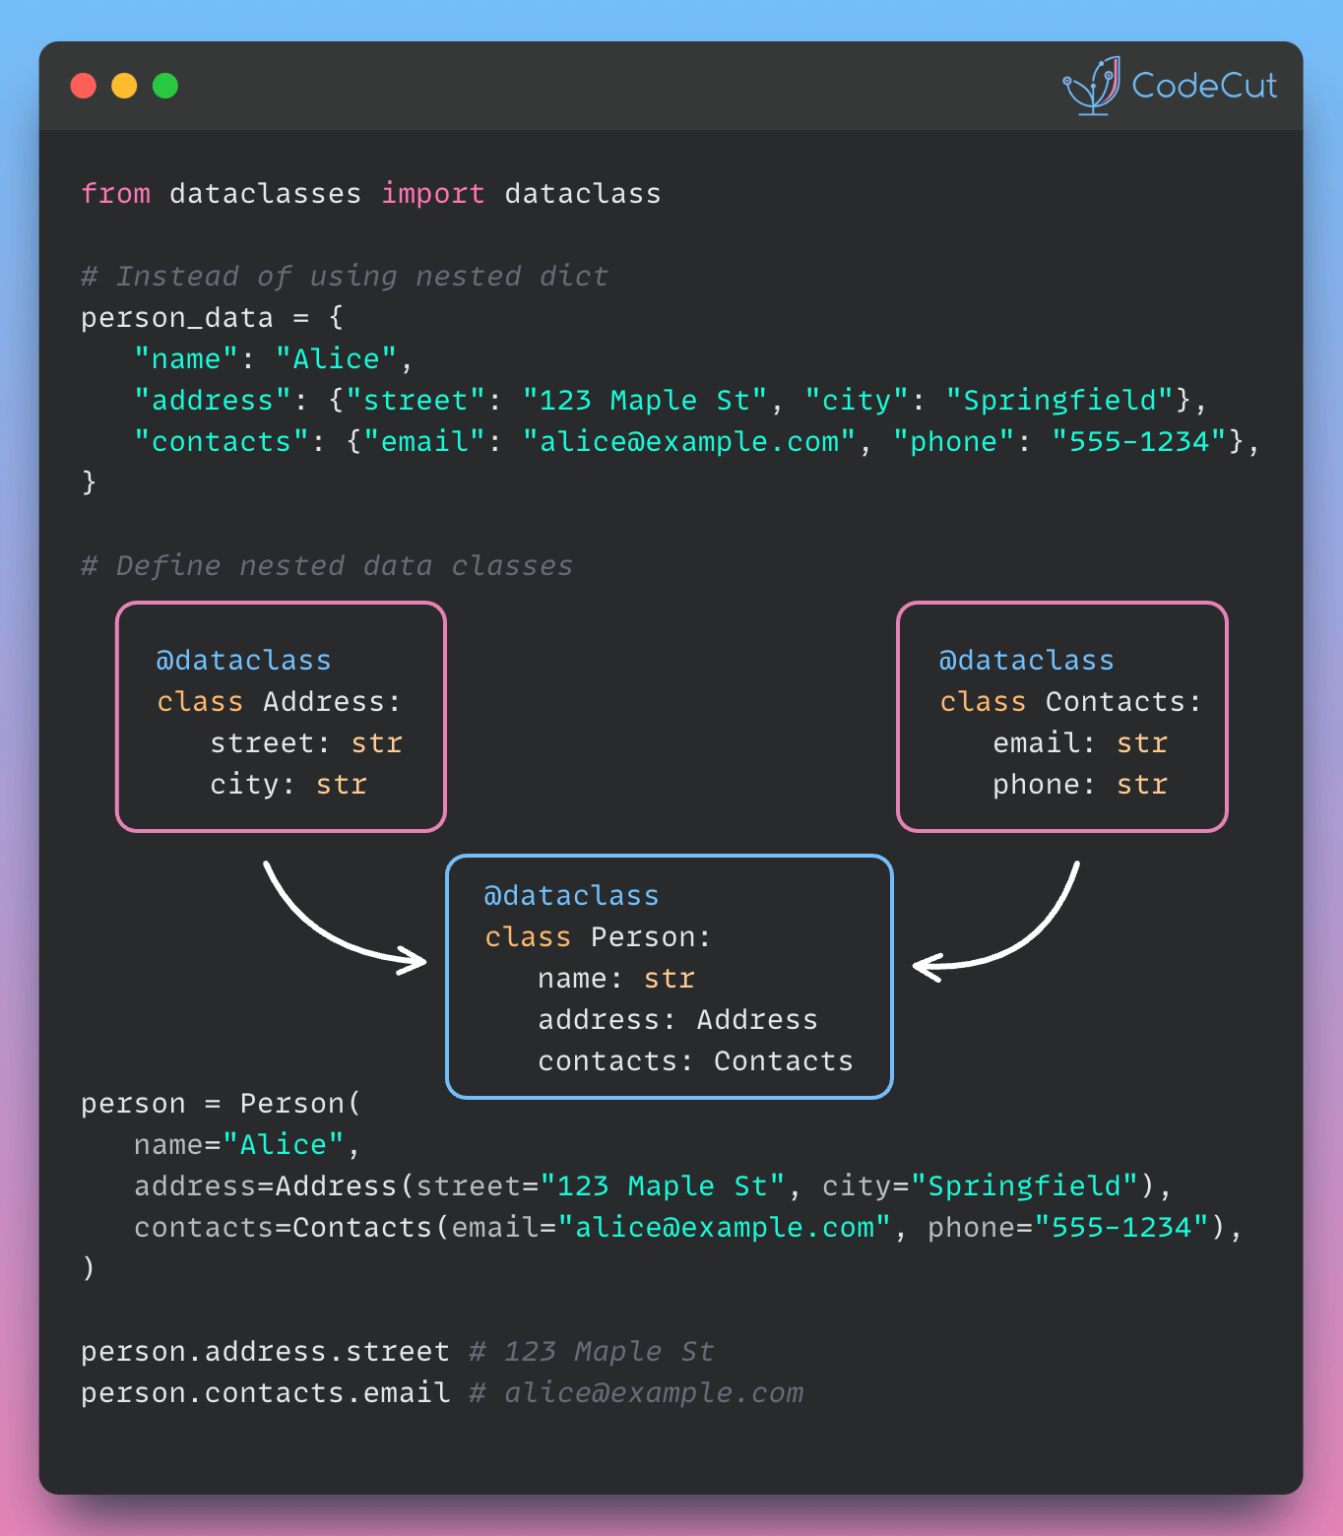
Simplify Nested Structures with Python Data Classes | CodeCut
Git for Data Scientists: Learn Git through Practical Examples | CodeCut
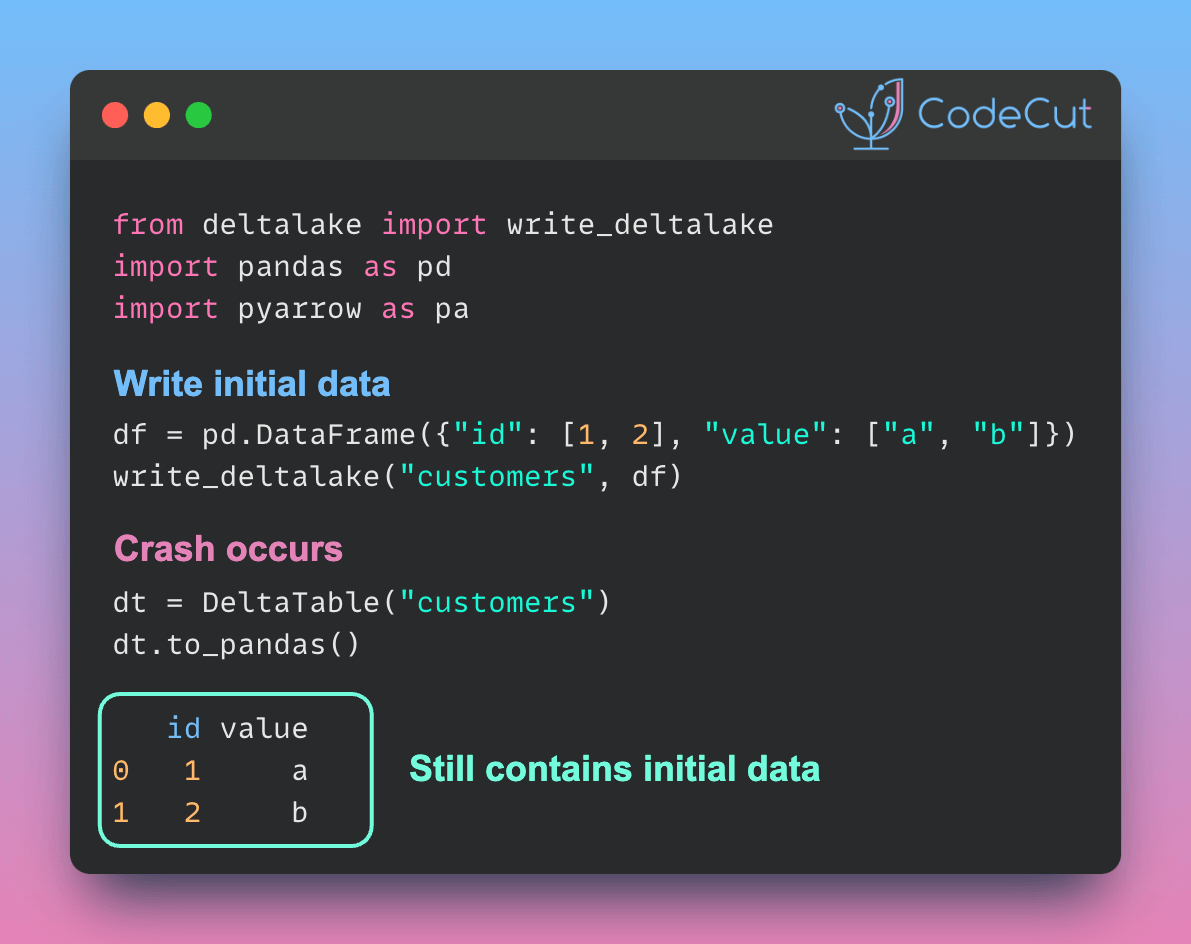
Building a High-Performance Data Stack with Polars and Delta Lake | CodeCut
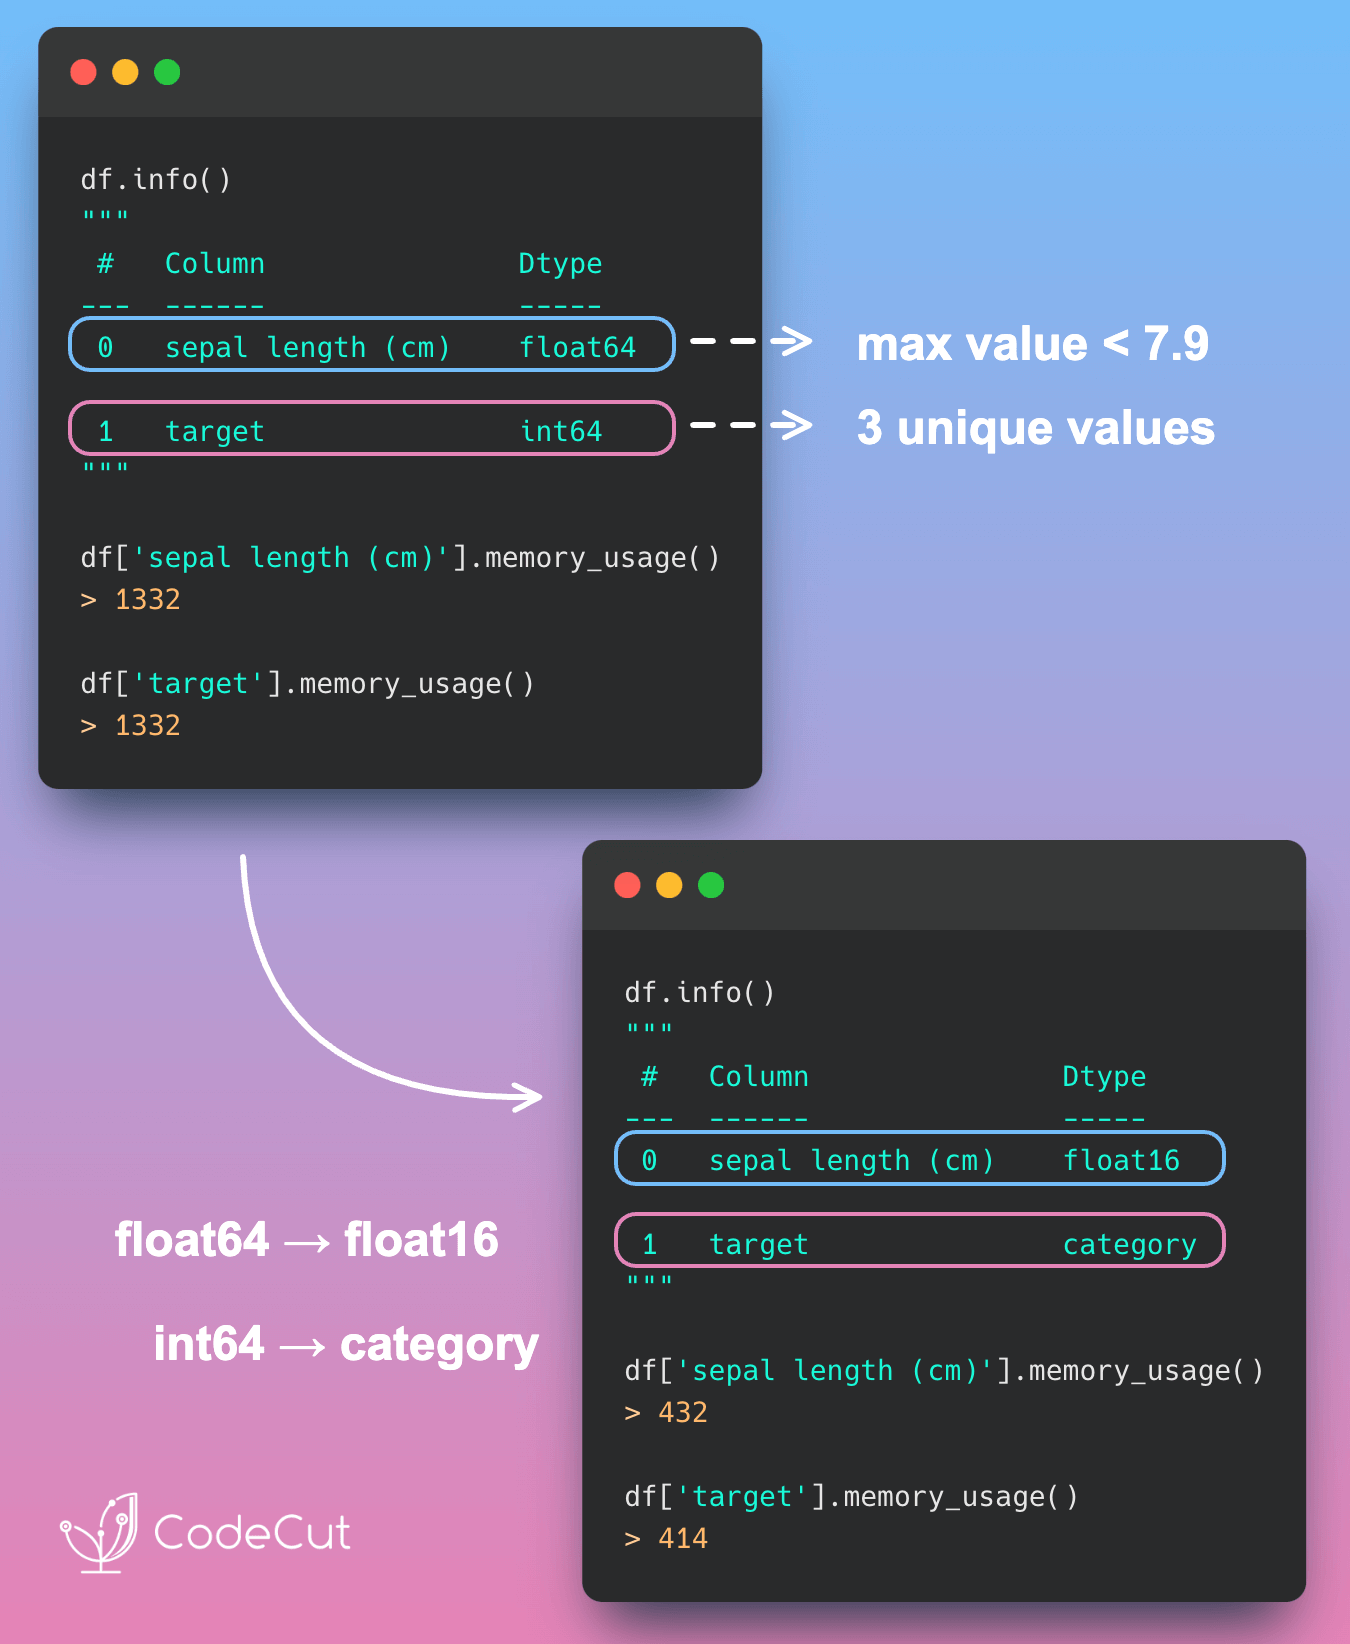
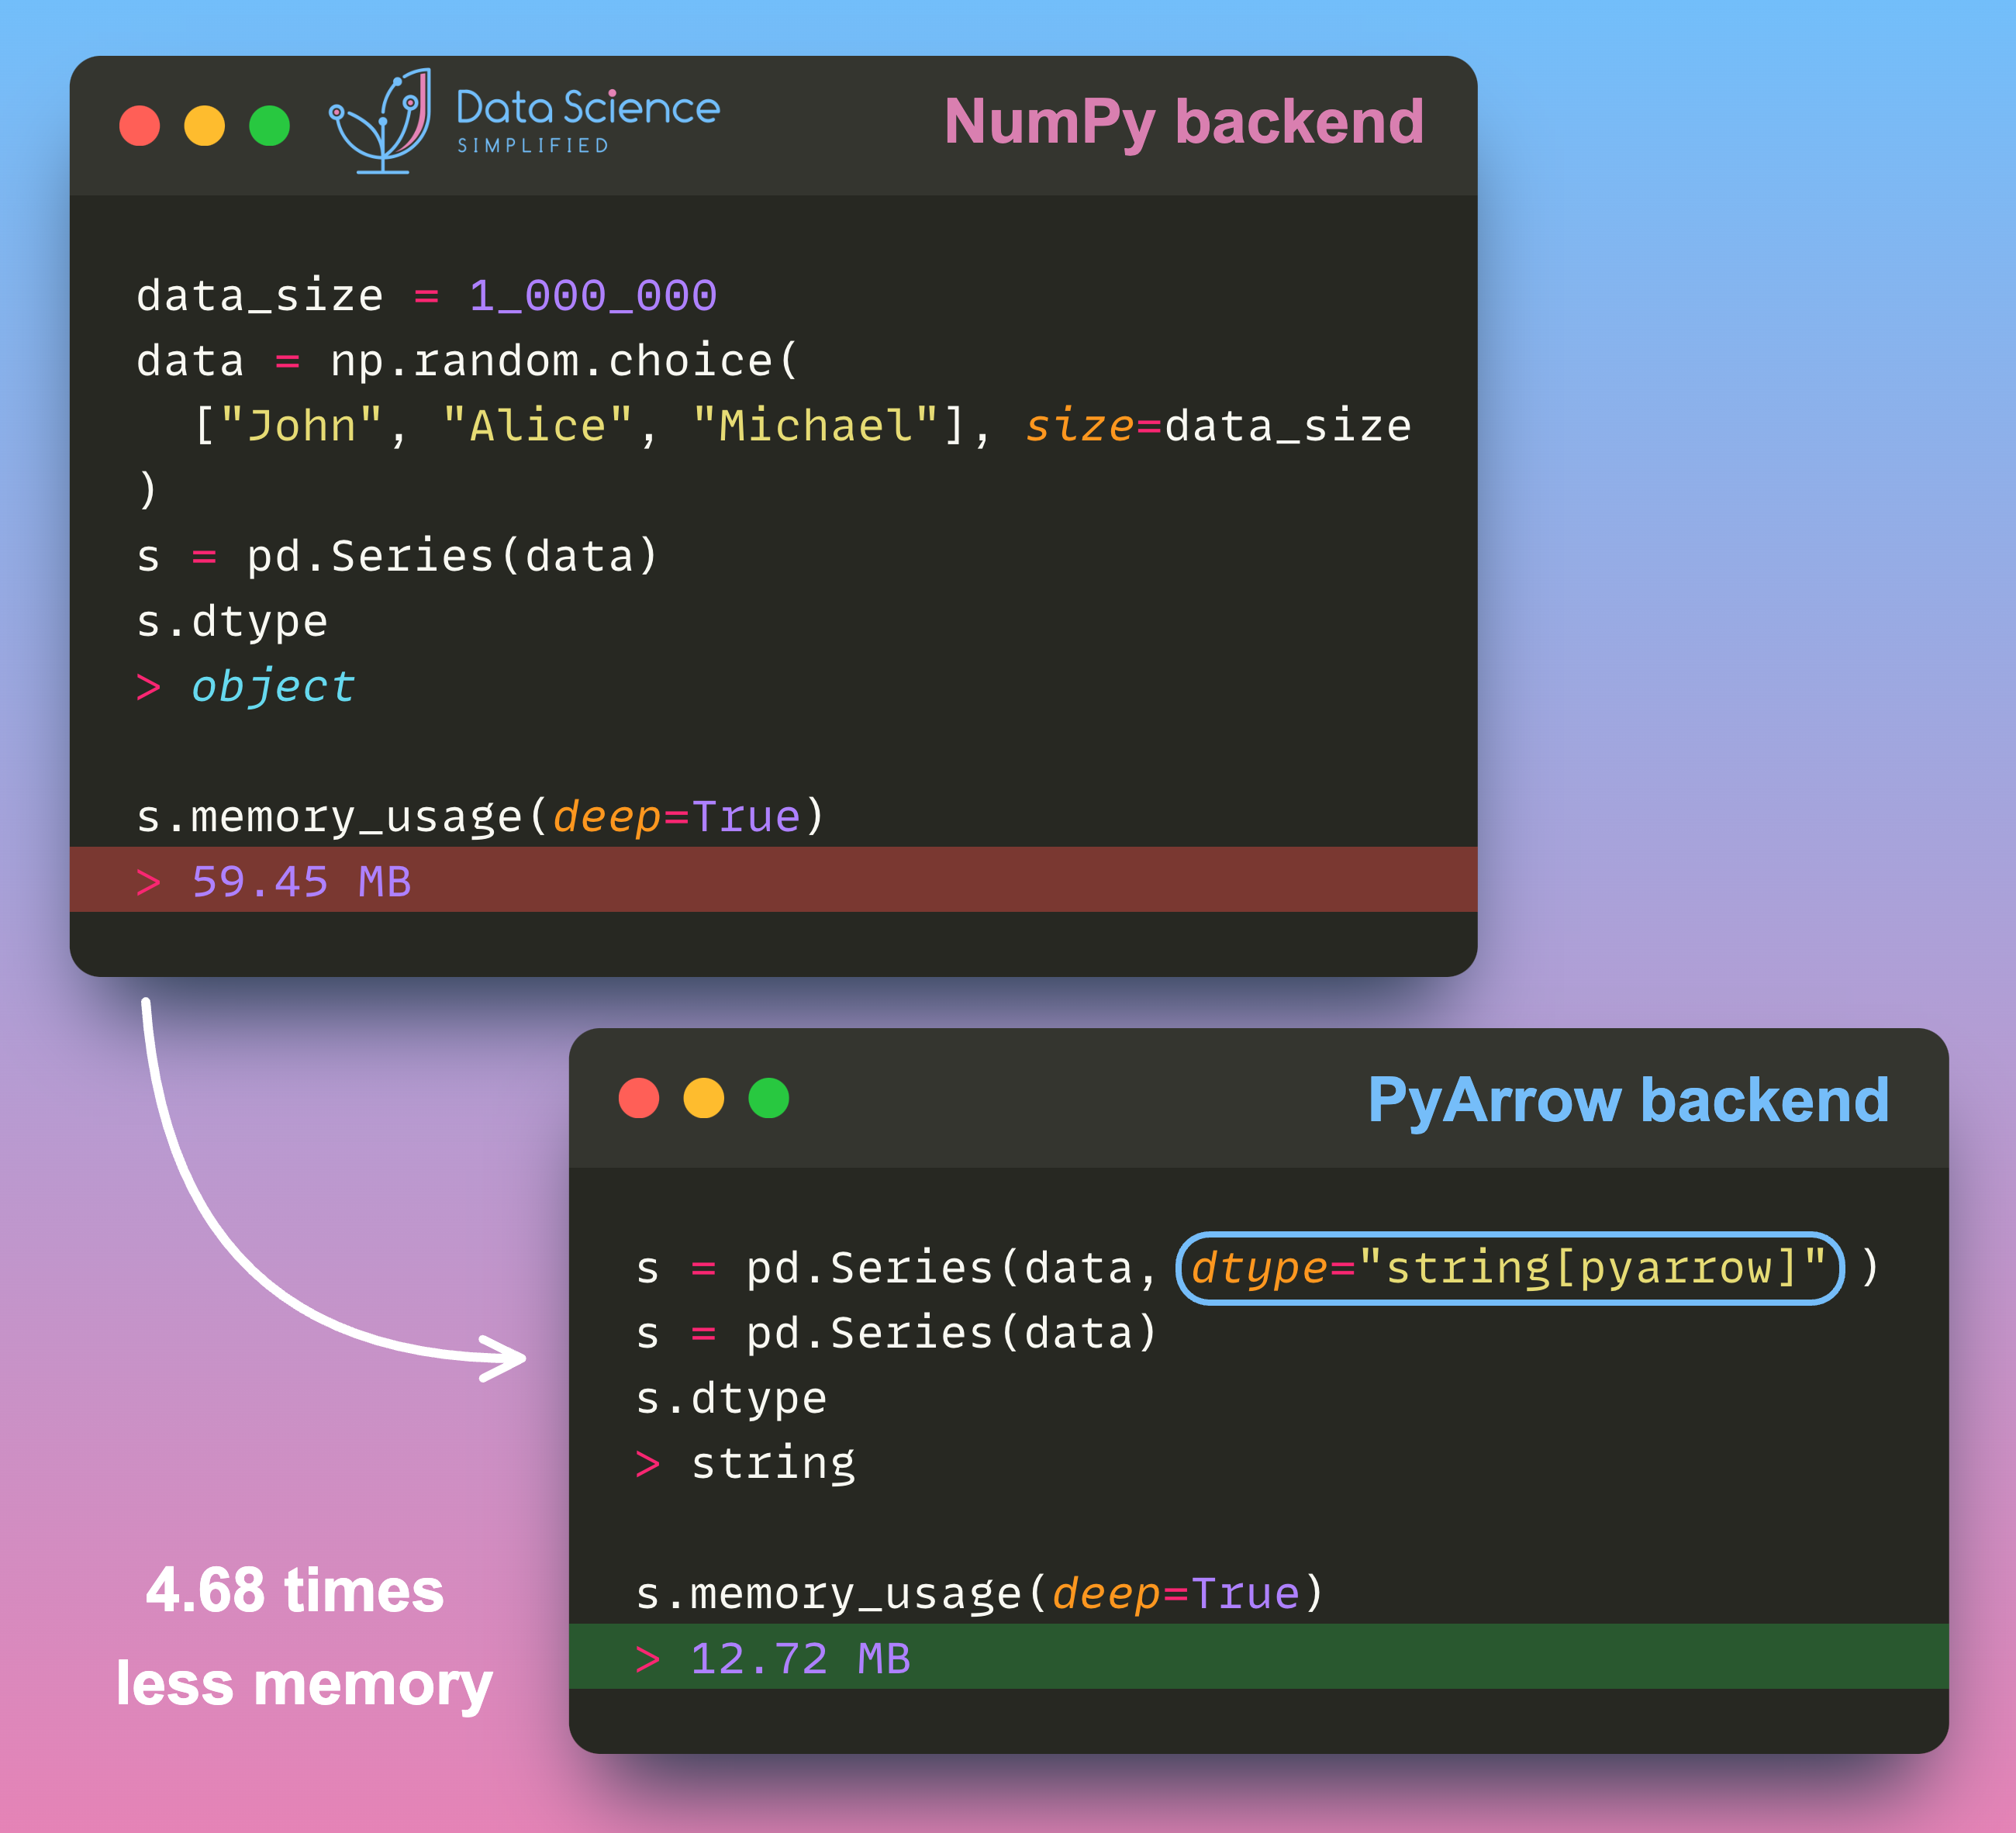
Smart Data Type Selection for Memory-Efficient Pandas | CodeCut
Simplify Data Validation with Pydantic | CodeCut
BertViz: Visualize Attention in Transformer Language Models | CodeCut
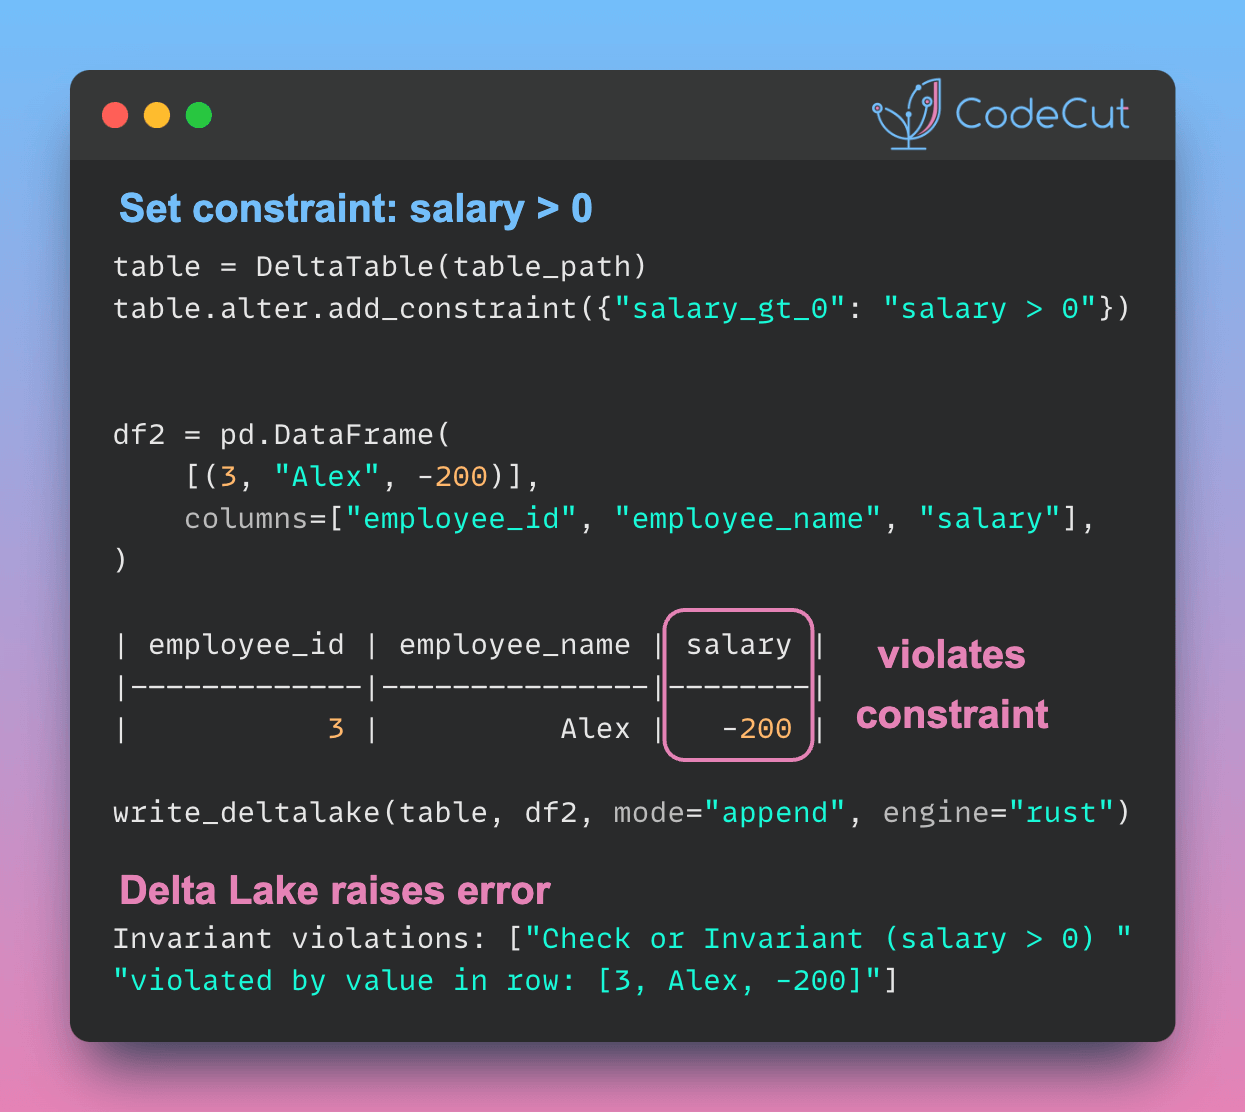
Ensure Pandas' Data Integrity with Delta Lake Constraints | CodeCut
Version Control for Data and Models Using DVC | CodeCut
Machine Learning | CodeCut
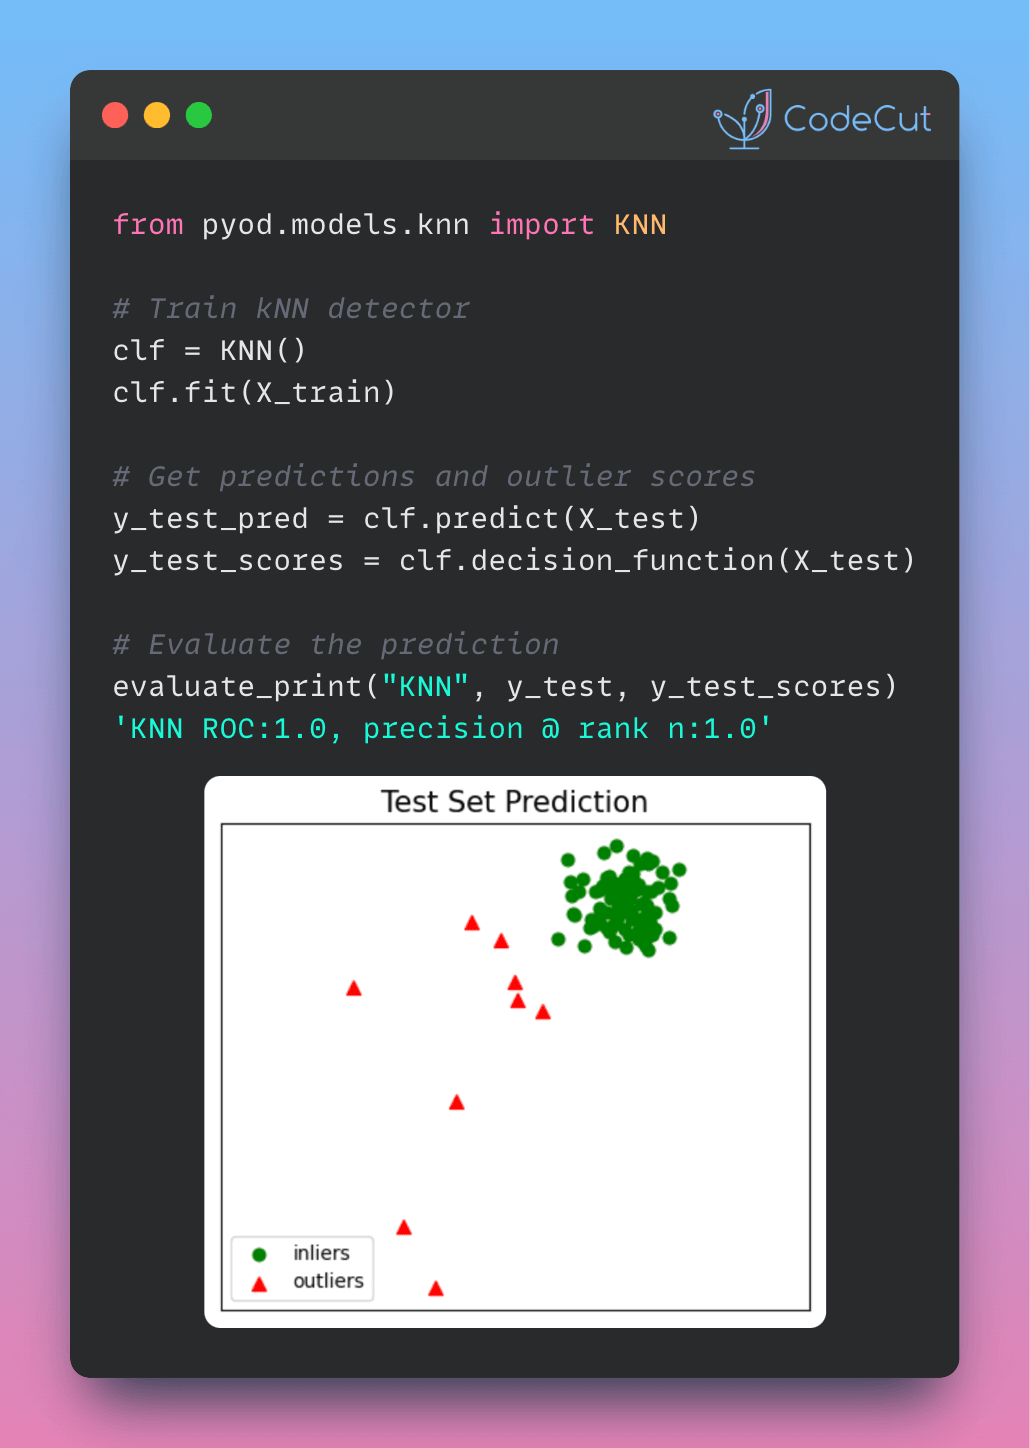
PyOD: Simplifying Outlier Detection in Python | CodeCut
kneed: Knee-Point Detection in Time Series | CodeCut
supertree: Interactive Decision Tree Visualization for Python | CodeCut
Visualization & Reporting | Page 4 of 7 | CodeCut
SDV: Use SDV to Generate Realistic Synthetic Datasets | CodeCut
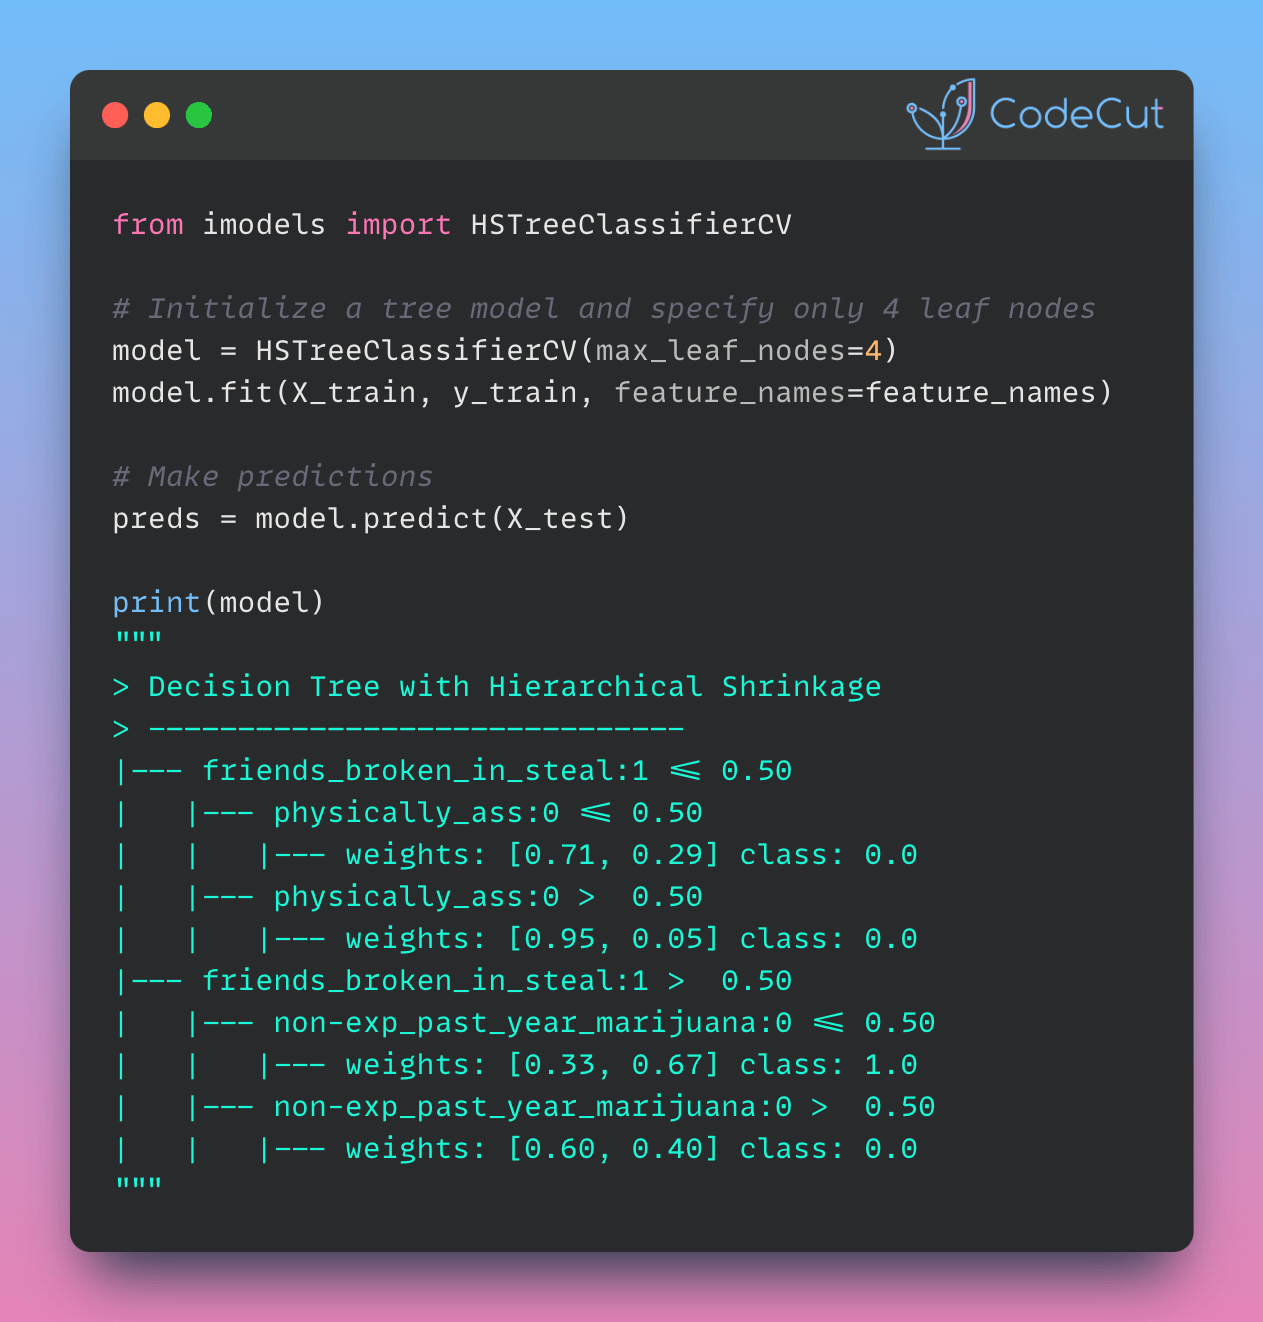
imodels: Simplifying Machine Learning with Interpretable Models | CodeCut
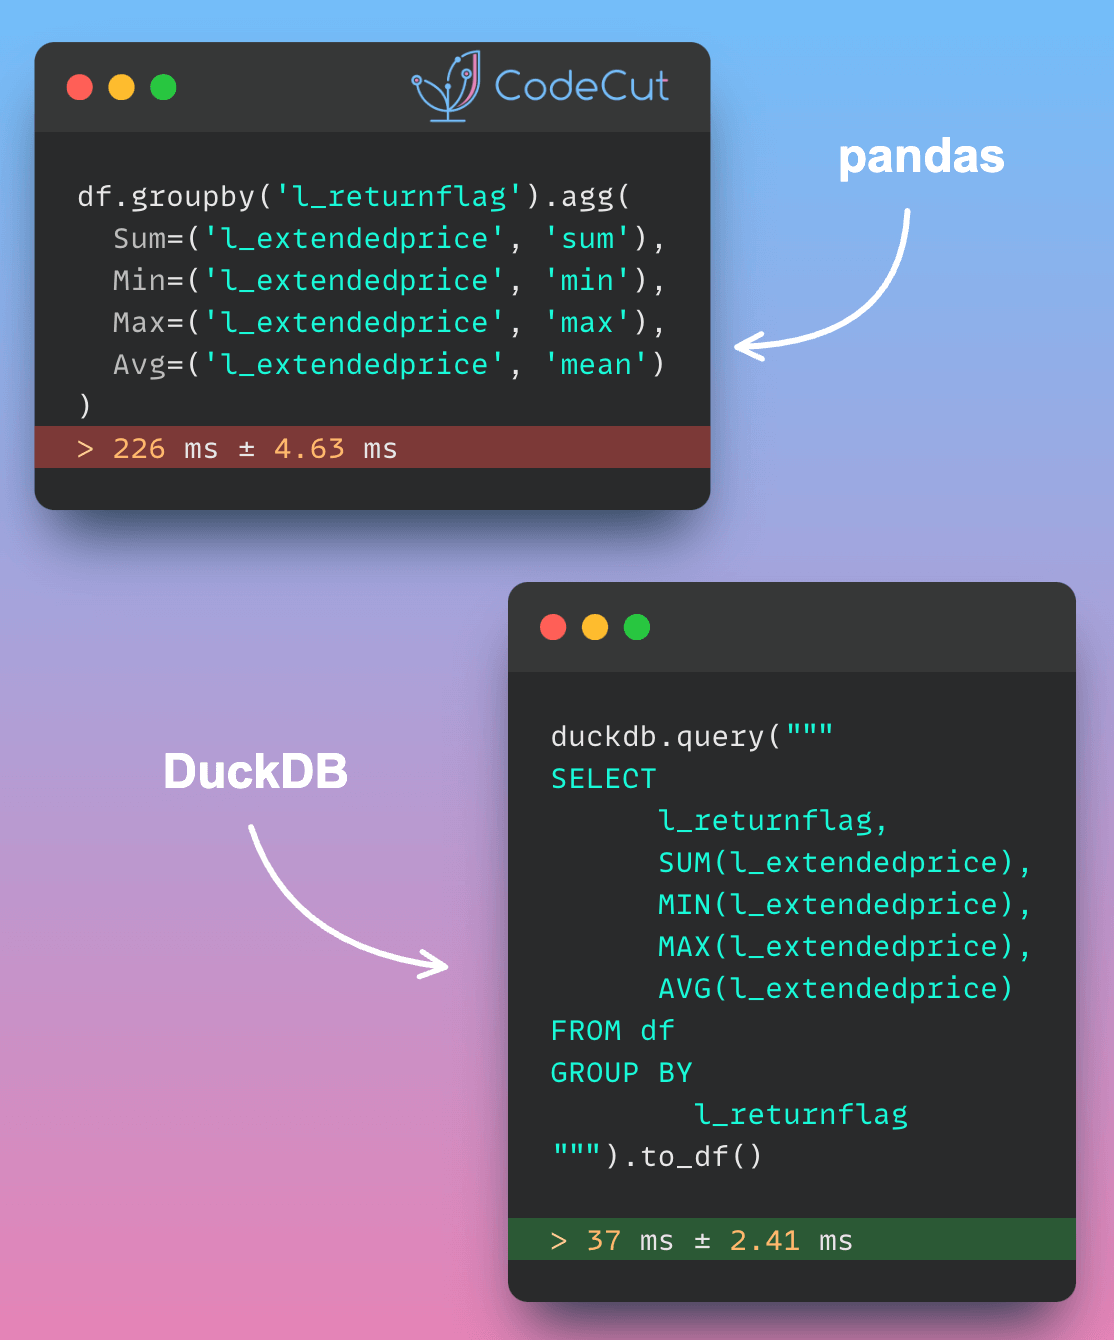
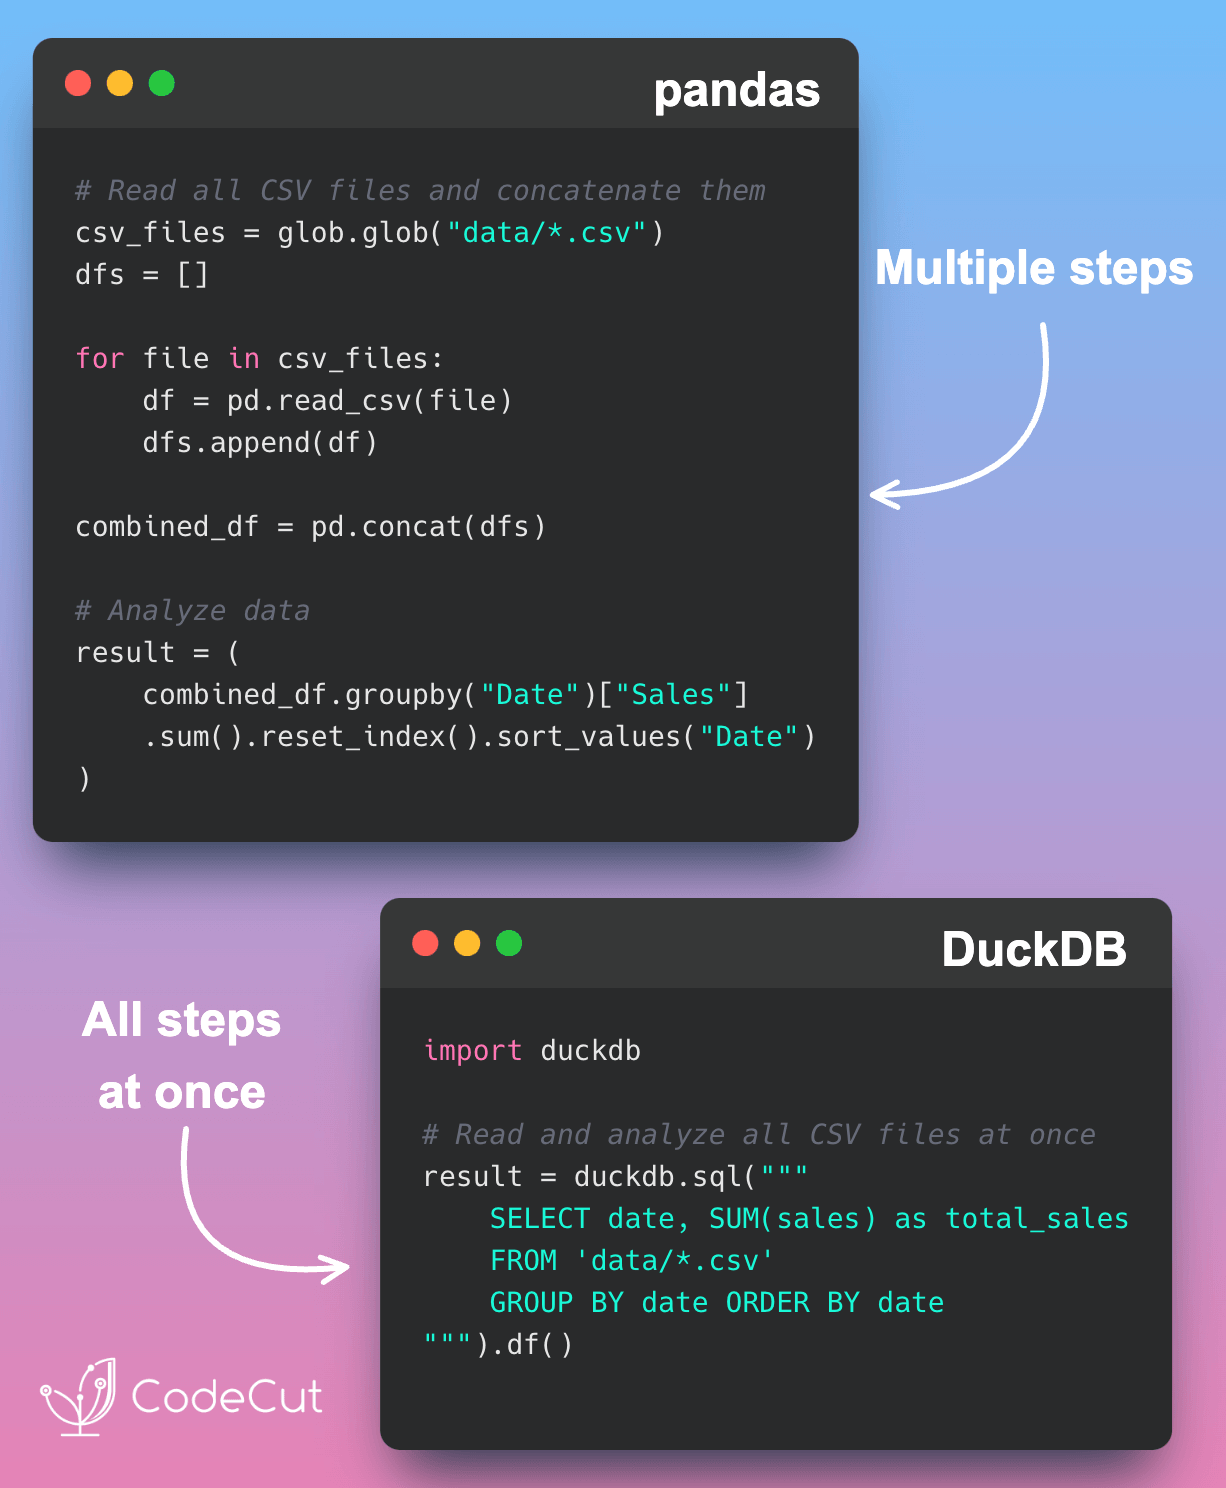
Accelerating Complex Calculations: From Pandas to DuckDB | CodeCut
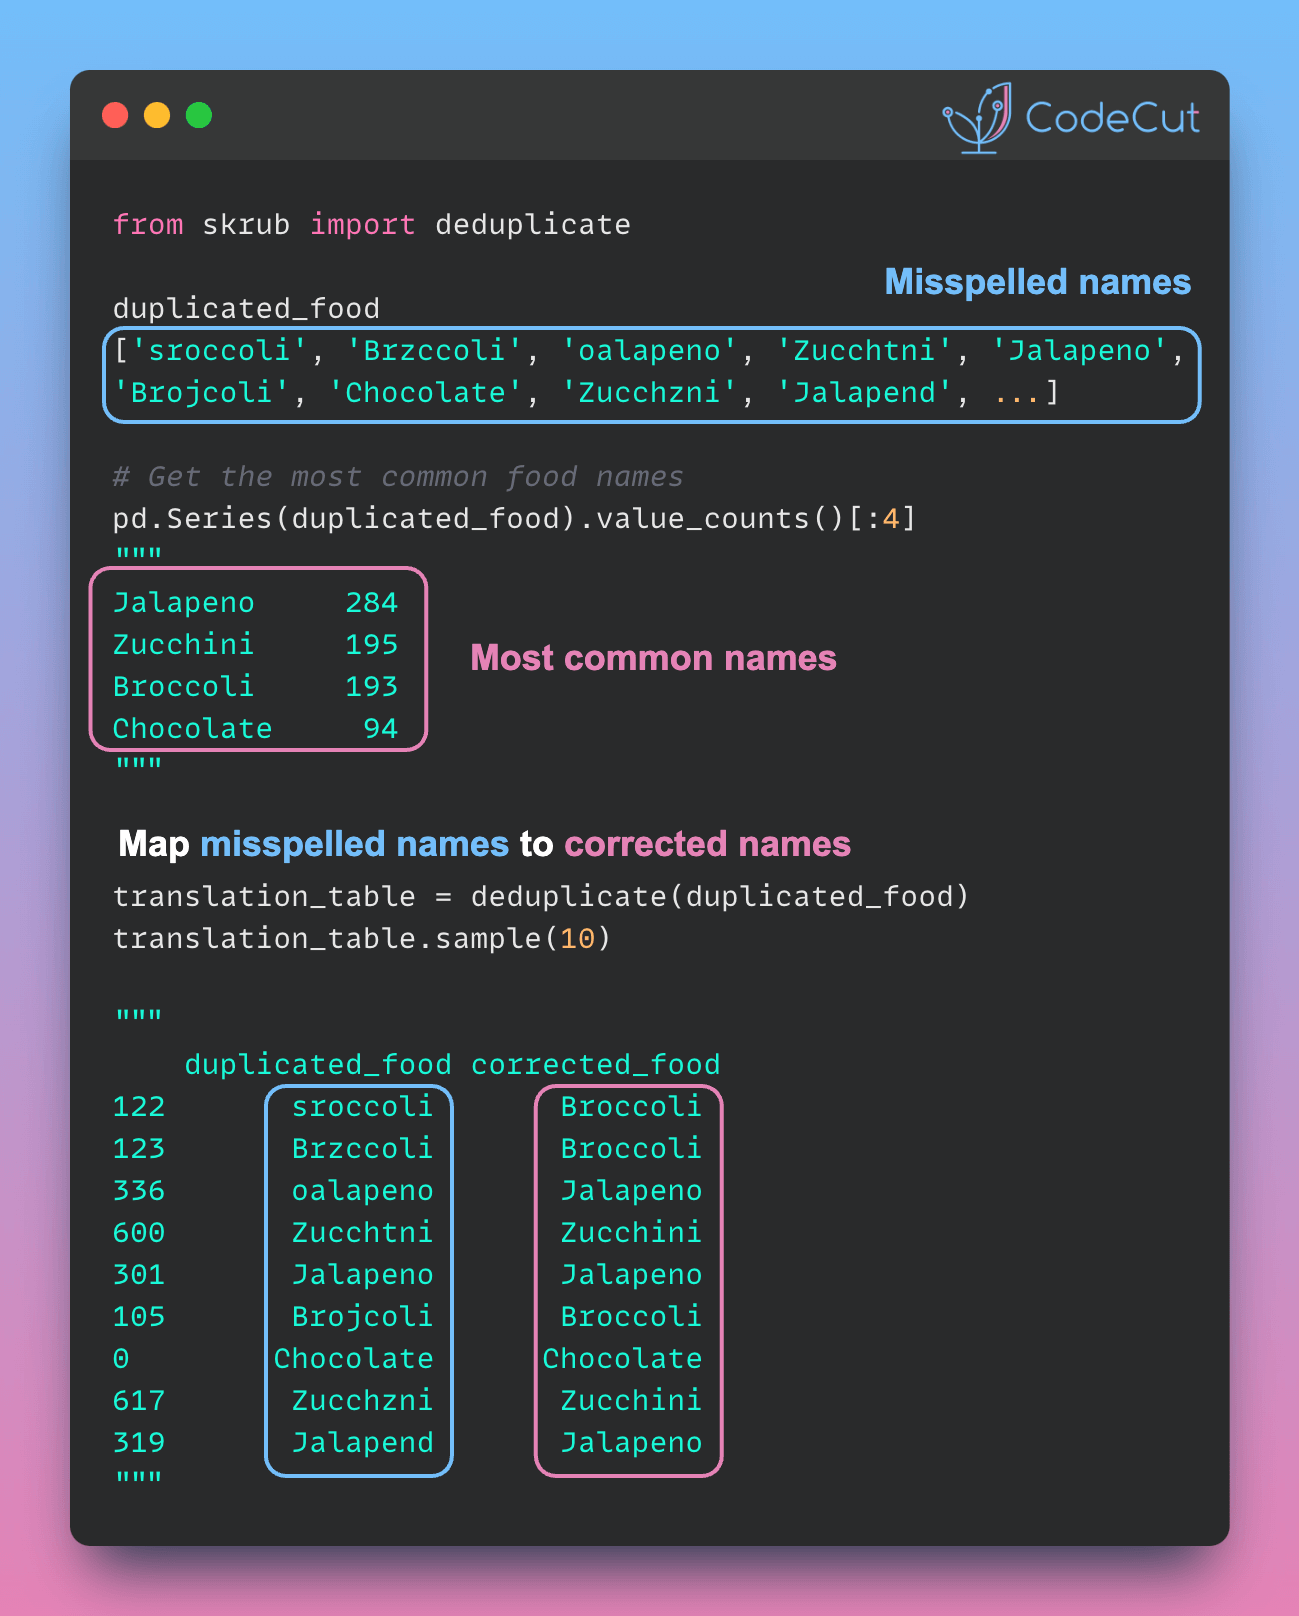
Automated Misspelling Correction in Datasets Using skrub | CodeCut
Markmap: Transform Markdown into Interactive Mind Maps | CodeCut
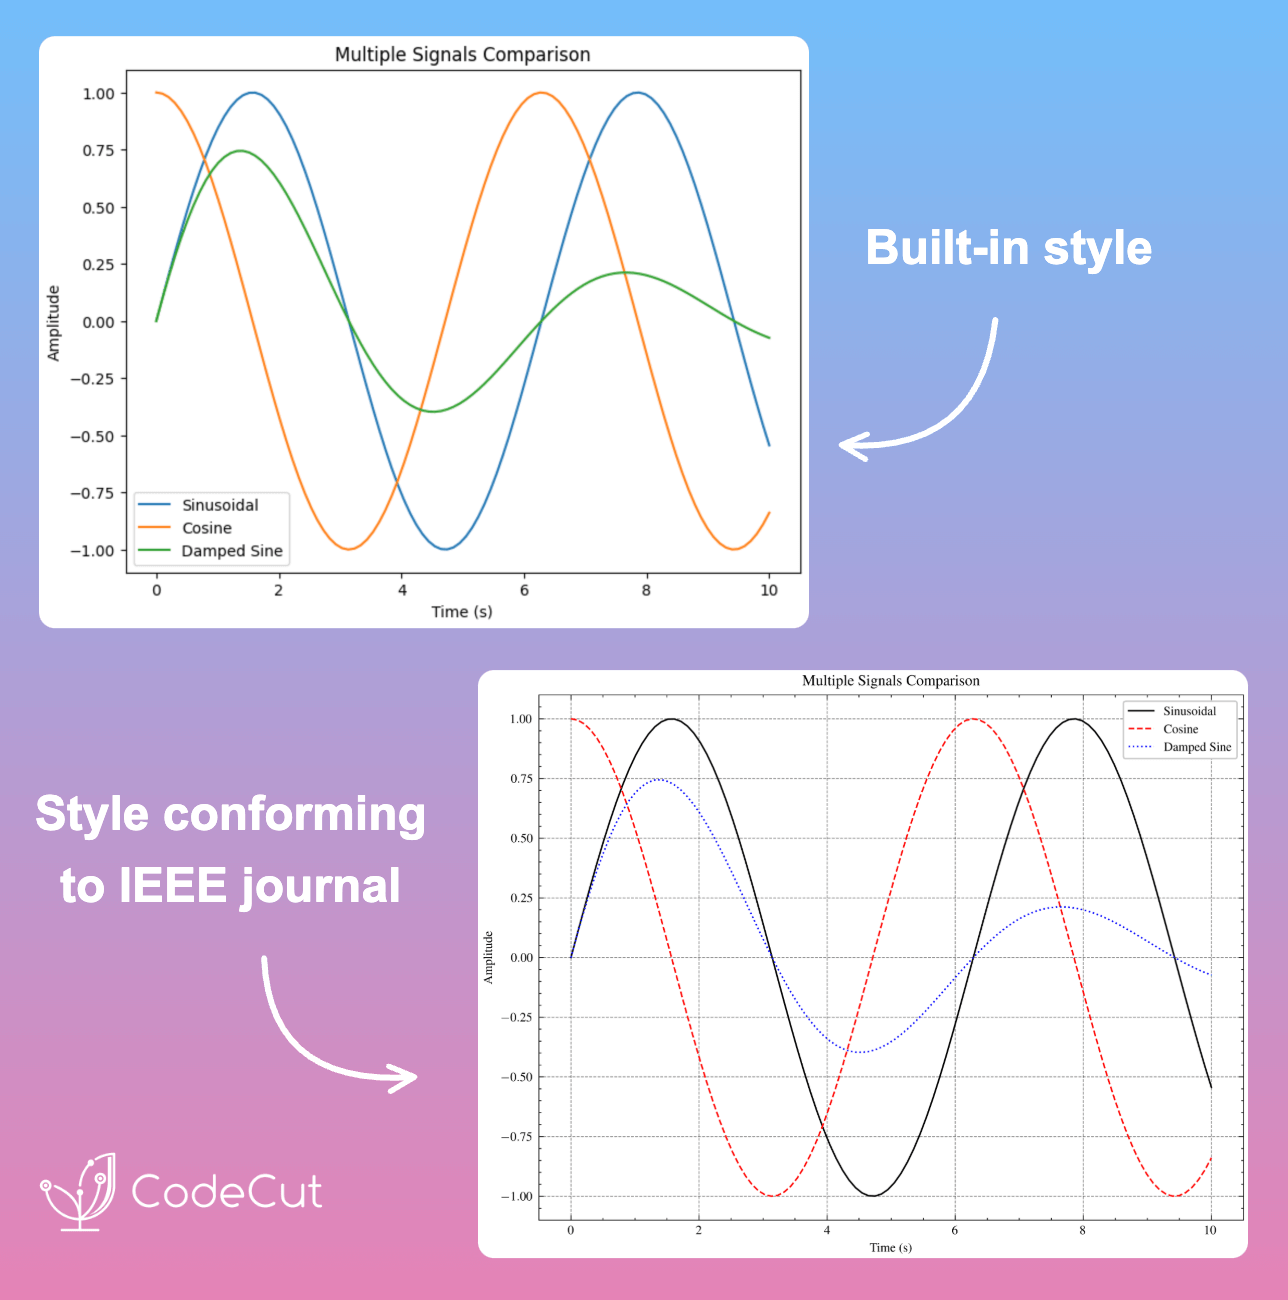
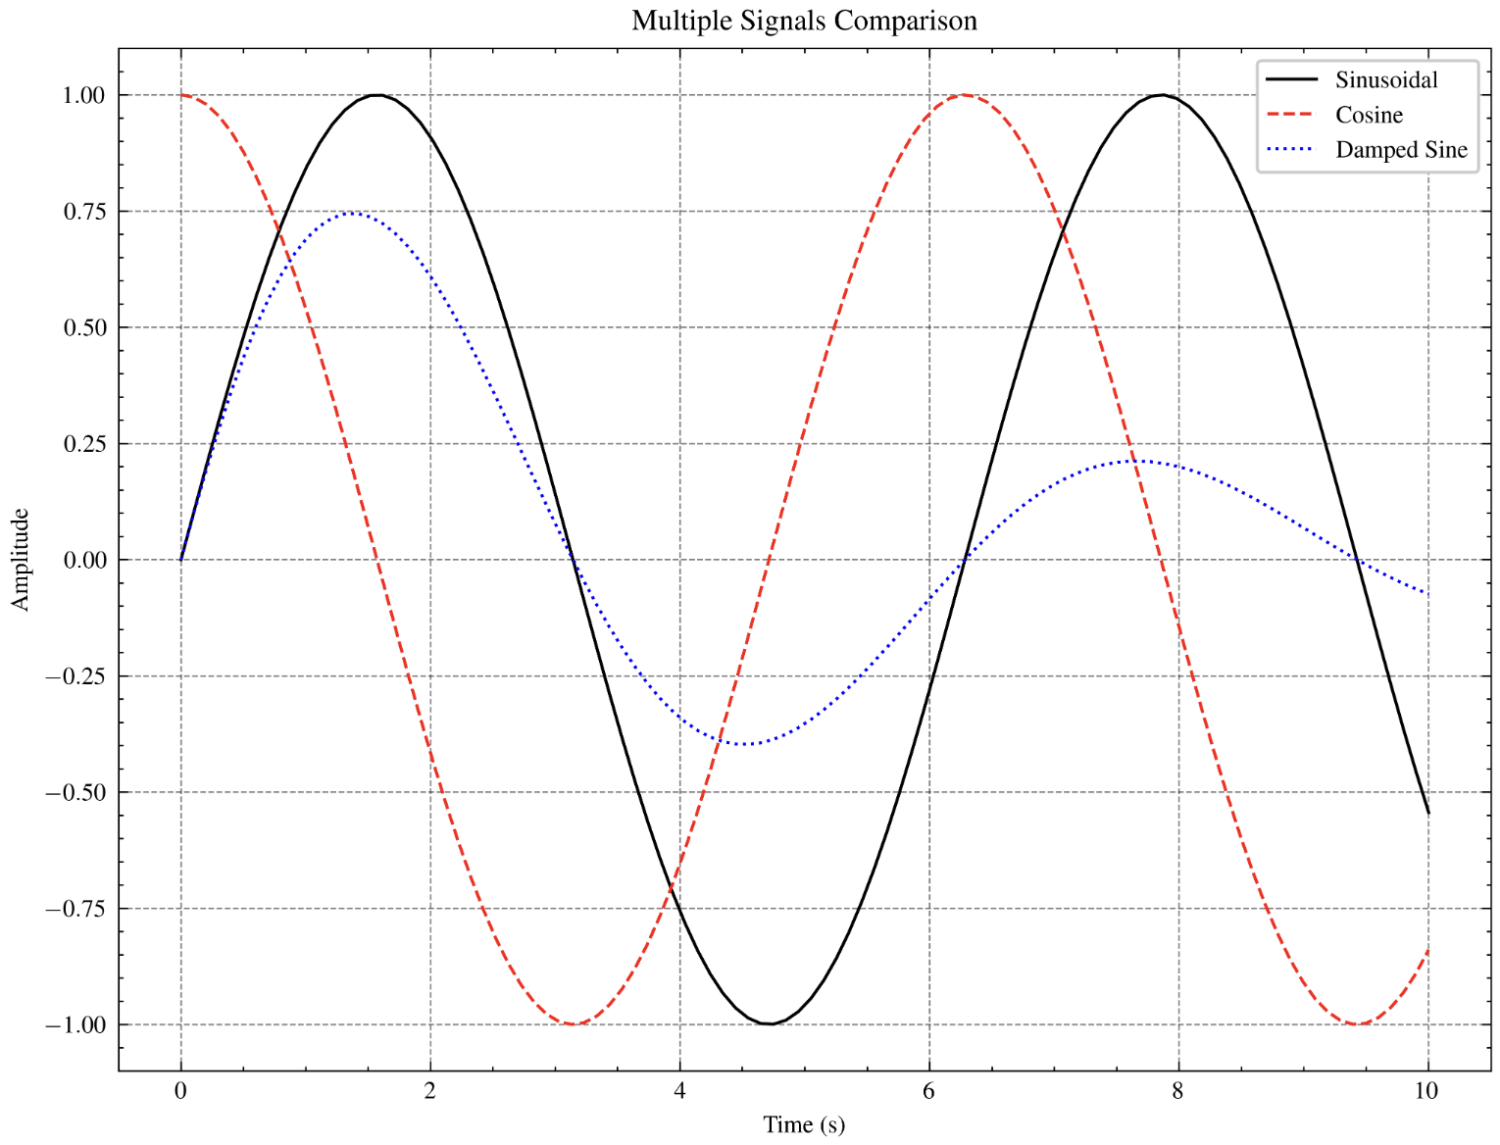
SciencePlots: Journal-Ready matplotlib Formatting Made Easy | CodeCut
Workflow Automation | CodeCut
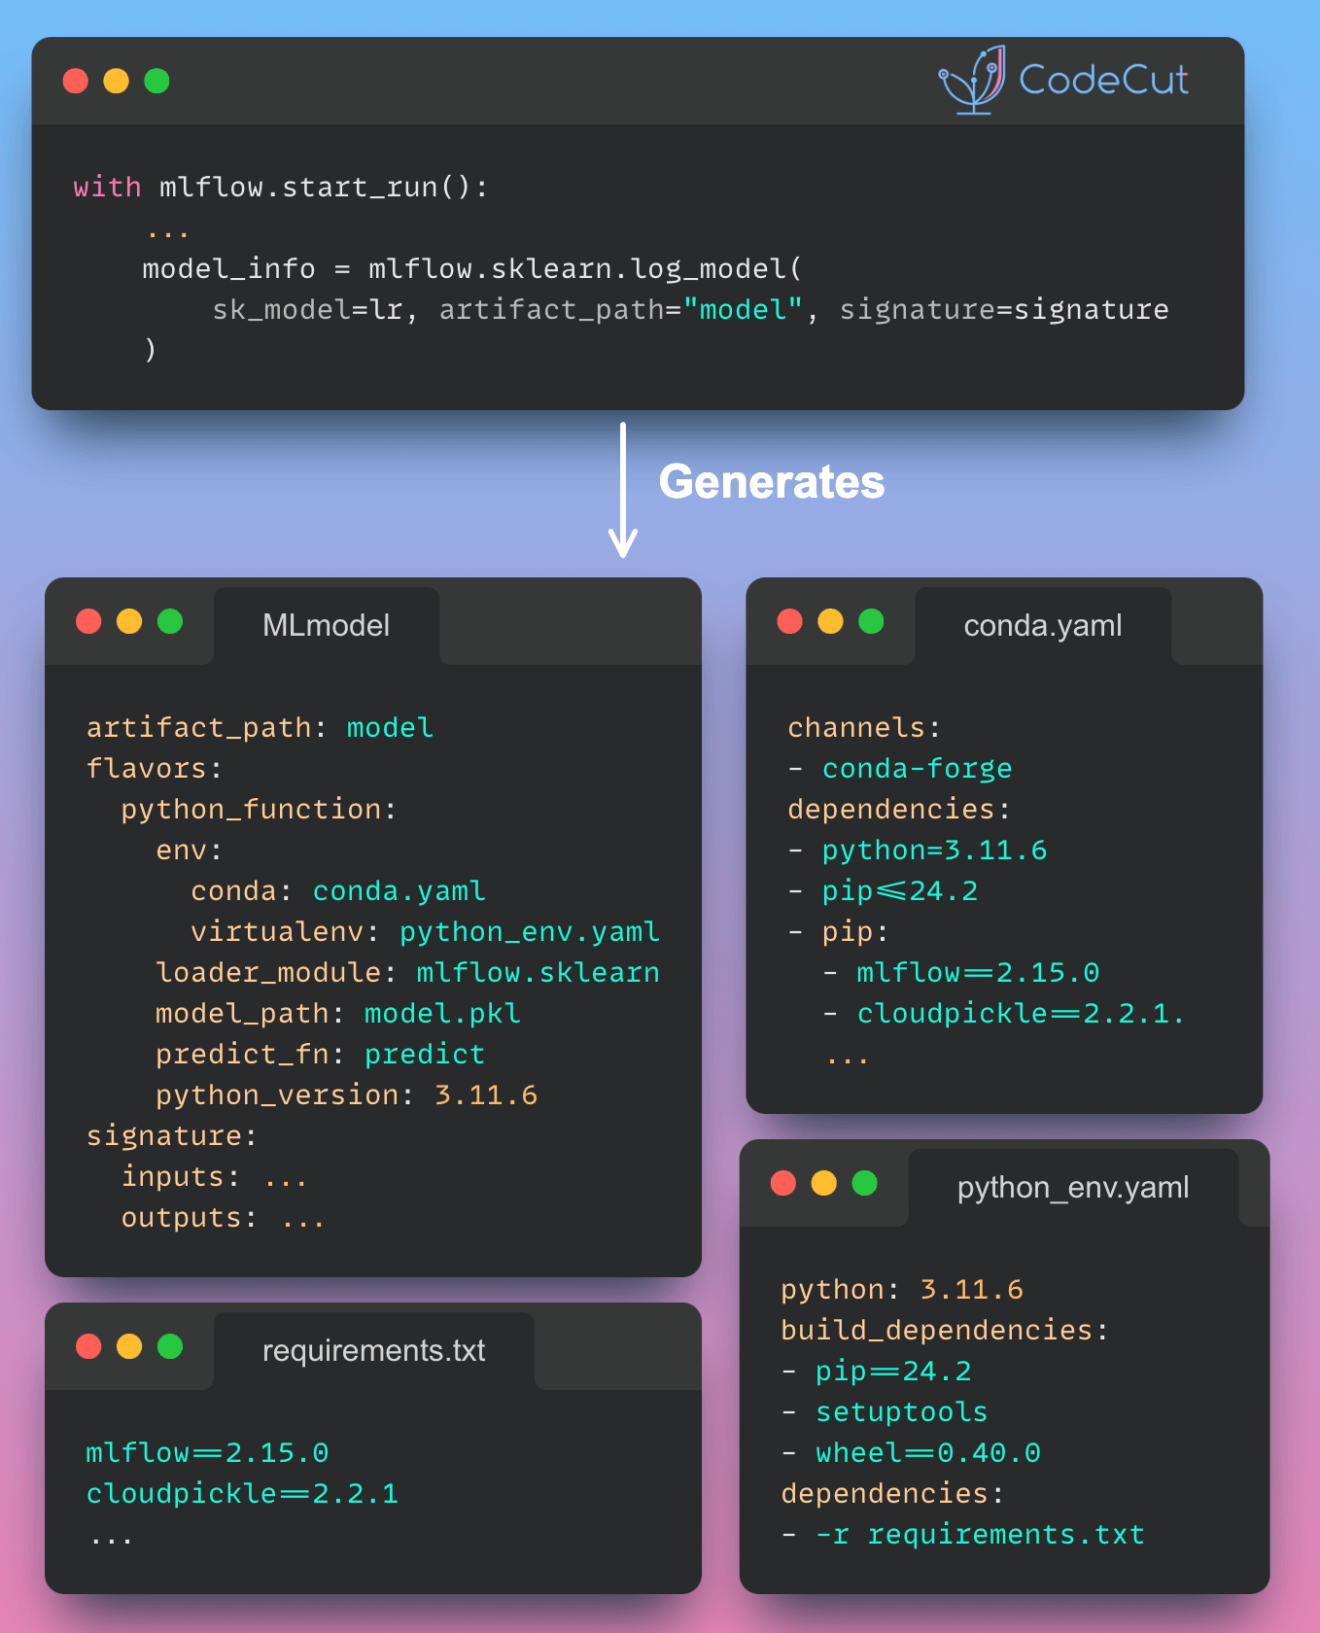
Model Logging Made Easy: MLflow vs. Pickle | CodeCut
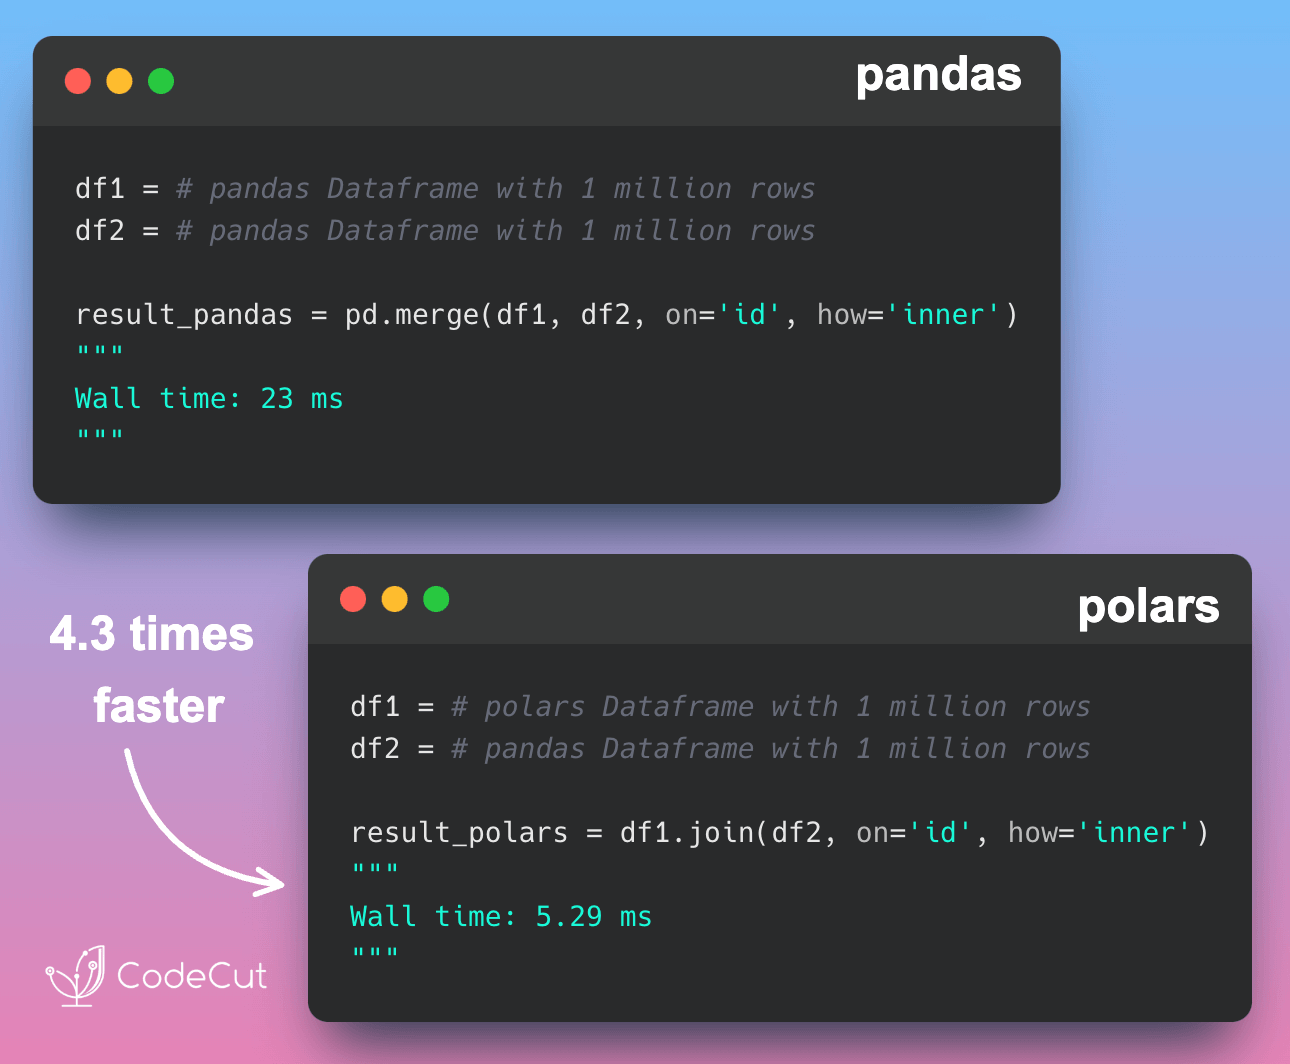
Comparing Join Performance: Pandas vs. Polars | CodeCut
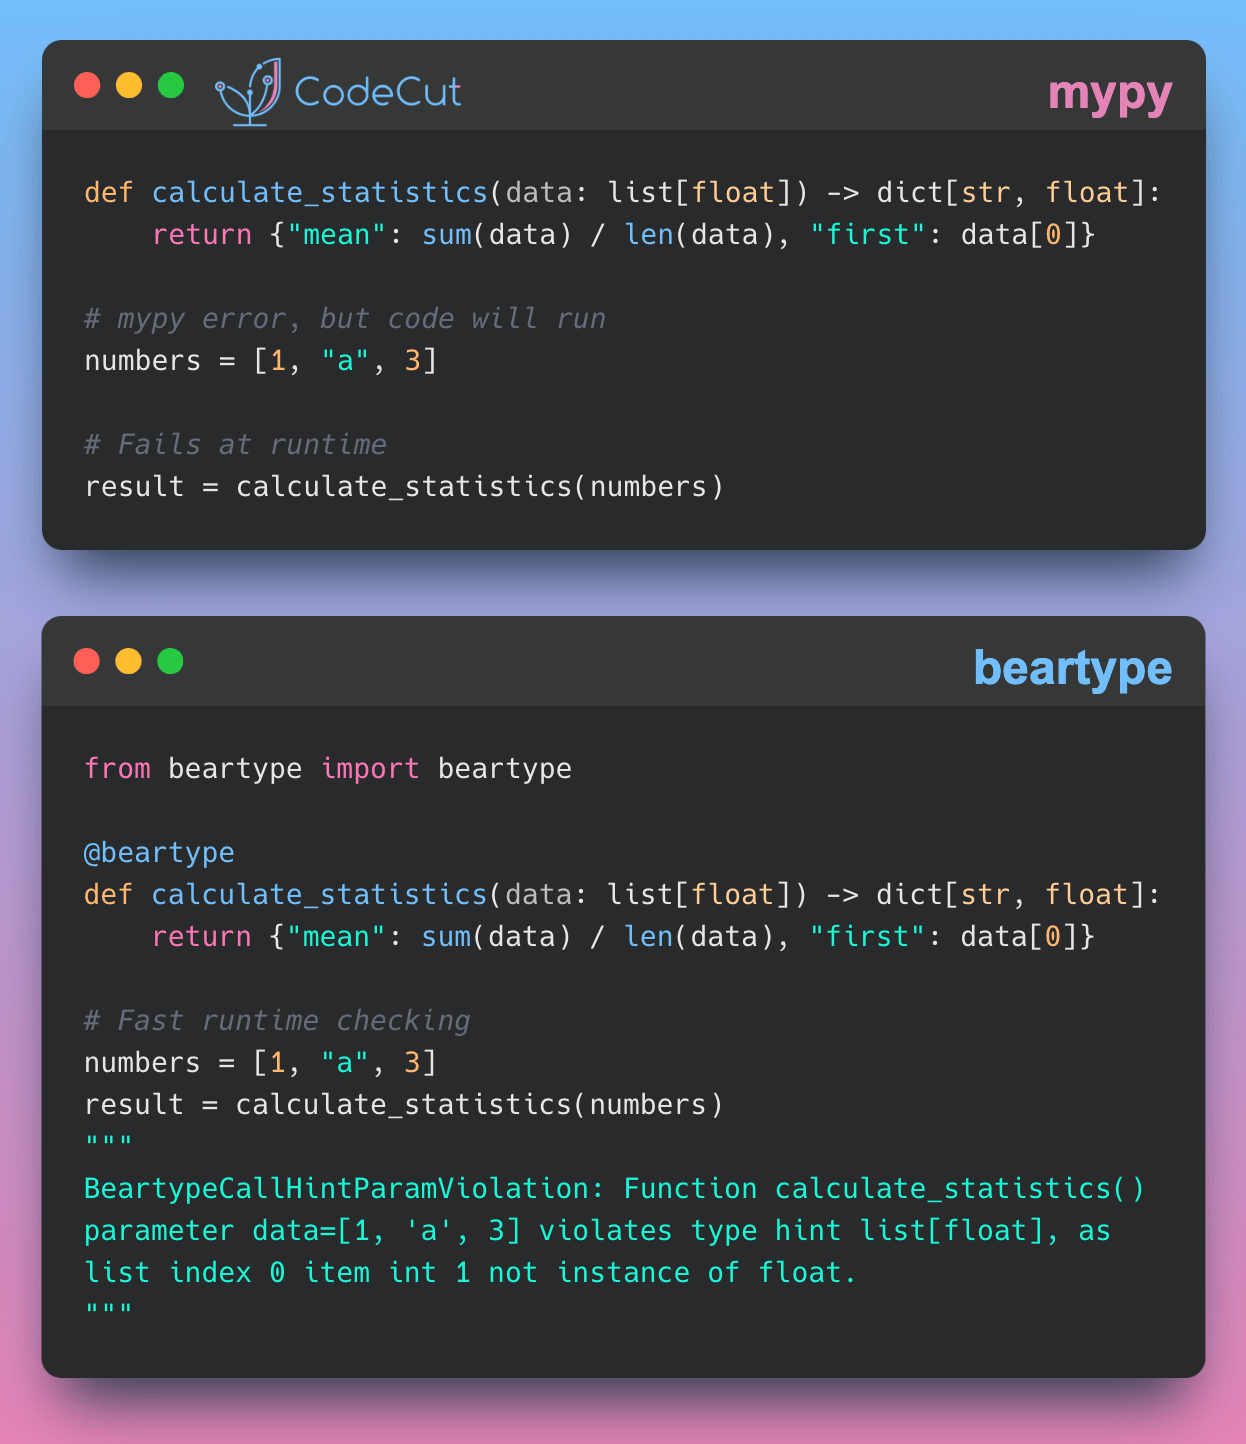
Beartype: Fast, Efficient Runtime Type Checking for Python | CodeCut
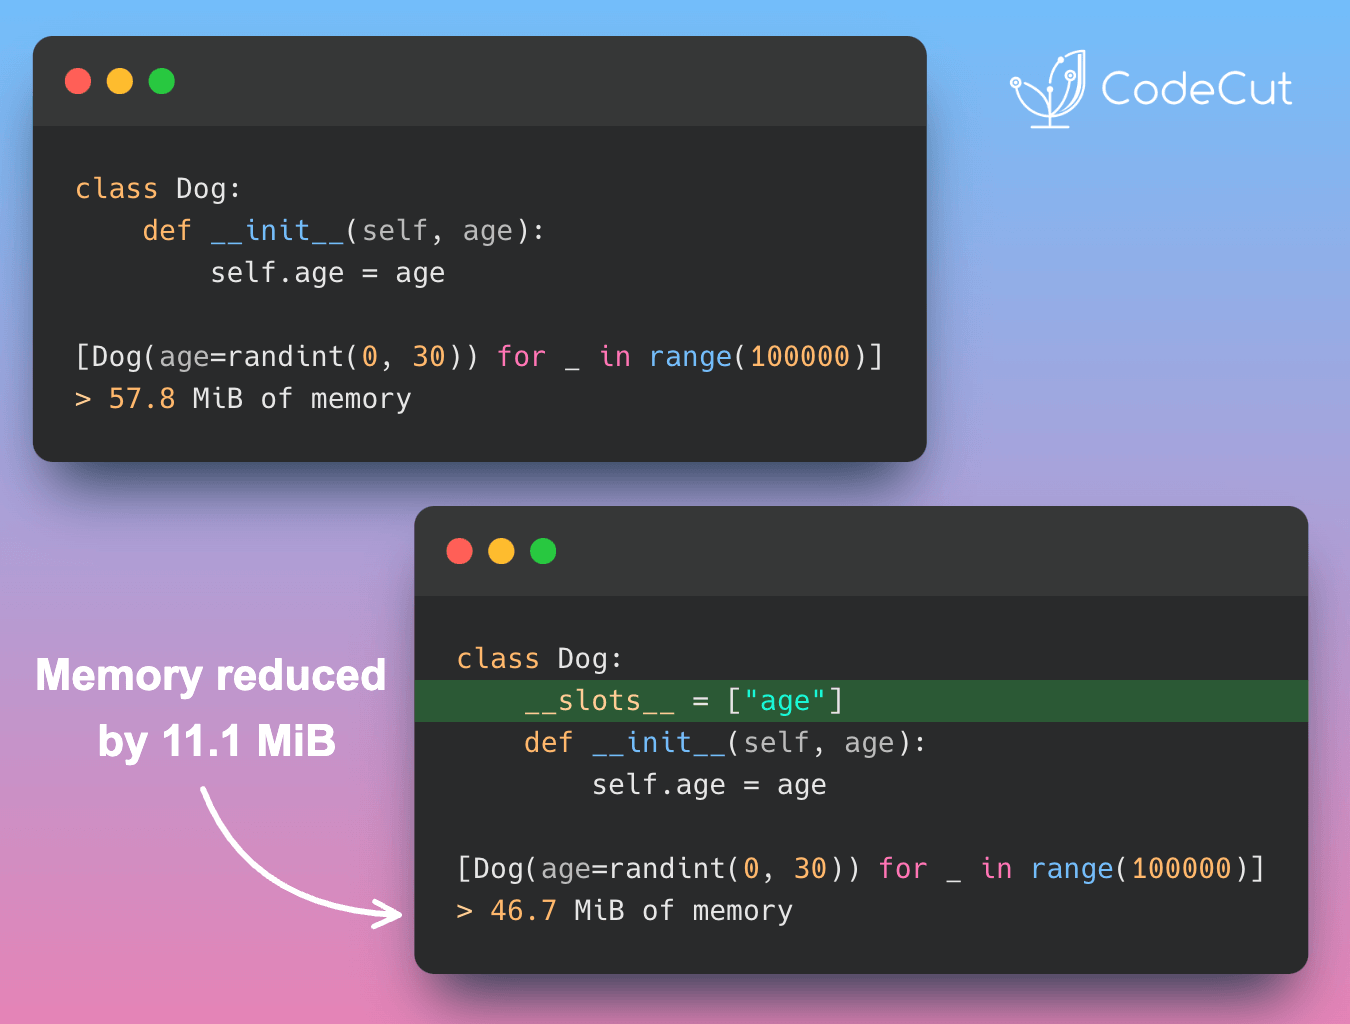
Optimizing Memory Usage in Python with Slots | CodeCut
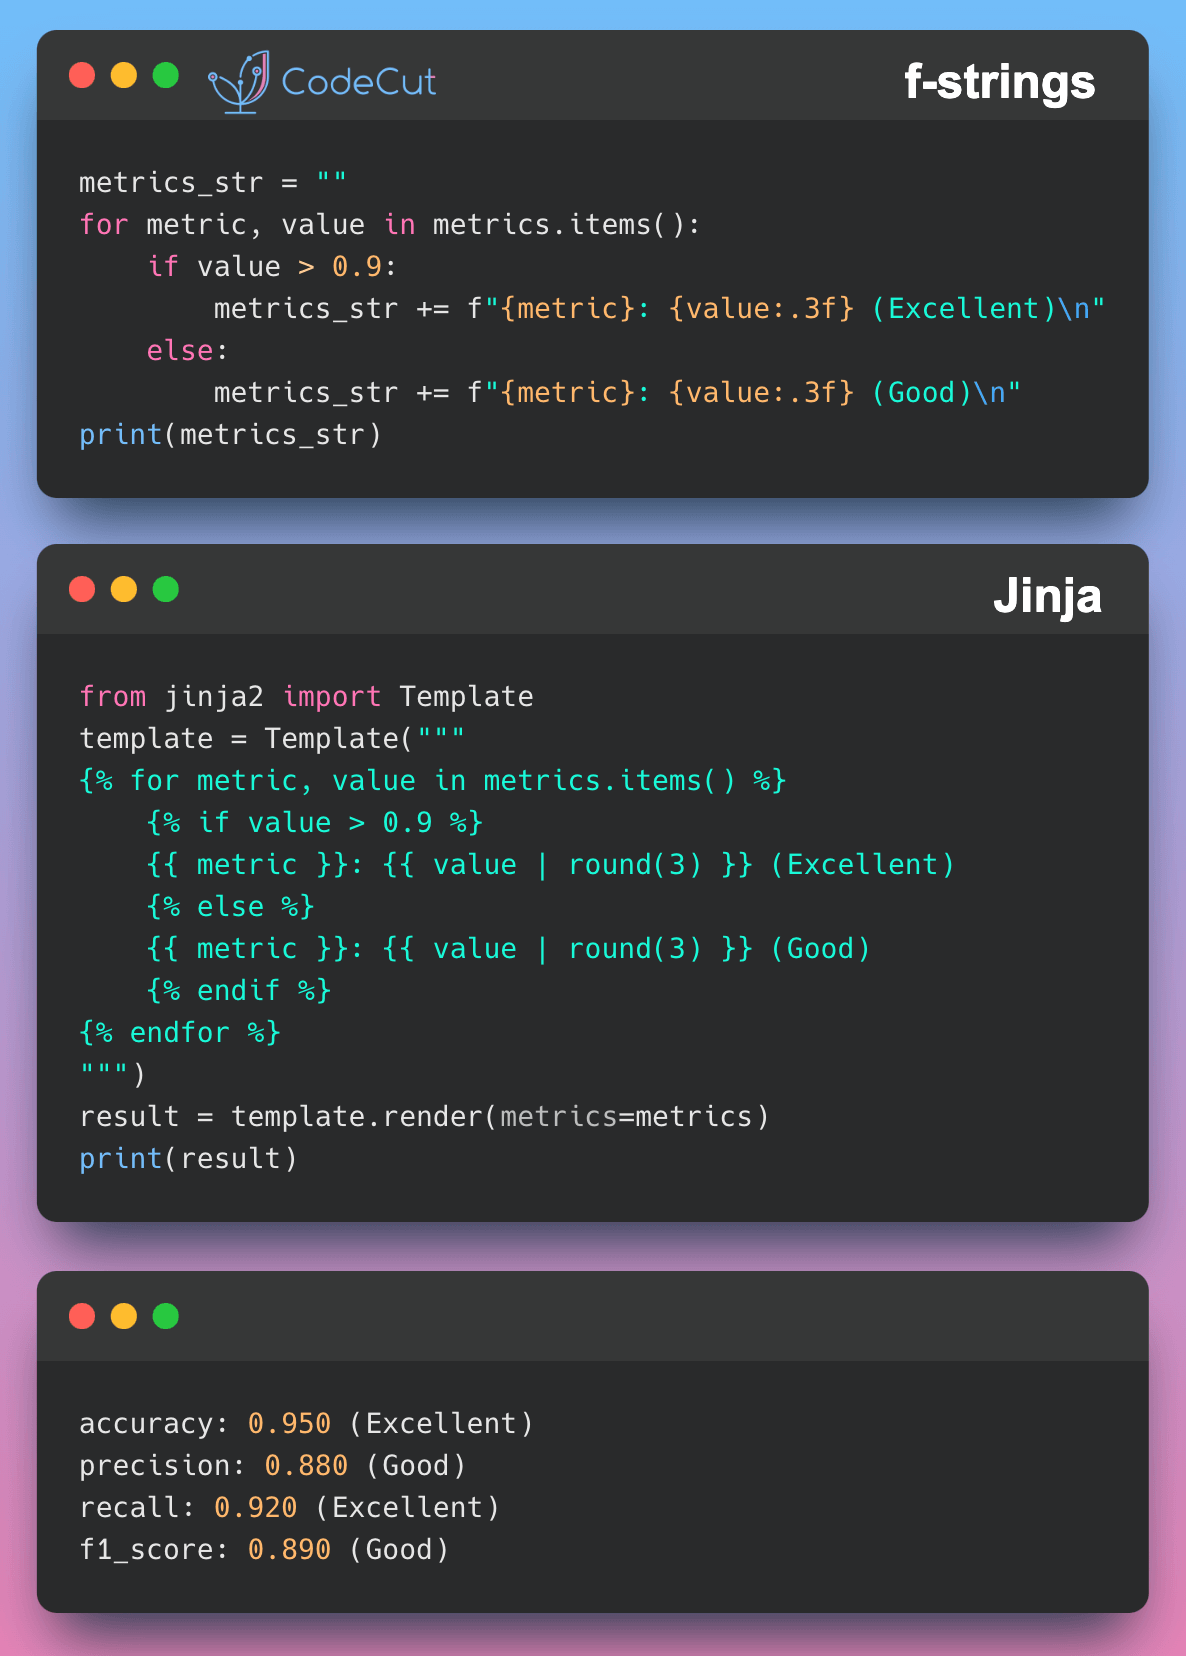
Dynamic Report Generation with Jinja Templates | CodeCut
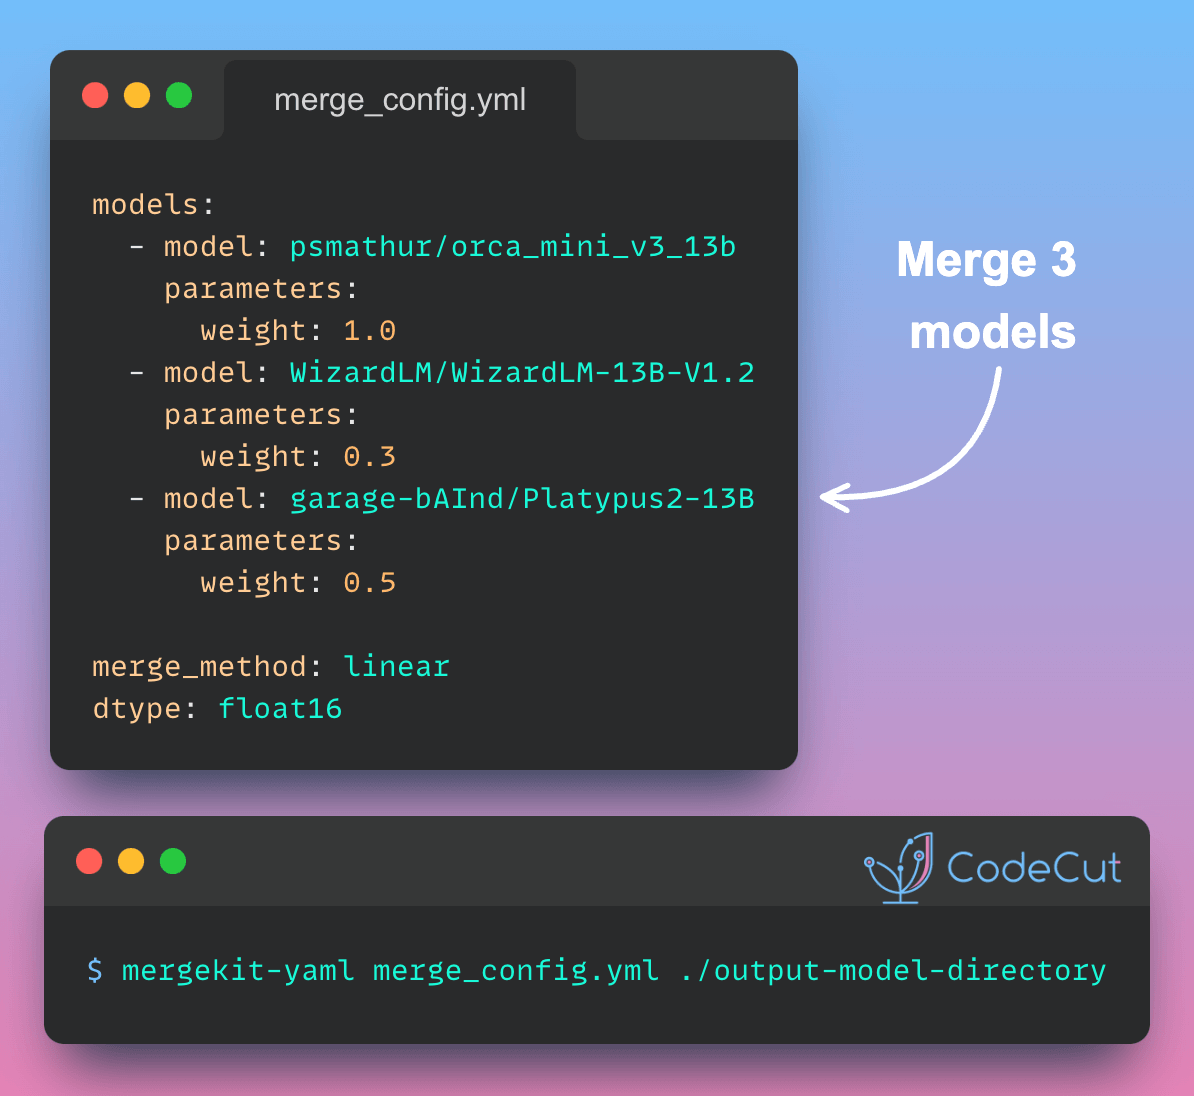
Mergekit: A Powerful Tool for Combining Language Models | CodeCut
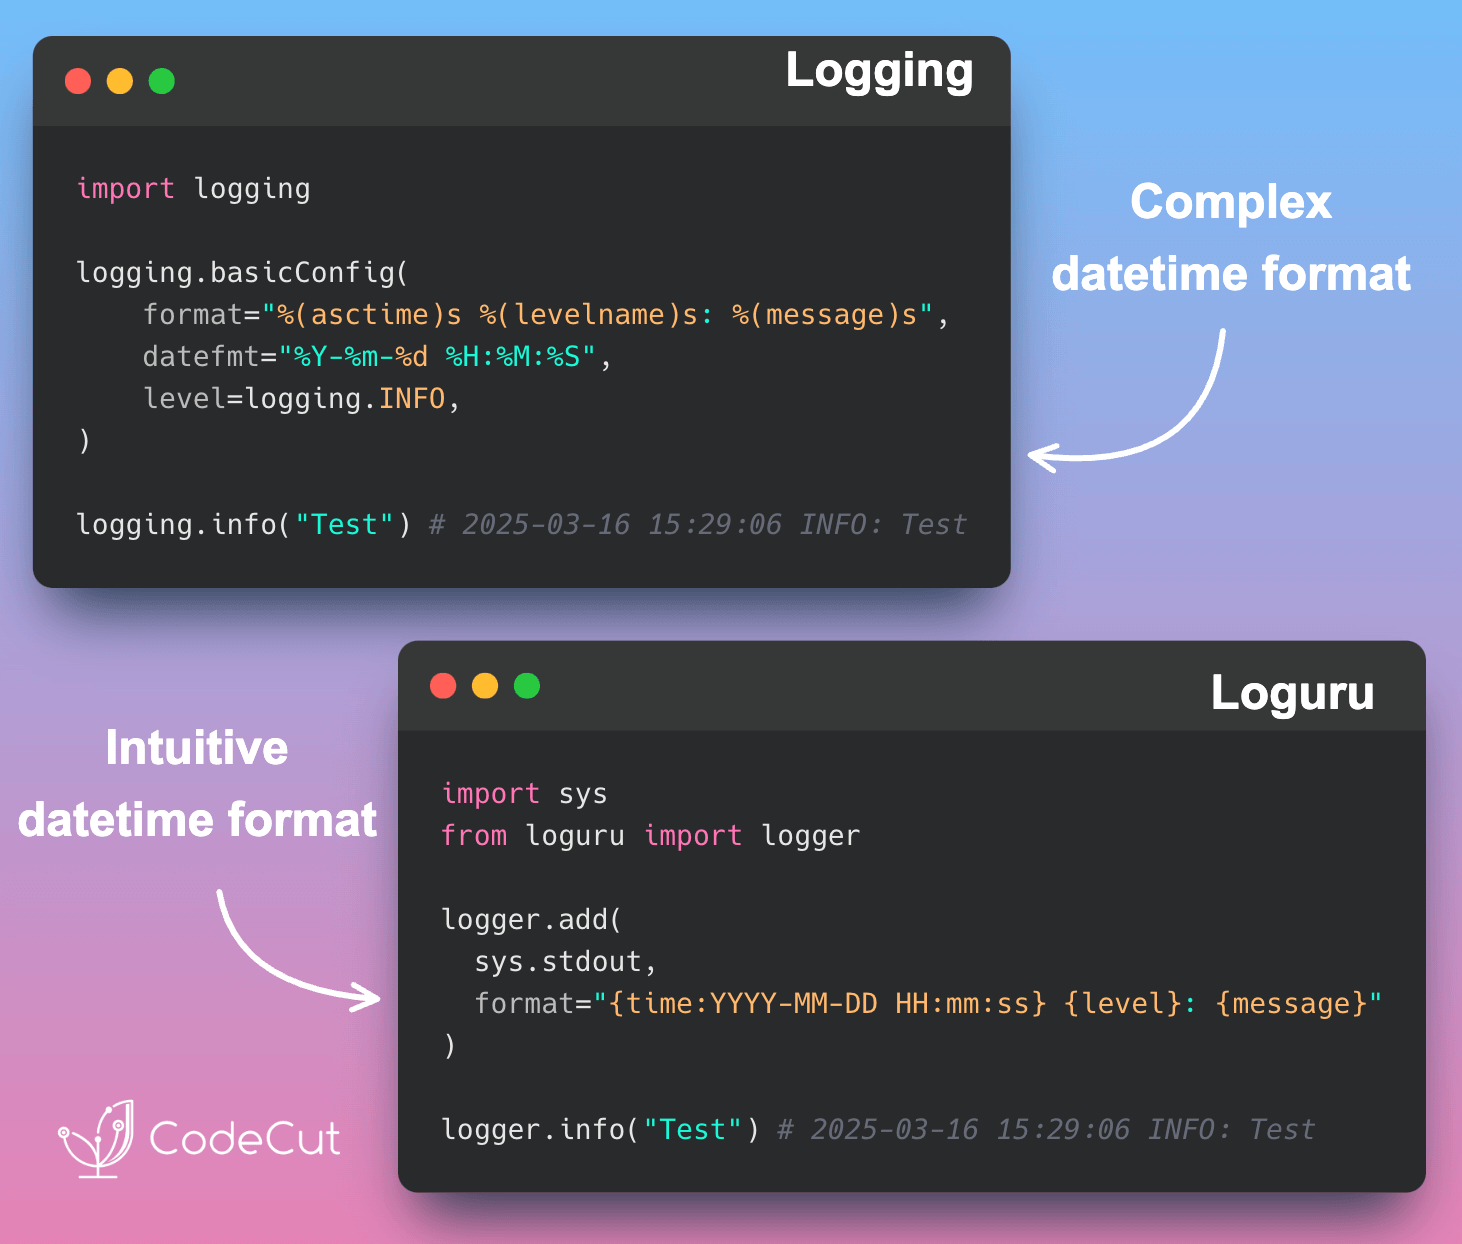
Using natsort for Intuitive Alphanumeric Sorting in Python | CodeCut
Visualization & Reporting | CodeCut
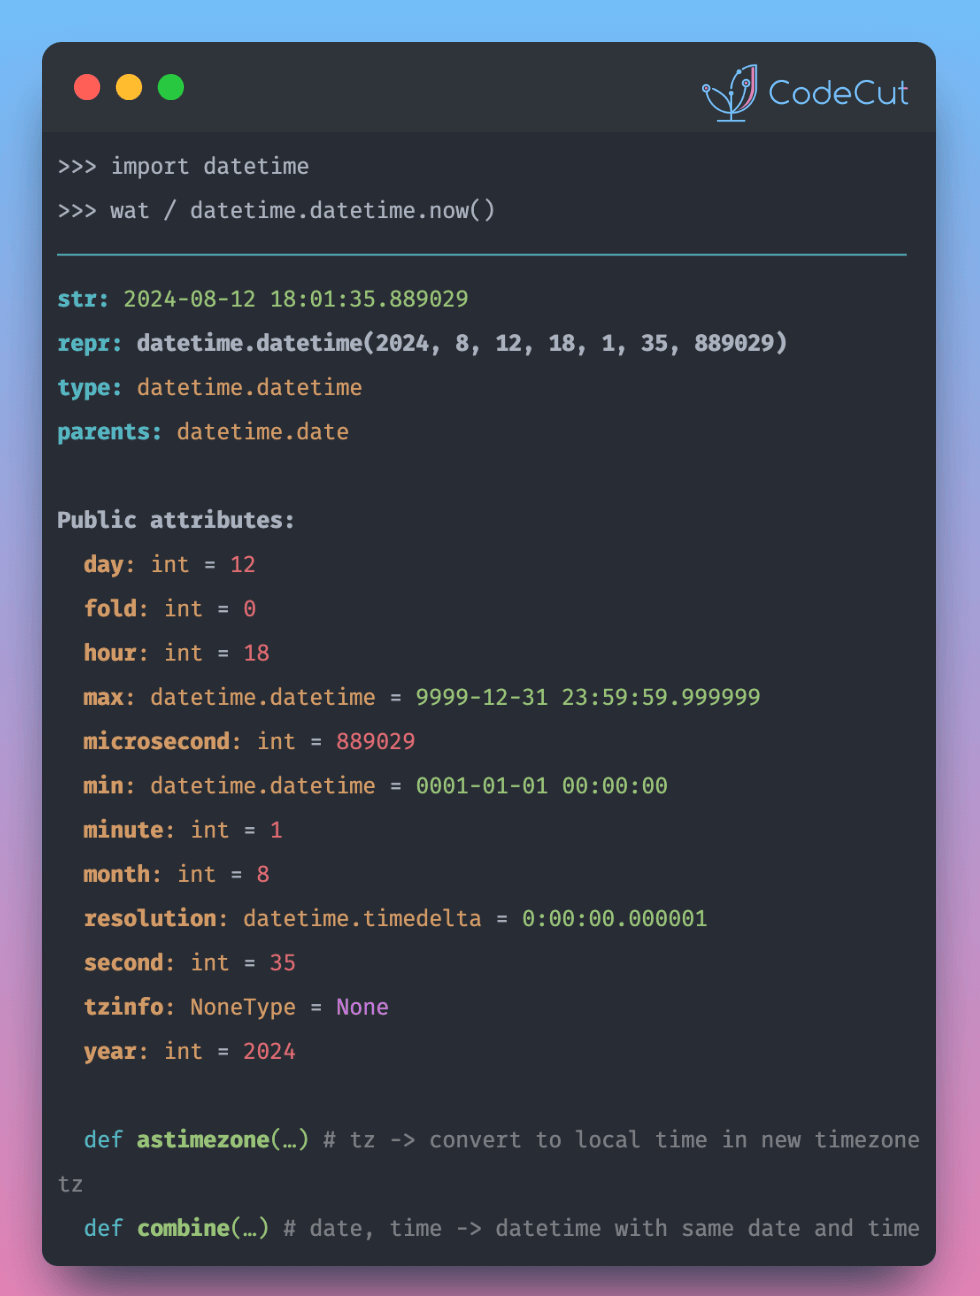
WAT: Your One-Stop Tool for Python Object Exploration | CodeCut
Python-Magic: Reliable File Type Detection Beyond Extensions | CodeCut
Pint: Safe Unit Conversions in Python | CodeCut
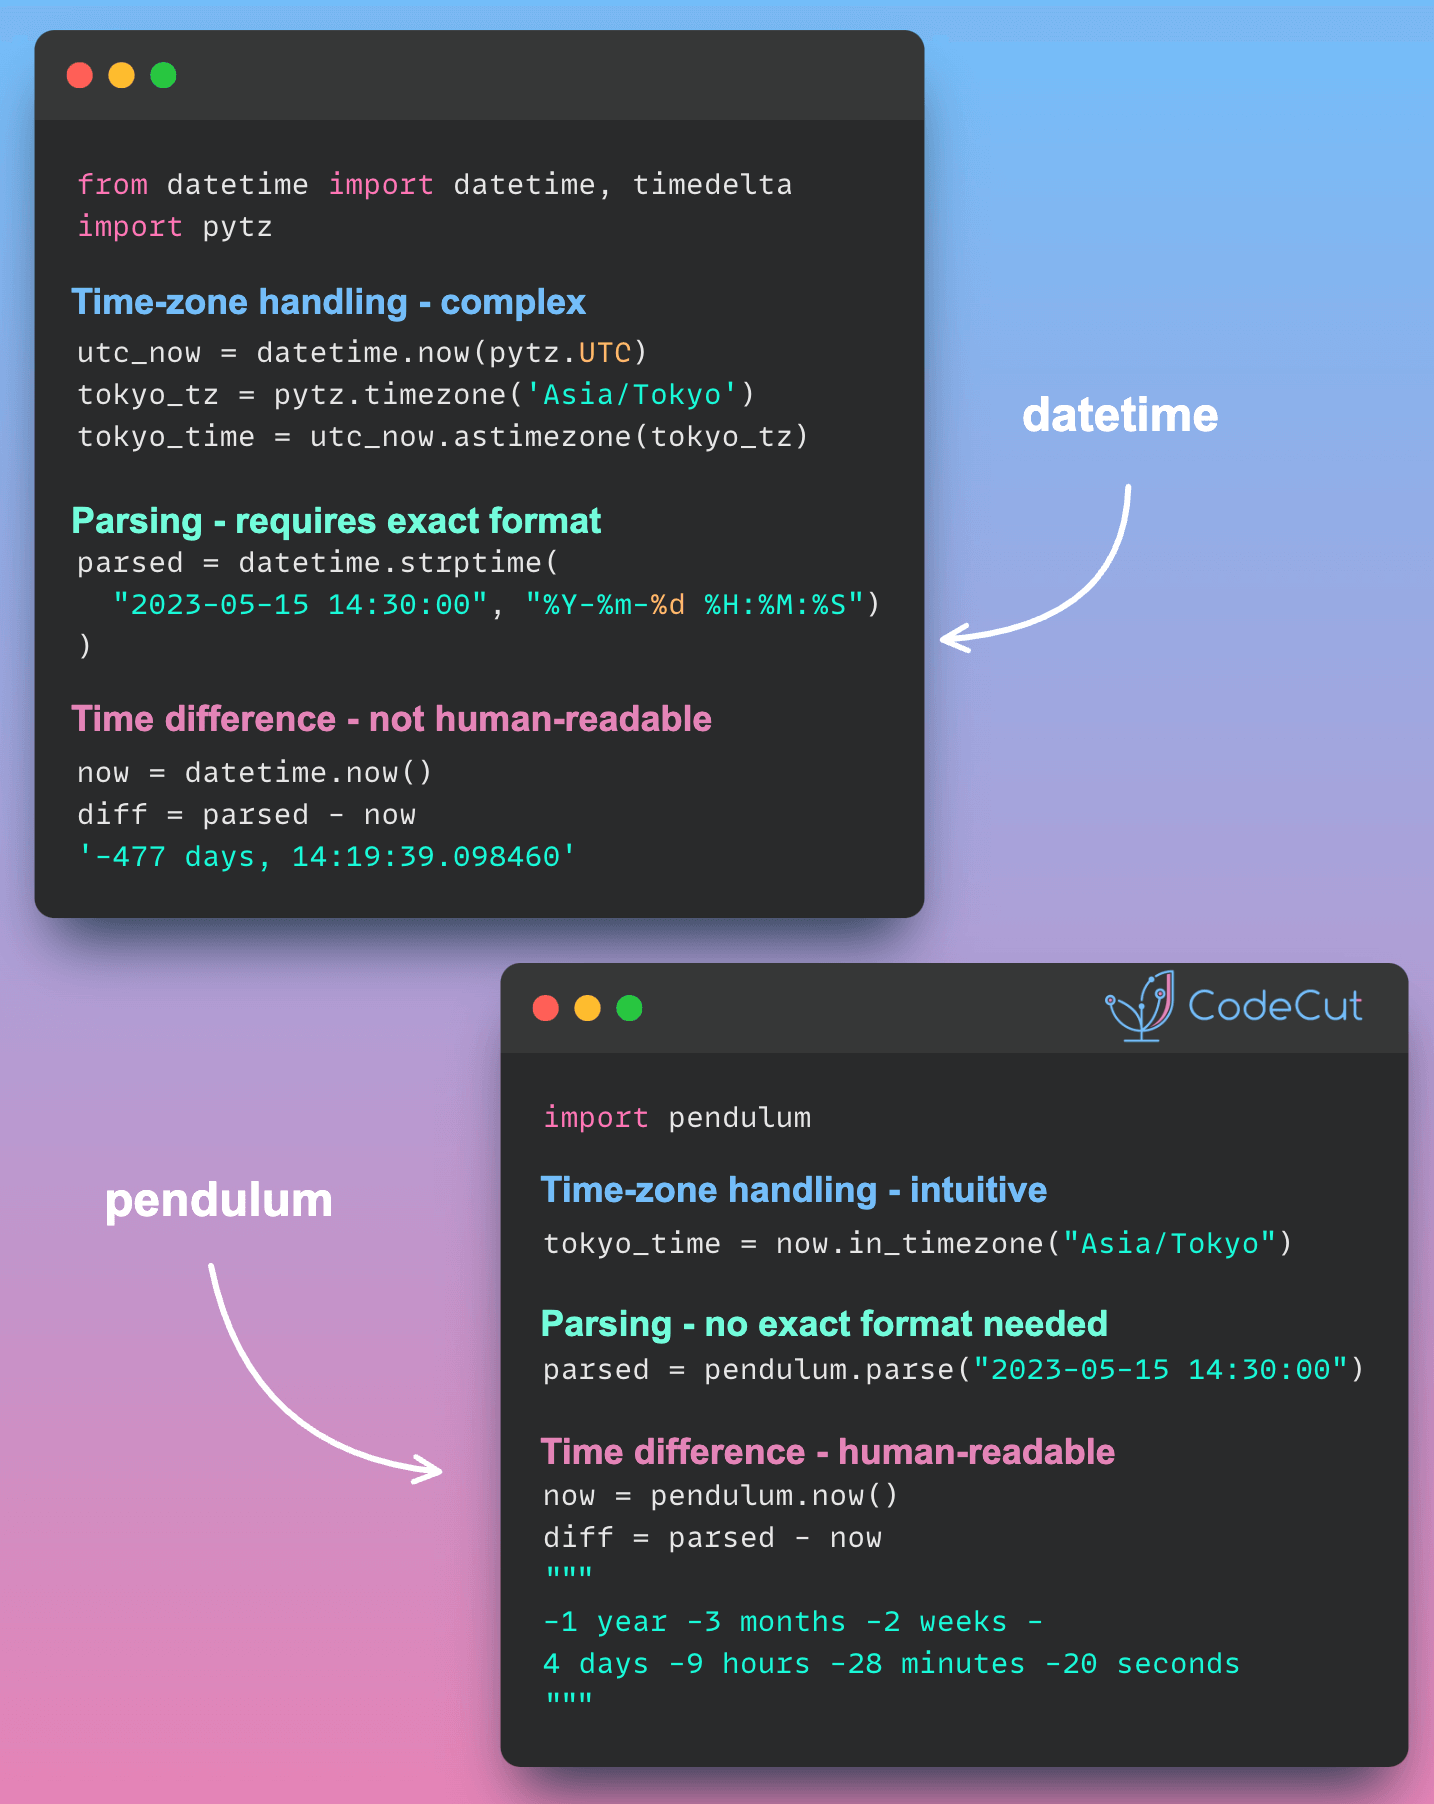
Pendulum: Python Datetimes Made Easy | CodeCut
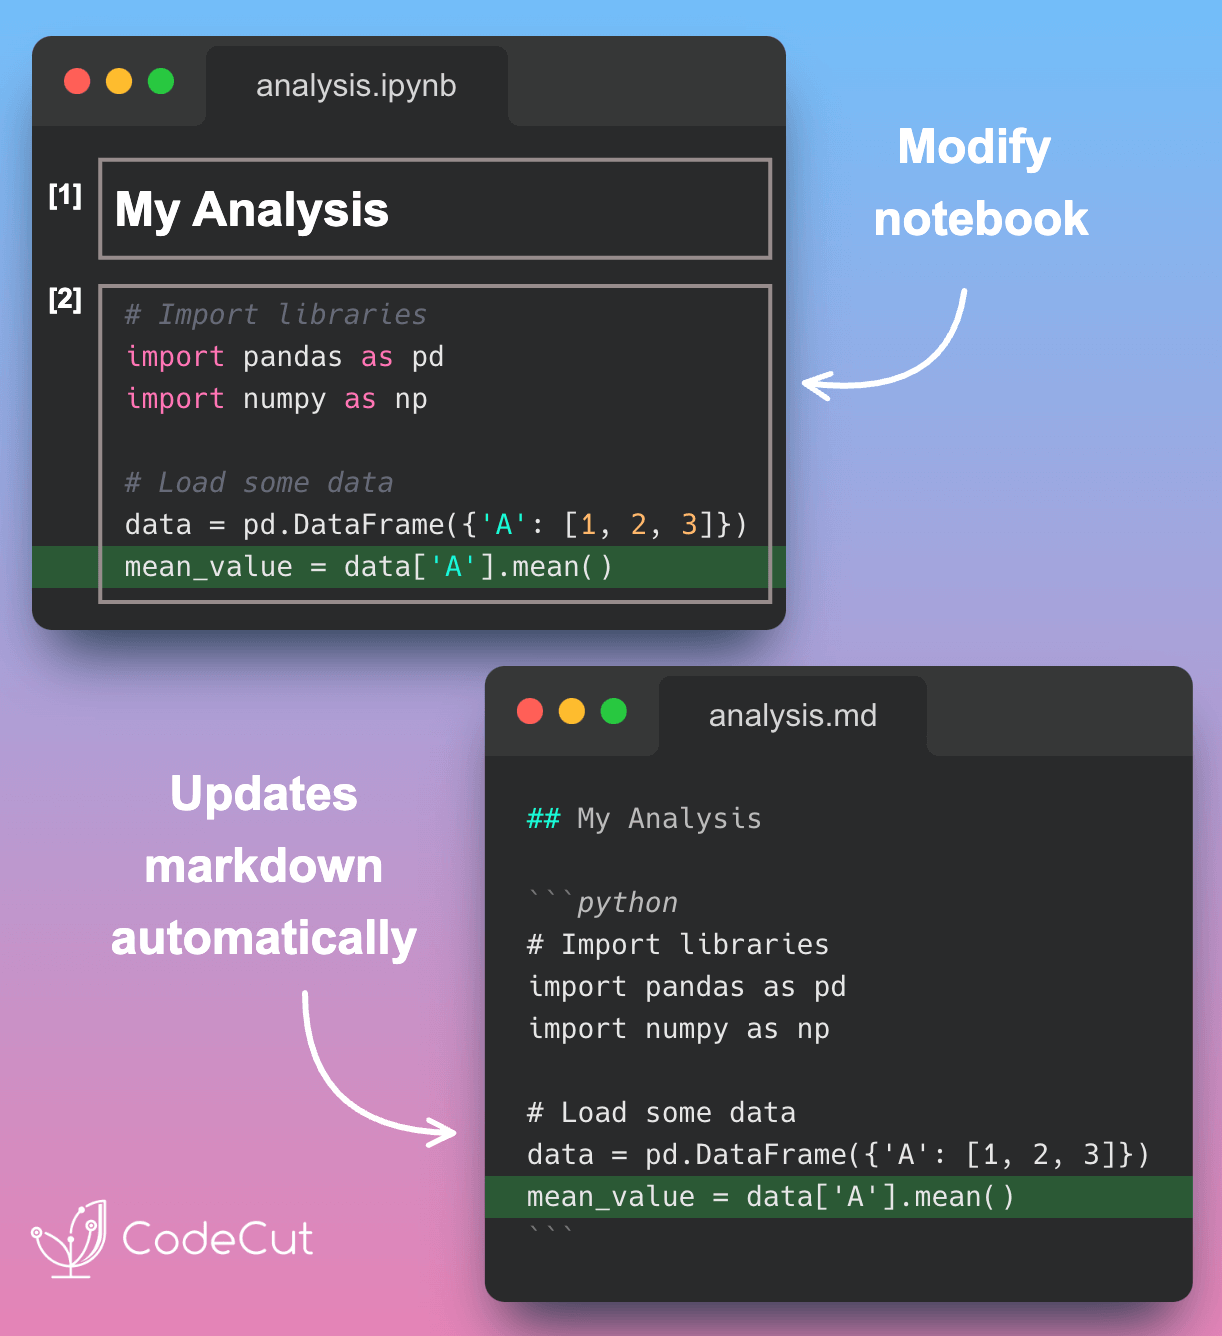
Jupytext: Transform Notebooks into Version Control-Friendly Text | CodeCut
Blog | Page 8 of 9 | CodeCut
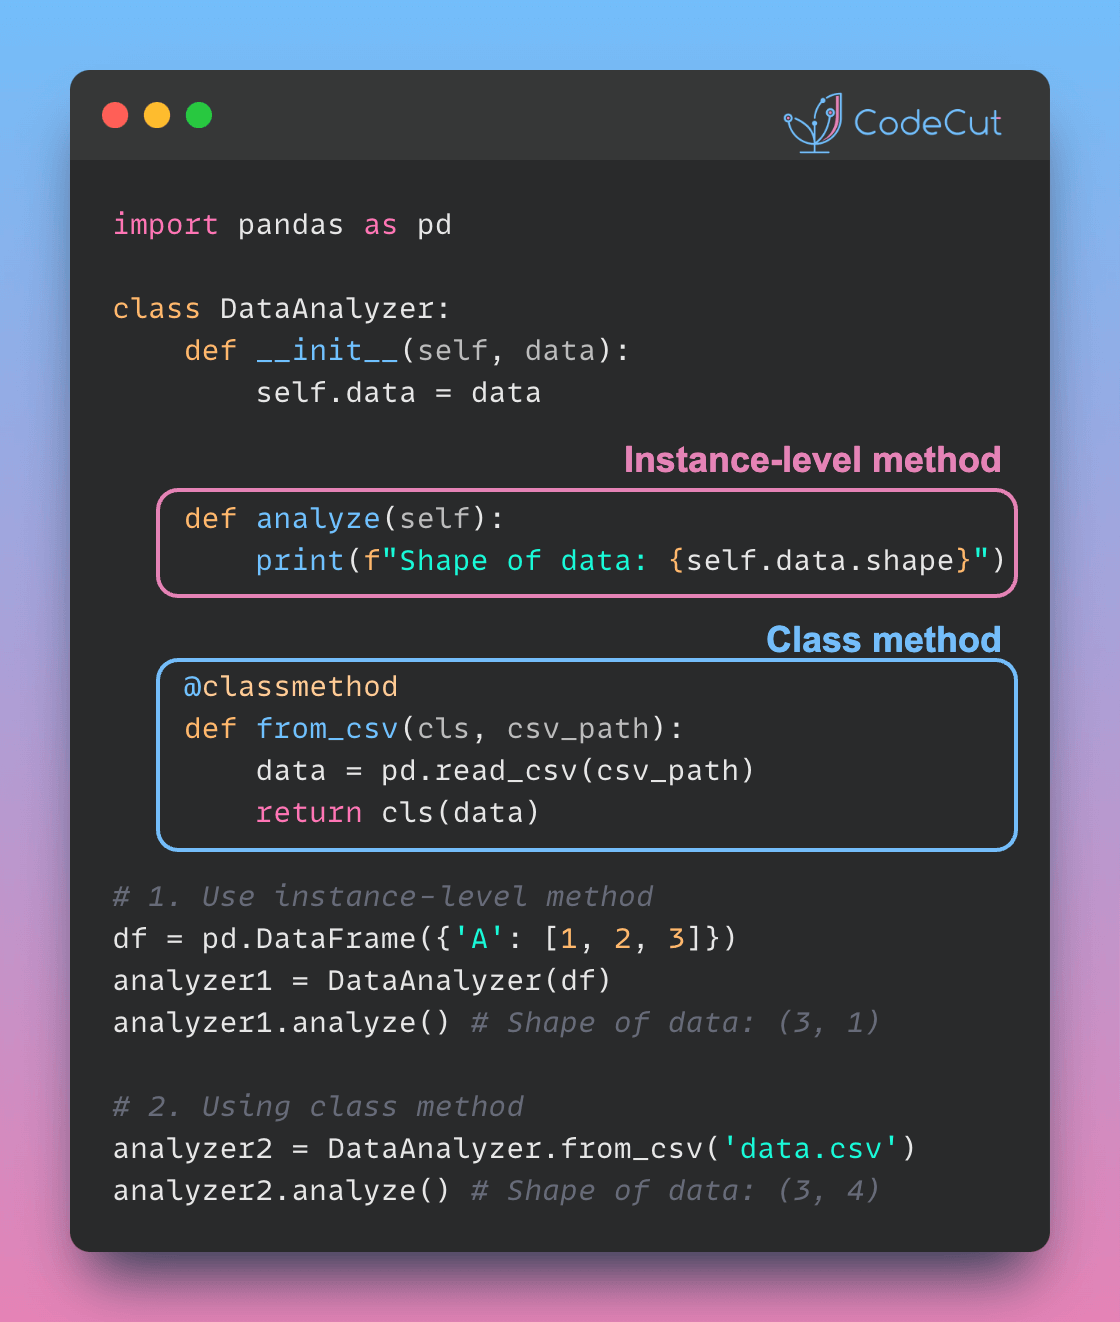
Simplify Object Creation with Python Class Methods | CodeCut
Pandas | CodeCut
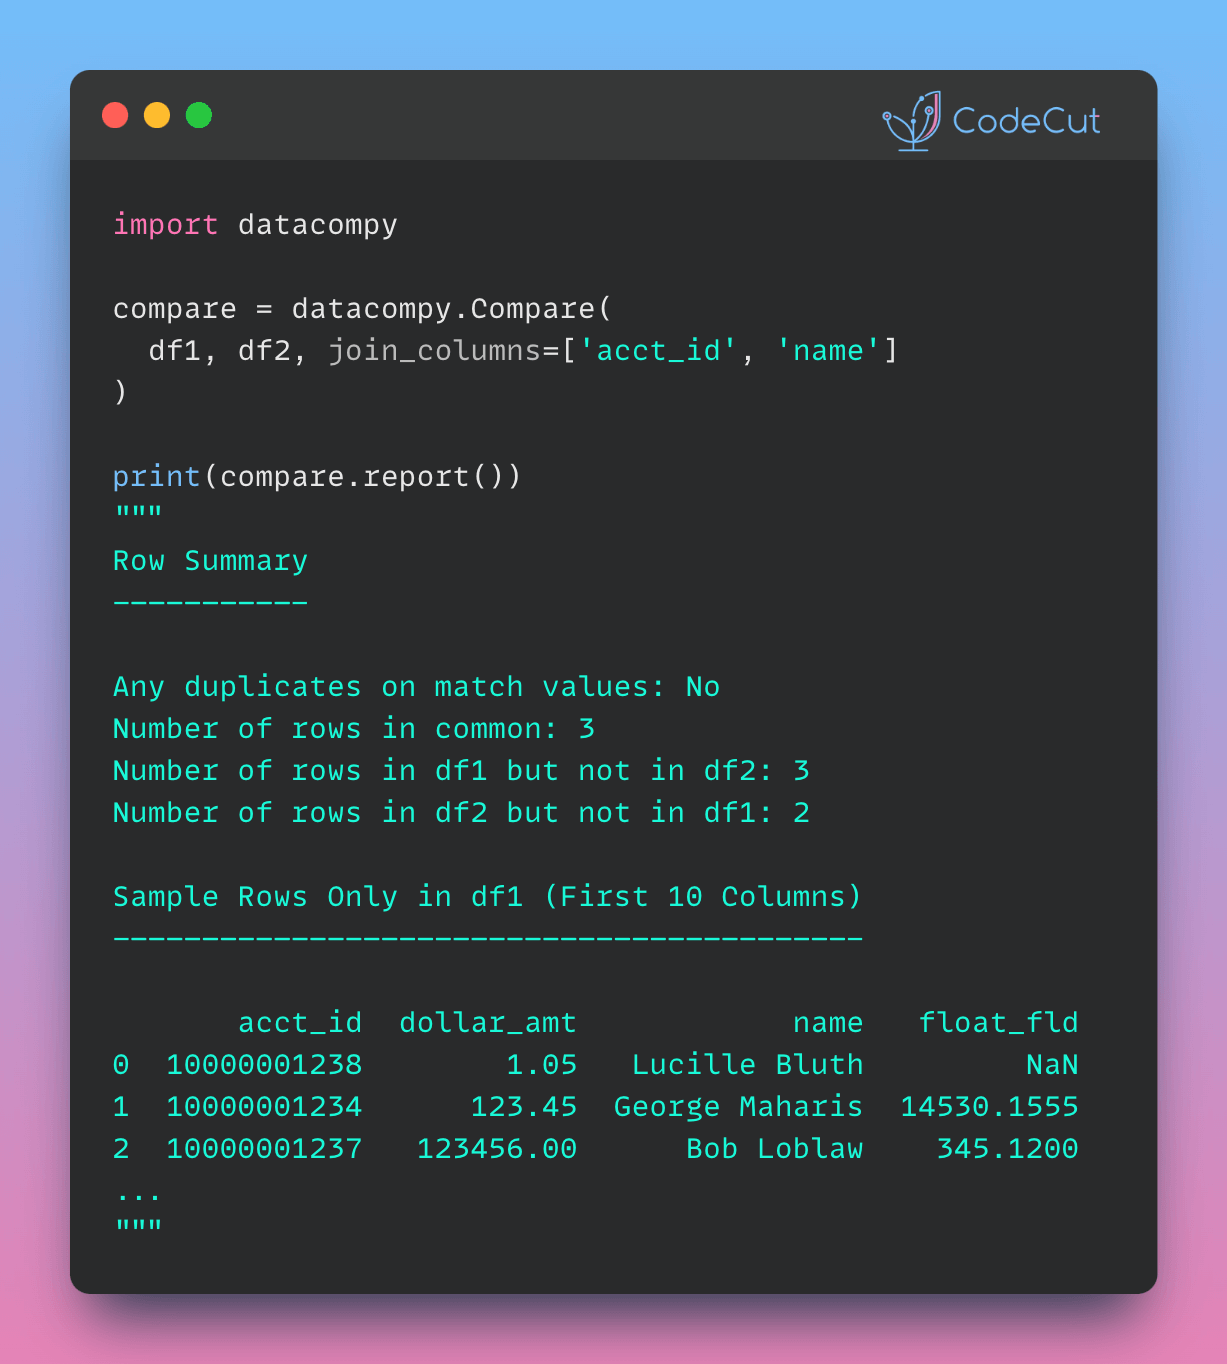
Simplifying Dataset Comparison with Datacompy | CodeCut
Automate CSV Parsing with DuckDB's read_csv | CodeCut
Add Statistical Significance Annotations on Seaborn Plots | CodeCut
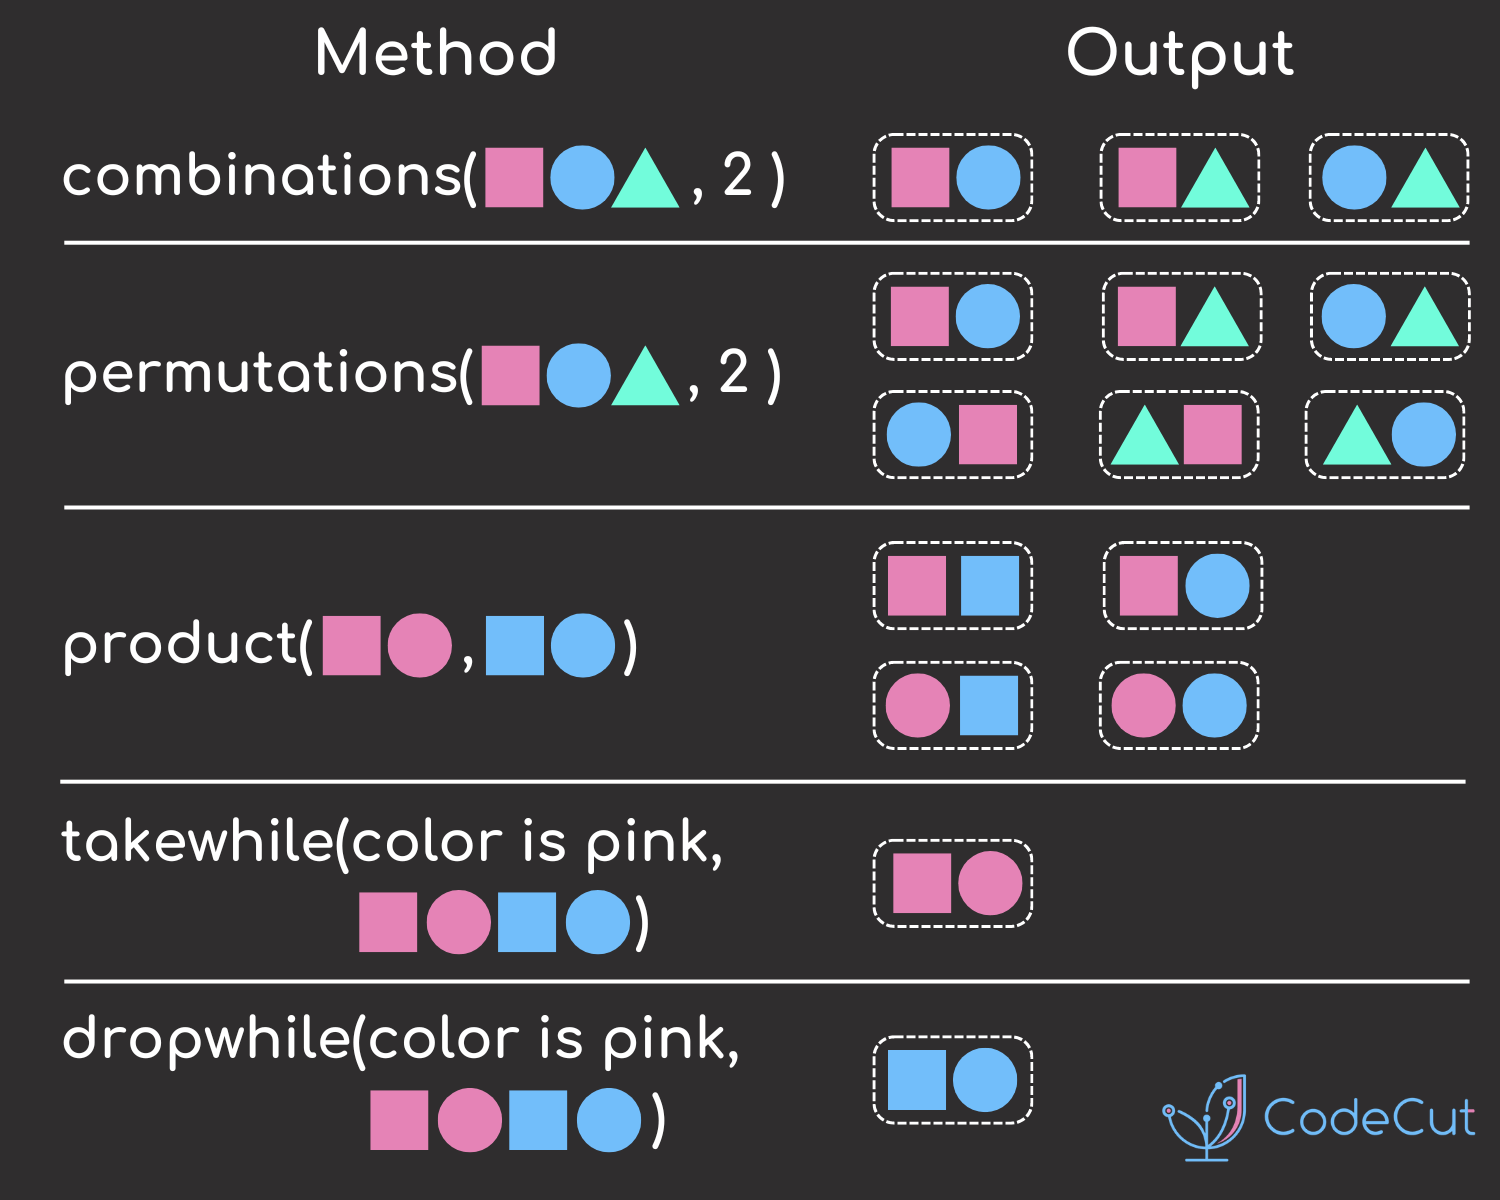
Efficient Looping in Python with itertools | CodeCut
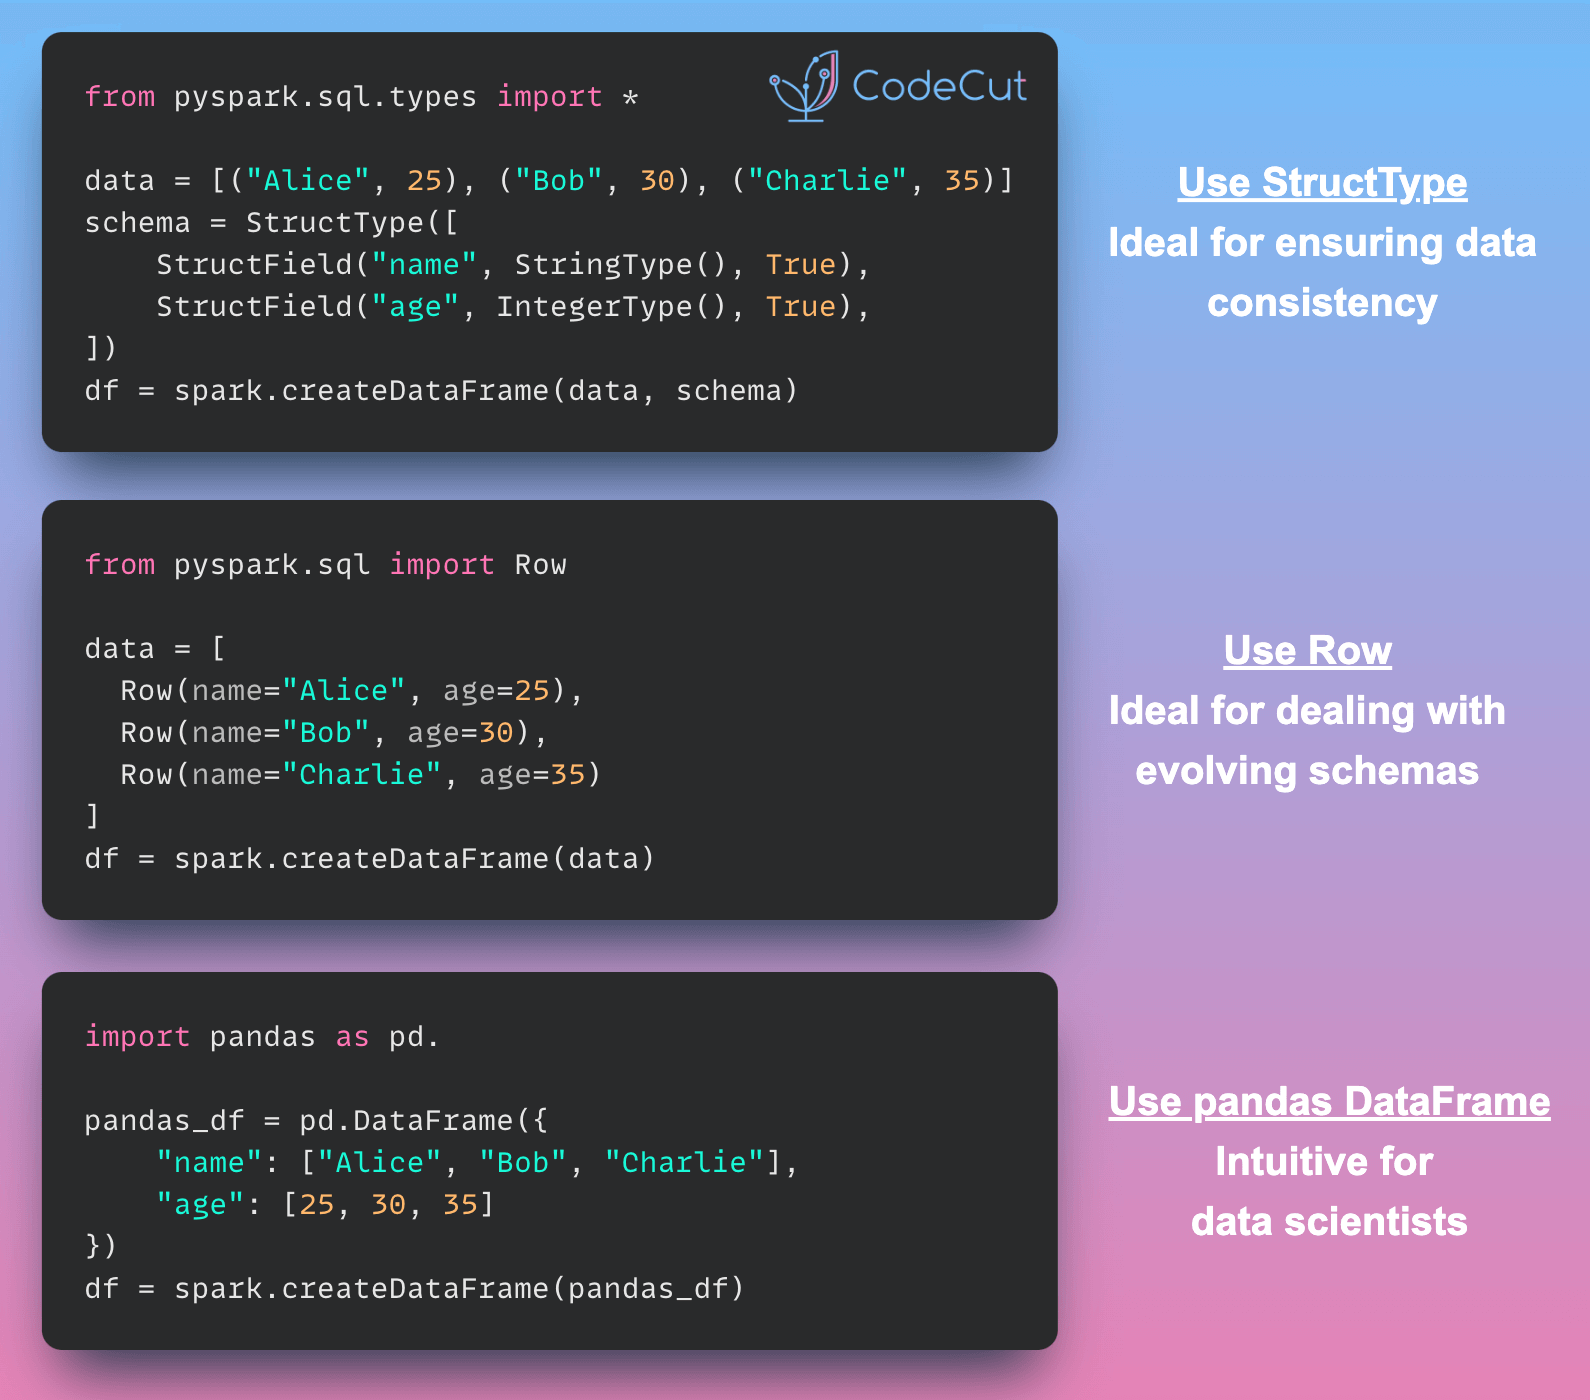
3 Powerful Ways to Create PySpark DataFrames | CodeCut
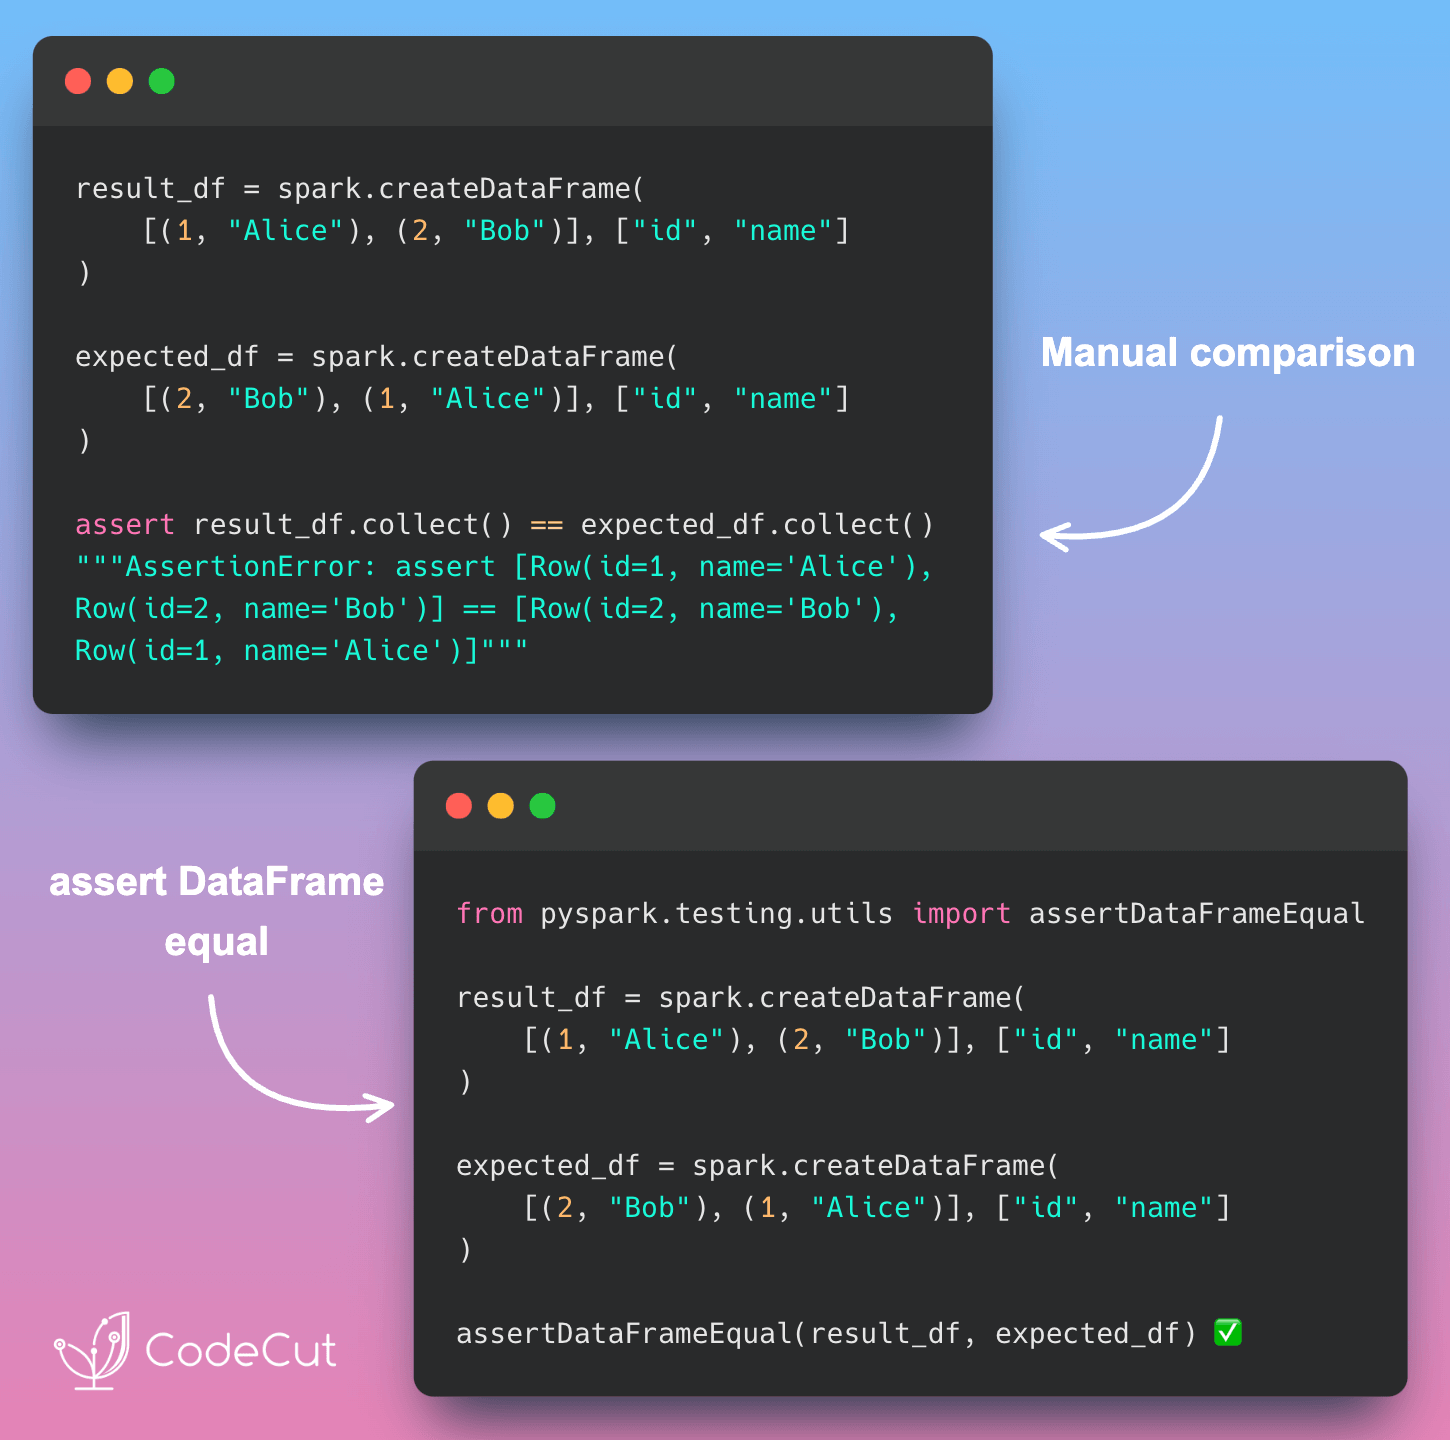
Best Practices for PySpark DataFrame Comparison Testing | CodeCut
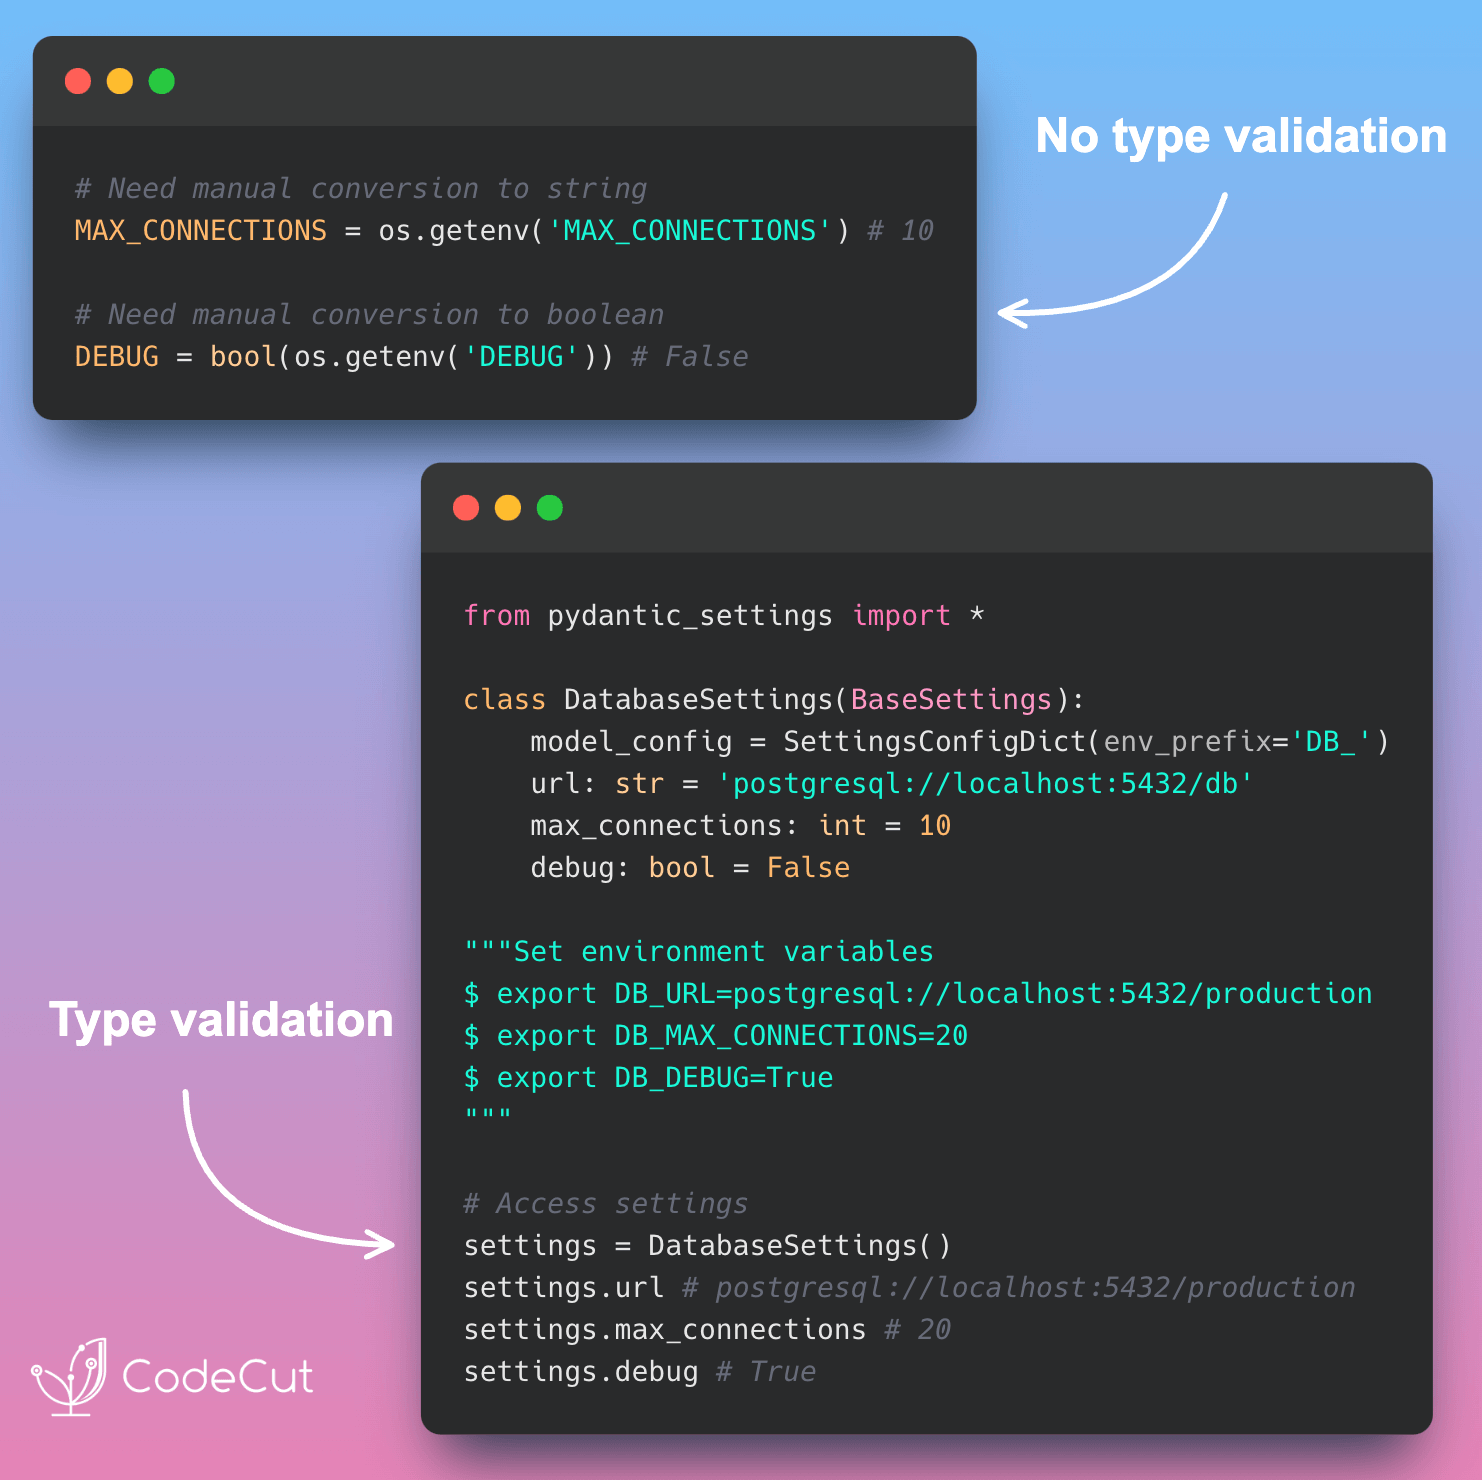
Pydantic-settings: Type-Safe Config Management | CodeCut
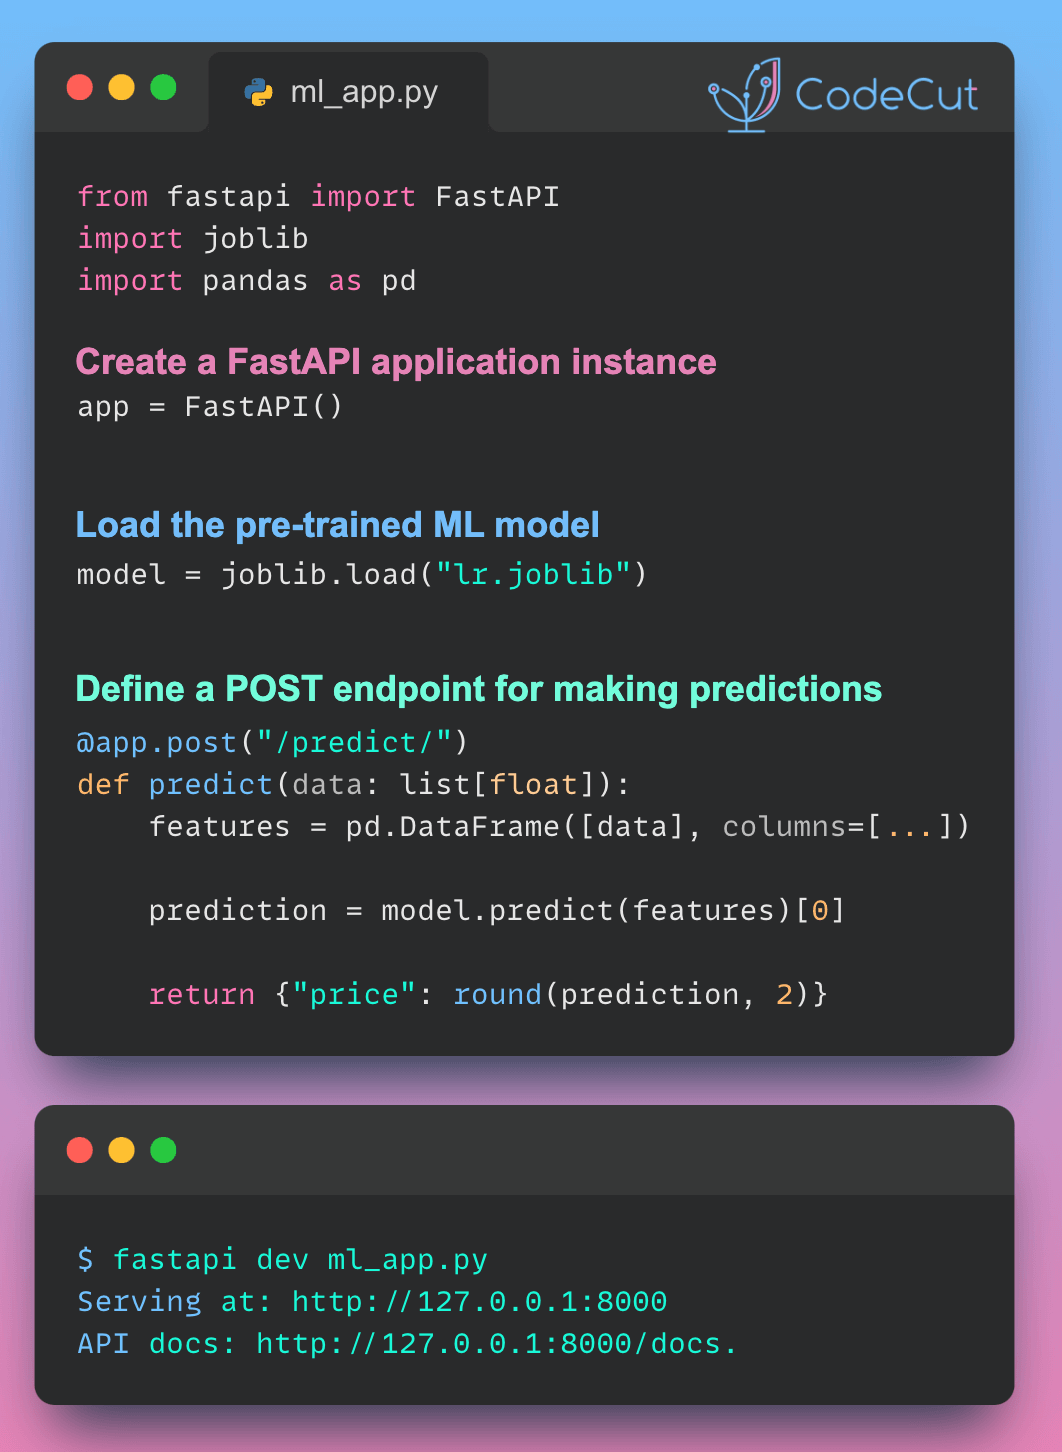
Simplifying ML Model Integration with FastAPI | CodeCut
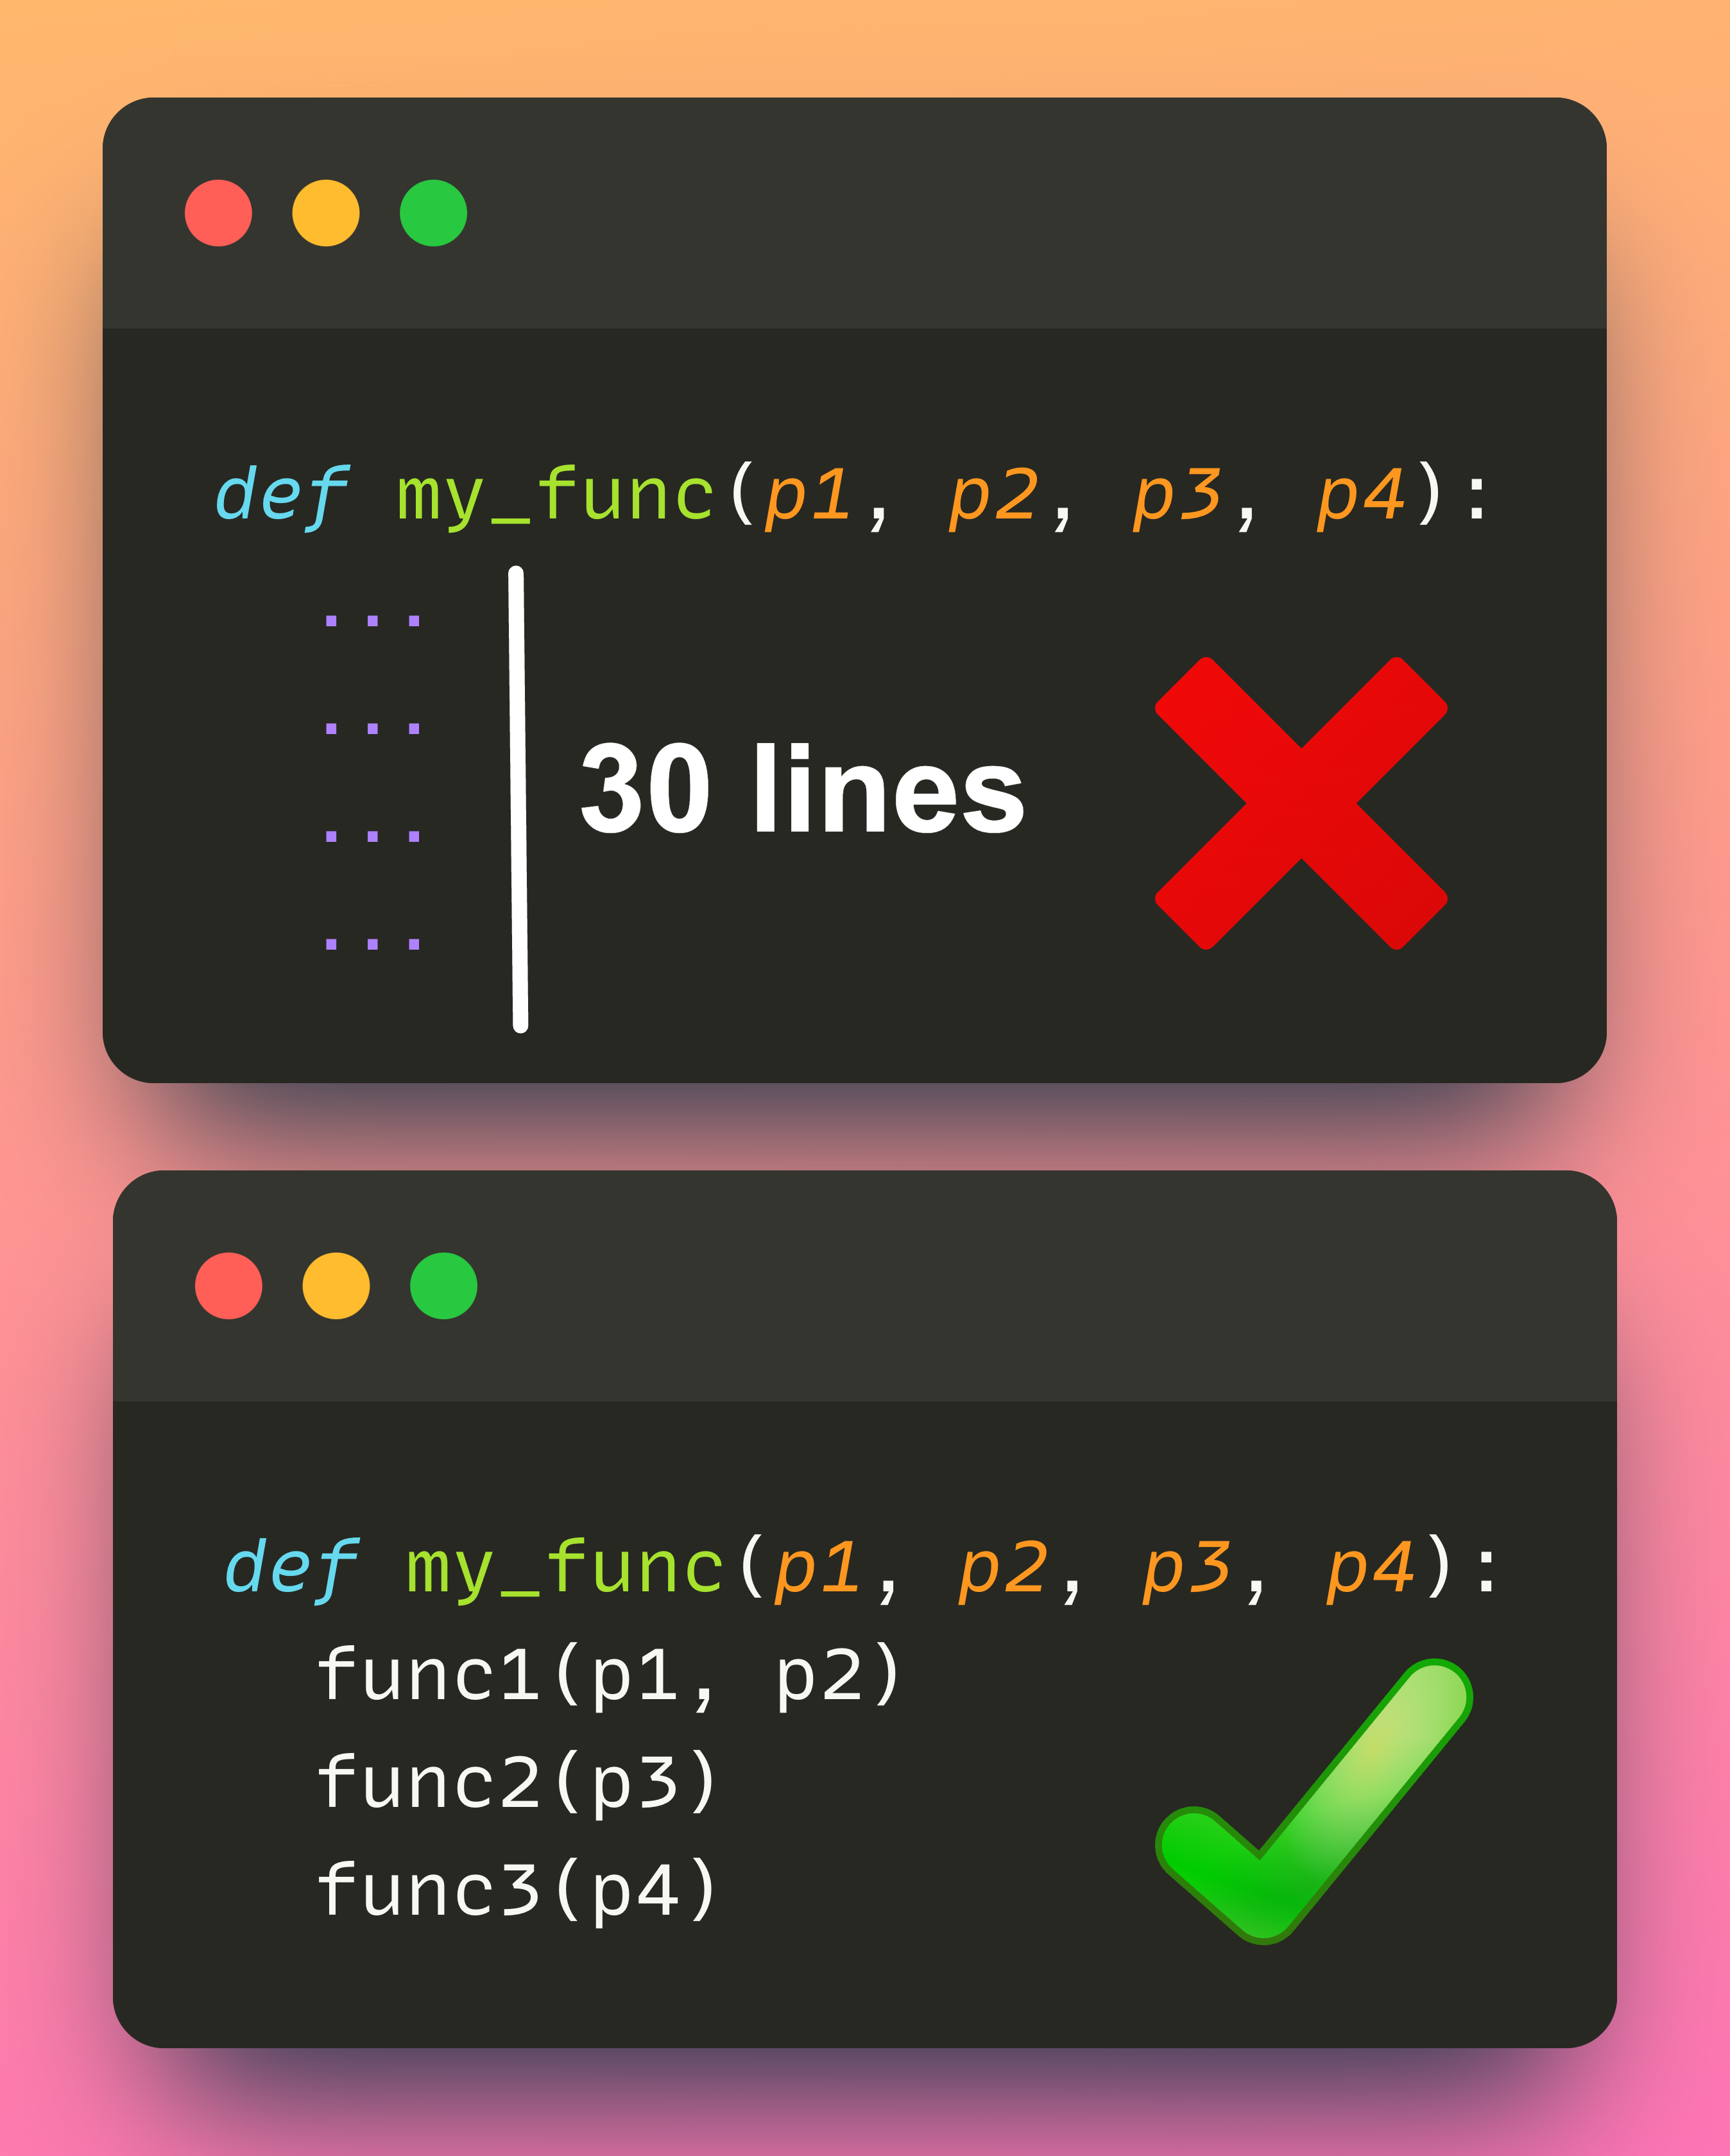
6 Best Practices to Write Reusable Python Functions | CodeCut
Tools | CodeCut
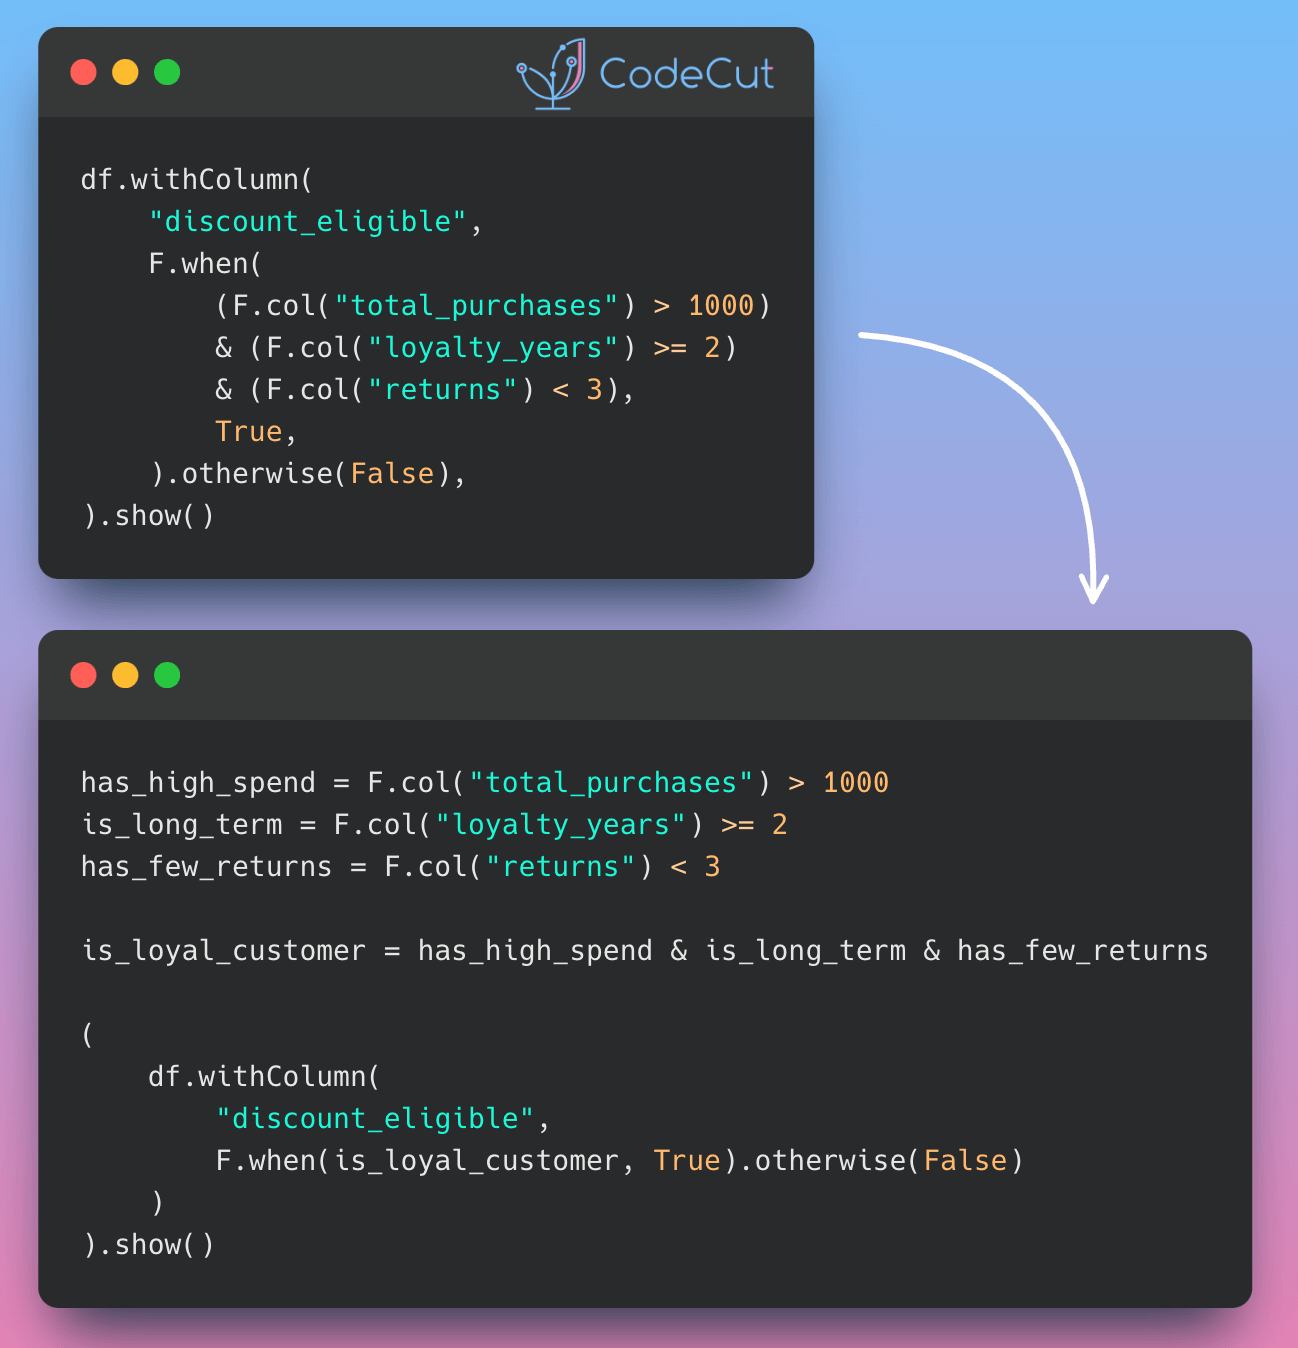
PySpark Best Practices: Simplifying Logical Chain Conditions | CodeCut
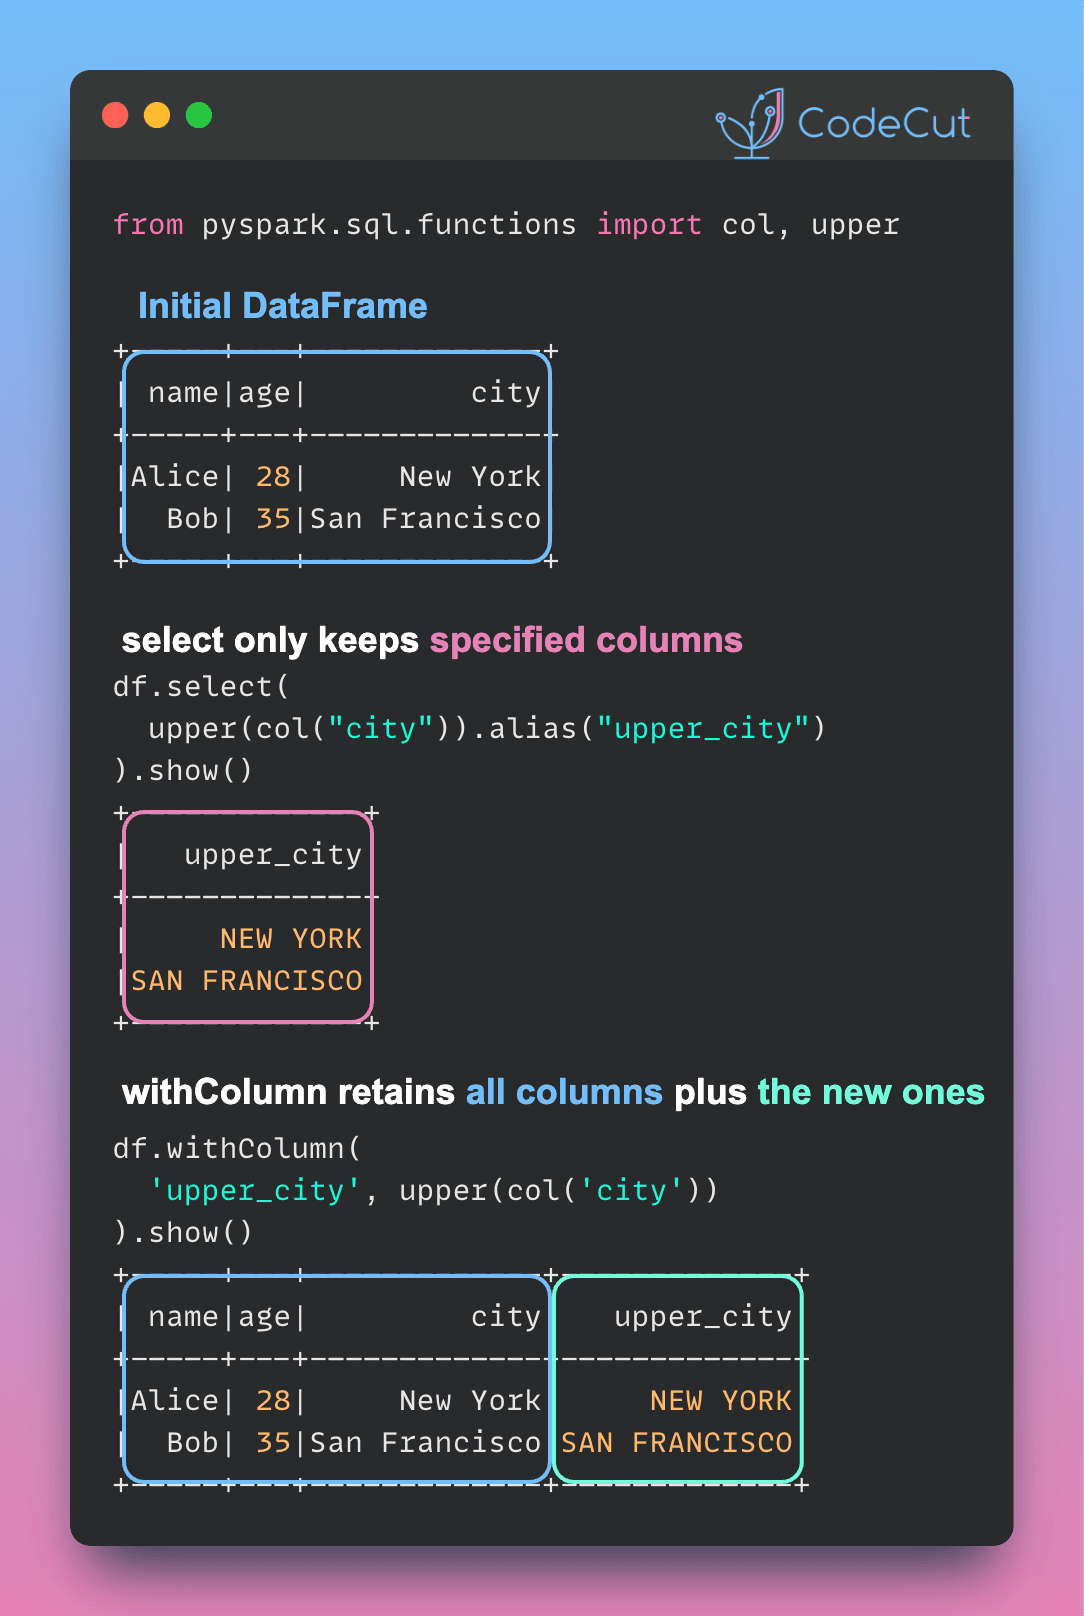
PySpark DataFrame Transformations: select vs withColumn | CodeCut
Dashboard | CodeCut
Color the Background of a pandas DataFrame in a Gradient Style | CodeCut
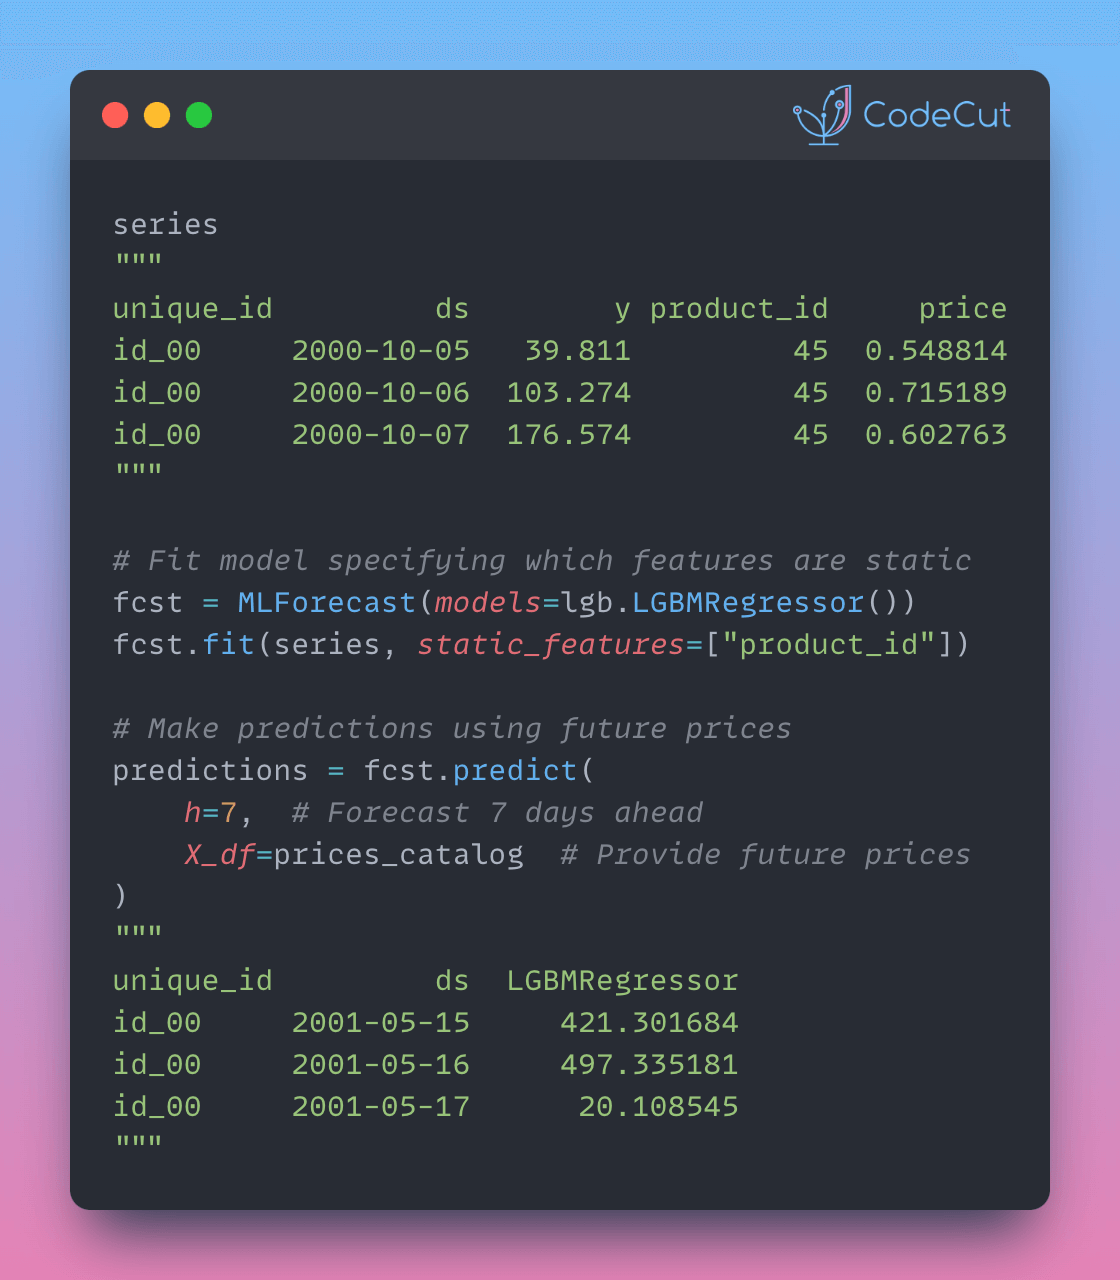
MLForecast: Automate External Feature Handling | CodeCut
5 Python Tools for Structured LLM Outputs: A Practical Comparison | CodeCut
Creating Venn Diagrams with Python using Matplotlib-Venn | CodeCut
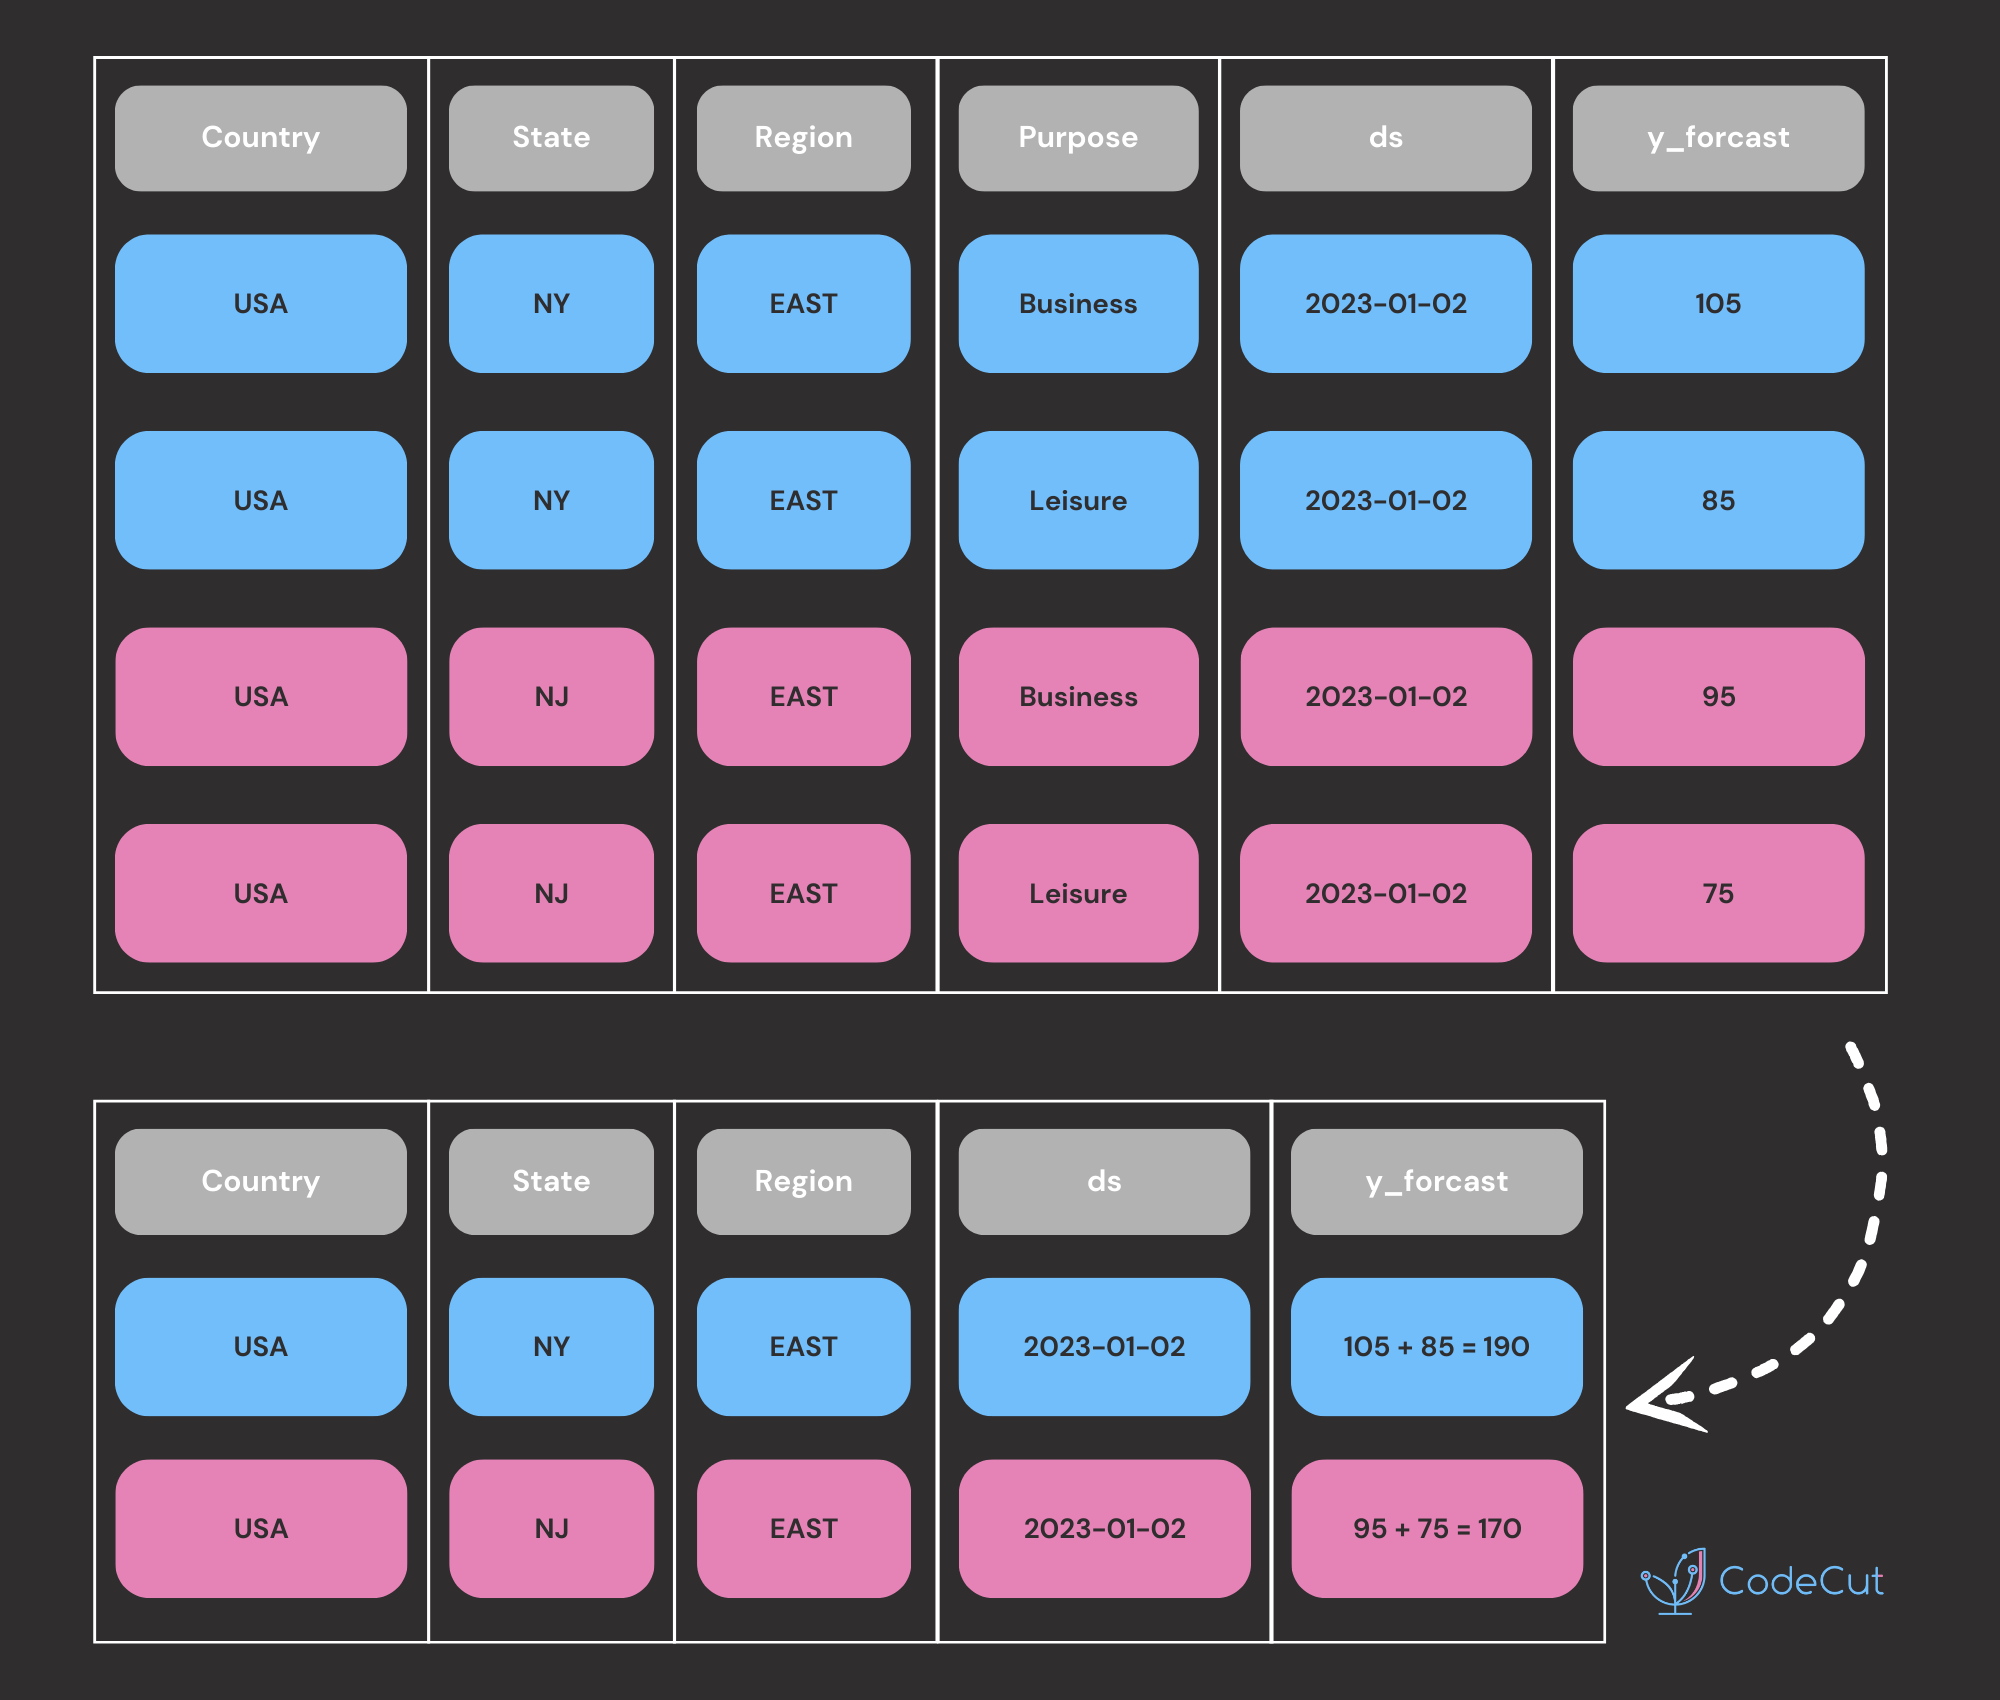
Hierarchical Forecasting in Python | CodeCut
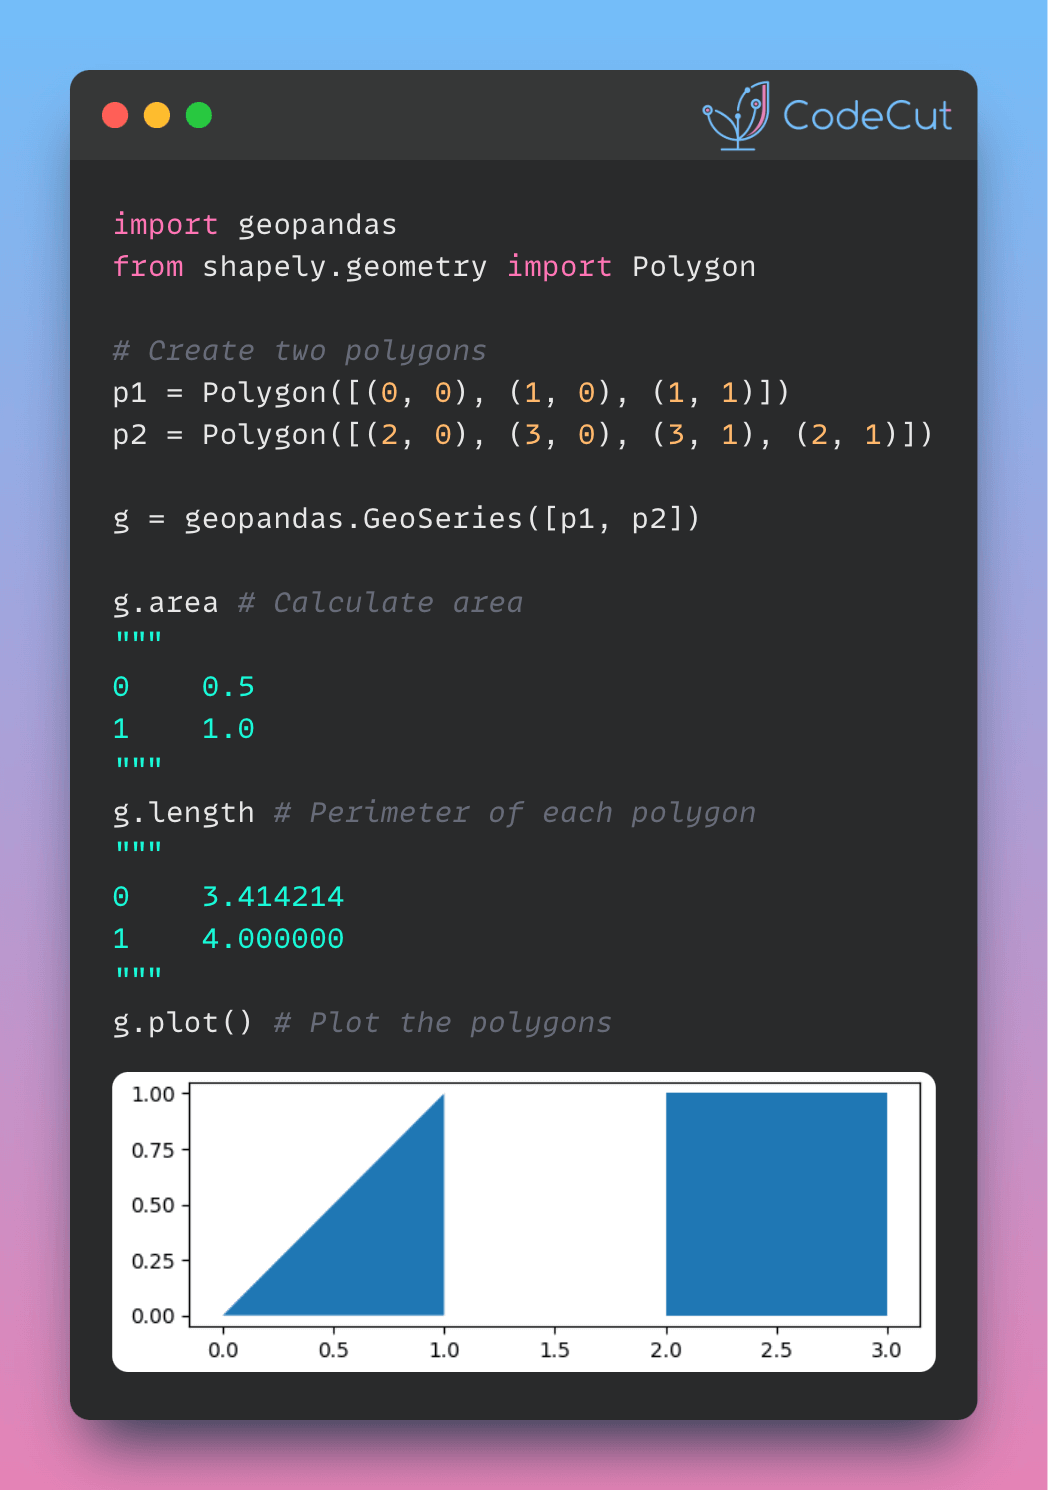
Simplifying Geographic Calculations with GeoPandas | CodeCut
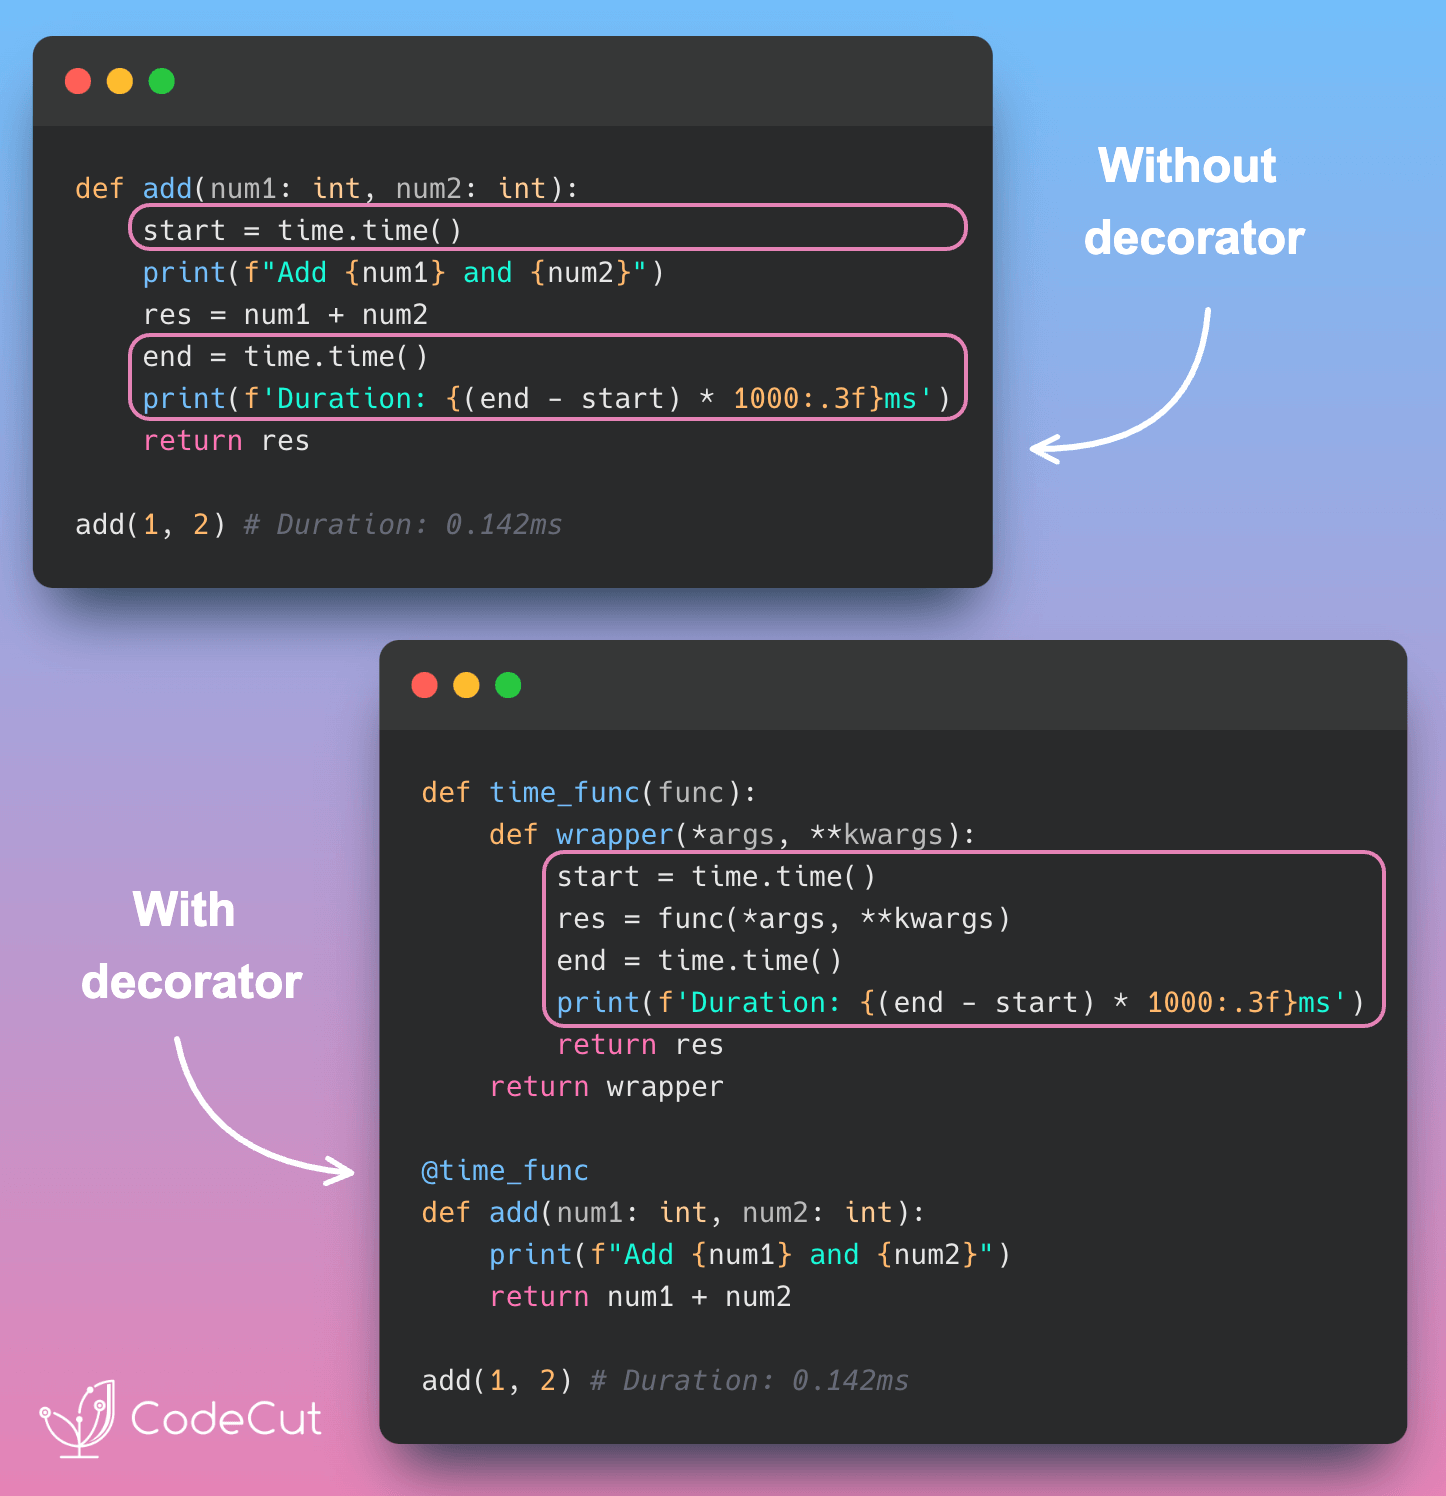
Writing Better Python: From Code Duplication to Decorators | CodeCut
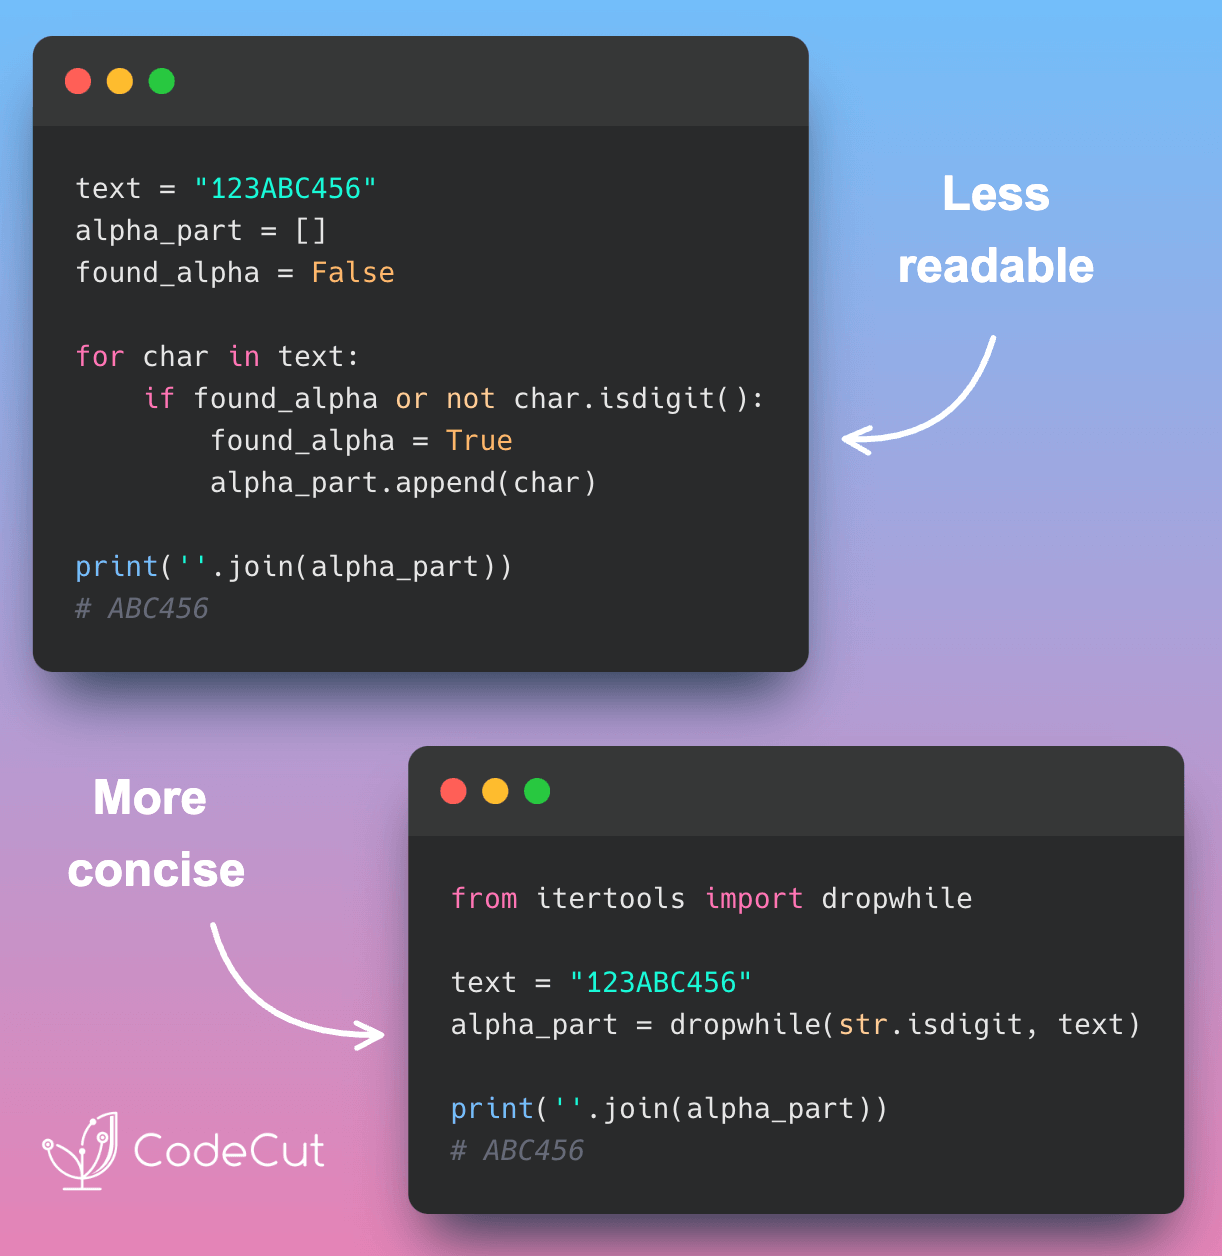
Python's dropwhile: A Clean Approach to Sequential Filtering | CodeCut
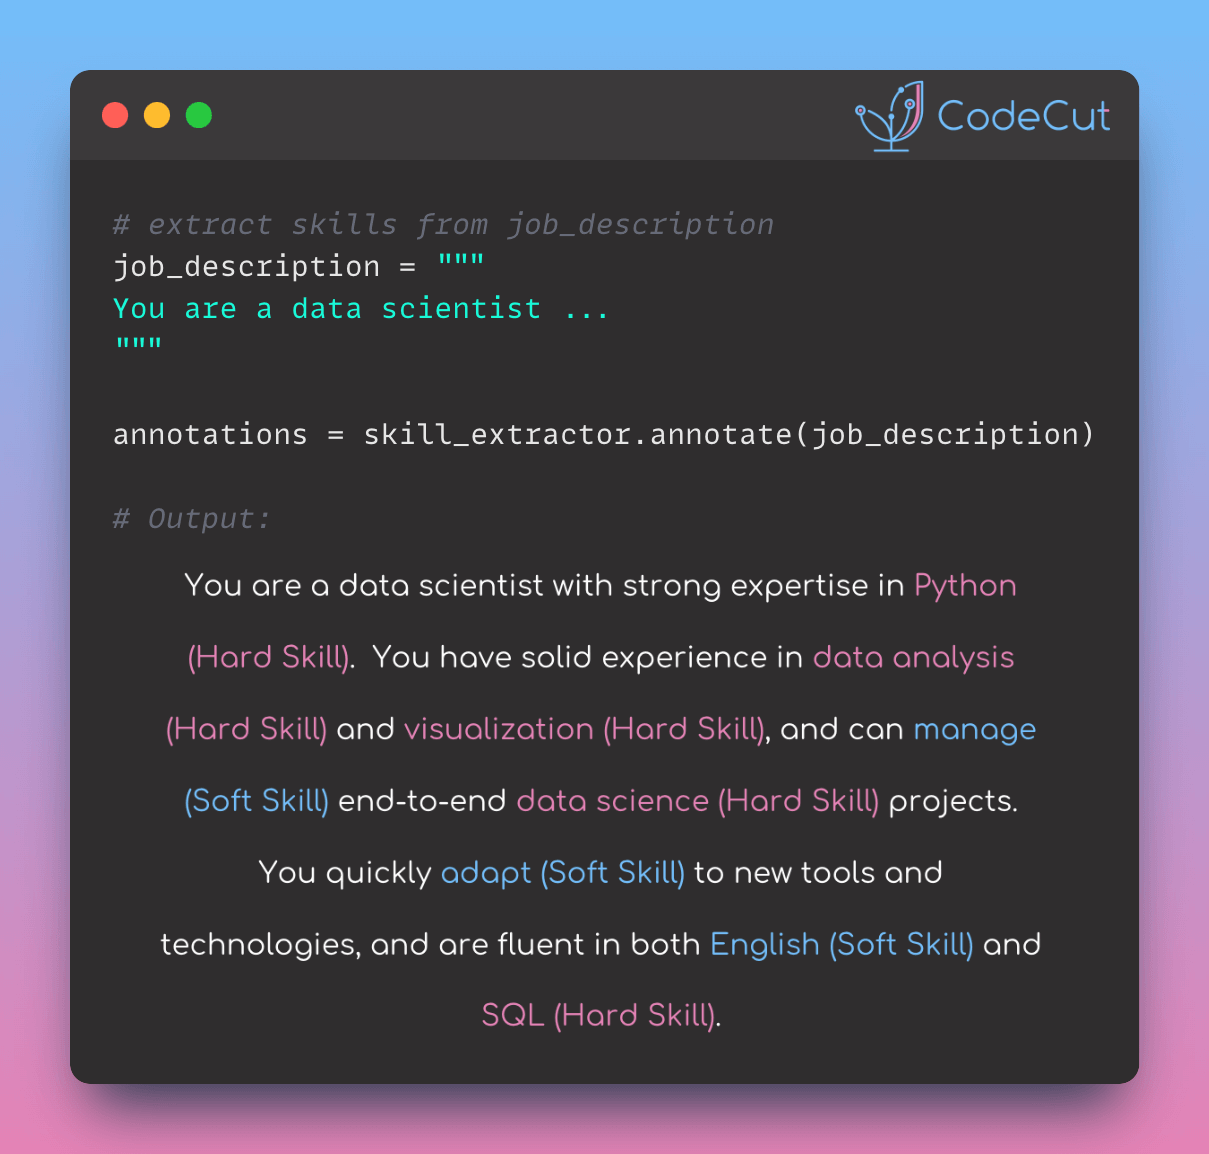
SkillNER: Automating Skill Extraction in Python | CodeCut
Flicking: Safe Model Deserialization in Python | CodeCut
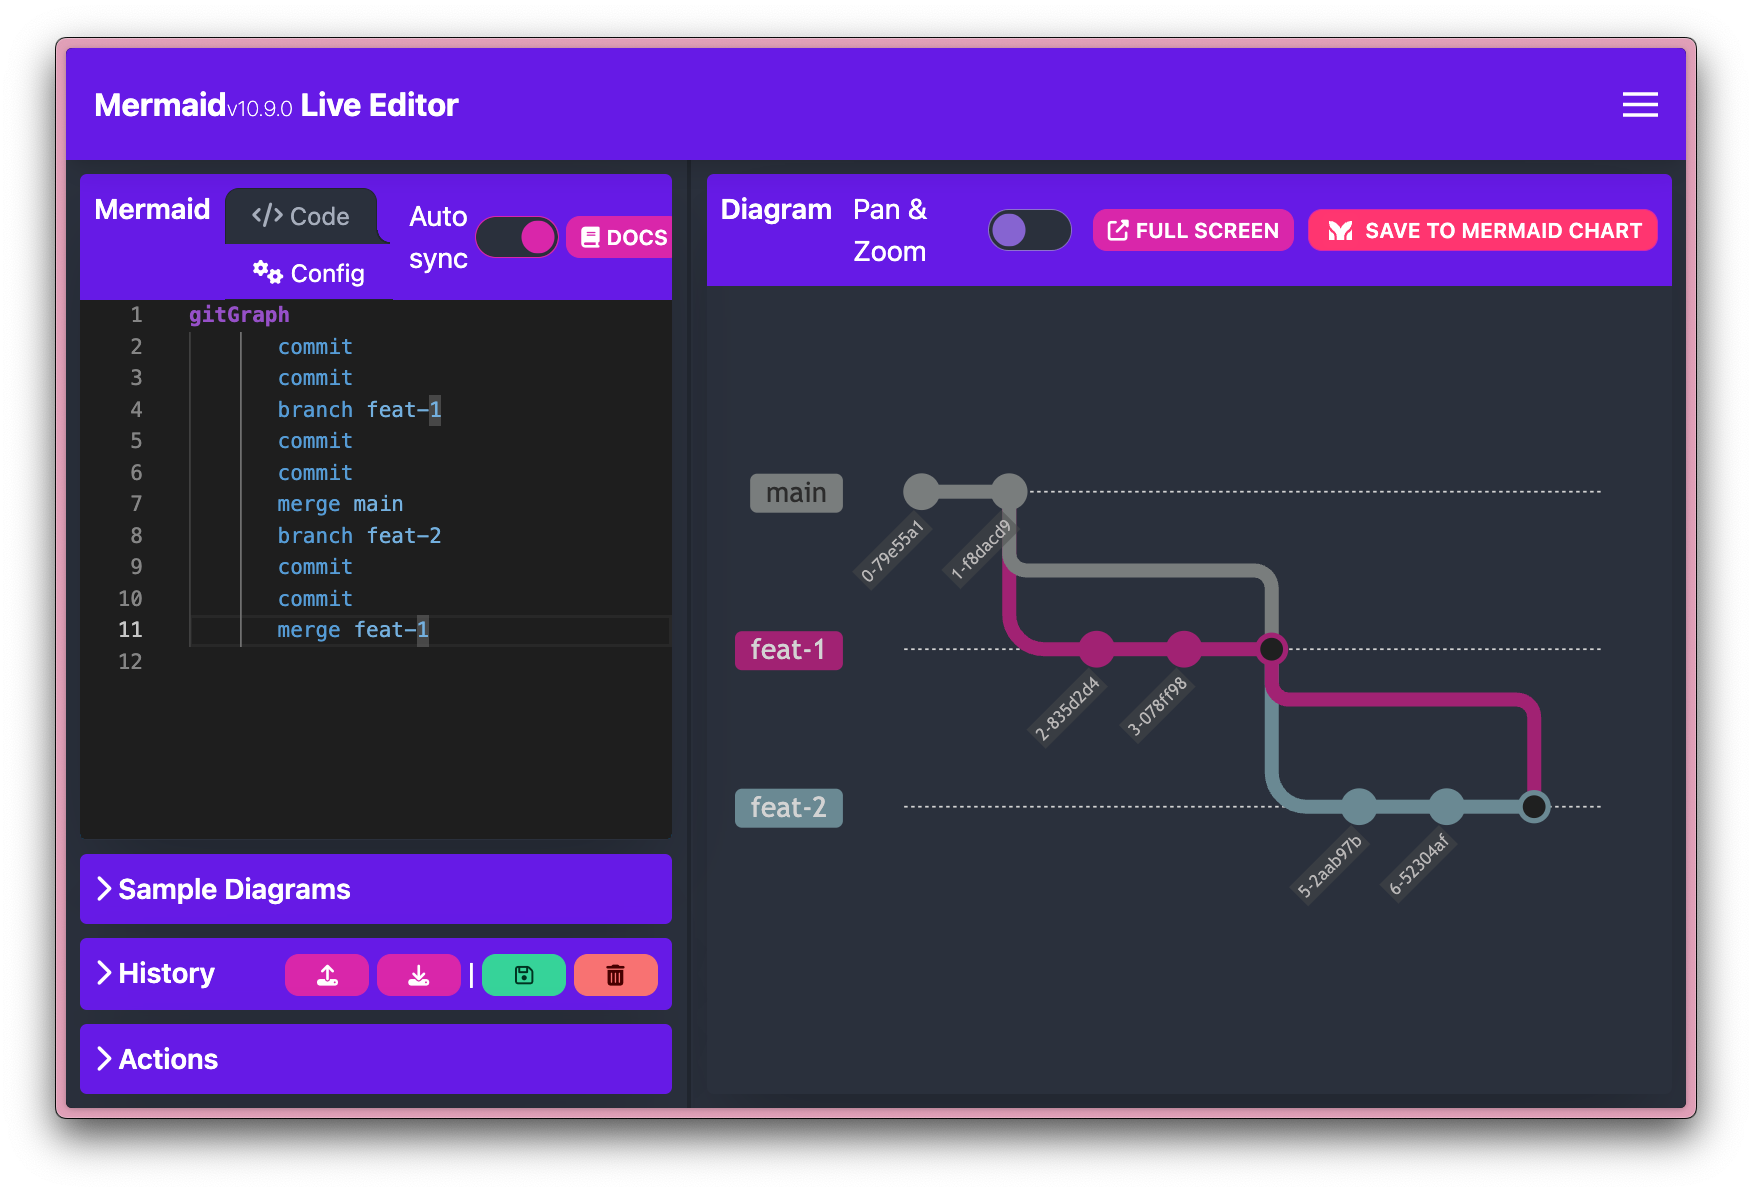
Leverage Mermaid for Real-Time Git Graph Rendering | CodeCut
Polars: Blazing Fast DataFrame Library | CodeCut
Machine Learning & AI | CodeCut
#pyspark #apachespark #dataengineering #sql | CodeCut
Databricks' Lakehouse architecture for data science | Khuyen Tran ...
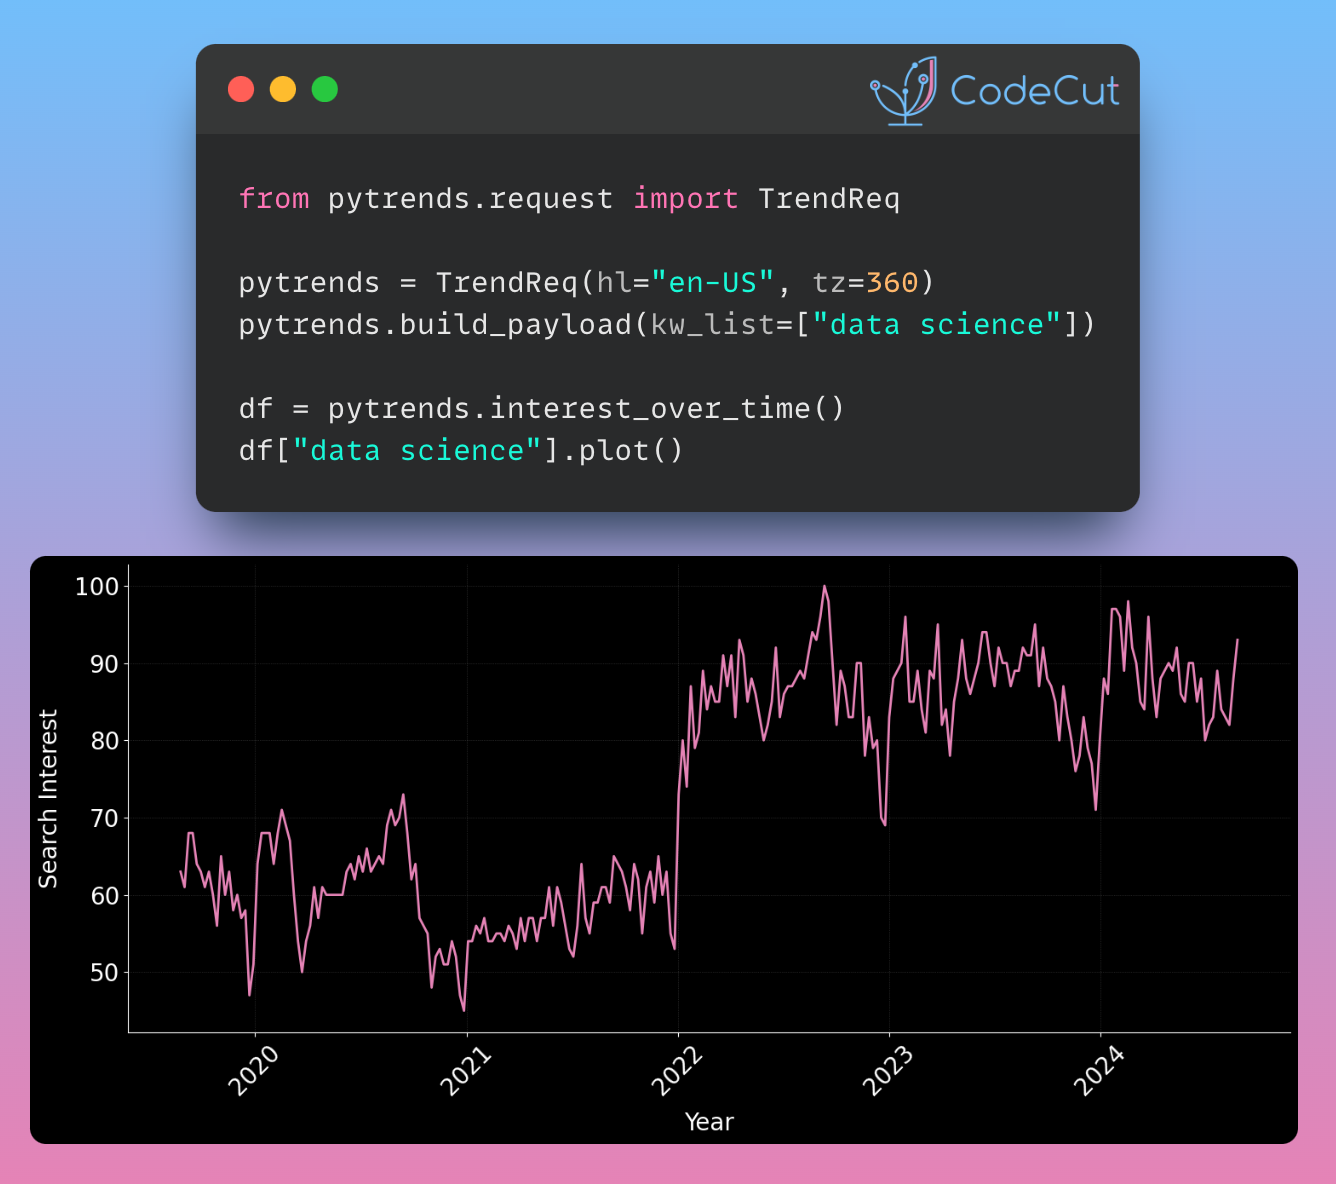
TimeSeriesSplit: How to split data chronologically | Khuyen Tran posted ...
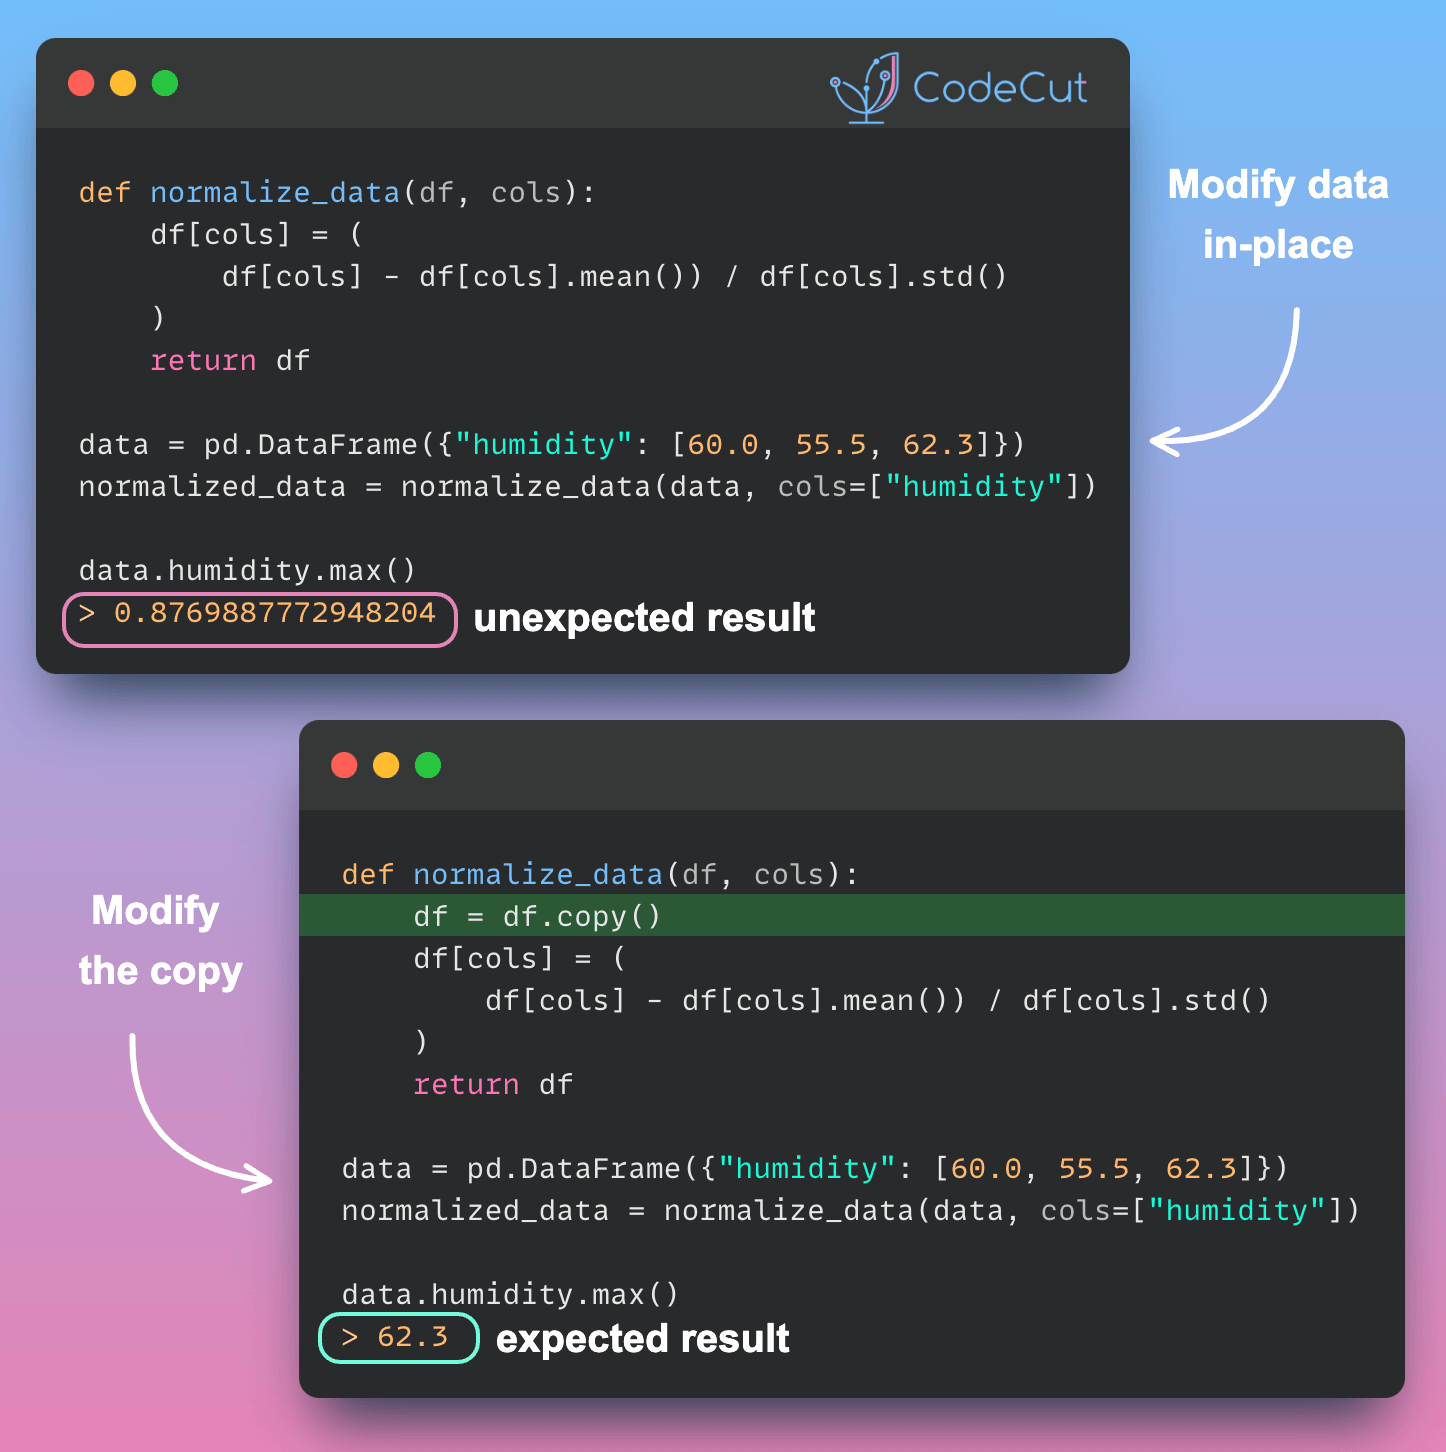
Copy First, Modify Later: Ensuring Data Integrity in Pandas Operations ...
#datascience #dataengineering | Khuyen Tran | 11 comments
#python #polars #pandas #performanceoptimization | Khuyen Tran
Khuyen Tran on LinkedIn: #python #timeseries #datascience | 11 comments
Embracing Duck Typing for Cleaner, More Adaptable Data Science Code ...
Venn Diagram Python R Transforming Data To Create Generalized,
#markdown #pdf | Khuyen Tran
#python | Khuyen Tran | 25 comments
#python | Khuyen Tran | 61 comments
Python 3.14 UUID v7 with Timestamp Ordering | Khuyen Tran posted on the ...
How to make Python scripts portable with uv | Khuyen Tran posted on the ...
#duckdb #polars #pandas #datascience | Paulo Cysne
#maplotlib #datavisualization | Khuyen Tran
F-strings have transformed string formatting in Python | Paulo Cysne
How DuckDB outperforms pandas for large datasets | Khuyen Tran posted ...
#python | Khuyen Tran | 11 comments
YAMAGIWA(ヤマギワ)ショク ペンダントライト ラージ 320F-532|THE CONRAN SHOP(コンランショップ) | The ...
Automate configuration validation with Pydantic-settings | Khuyen Tran ...
#python | Khuyen Tran
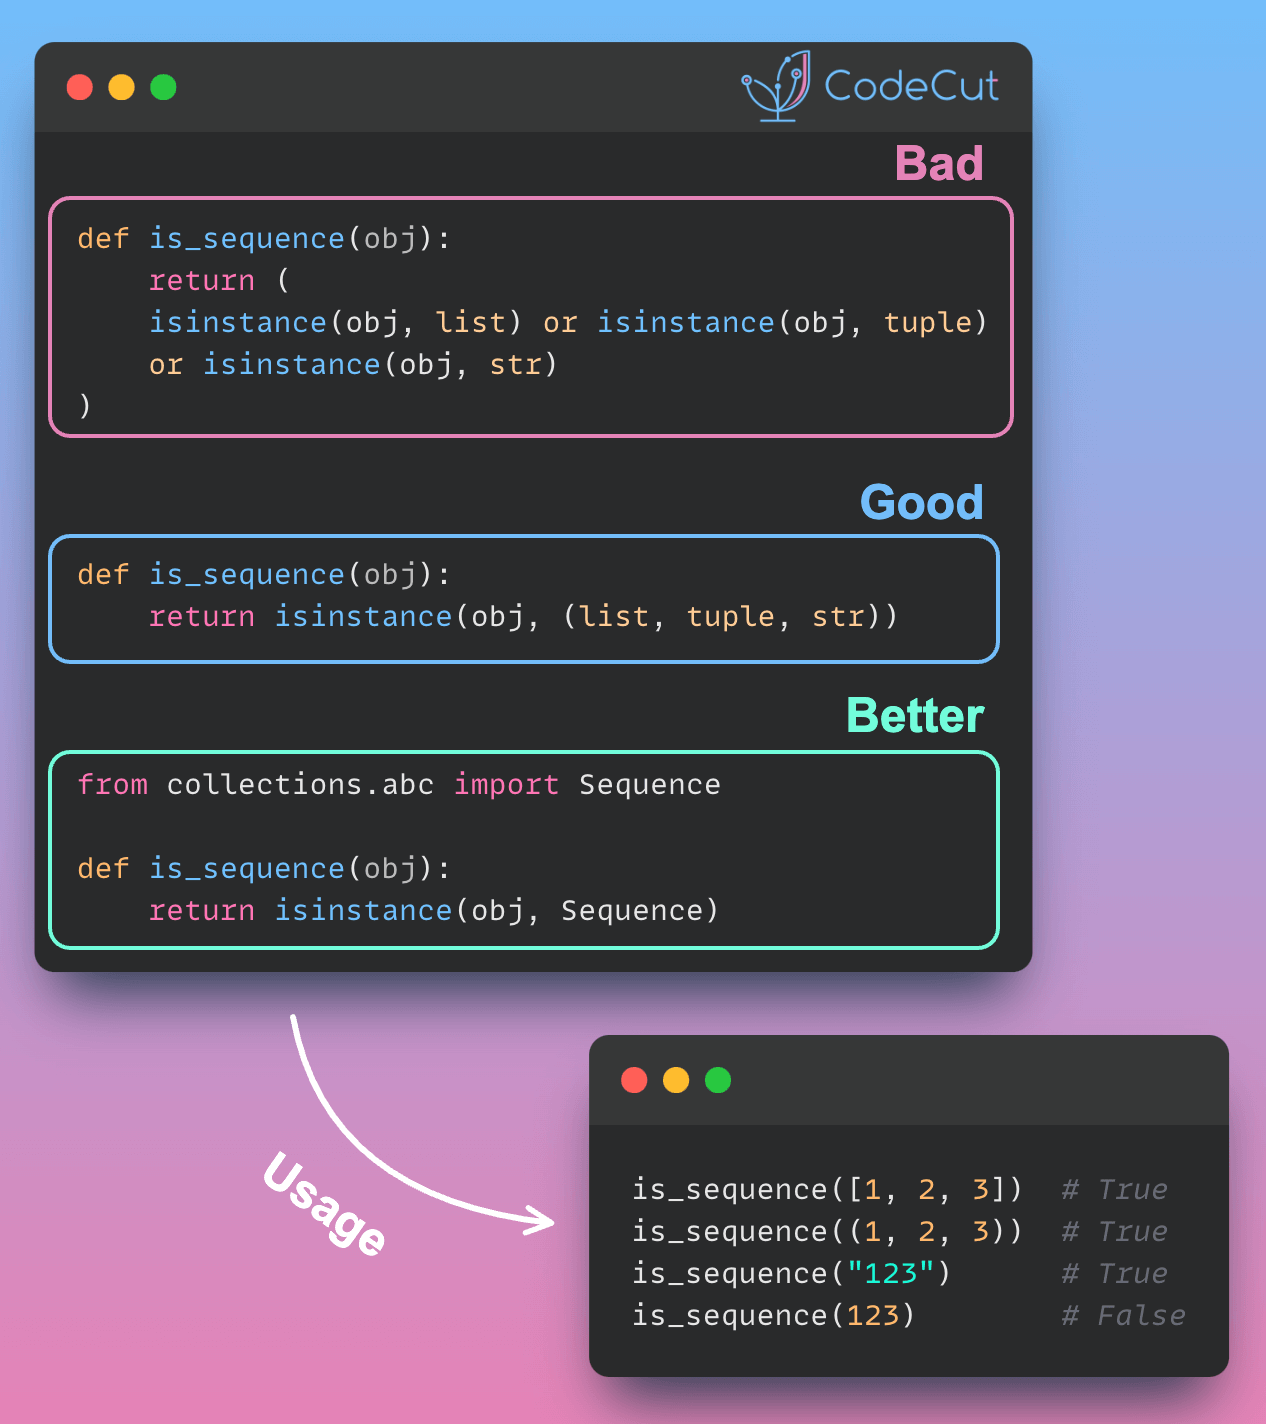
Simplify Multiple Type Checks in Python: Tuples and Abstract Base ...
Numpy Linspace Python
Grecia C. on LinkedIn: 💚🐍
Pulse · FirstClassML/codecut-blog · GitHub
Khuyen Tran on LinkedIn: #python #timeseries
Liangliang Cao posted on LinkedIn
Dr. Guillermo G Schiava D'Albano posted on LinkedIn
Khuyen Tran on LinkedIn: #python
Precious Oso posted on LinkedIn
Syed Ali Ameer posted on LinkedIn
Saksham Gupta posted on LinkedIn
#datascience #dataquality #python #datavalidation #dataanalytics ...
Samuel Chiji posted on LinkedIn
#python #programmingtips #codingbestpractices #softwaredevelopment ...
Farhan Jusoh posted on LinkedIn
Jack C Crawford on LinkedIn: L L M
Luis Guzman Lama posted on LinkedIn
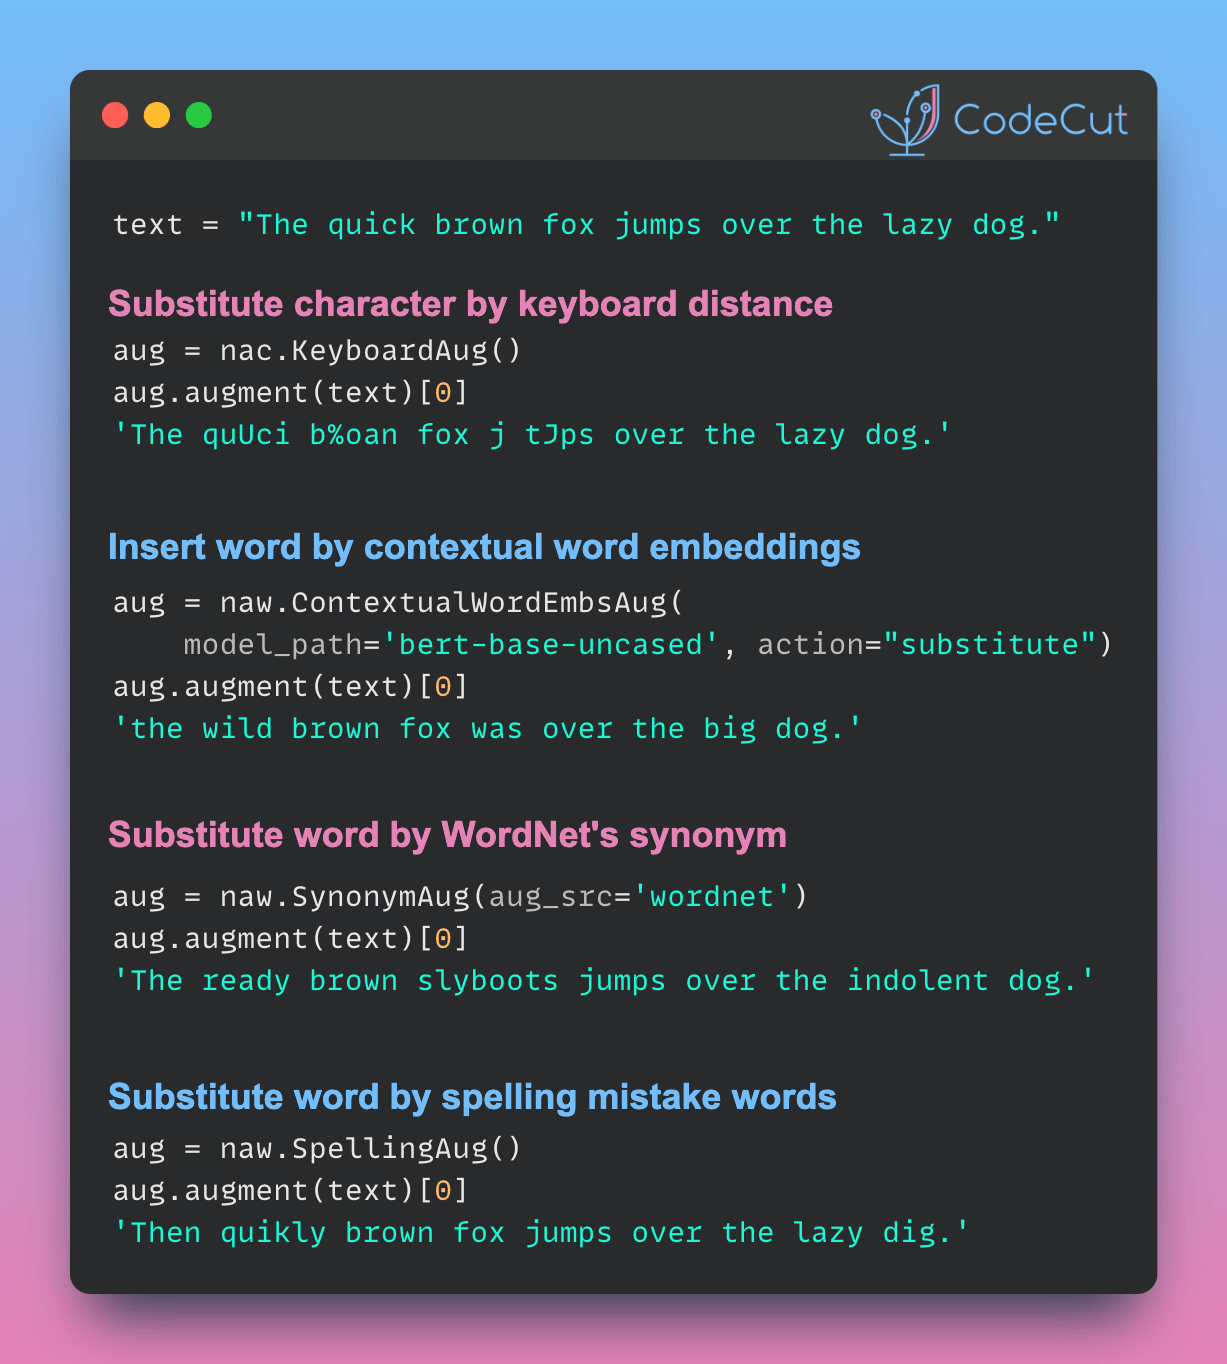
Nlp speed attraction 60 photos - Lomelono.com
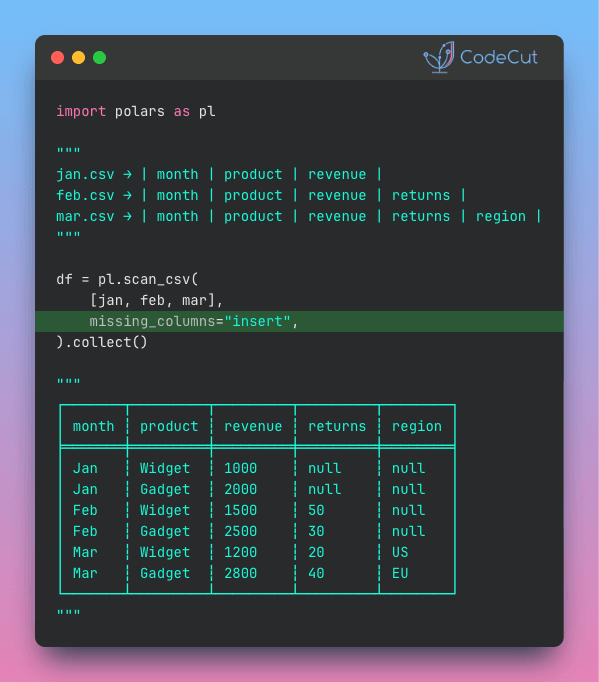
Polars scan_csv ahora puede unir CSVs con esquemas distintos · Bitácora ...
William Bouzek posted on LinkedIn
Charin Kumjudpai posted on LinkedIn
Khuyen Tran on LinkedIn: #python #datascience
Arthur Bernardo Assumpção Pinto posted on LinkedIn
Rogelio Rodriguez posted on LinkedIn