无需归一化的Transformer:动态Tanh(DyT)的效率提升是免费的午餐么? - 知乎
颠覆大模型归一化!Meta | 提出动态Tanh:DyT,无归一化的 Transformer 性能更强 - 知乎
Transformers without Normalization/去掉归一化的Transformer概要 - 知乎
凯明新作:Transformers without Normalization - 知乎
何恺明LeCun暴击Transformer命门,9行代码砍掉归一化层!性能反而更强了? - 知乎
Vision Backbone 超详细解读 (三十四):DyT:取代 Transformer 归一化层 - 知乎
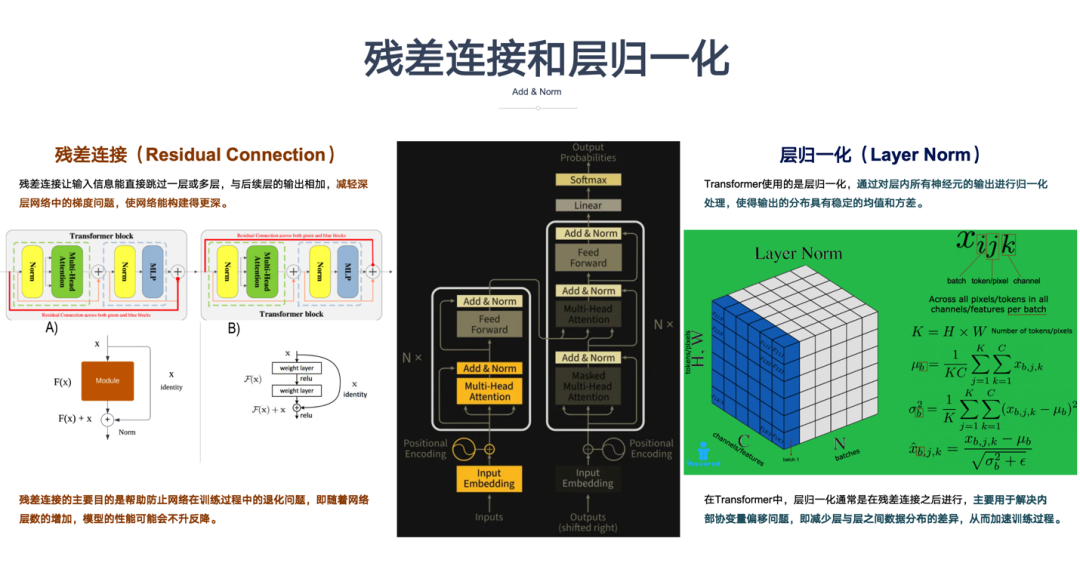
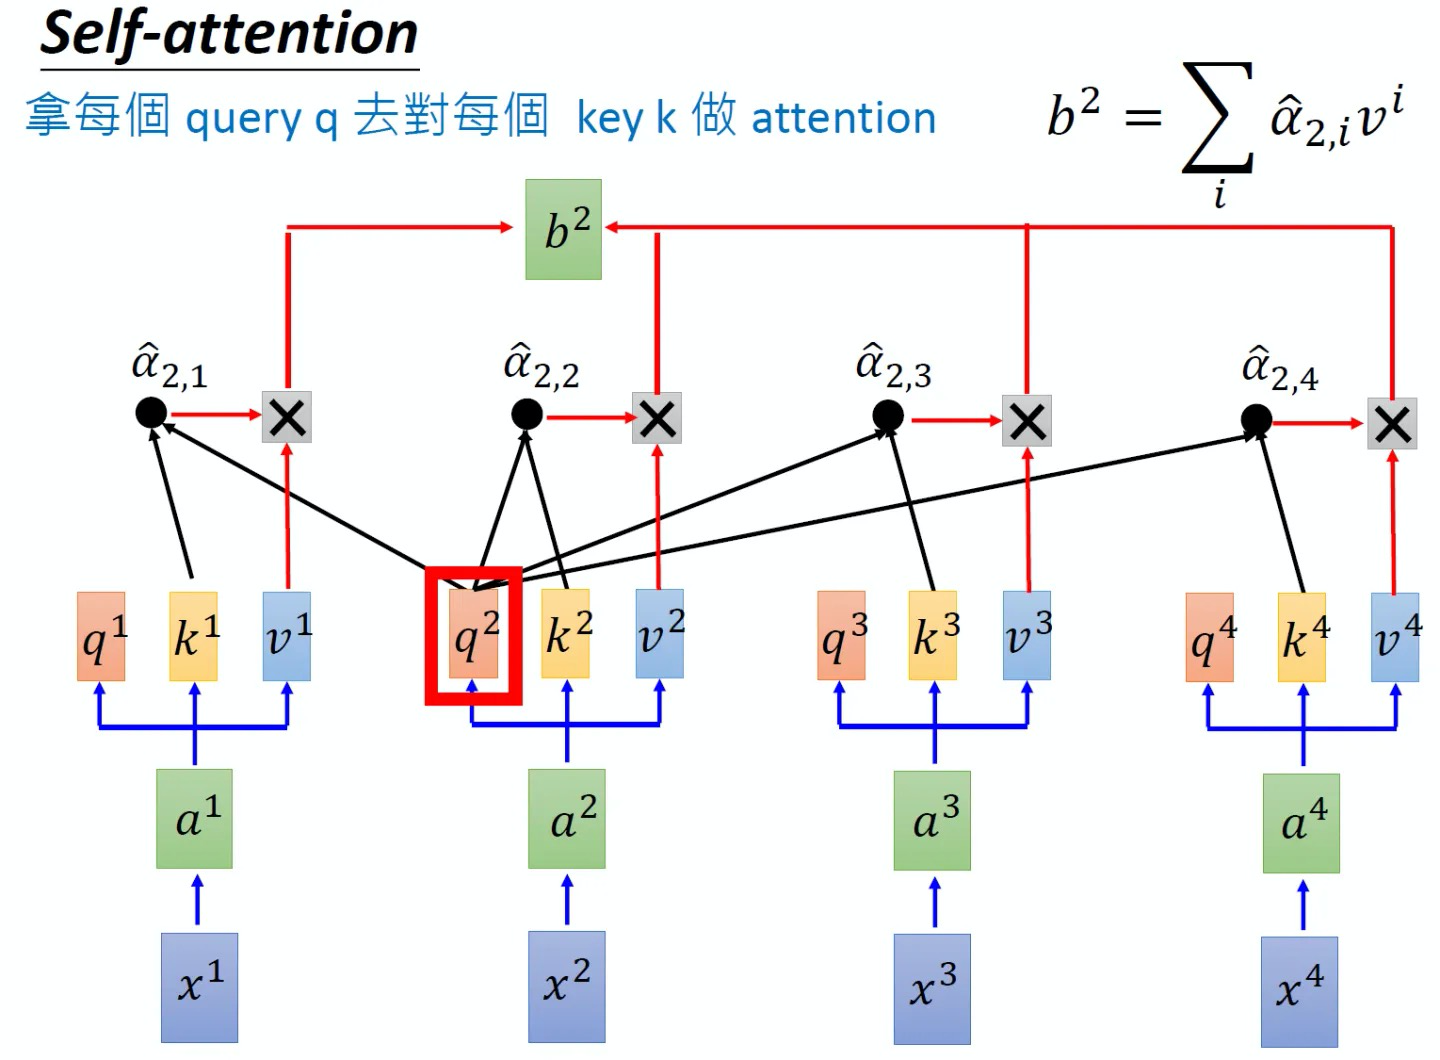
一文读懂: Transformer(详细但无代码) - 知乎
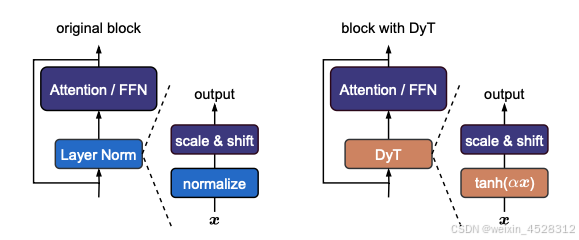
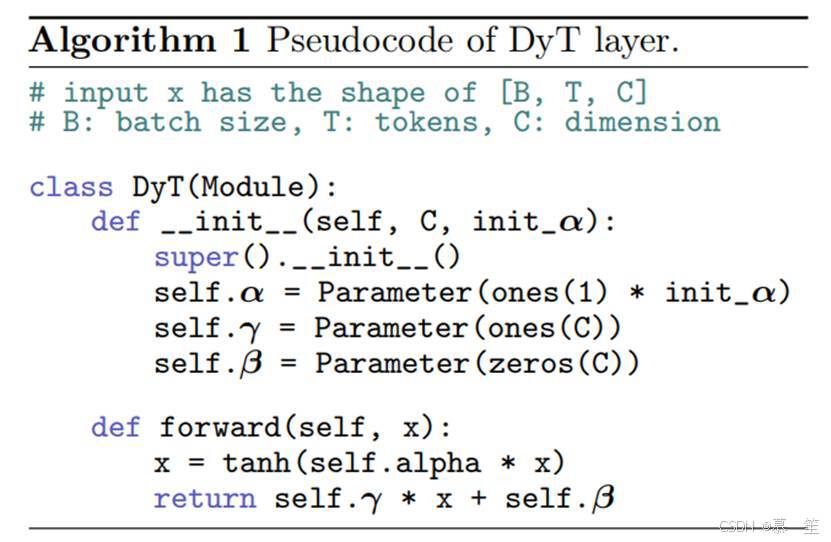
DyT:Transformer架构的革新,9行代码打破归一化层的“铁律” - 知乎
更强大的免归一化Transformer - AI论文精选
何恺明LeCun联手改造Transformer!9行代码替代归一化层,性能不减还加速 - 智源社区
何恺明LeCun暴击Transformer命门,9行代码砍掉归一化层!性能反而更强了? - 智源社区
颠覆大模型归一化!Meta | 提出动态Tanh:DyT,无归一化的 Transformer 性能更强_动态归一化-CSDN博客
无归一化Transformer:用Dynamic Tanh (DyT)取代层归一化(Layer Normalization, LN) – 思空,简观
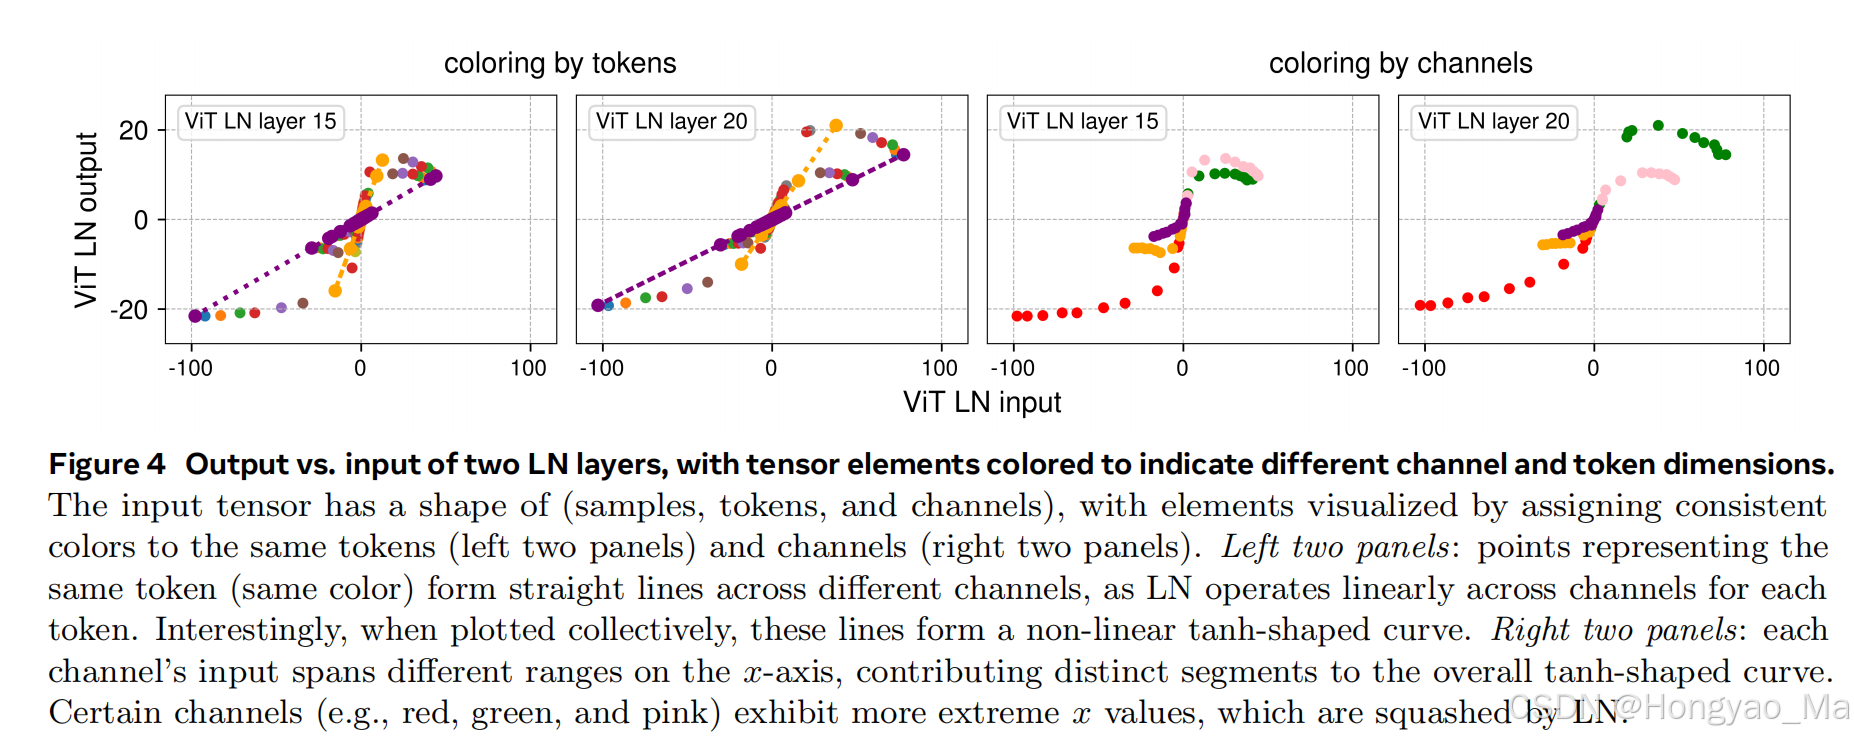
何凯明和Yann LeCun署名的文章—— 动态tanh(DyT):重新审视Transformer中的归一化层_dynamic tanh-CSDN博客
【Transformer】Transformers without Normalization_transformer without ...
Transformers without Normalization论文翻译_动态双曲正切函数 dyt-CSDN博客
【CVPR2025】计算机视觉|即插即用|DyT:Transformer优化新突破!DyT模块,性能提升不止一点点!-CSDN博客
清华姚班校友刘壮团队再发力,无需归一化的Transformer性能进化-腾讯云开发者社区-腾讯云
何恺明和LeCun新作:Transformer没有归一化层行吗?_何凯明和杨立昆-CSDN博客
Transformers without Normalization:归一化层在 Transformer 架构中必要性讨论-CSDN博客
大模型 | 一文彻底搞懂深度学习:Transformer,零基础入门到精通,收藏这篇就够了-CSDN博客
【Block总结】Dynamic Tanh (DyT)|即插即用|何凯明和Yann LeCun署名_dynamic tanh论文链接-CSDN博客
Dynamic Tanh DyT: A Simplified Alternative to Normalization in ...
【人工智能】DyT干掉Transformer归一化层 | 动态Tanh | 9行代码 | 性能不降反升 | 何恺明杨立昆携手 | 多项任务验证 ...
YOLO12 改进|Dynamic Tanh(DyT)减少背景噪声干扰,尤其在复杂场景下(如多目标重叠、低分辨率目标)提升检测准确率 ...
Transformers without Normalization——无需归一化的Transformer-CSDN博客
重磅论文!何恺明、Yann LeCun等改造Transformer,CVPR 2025已收录_腾讯新闻
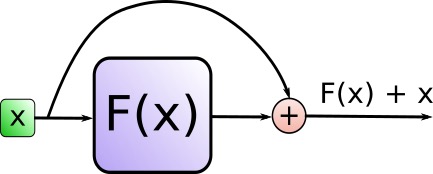
Transformer架构大创新?无残差连接或归一化层,也能成功训练深度transformer-极市开发者社区
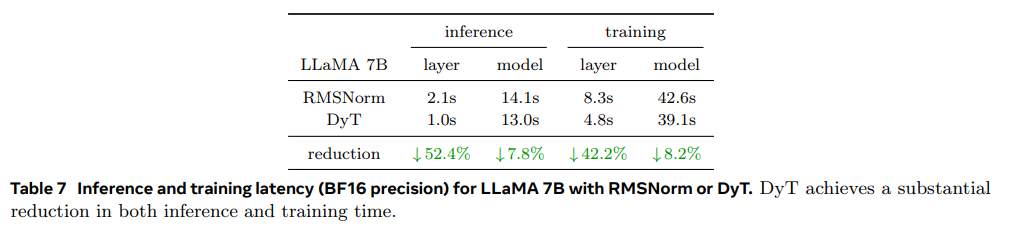
DyT新技术:无需归一化层的Transformer实现高效训练与推理 | AI工具箱
从零实现Transformer的简易版与强大版:从300多行到3000多行_用transformer从零训练大模型-CSDN博客
Transformers without Normalization | Zhangzhe's Blog
Program to Find the Correlation Coefficient | by Shlok Kumar | Mar ...