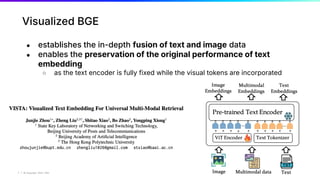
VISTA: Visualized Text Embedding For Universal Multi-Modal Retrieval ...
[논문 리뷰] VISTA: Visualized Text Embedding For Universal Multi-Modal ...
Paper page - VISTA: Visualized Text Embedding For Universal Multi-Modal ...
【论文笔记】VISTA: Visualized Text Embedding For Universal Multi-Modal ...
论文阅读:VISTA: Visualized Text Embedding For Universal Multi-Modal ...
[论文评述] UniRAG: Universal Retrieval Augmentation for Multi-Modal Large ...
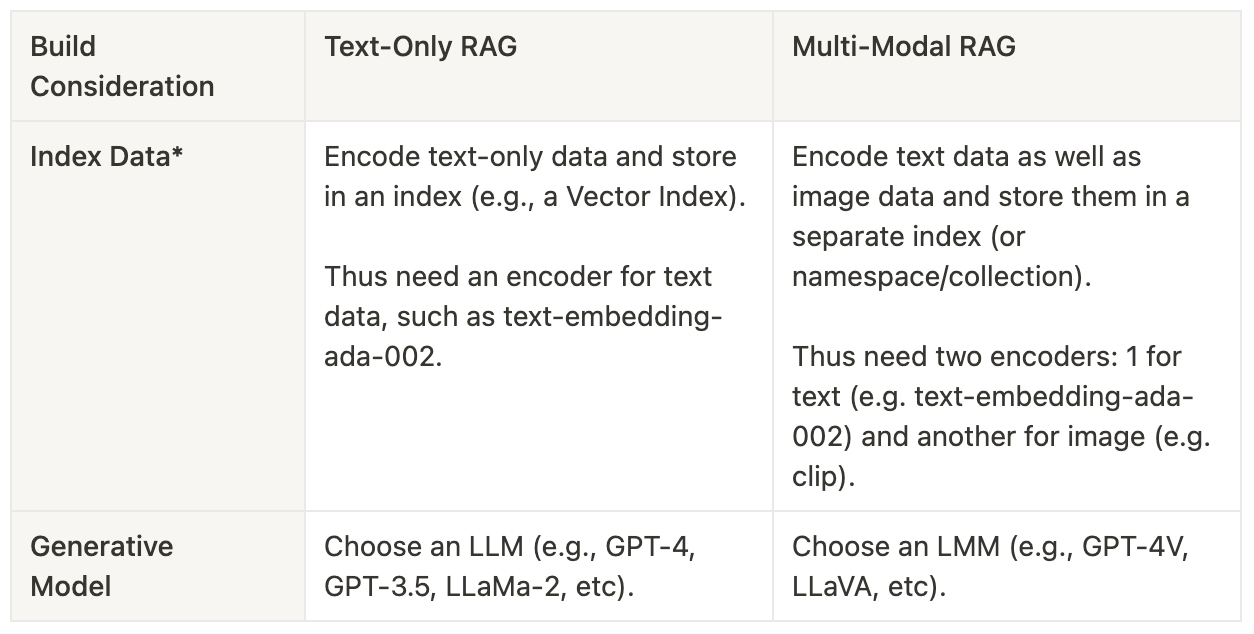
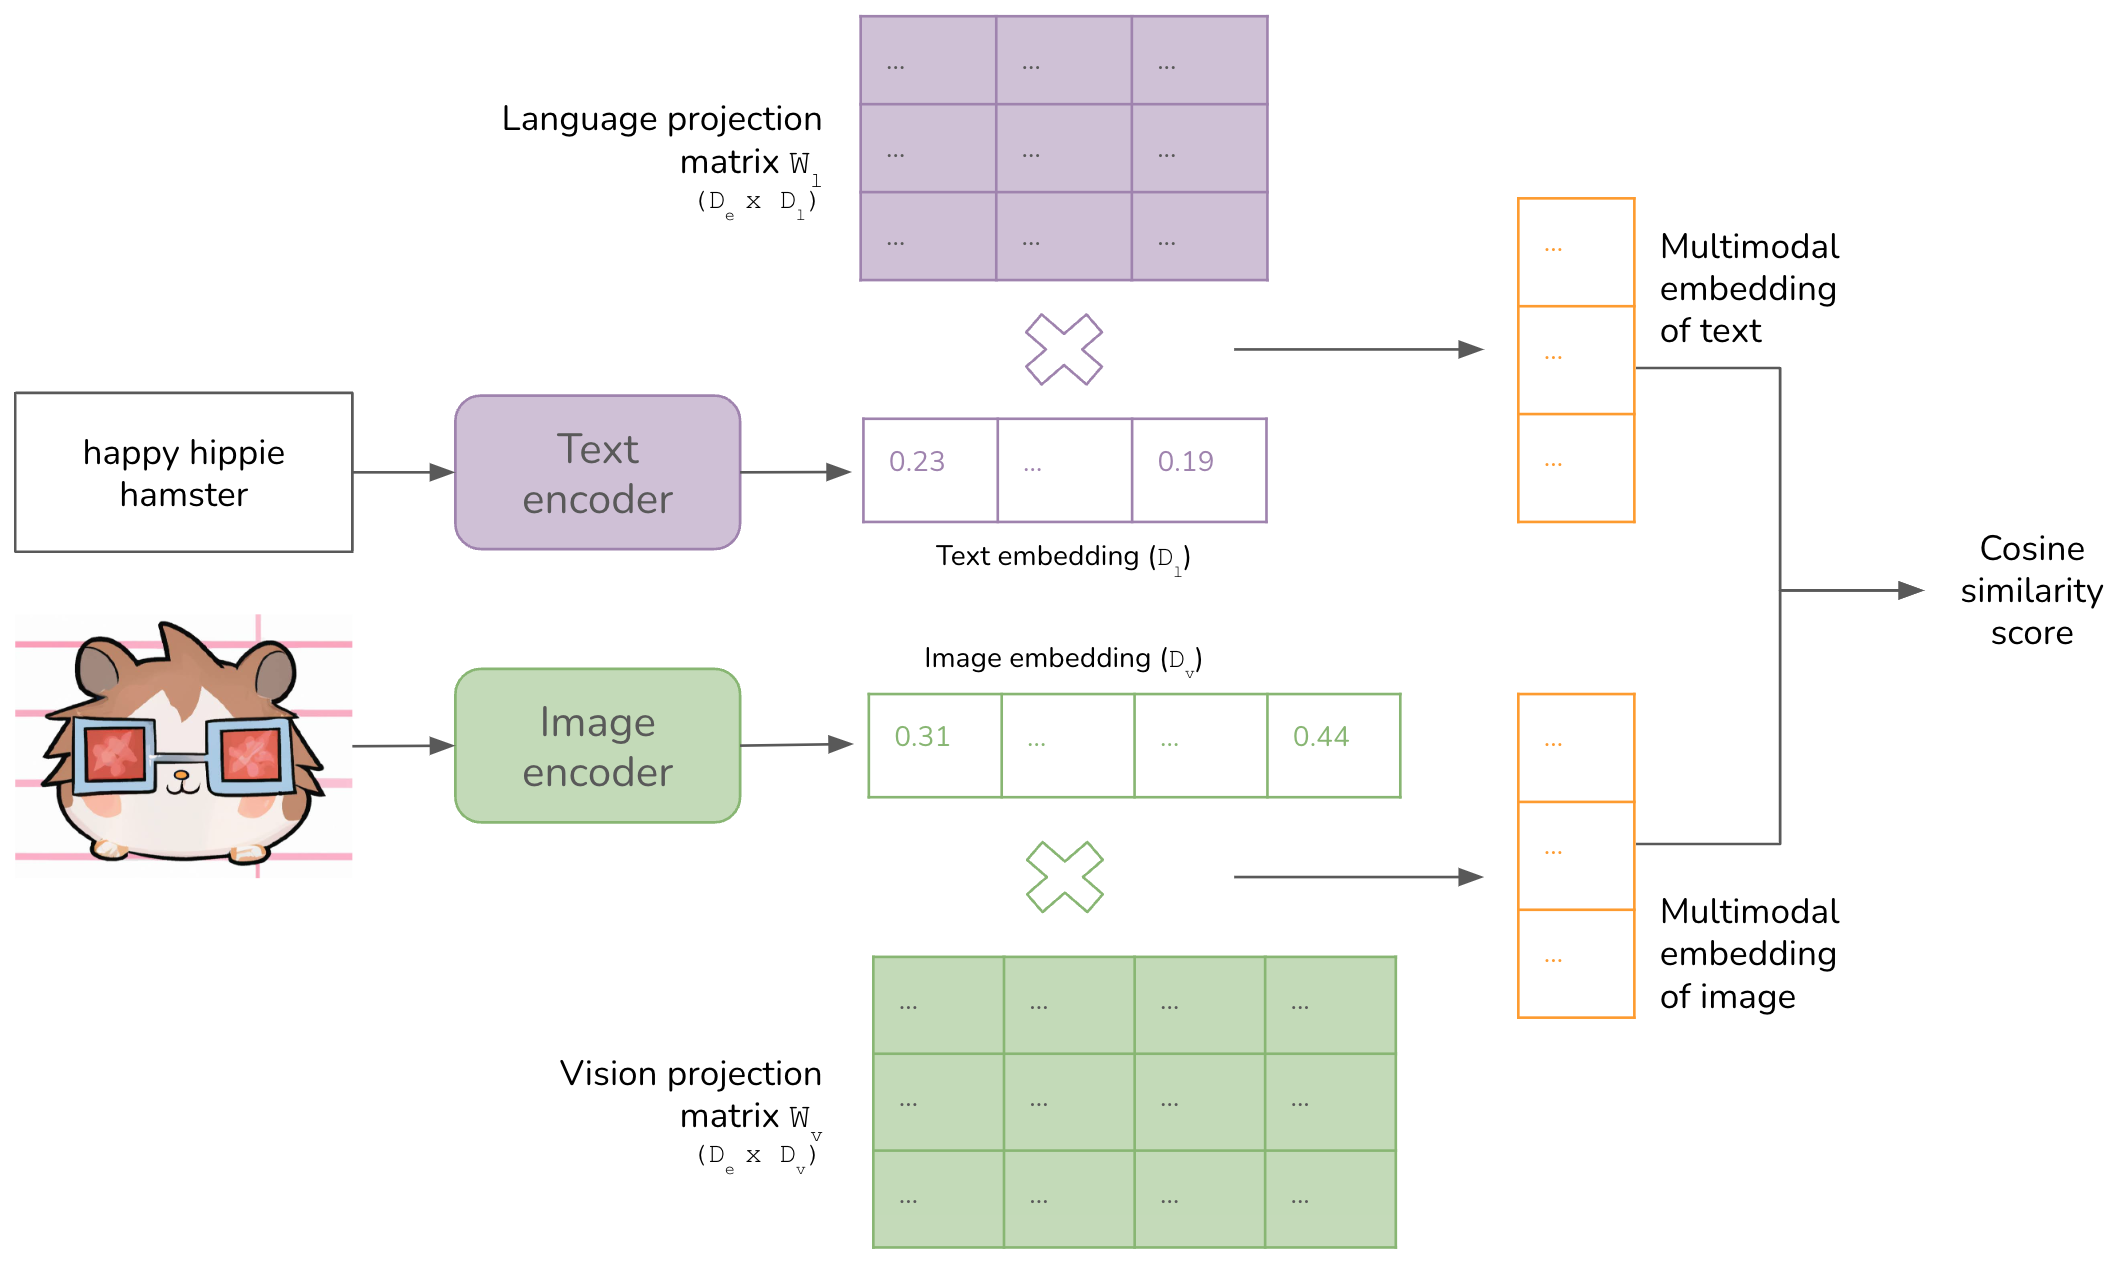
Multi-Modal Retrieval using GPT text embedding and CLIP image embedding ...
(PDF) Adversarial Attentive Multi-Modal Embedding Learning for Image ...
(PDF) Structured Multi-modal Feature Embedding and Alignment for Image ...
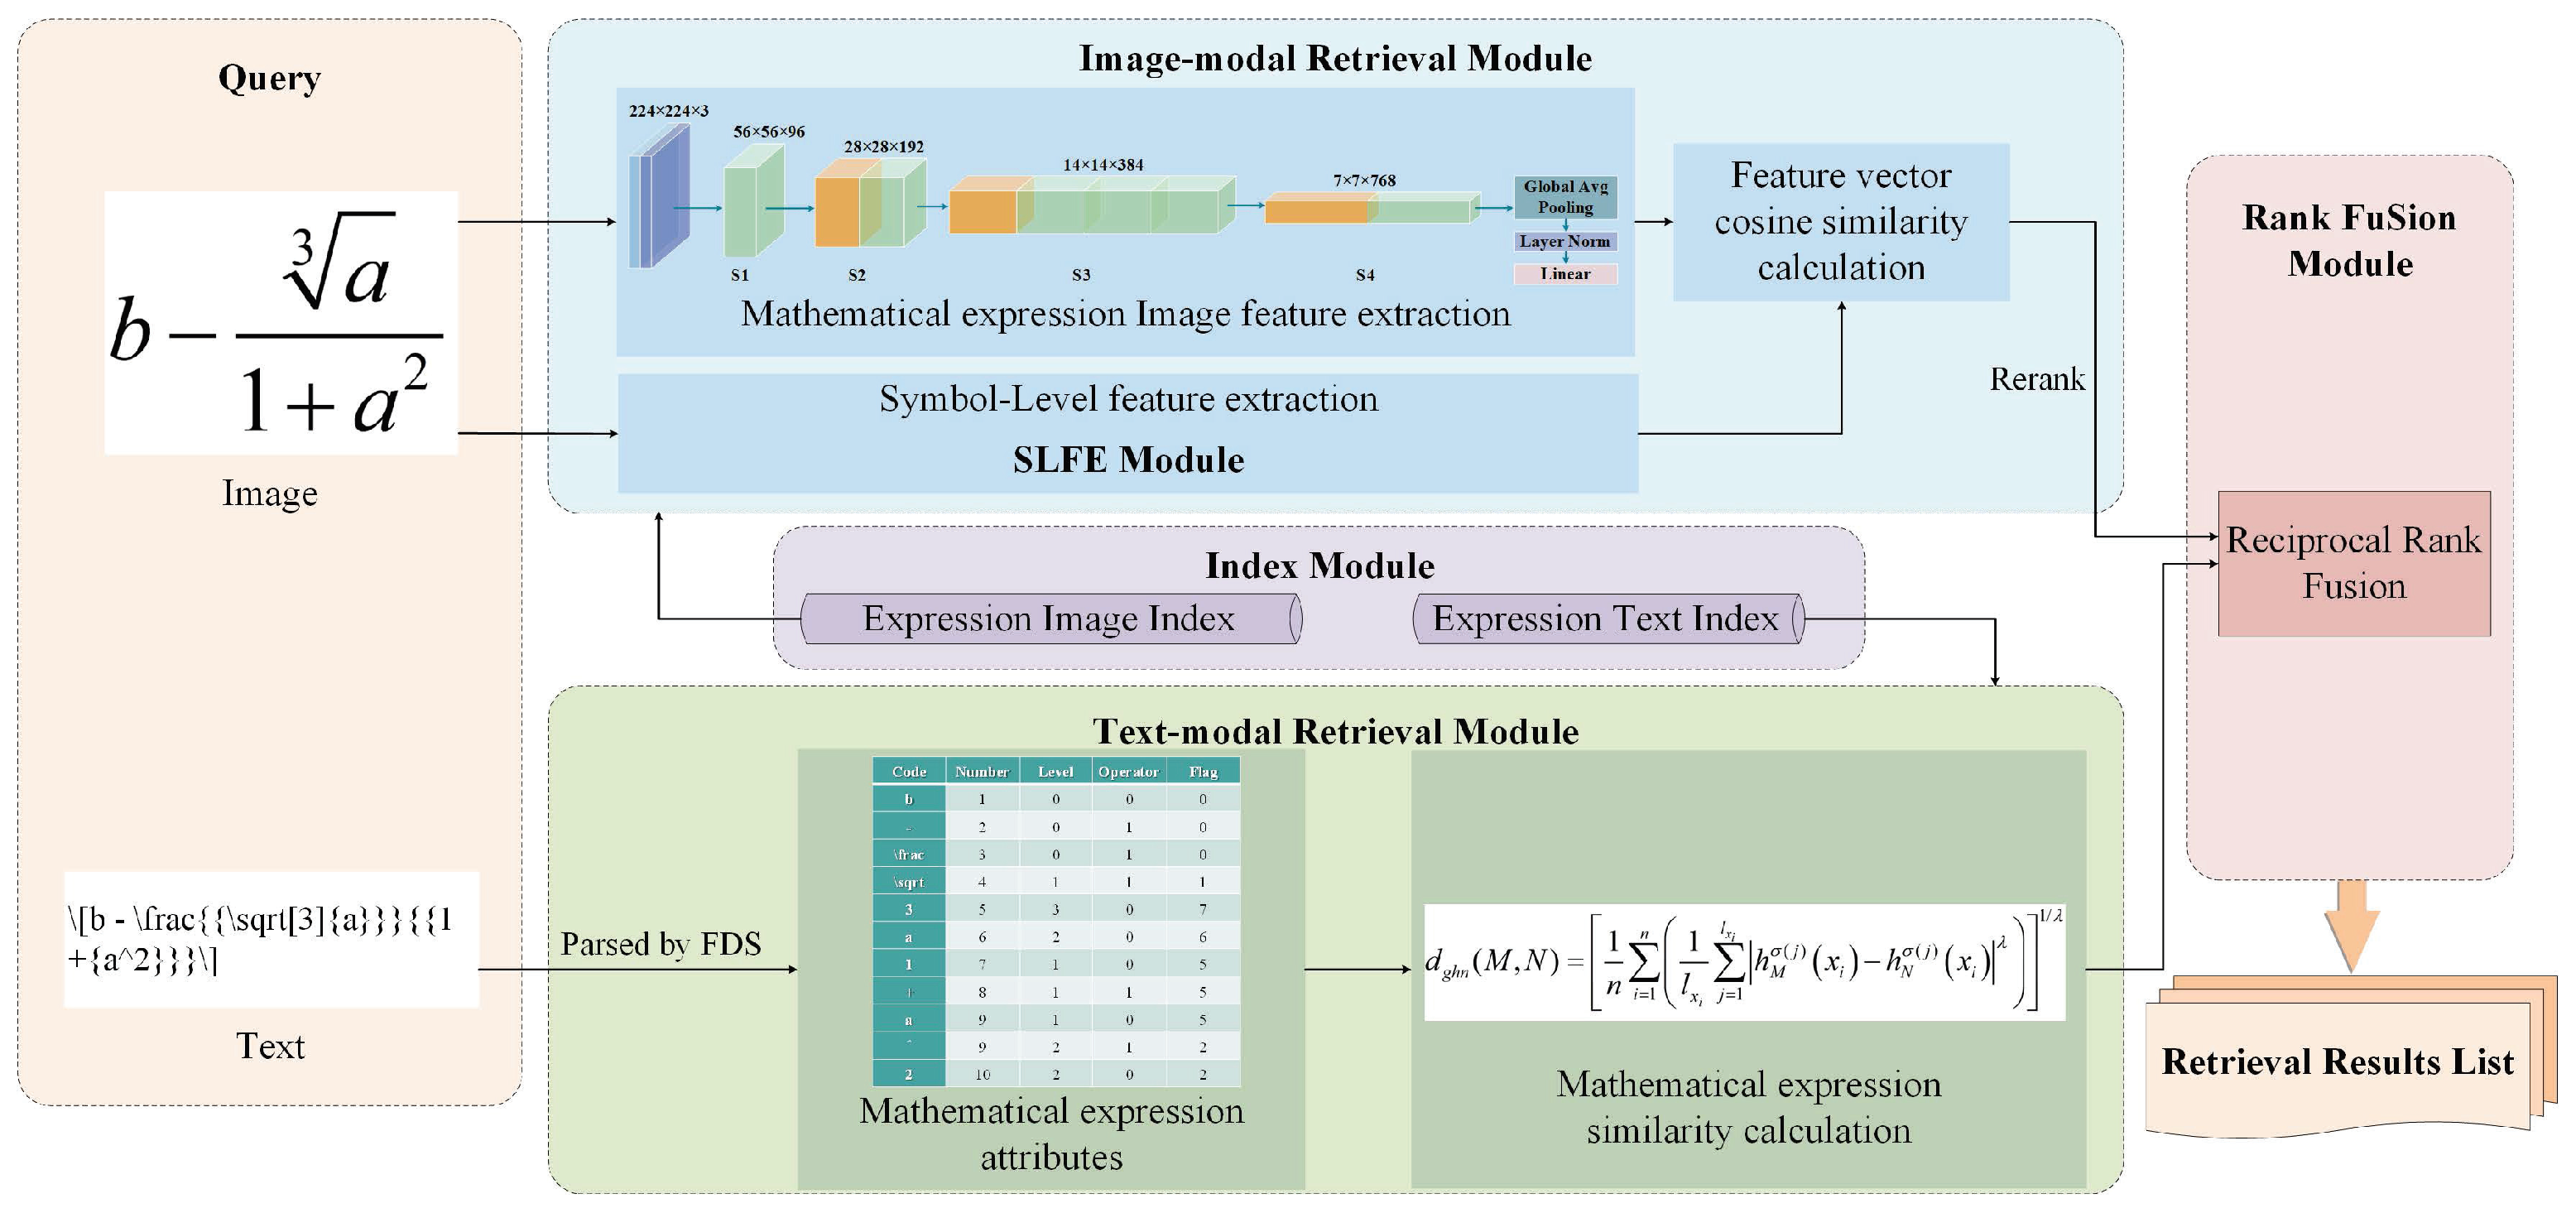
A Multi-Modal Retrieval Model for Mathematical Expressions Based on ...
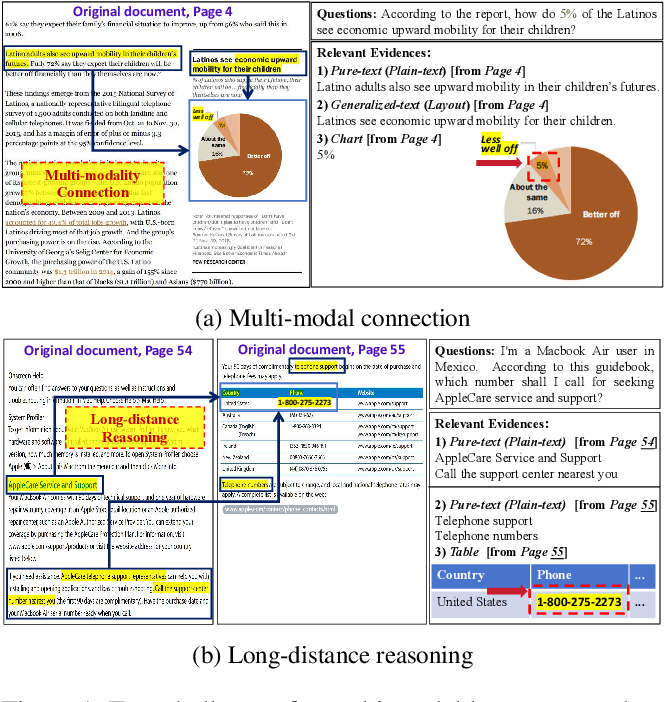
M3DocRAG: Multi-modal Retrieval is What You Need for Multi-page Multi ...
[2309.17133] Fine-grained Late-interaction Multi-modal Retrieval for ...
Multi-modal Molecule Structure-text Model for Text-based Retrieval and ...
[CVPR2022|跨模态检索]ViSTA: Vision and Scene Text Aggregation for Cross ...
性能赶超GPT-4!多模态检索最新成果刷爆SOTA!顶会思路确定不学?_more: multi-modal retrieval ...
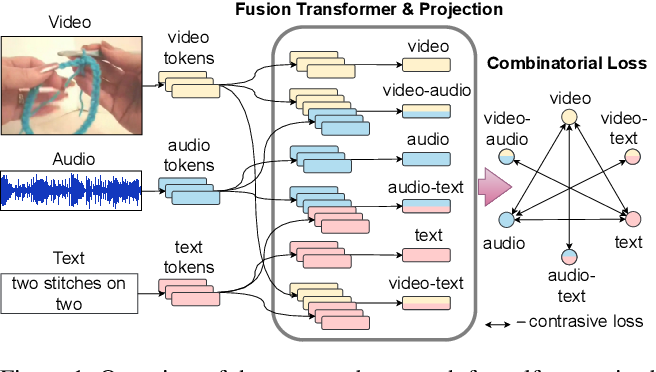
Figure 1 from Everything at Once – Multi-modal Fusion Transformer for ...
ERNIE-Layout: Layout-Knowledge Enhanced Multi-modal Pre-training for ...
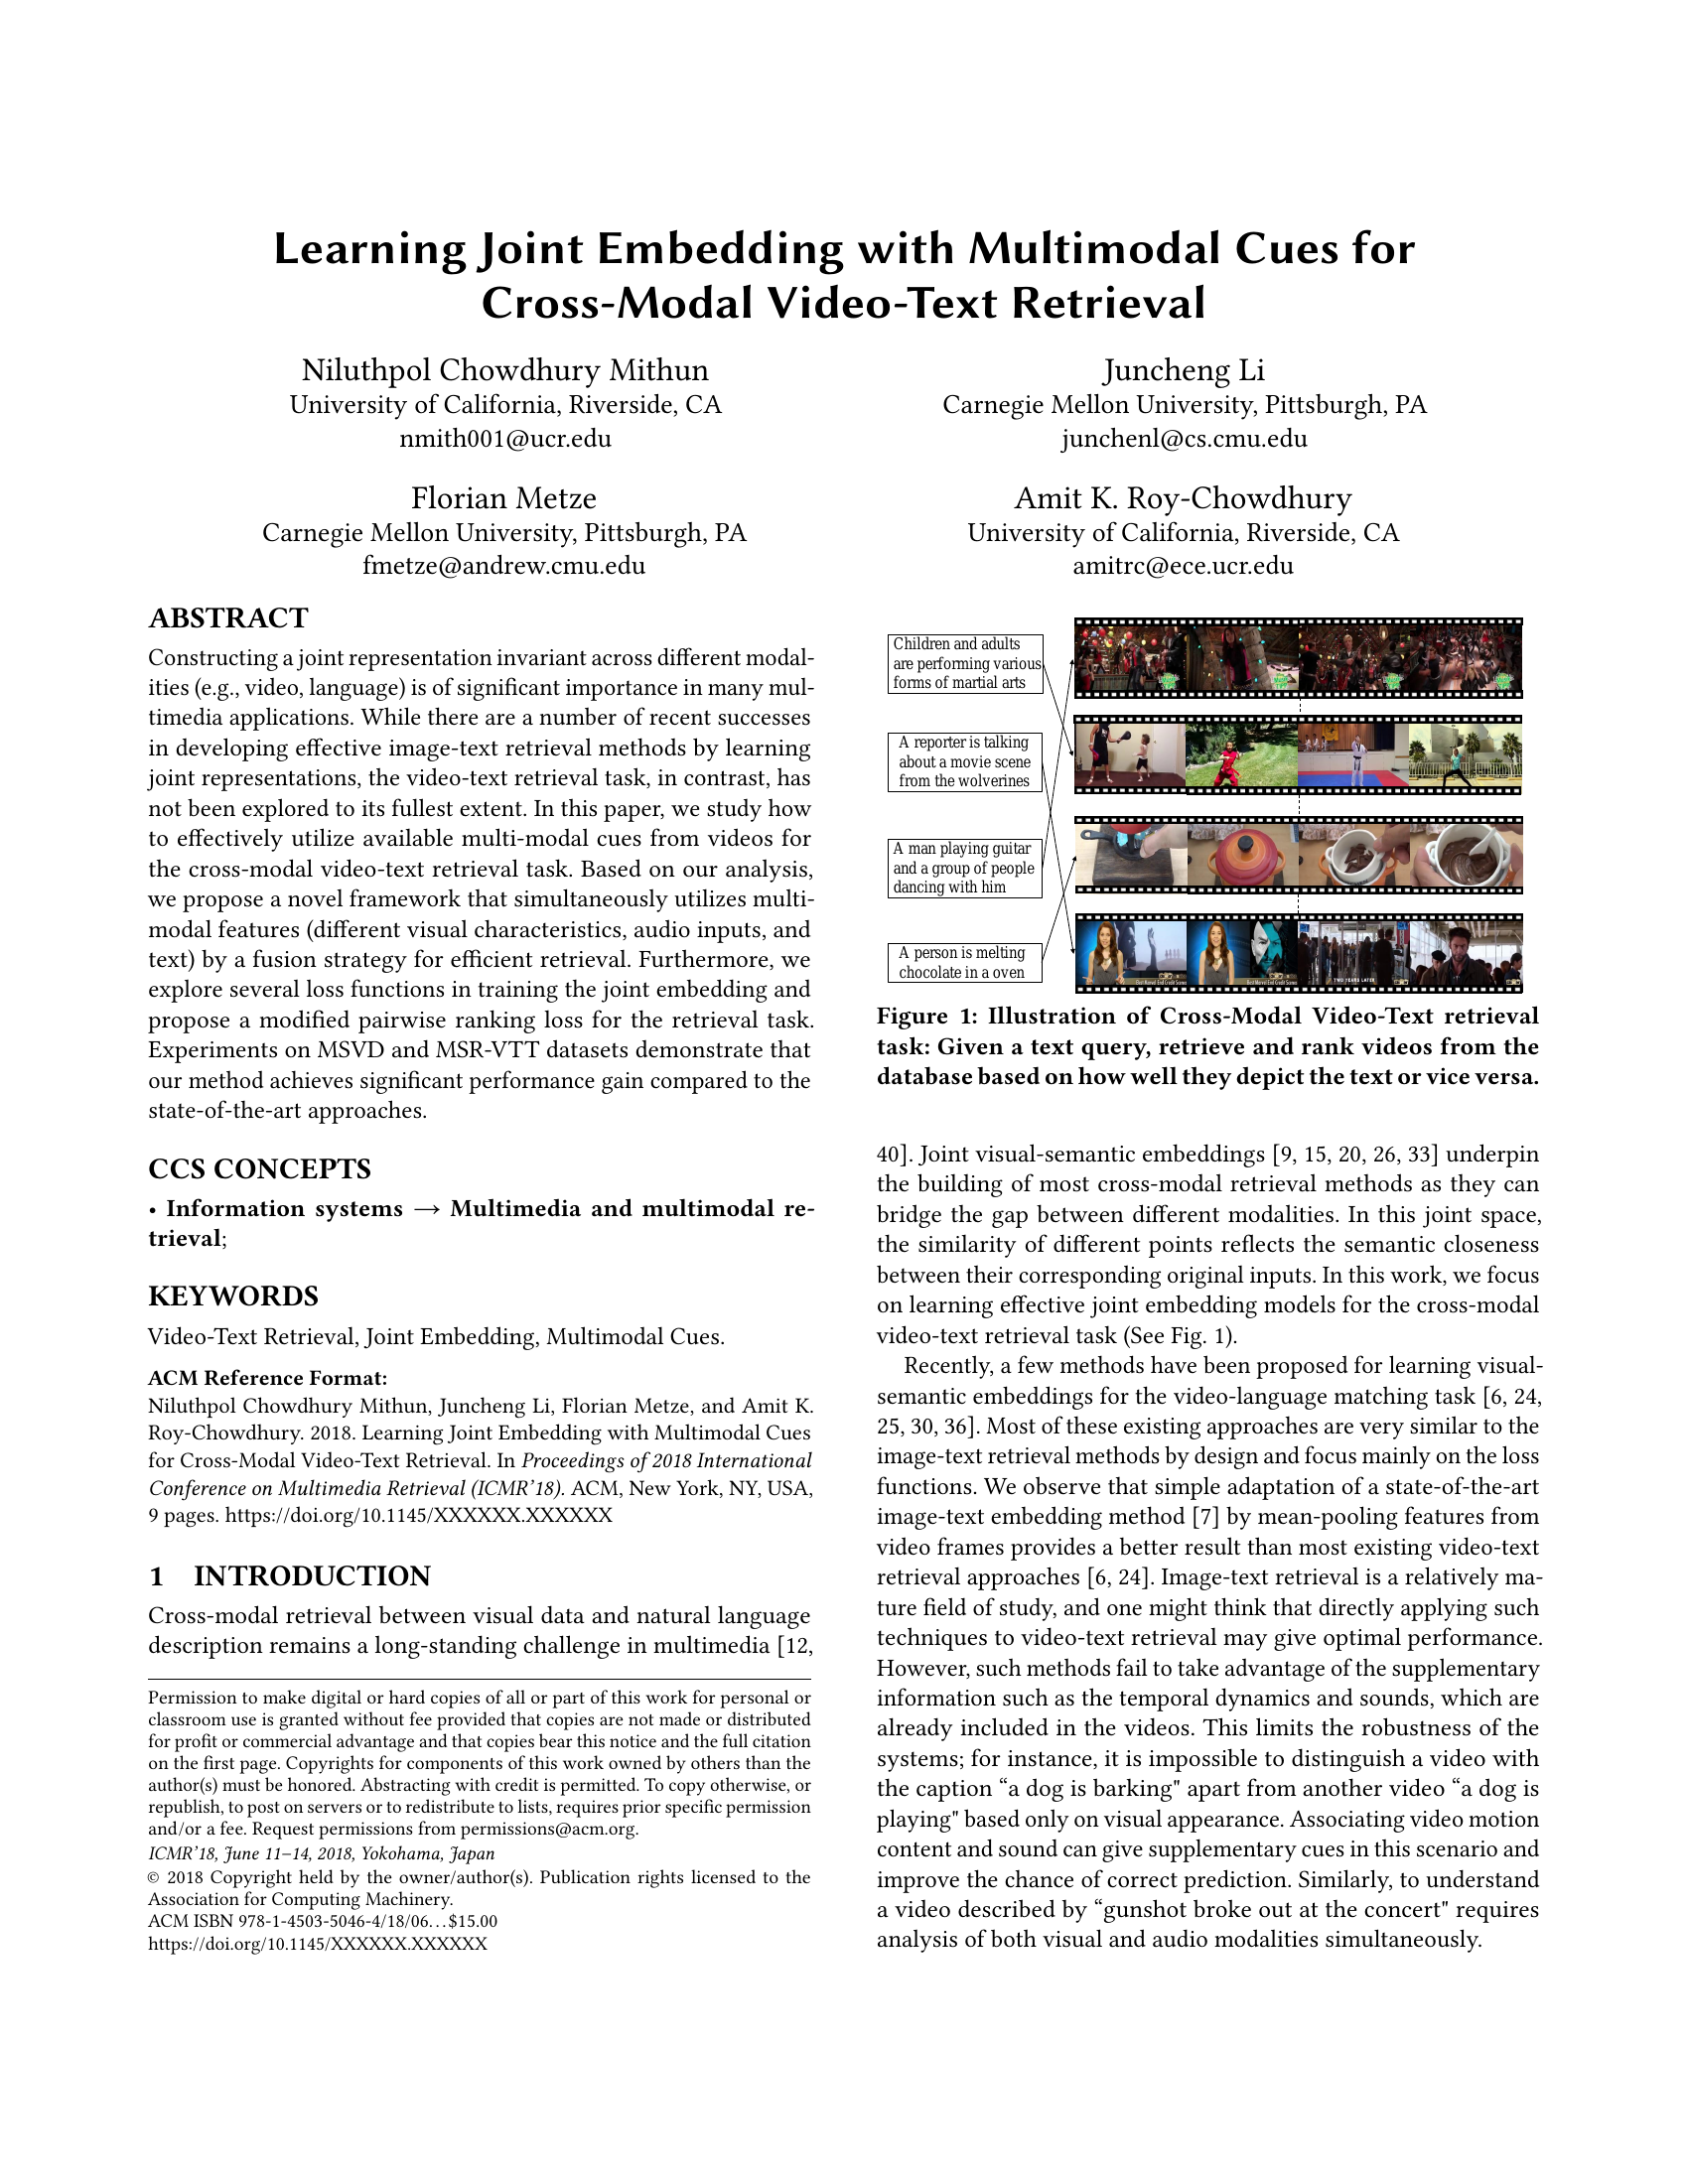
Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...
Paper page - Multi-Modal Motion Retrieval by Learning a Fine-Grained ...
Video–text retrieval via multi-modal masked transformer and adaptive ...
Embedding + Generation Model 사전 논문 조사4 - Multi-modal Generative ...
Outline of the multi-modal retrieval including a query-adaptive ...
Figure 2 from Adversarial Multi-Grained Embedding Network for Cross ...
Contrasting Dual Transformer Architectures for Multi-Modal Remote ...
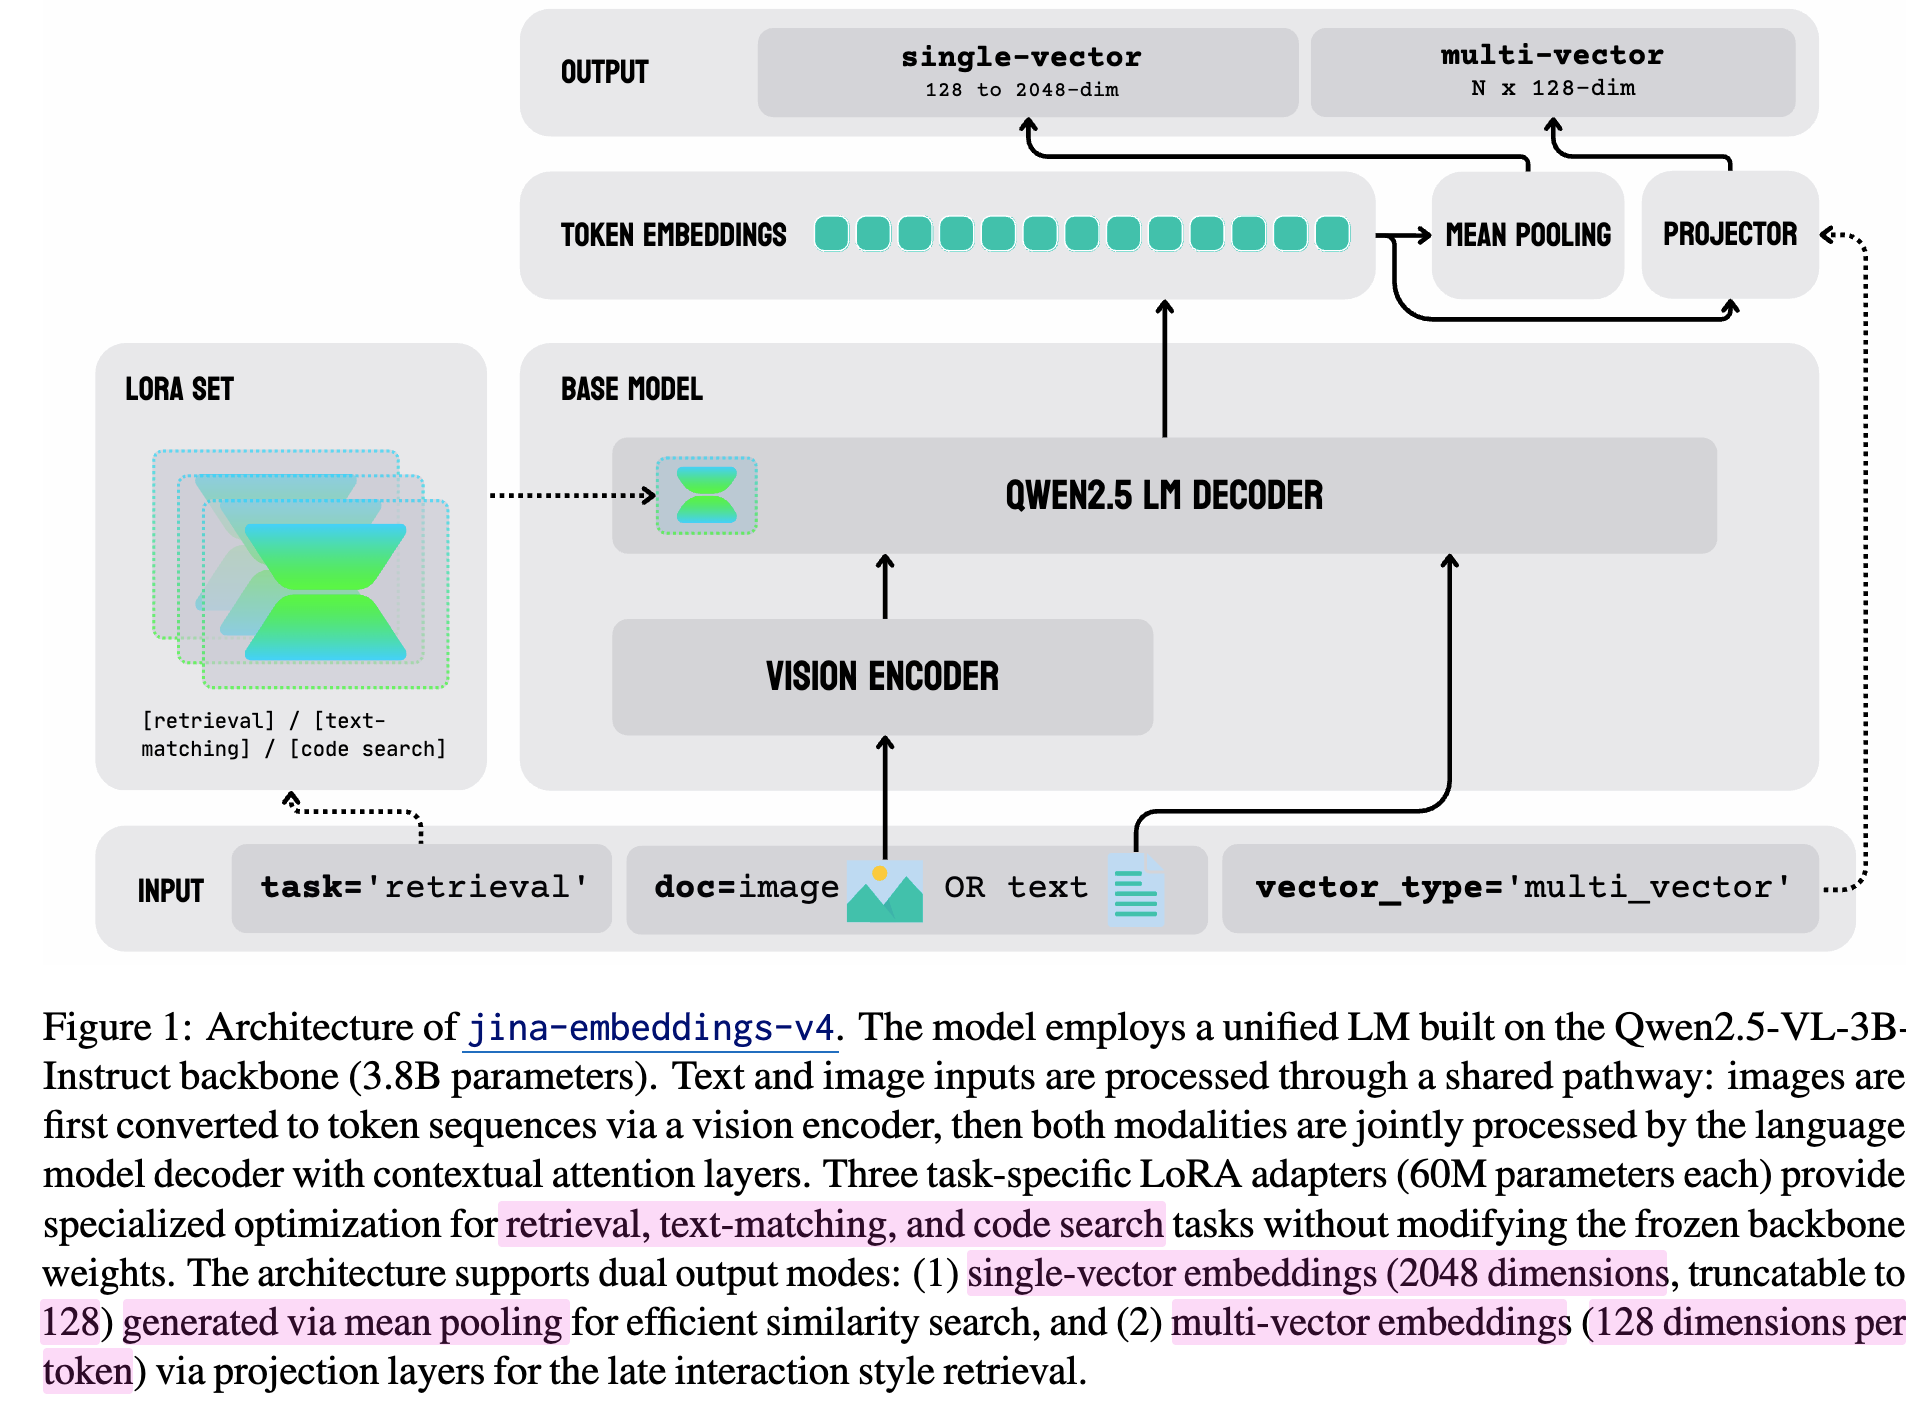
[Retrieval] Jina-embedding V4: Universal Embeddings for Multimodal ...
Figure 10 from Direction-Oriented Visual–Semantic Embedding Model for ...
Multi-Modal Retrieval using Cohere Multi-Modal Embeddings | Developer ...
Figure 1 from Learning Joint Embedding with Multimodal Cues for Cross ...
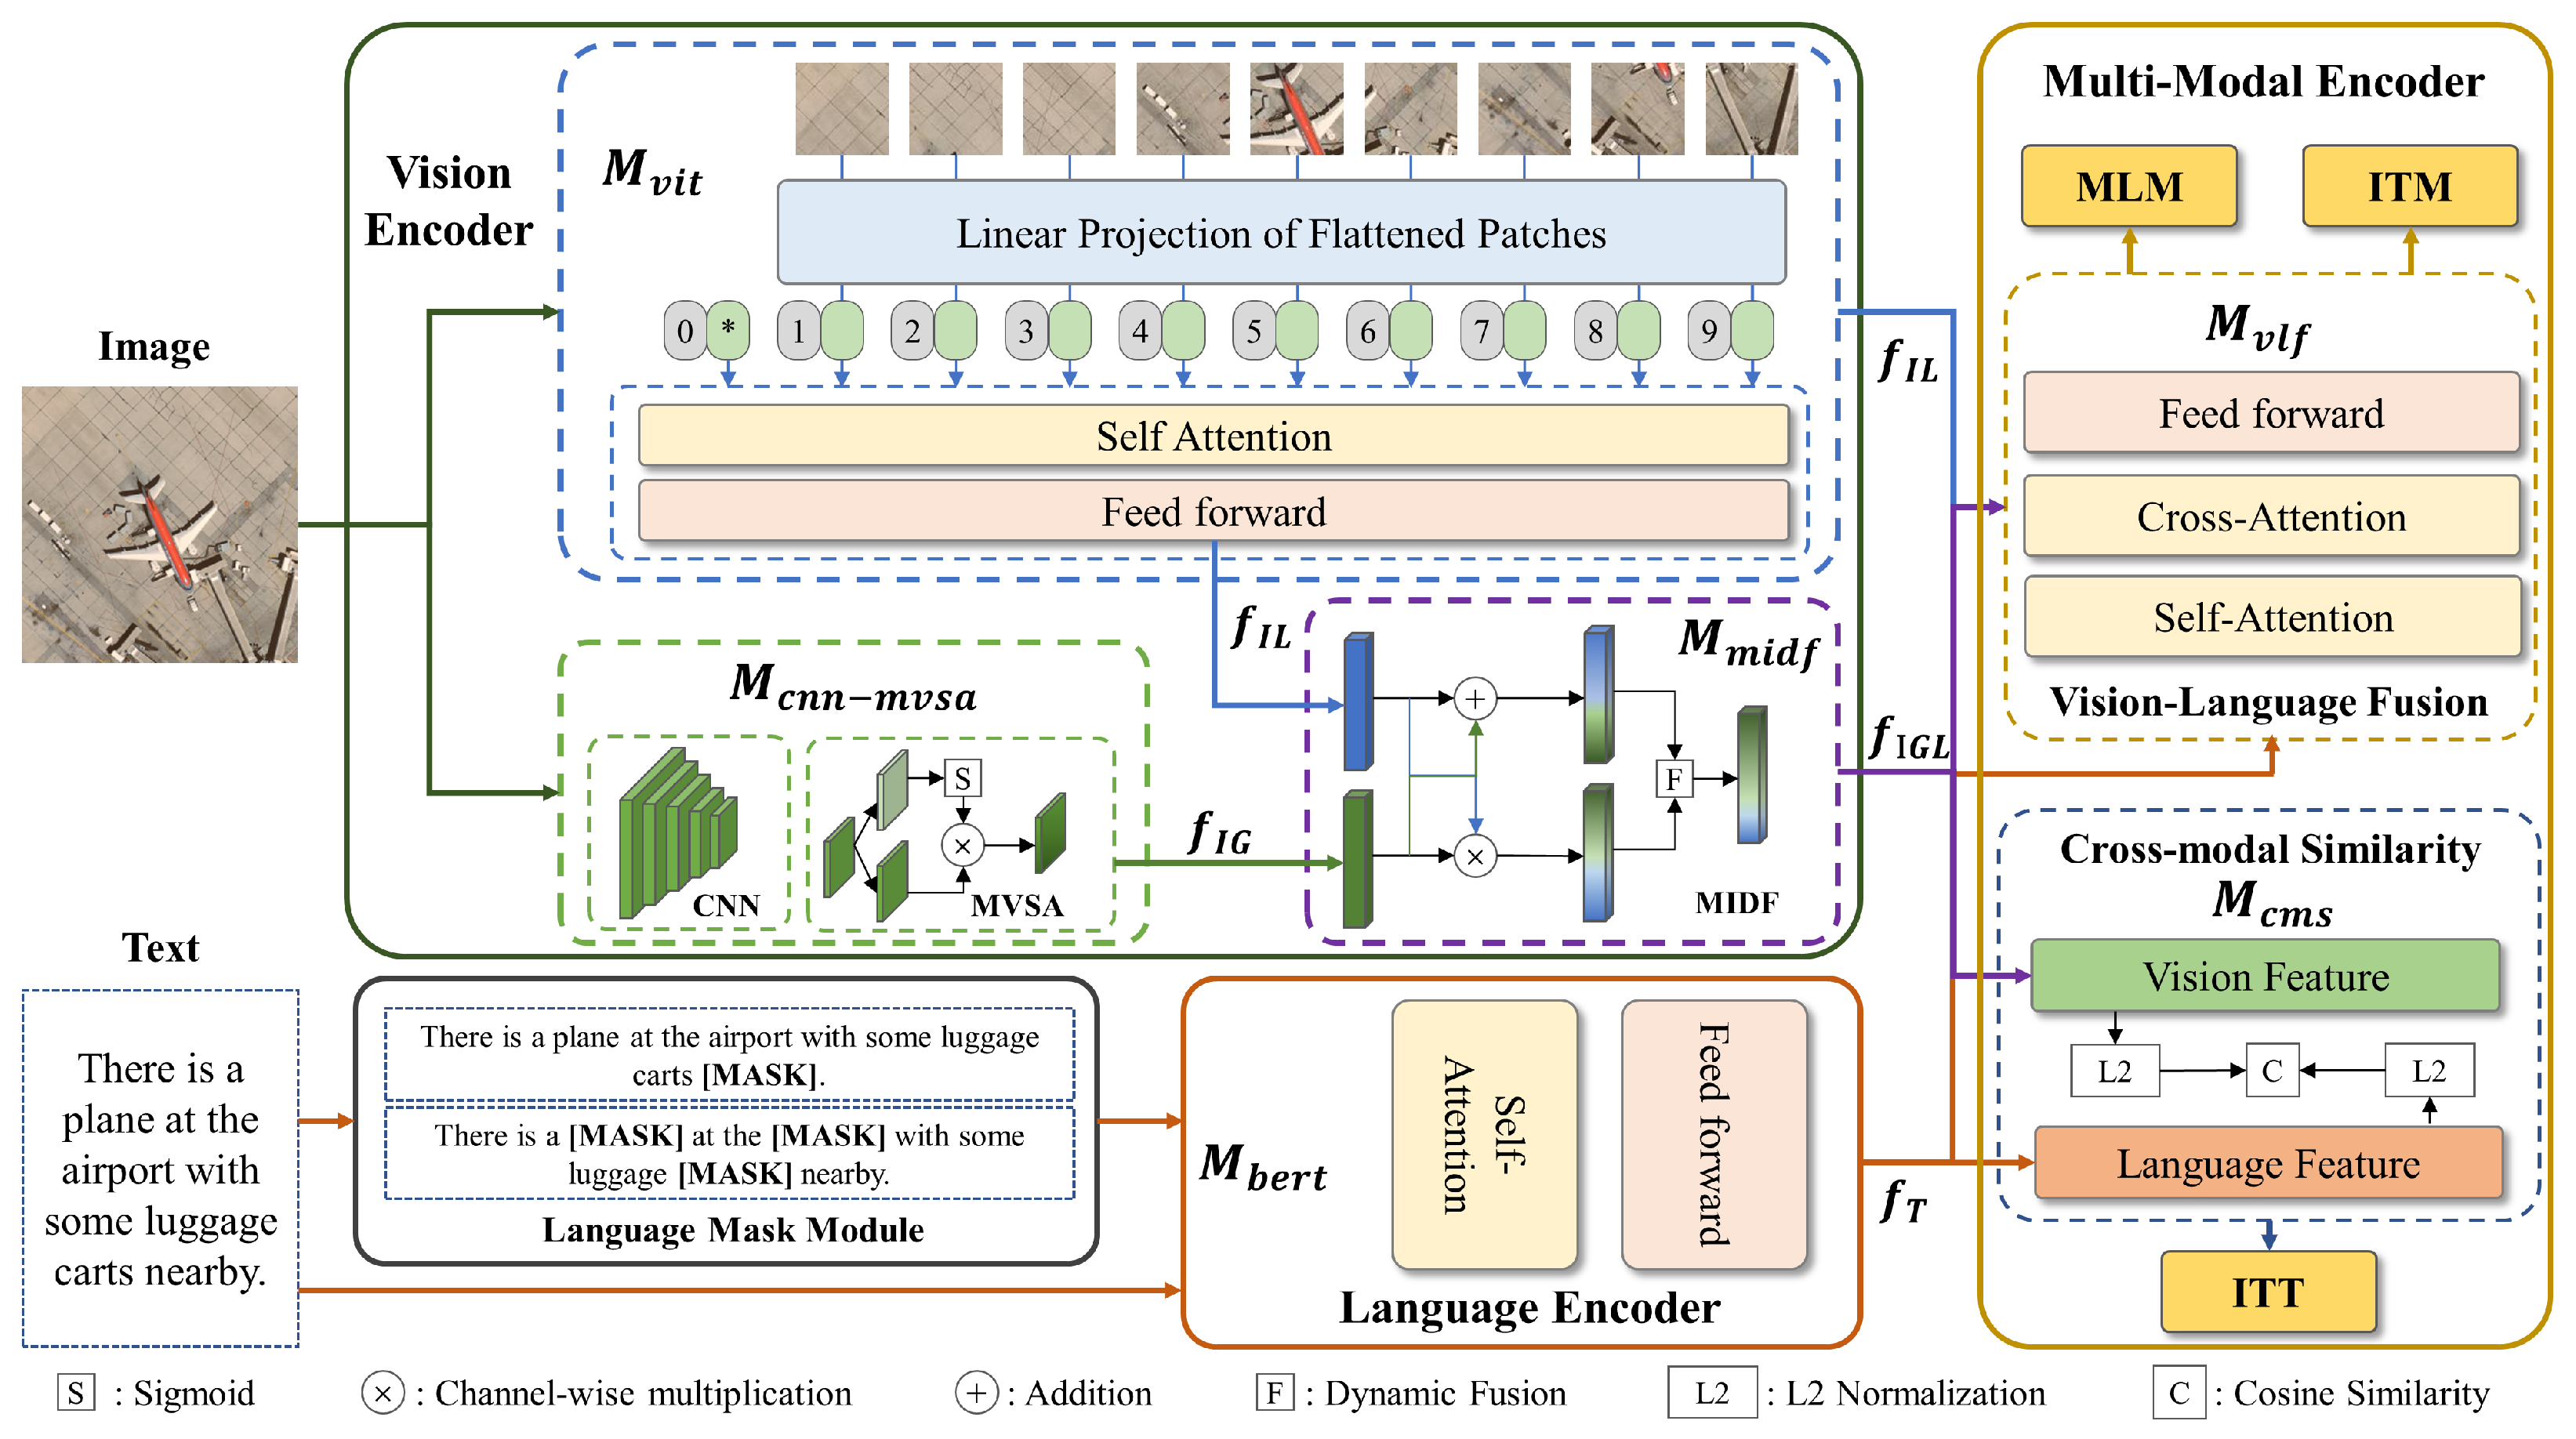
An End-to-End Framework Based on Vision-Language Fusion for Remote ...
Historical Report Guided Bi-modal Concurrent Learning for Pathology ...
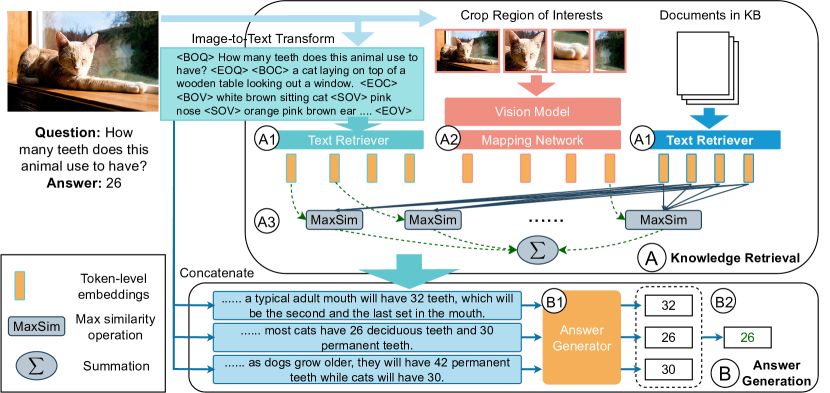
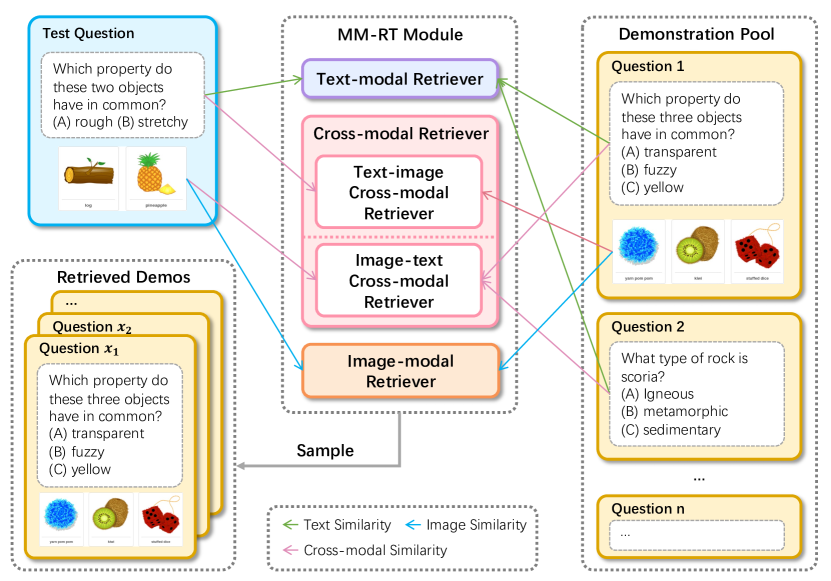
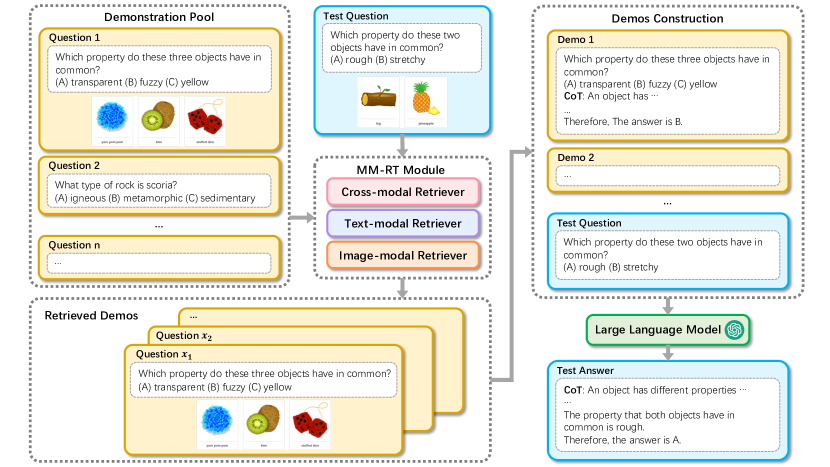
[2312.01714] Retrieval-augmented Multi-modal Chain-of-Thoughts ...
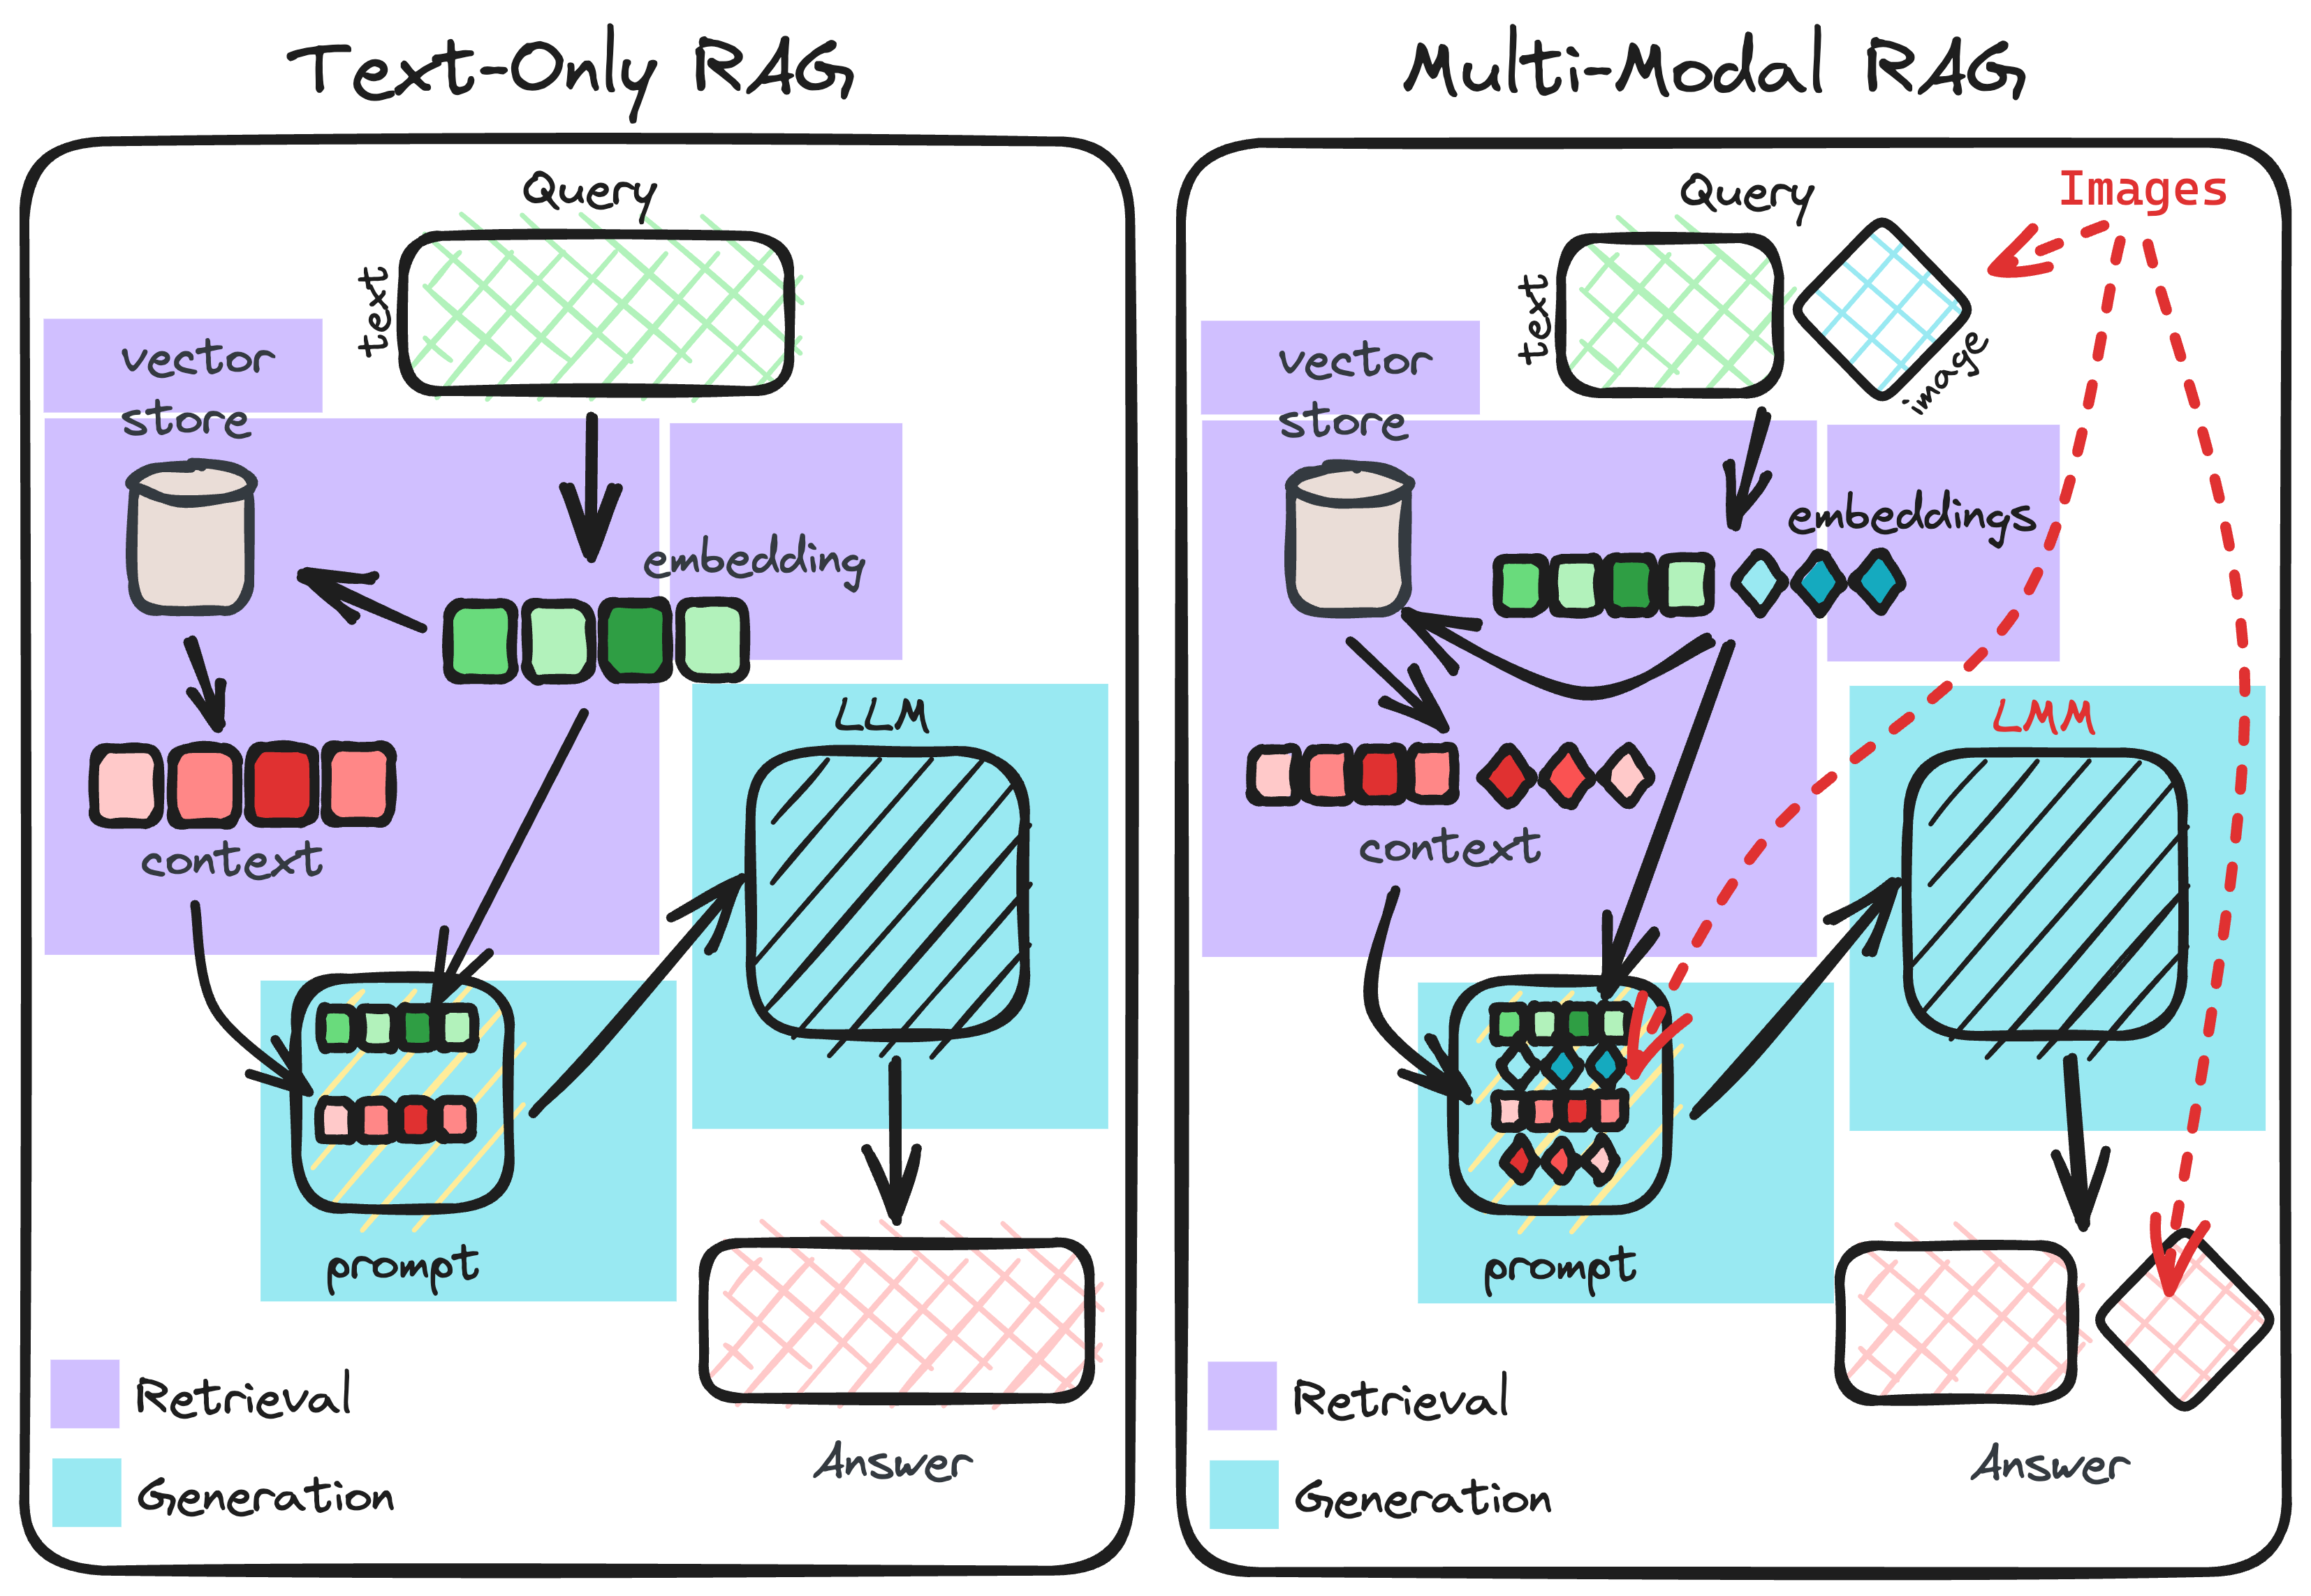
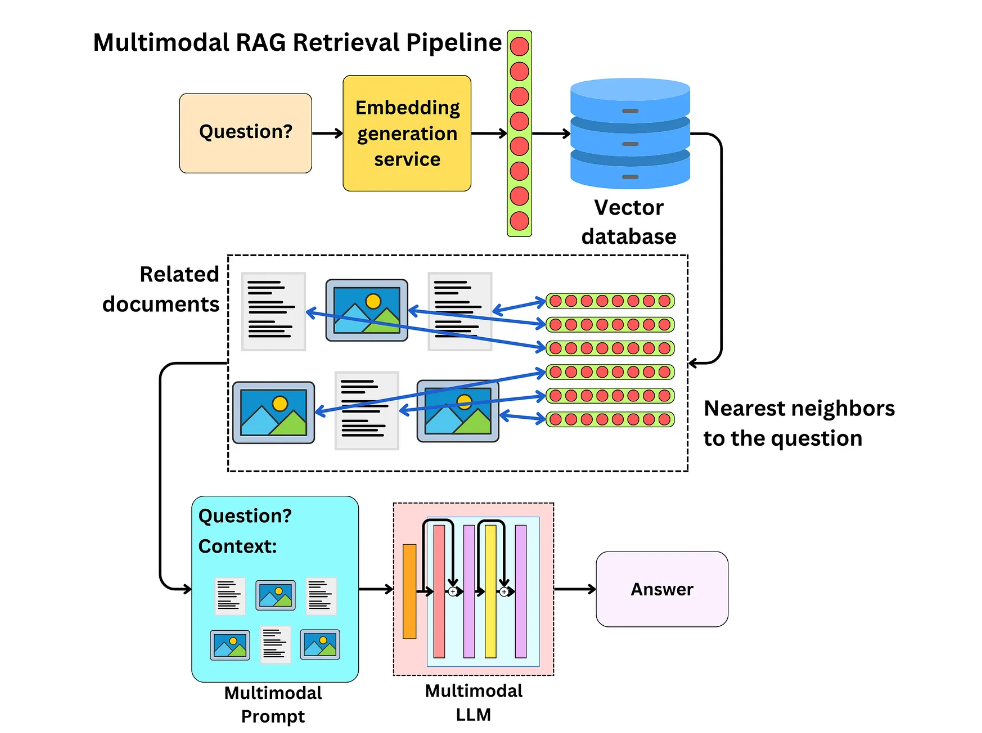
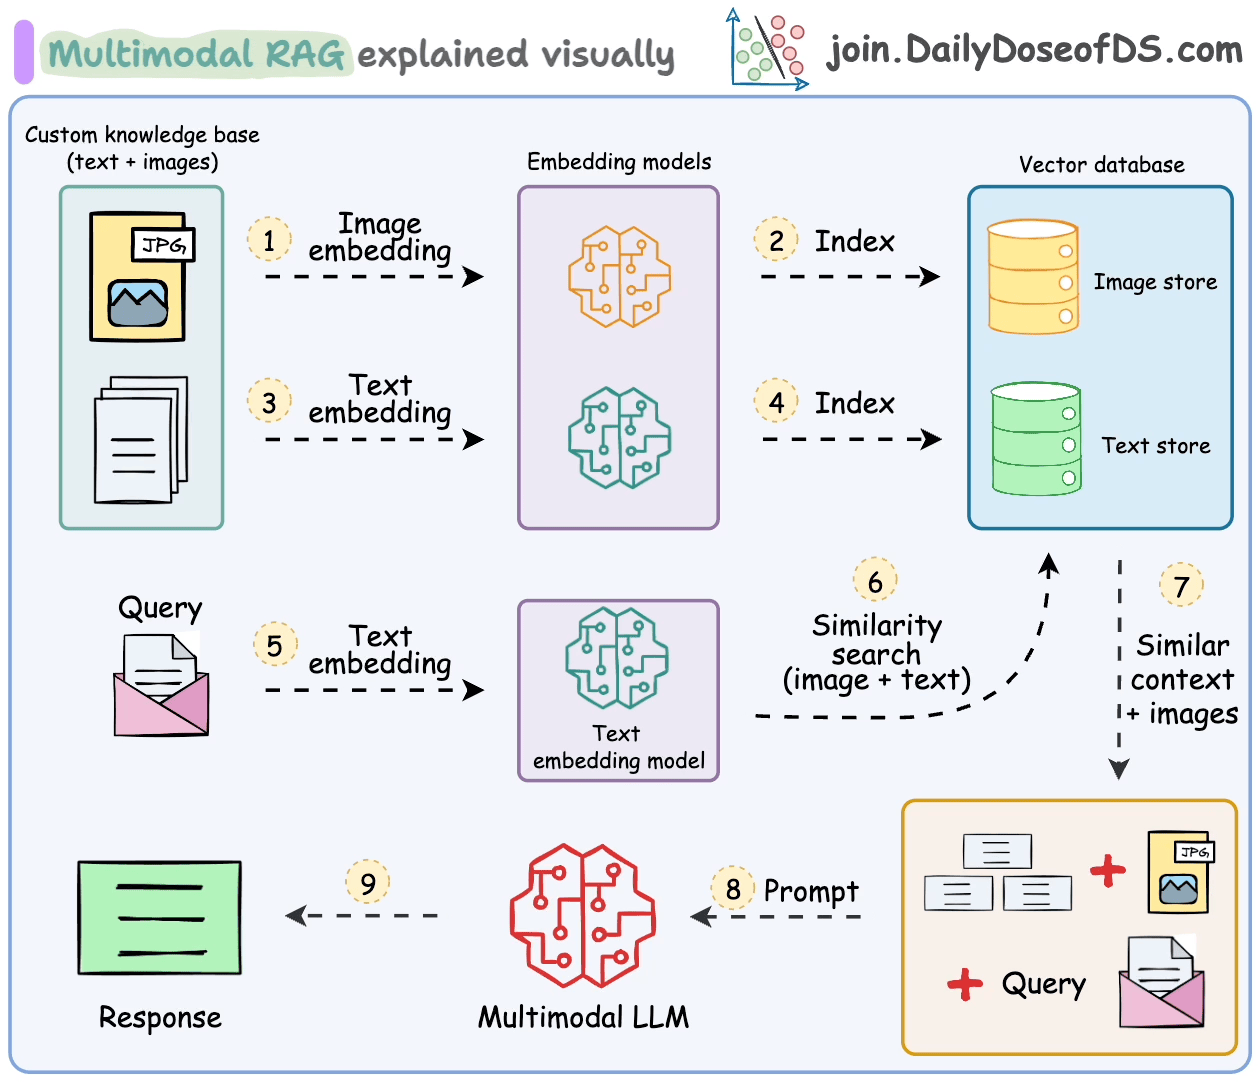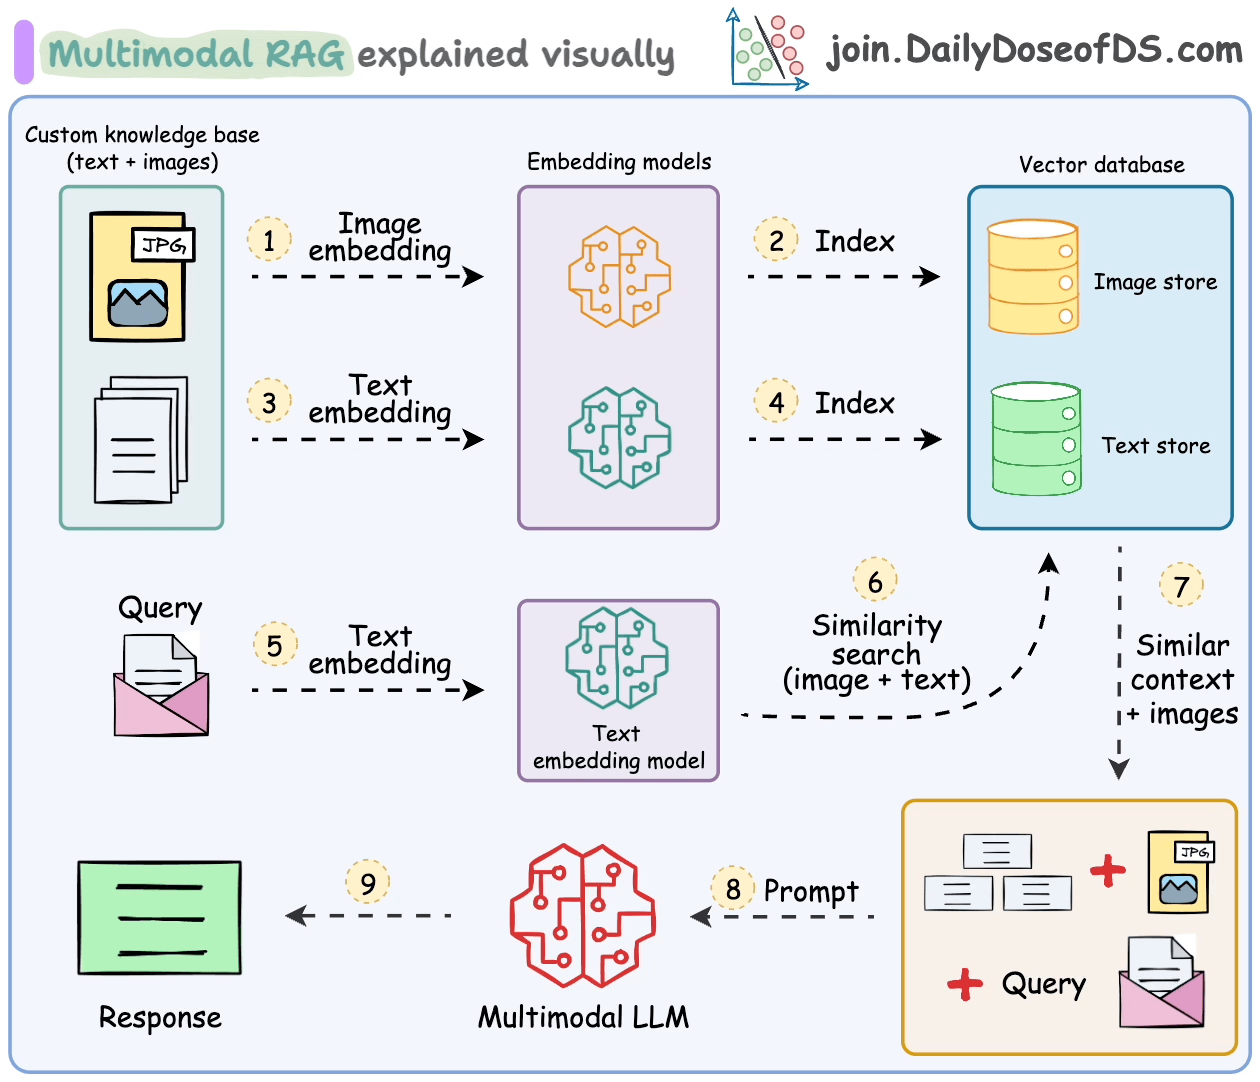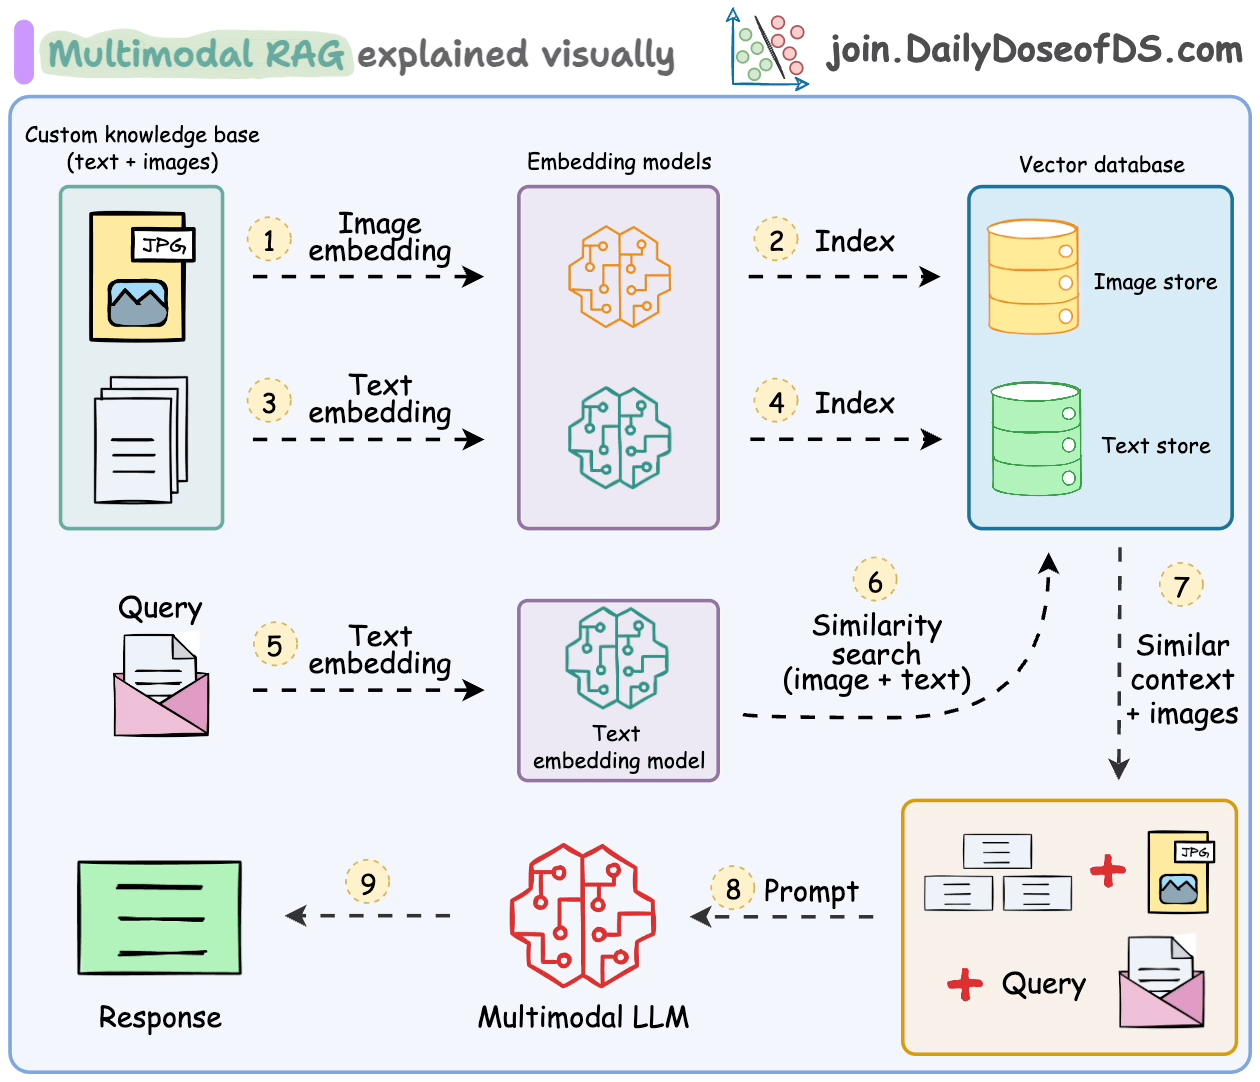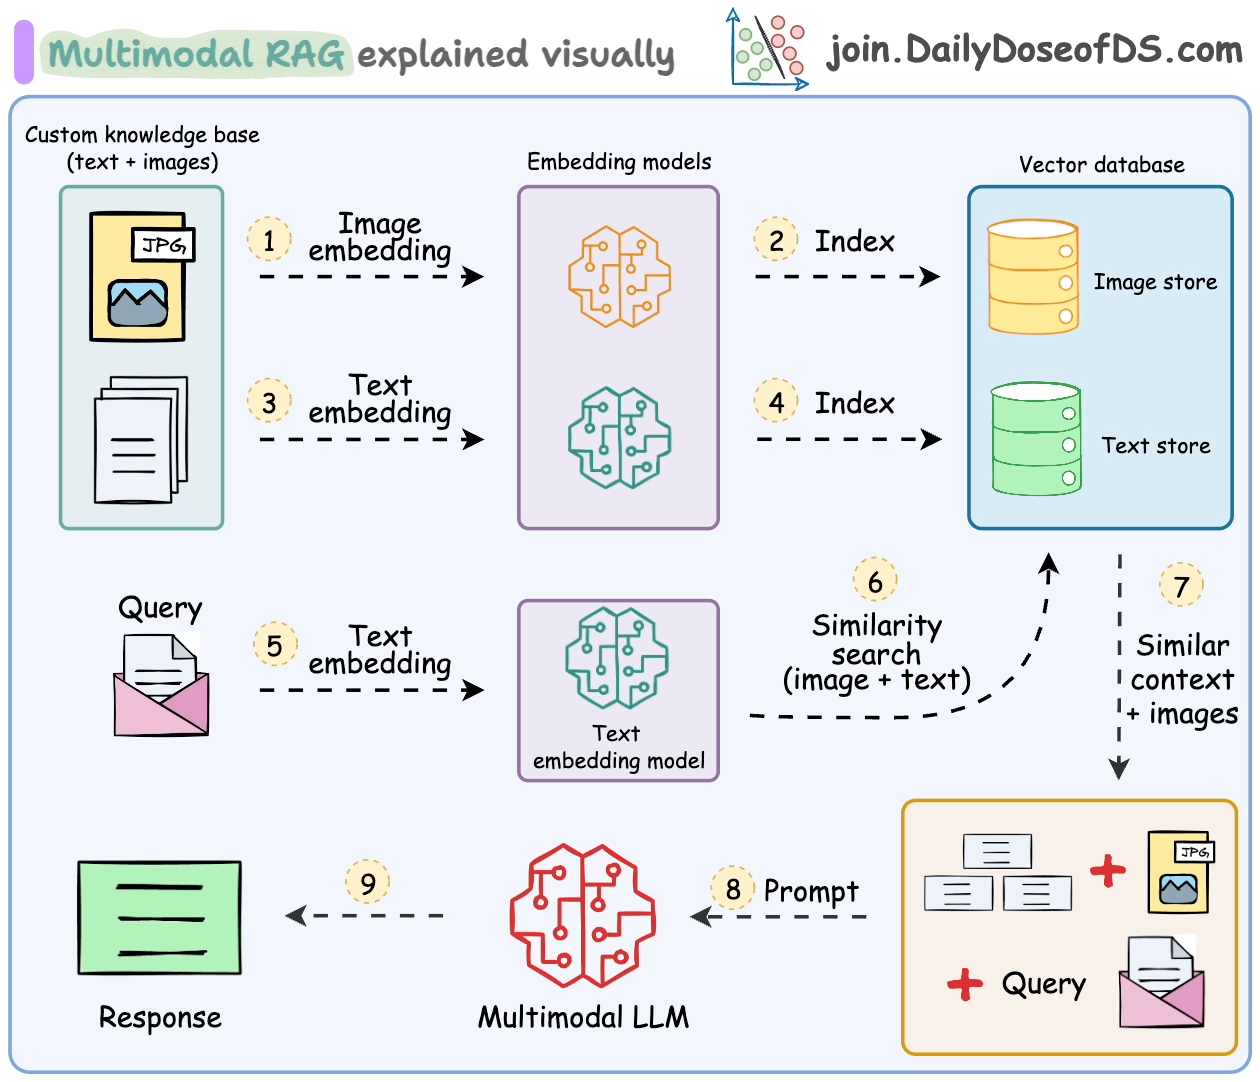
Multi-Modal Retrieval-Augmented Generation (RAG) Systems: An In-Depth ...
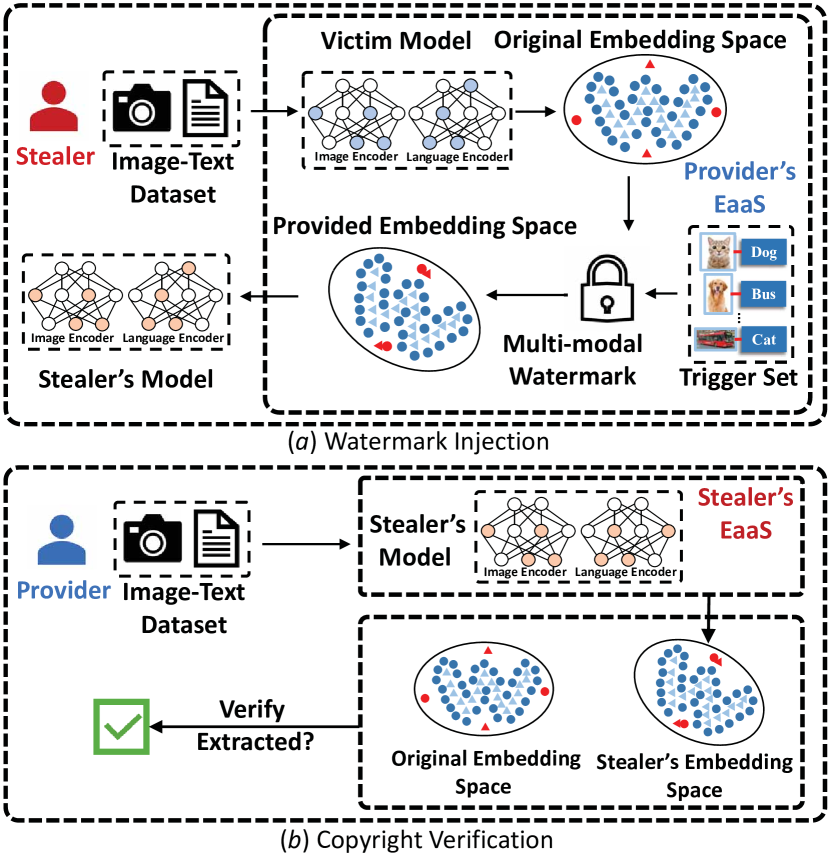
[2311.05863] Watermarking Vision-Language Pre-trained Models for Multi ...
MiMIC: Mitigating Visual Modality Collapse in Universal Multimodal ...
A novel multi-modal image retrieval system
Voyage AI Introduces voyage-multimodal-3: A New State-of-the-Art for ...
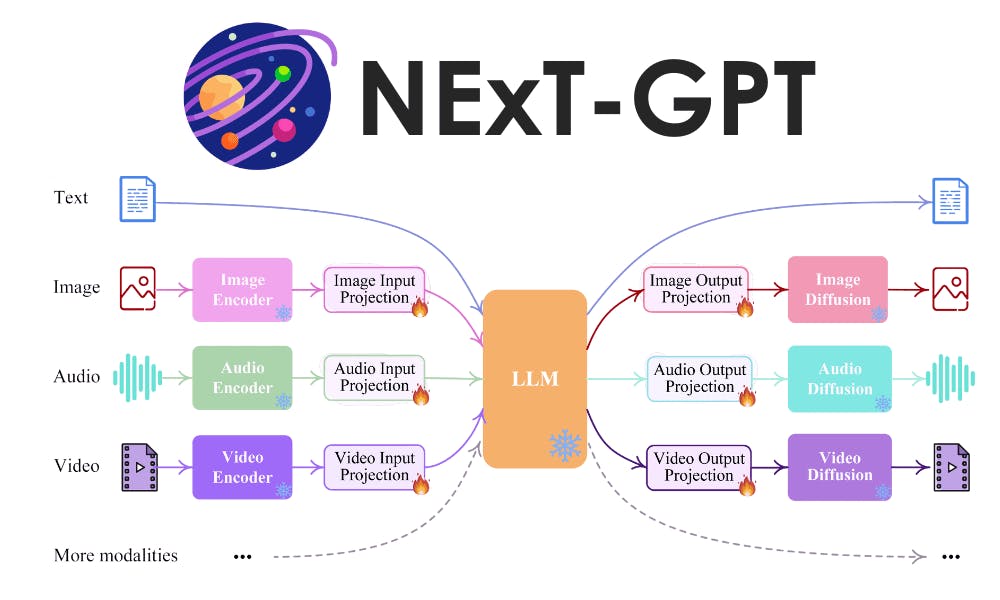
Macaw-LLM: Multi-Modal Language Modeling with Image, Audio, Video, and ...
ImageBind: Meta AI's Multi-Modal Embedding Model | Inference Systems
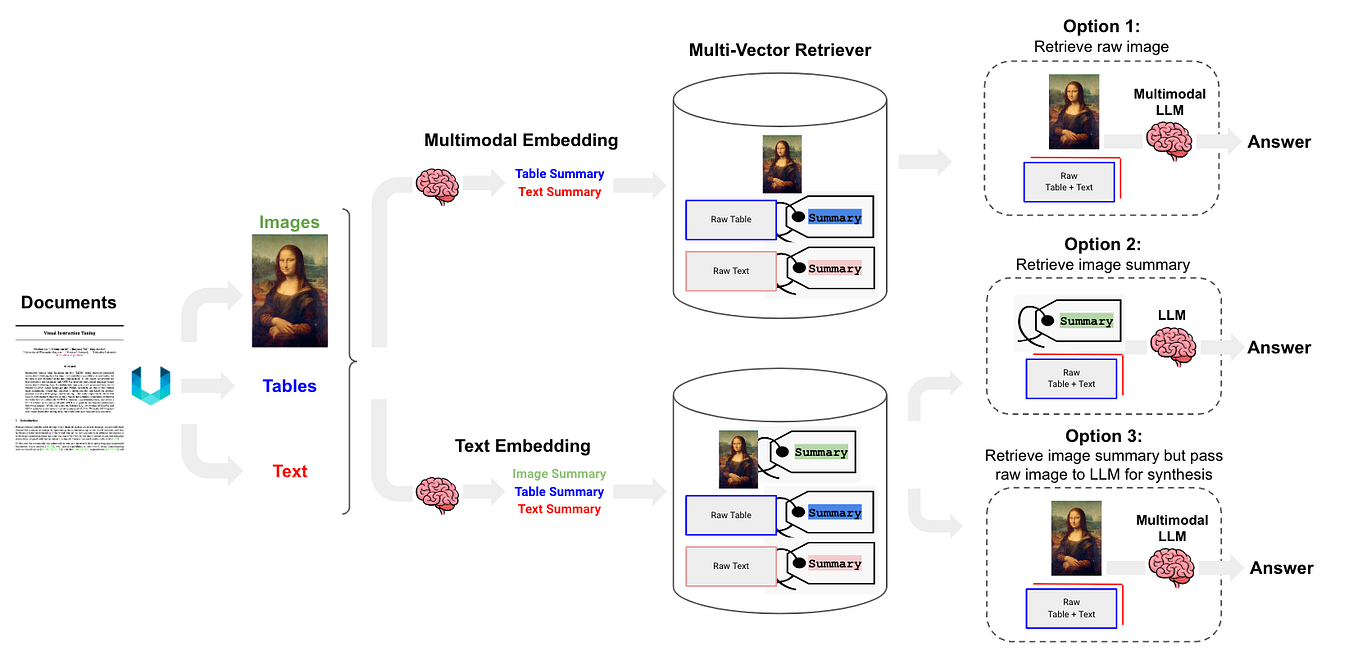
An Easy Introduction to Multimodal Retrieval-Augmented Generation for ...
IASC | Free Full-Text | DCRL-KG: Distributed Multi-Modal Knowledge ...
Remote Sensing Cross-Modal Text-Image Retrieval Based on Attention ...
Magic-MM-Embedding: Towards Visual-Token-Efficient Universal Multimodal ...
X-Pool: Cross-Modal Language-Video Attention for Text-Video Retrieval - 知乎
[논문 리뷰] Beyond Text: Unveiling Privacy Vulnerabilities in Multi-modal ...
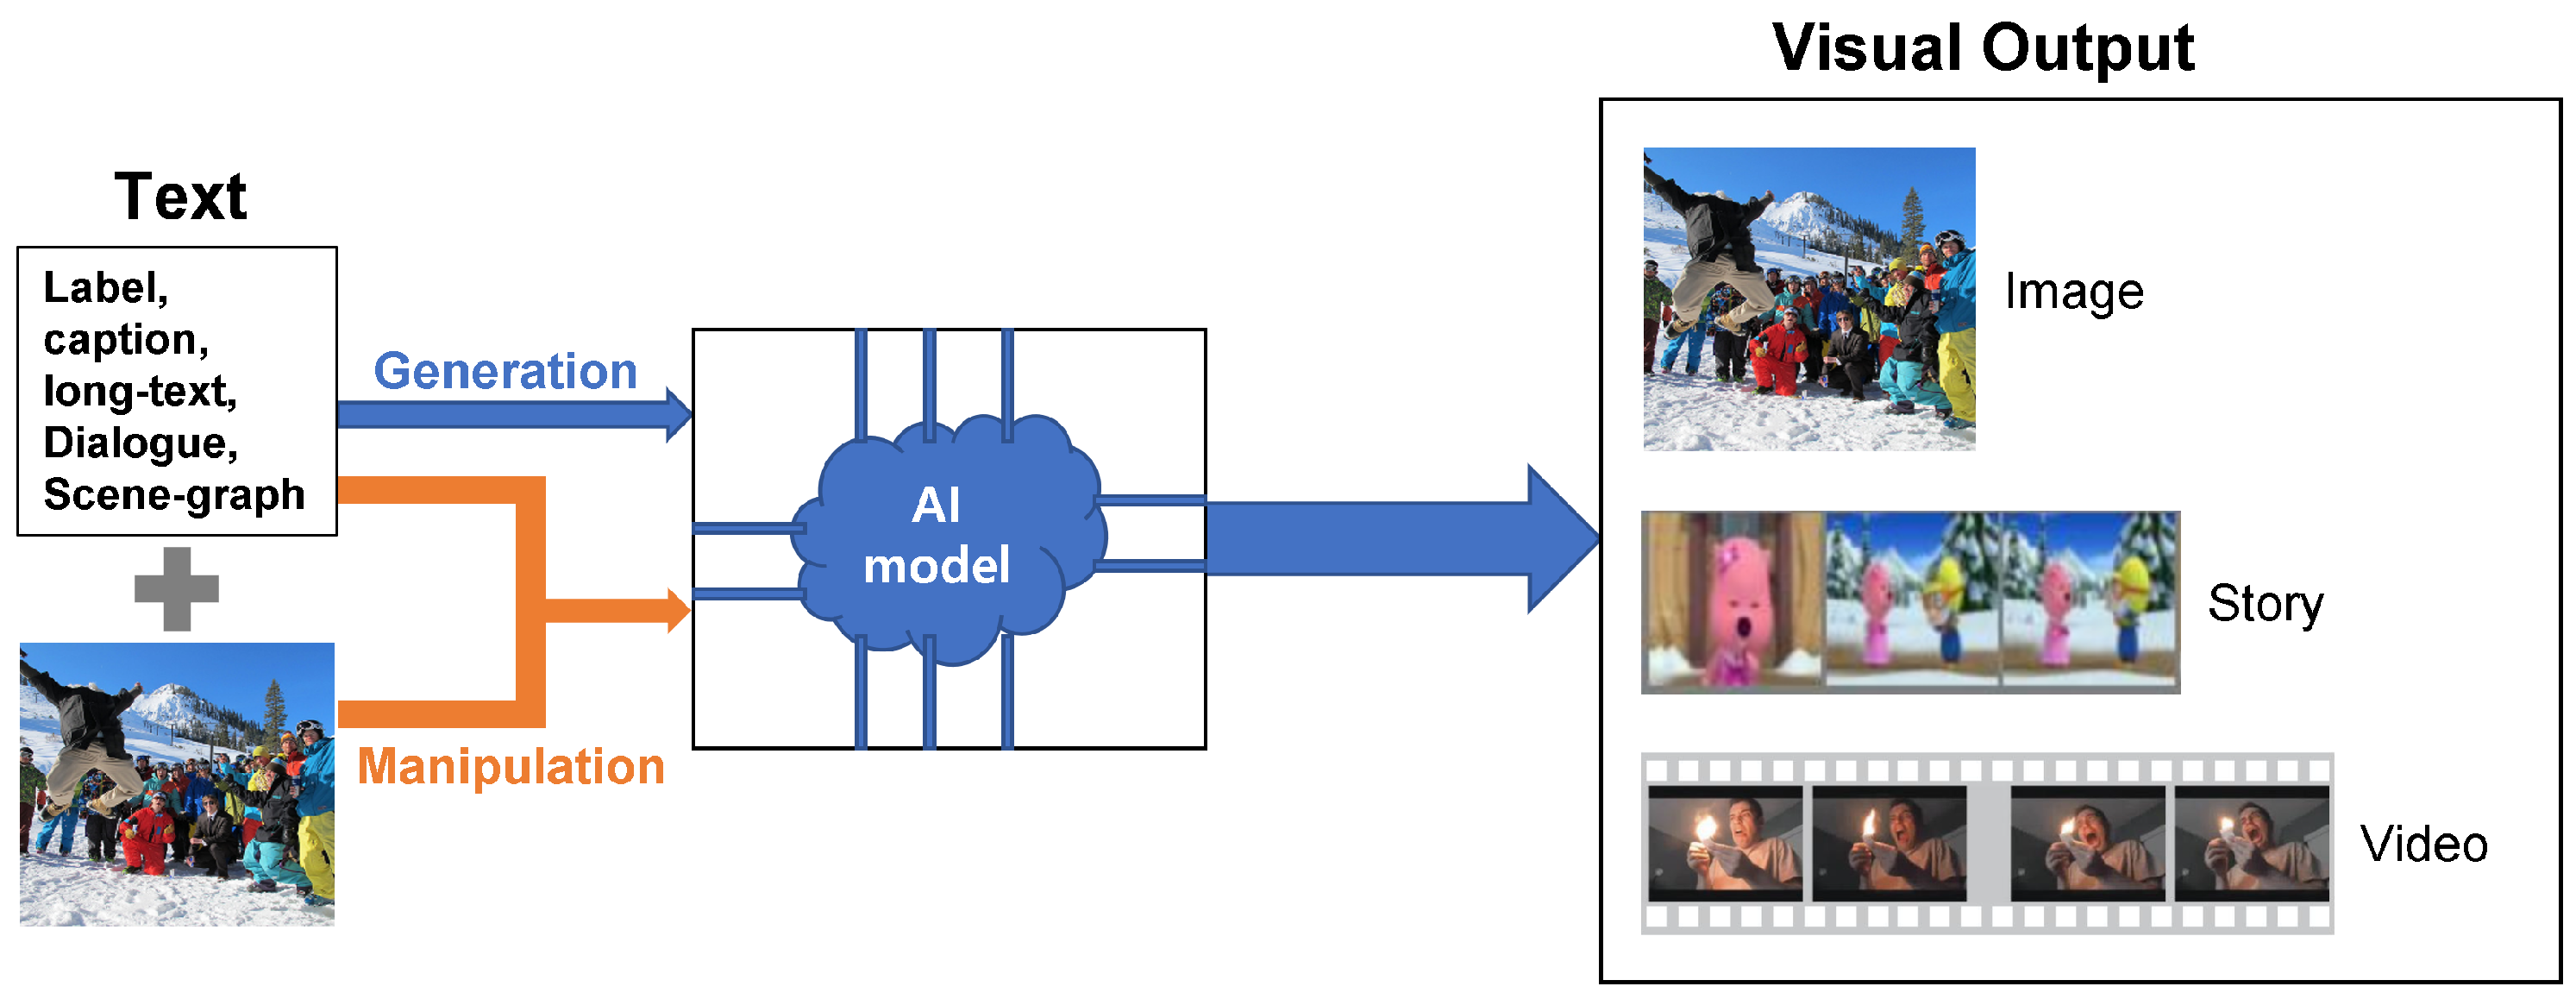
A Review of Multi-Modal Learning from the Text-Guided Visual Processing ...
Prompting Learning在CV领域的进展_exploring visual prompts for adapting large ...
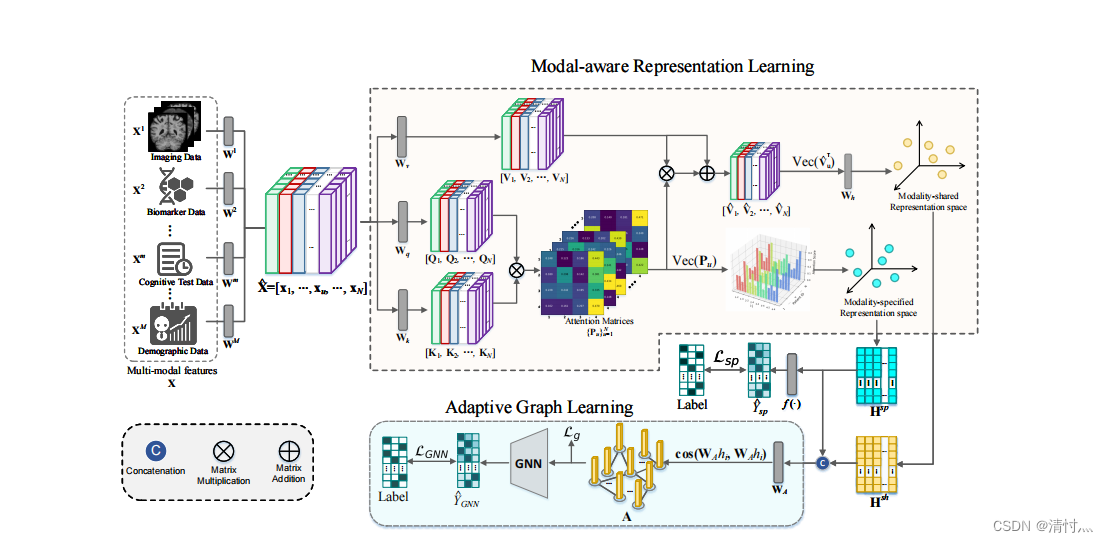
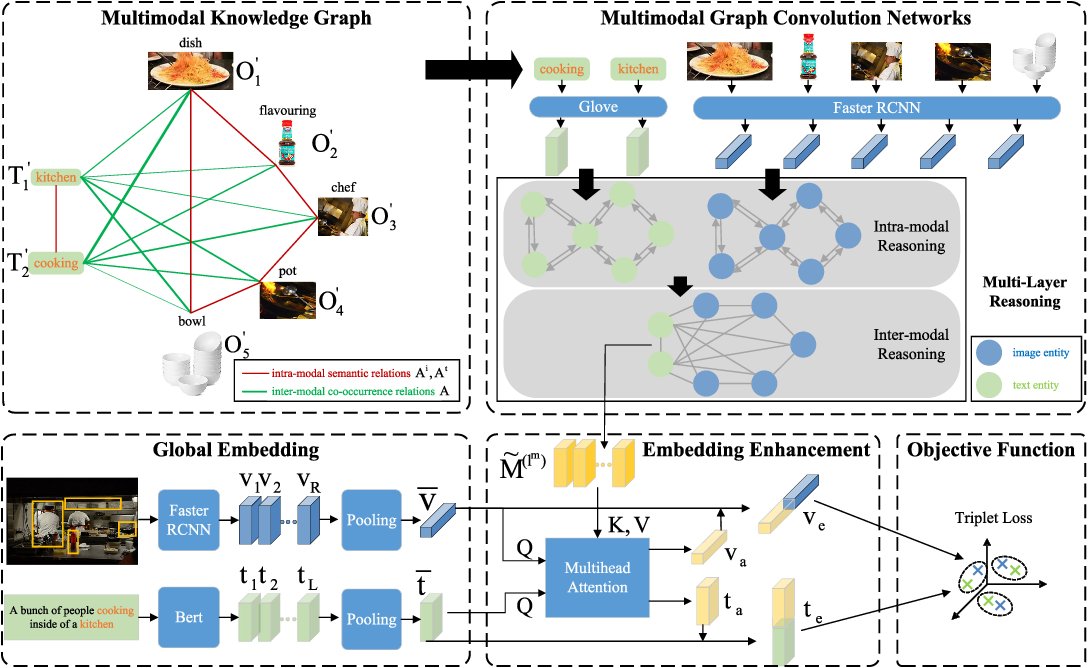
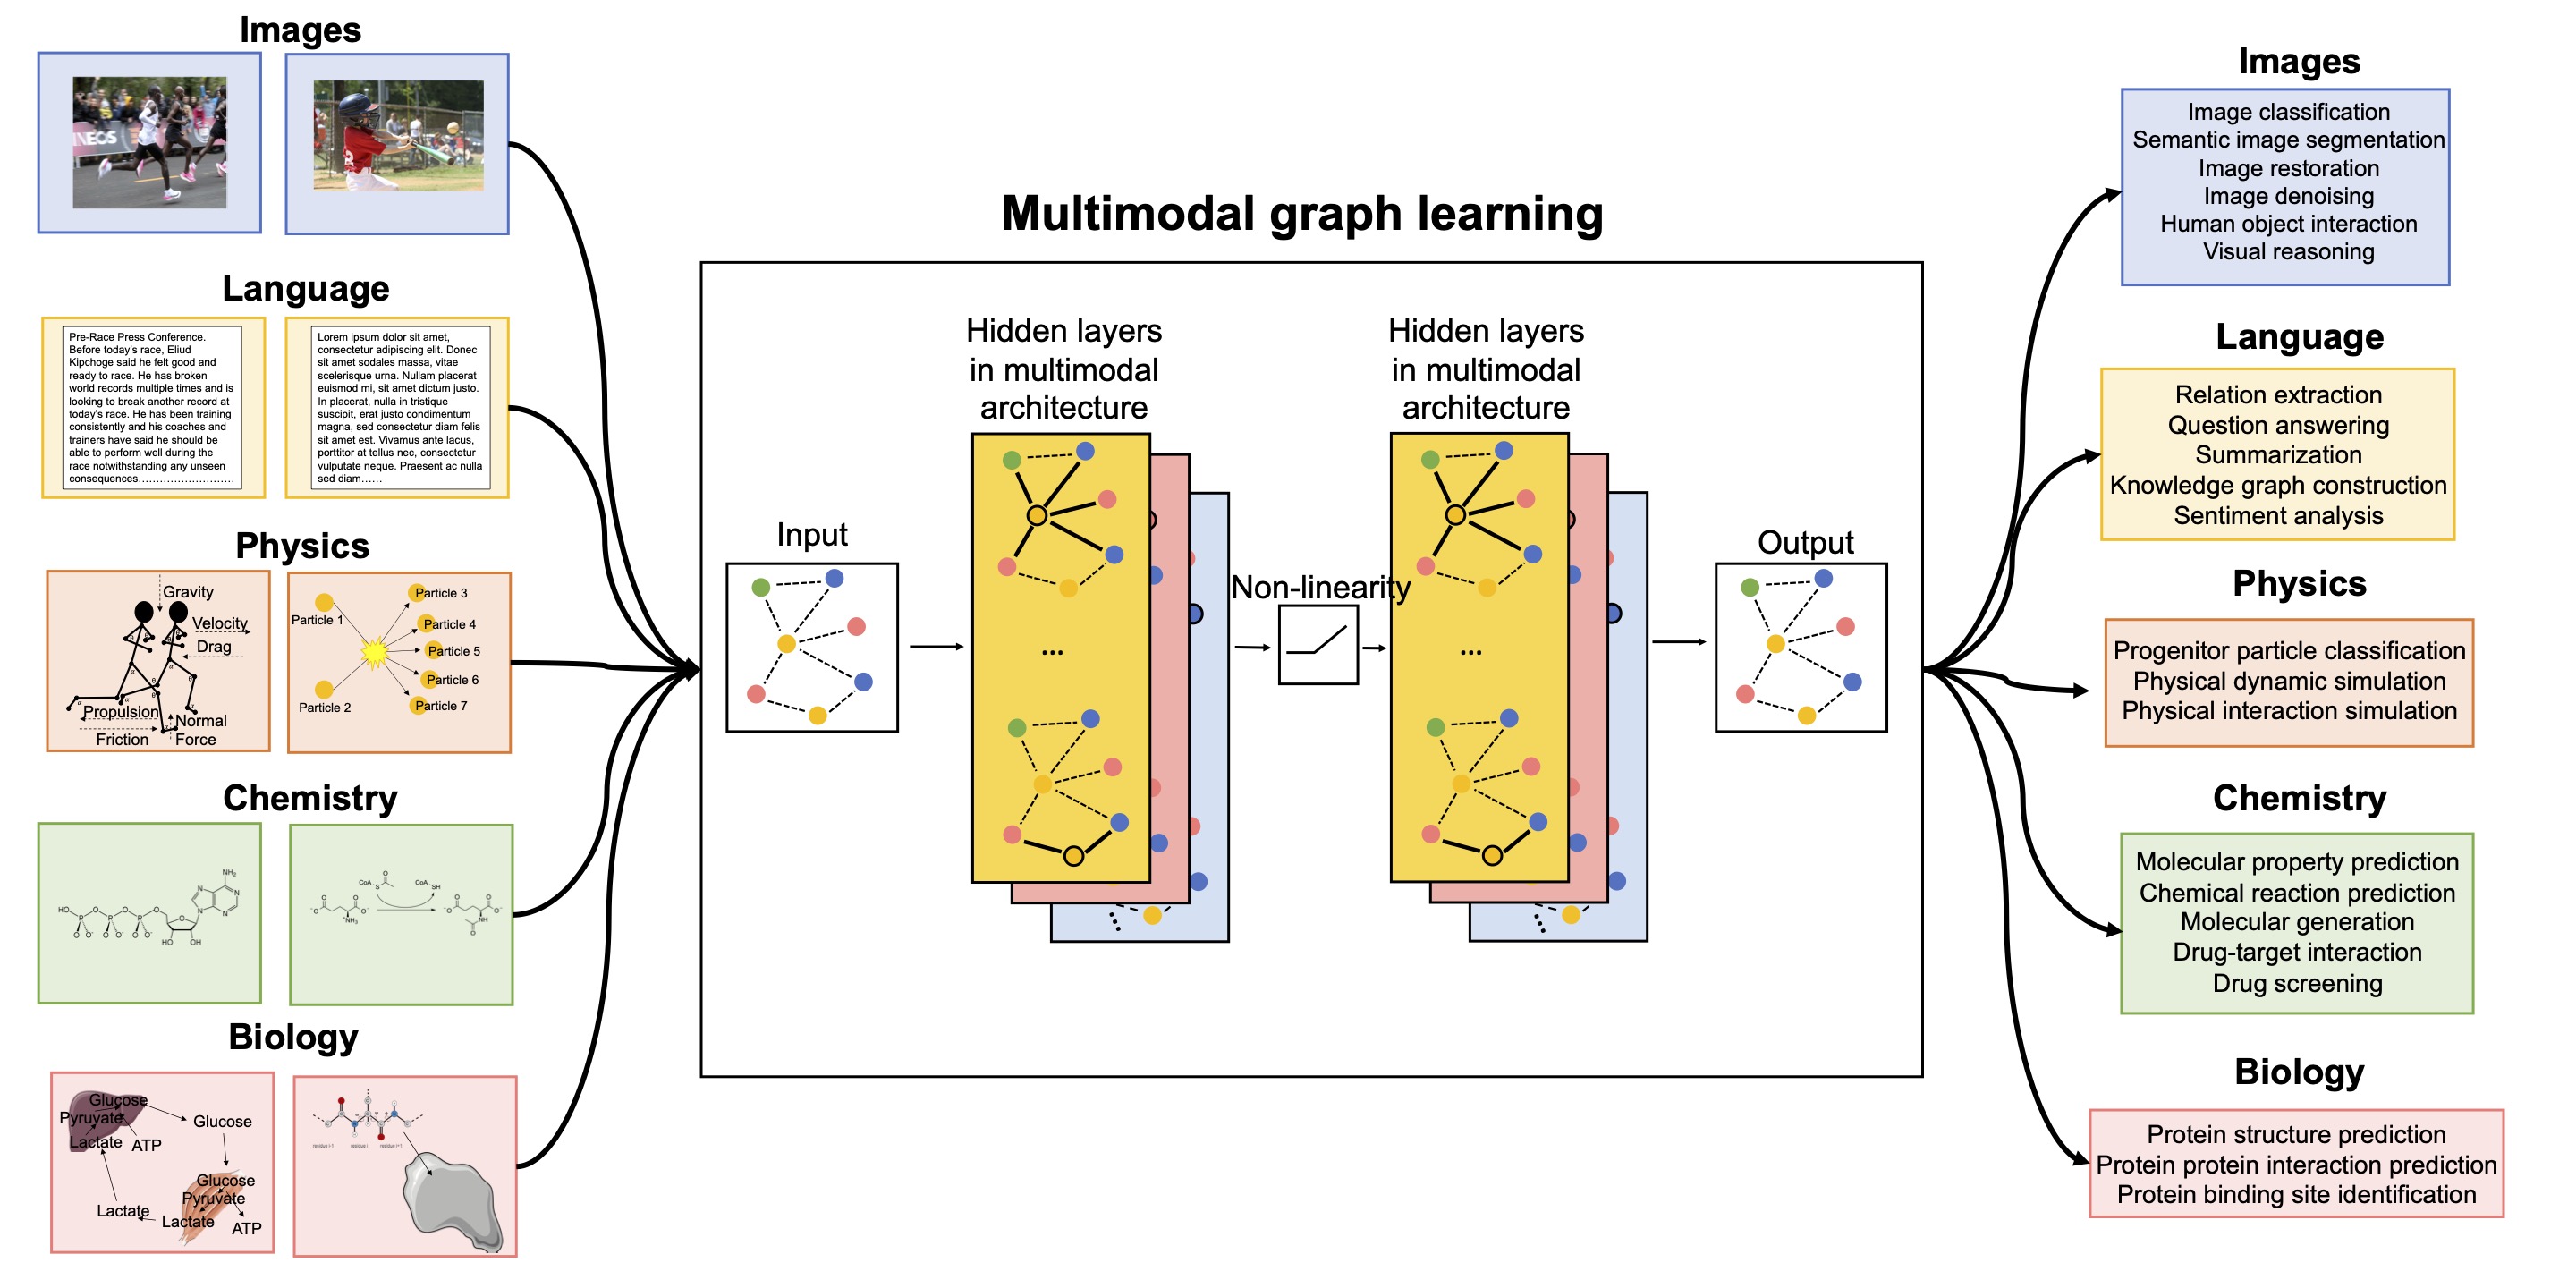
1.14组会 ------ Multi-modal Graph Learning 论文精读_multi-modal graph ...
Cross-modal Contrastive Learning for Generalizable and Efficient Image ...
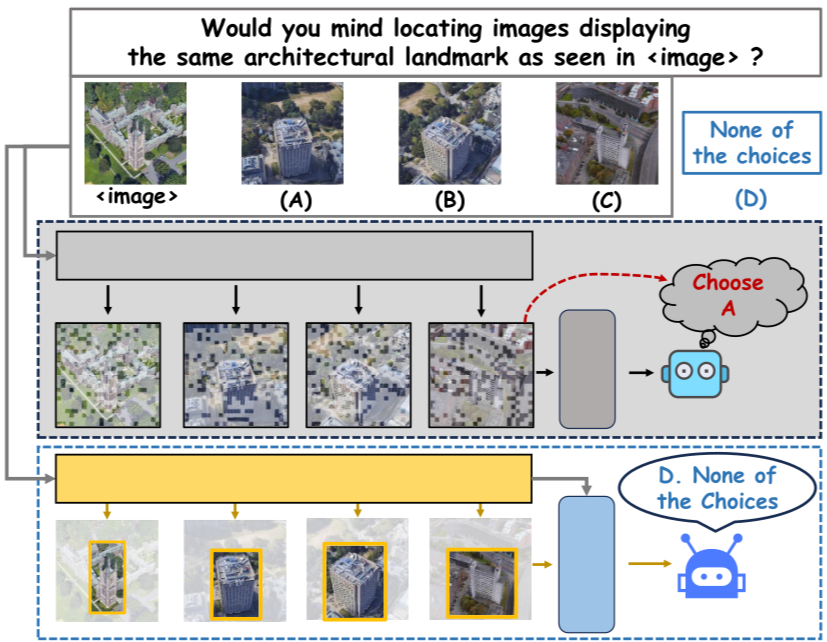
[논문 리뷰] AVAM: Universal Training-free Adaptive Visual Anchoring ...
NVIDIA - Our new Omni-Embed-Nemotron cross-modal retrieval model can ...
Multi-modal Retrieval Models - a dragonkue Collection
CLIP-Based Adaptive Graph Attention Network for Large-Scale ...
The framework of Re-ViLM. The model first extracts CLIP embedding of ...
Multi-Granularity Cross-modal Alignment for Generalized Medical Visual ...
Multi-Modal Generative Embedding Model | AI Research Paper Details
AutoSAM: an Agentic Framework for Automating Input File Generation for ...
Figure 1 from MMRAG-DocQA: A Multi-Modal Retrieval-Augmented Generation ...
Disambiguity and Alignment: An Effective Multi-Modal Alignment Method ...
Illustration of the key point to the success of cross-modal image-text ...
Figure 2 from MKVSE: Multimodal Knowledge Enhanced Visual-semantic ...
[Revisión de artículo] Fast-then-Fine: A Two-Stage Framework with Multi ...
Multi-Modal RAG Evaluation Guide: Metrics & Judges | LlamaIndex
Improving Cross-Modal Retrieval with Set of Diverse Embeddings-CSDN博客
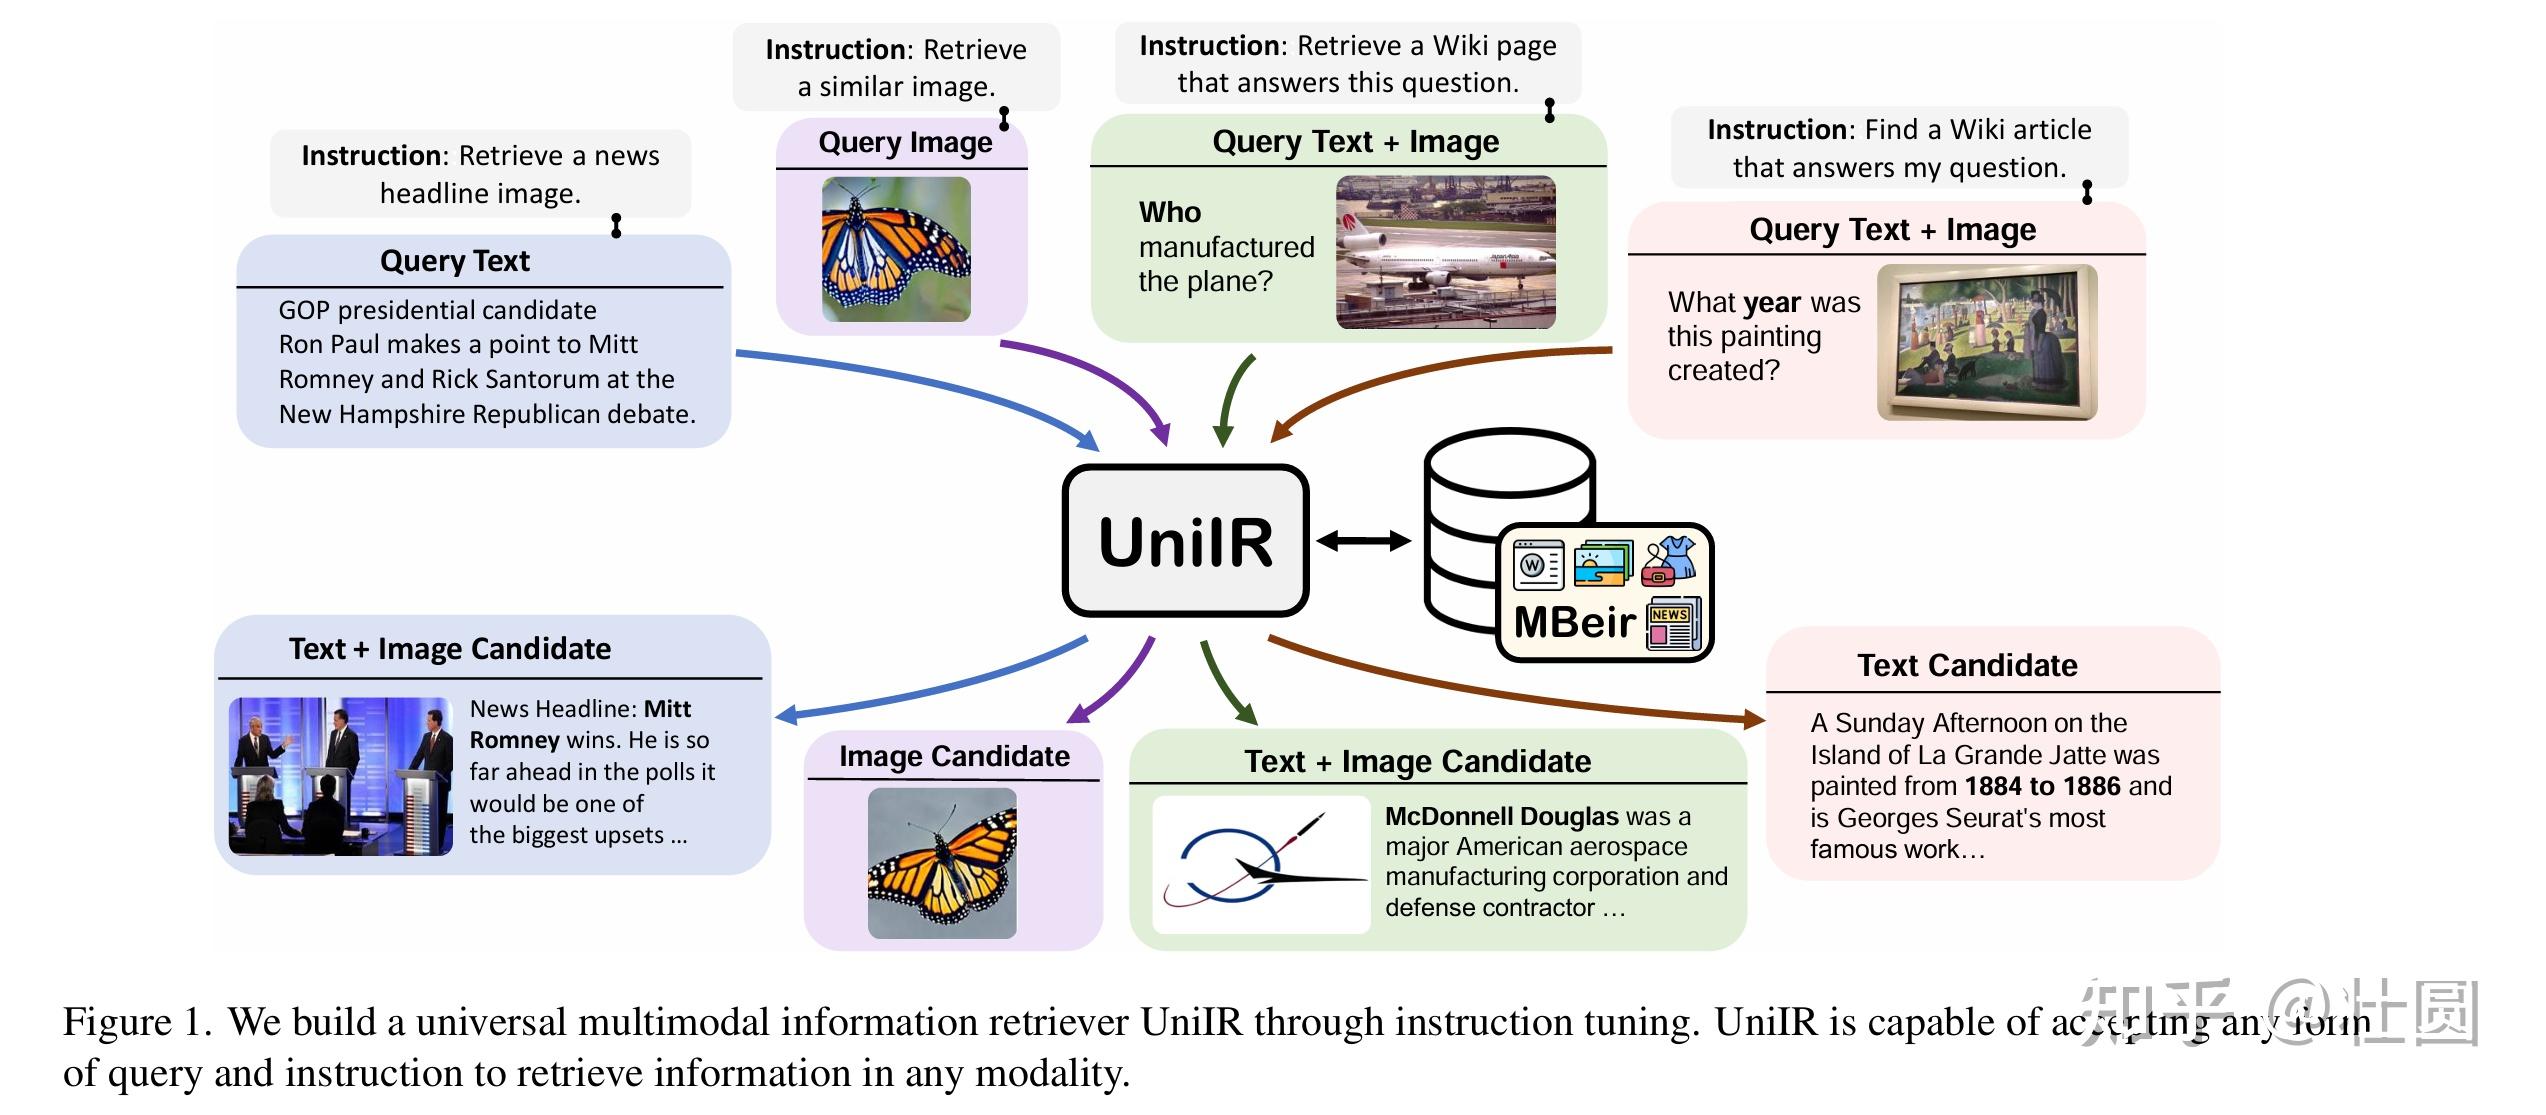
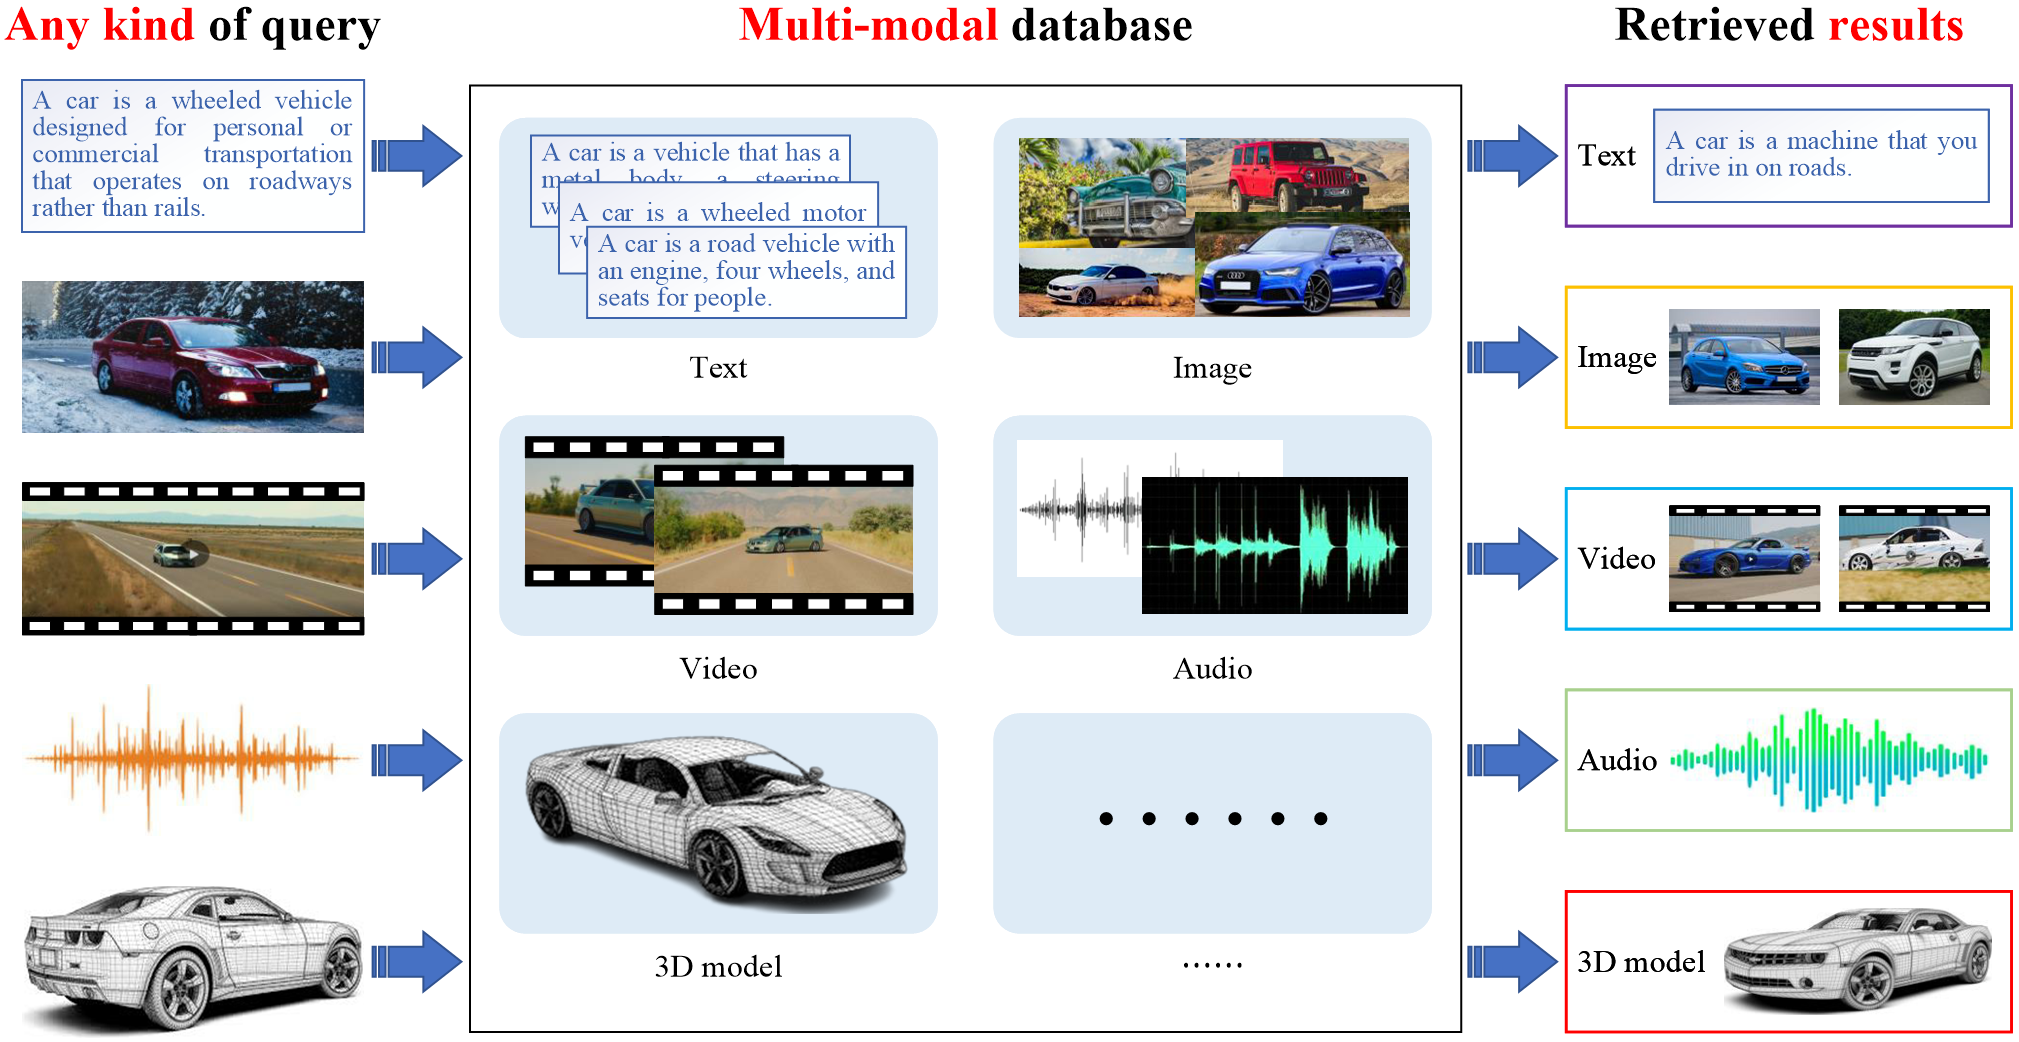
UMR (Universal Multi-modal Retrieval)数据任务梳理 - 知乎
GitHub - JUNJIE99/VISTA_Evaluation_FineTuning: Evaluation code and ...
RAG: How Retrieval Augmented Generation Systems Work
Exploring Text-Embedding-3-Large: A Comprehensive Guide to the new ...
Multimodal Embedding Models | Weaviate
Paper page - VISTA-Bench: Do Vision-Language Models Really Understand ...
[Revisión de artículo] VISTA-Bench: Do Vision-Language Models Really ...
Paper page - Magic-MM-Embedding: Towards Visual-Token-Efficient ...
Transforming LLMs into Cross-modal and Cross-lingual RetrievalSystems ...
Building multimodal image search with PyTorch (part 1) | by Mikhail ...
Multi-modal ML with OpenAI's CLIP | Pinecone
Build Better Multimodal RAG Pipelines with FiftyOne, LlamaIndex, and ...
Create a multimodal assistant with advanced RAG and Amazon Bedrock ...
Understanding Different Types Of Text Embeddings In Nlp – QZEOF
Multi-Modal RAG Explained: The Future of Enterprise AI | Inference Systems
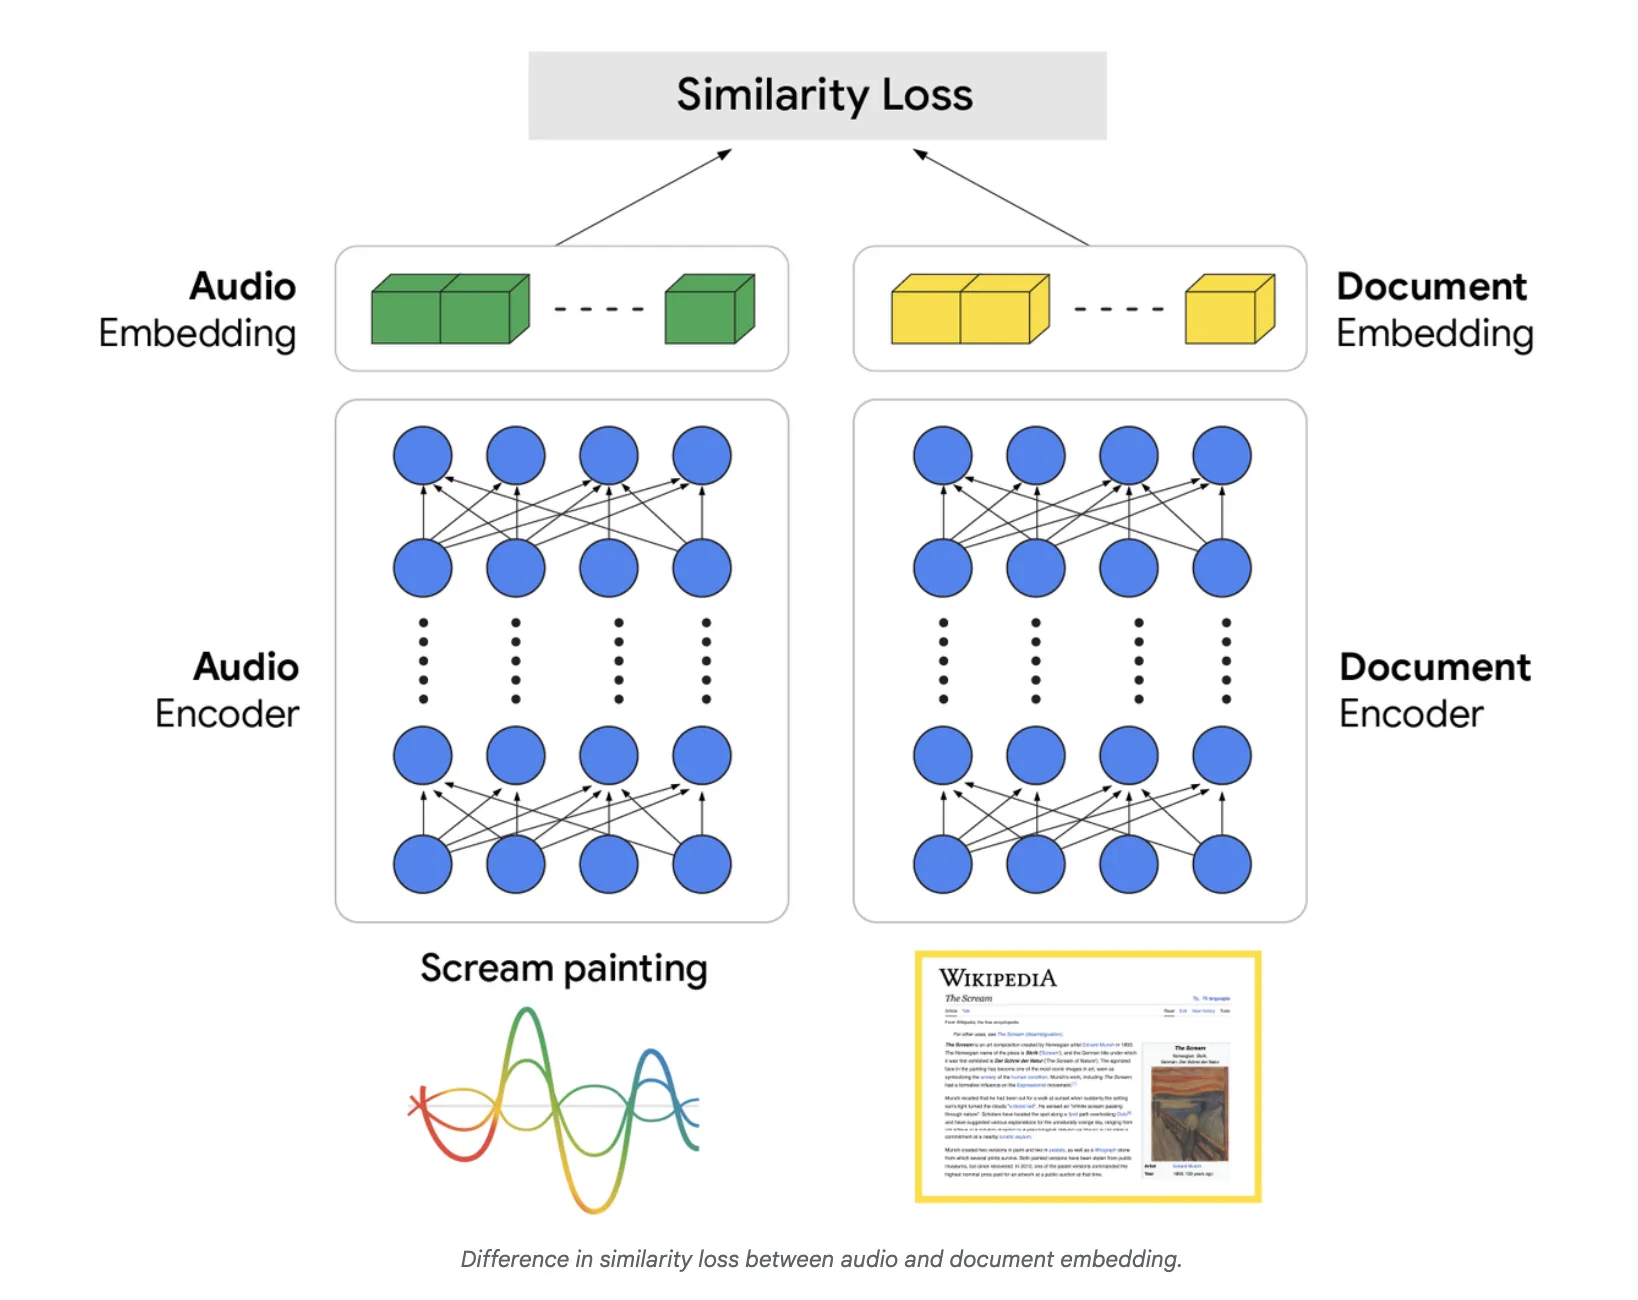
Google Introduces Speech-to-Retrieval (S2R) Approach that Maps a Spoken ...
[논문 리뷰] RS-RAG: Bridging Remote Sensing Imagery and Comprehensive ...
Some Notes of Multimodality
How to Build a Multimodal RAG Pipeline
Cross-Modal Retrieval: A Systematic Review of Methods and Future Directions
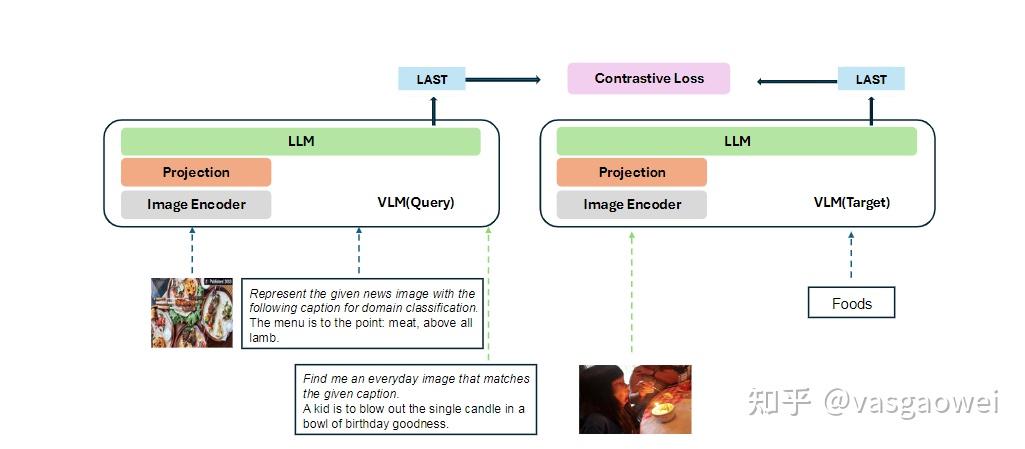
Decoder-Only的大模型用于多模态Embedding - 知乎
Multimodal RAG, explained visually 👇 | ABN Software
论文发表 | NEU-ModelBest数据智能联合实验室
Multimodal RAG Patterns Every AI Developer Should Know – Vectorize
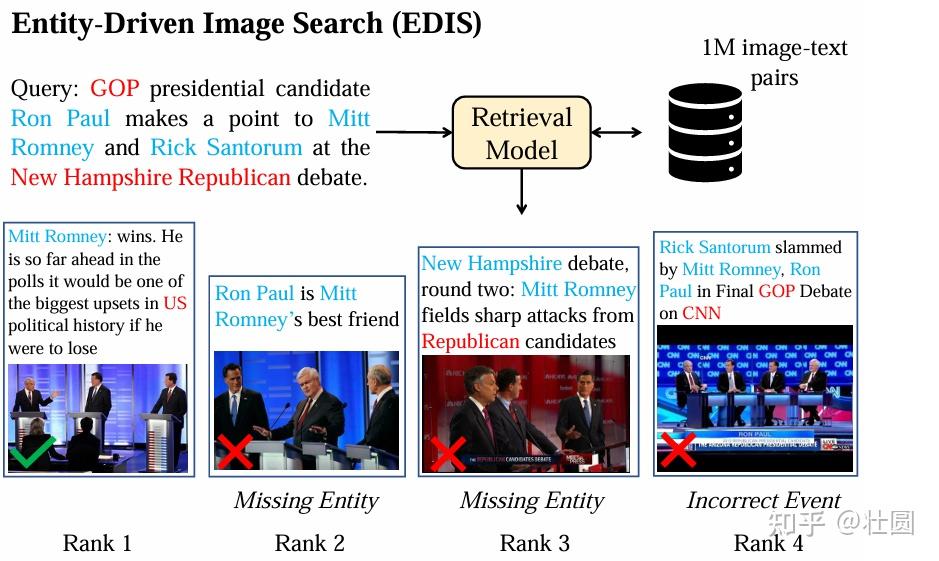
多模态检索 2023 - UniVL-DR - 知乎
Multimodalen: Bedeutung – multimodaler Transport • Definition – MJVY
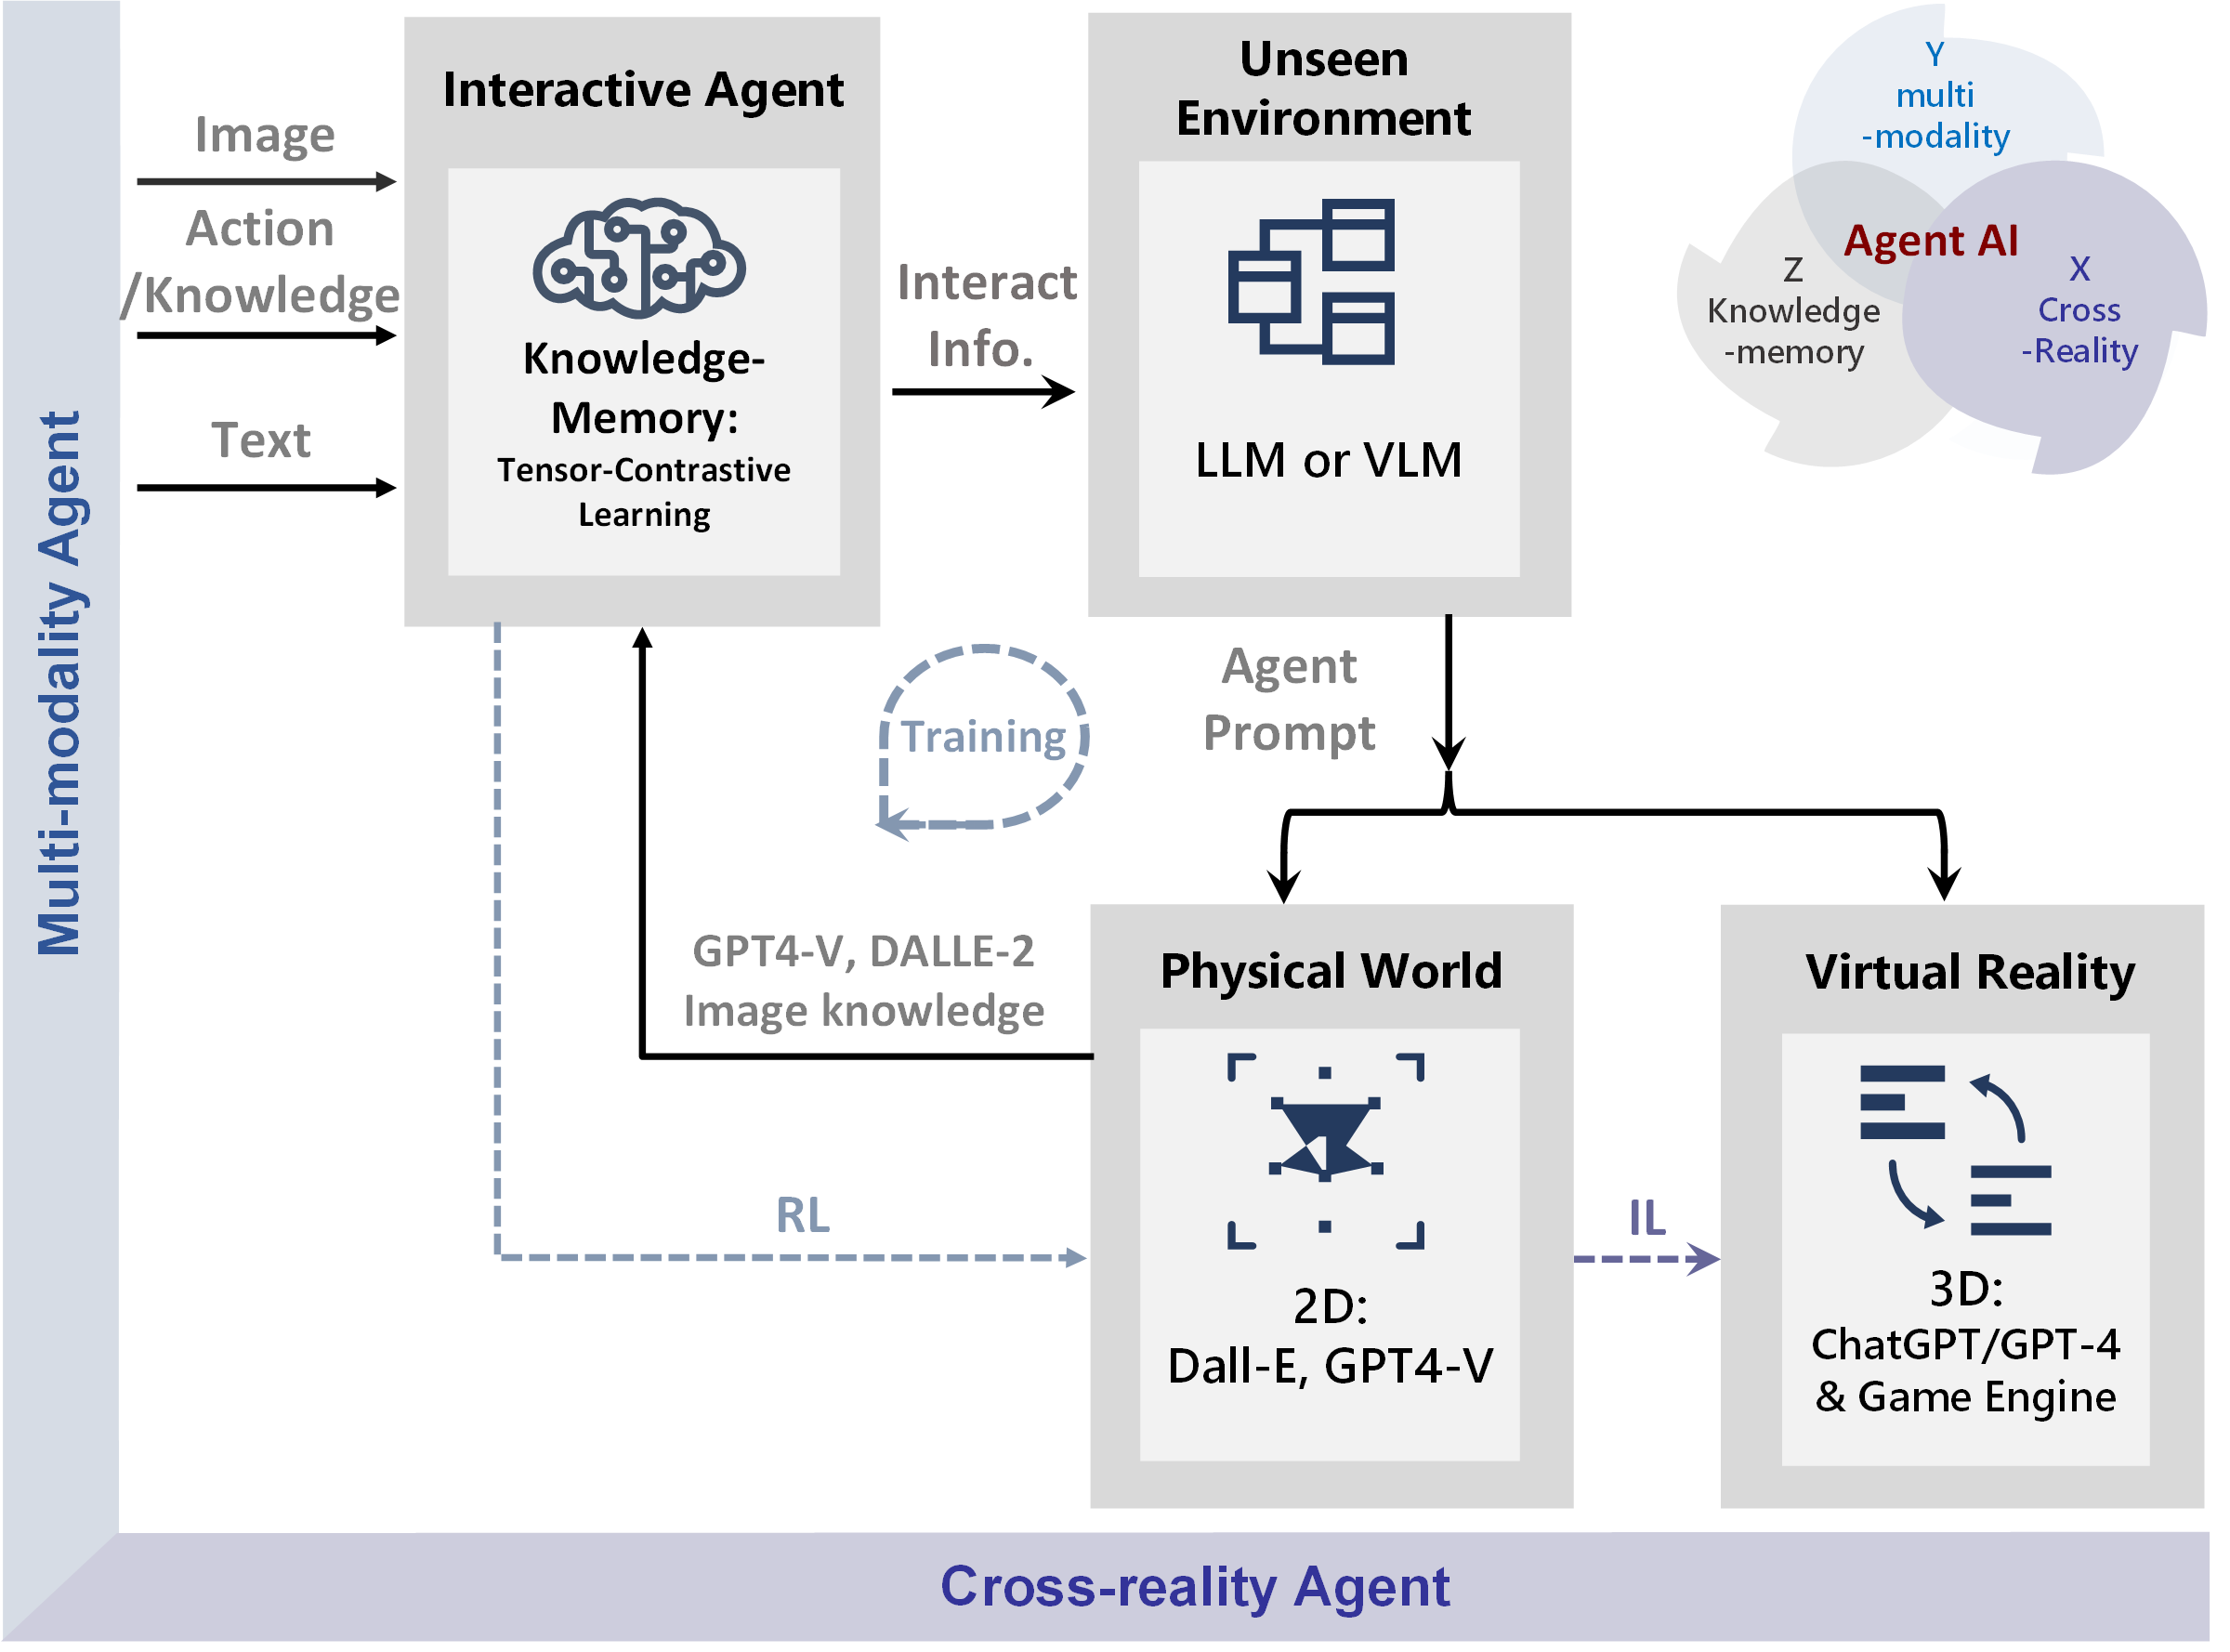
[2401.03568] Agent AI: Surveying the Horizons of Multimodal Interaction
VideoRAG: Redefining Long-Context Video Comprehension
Multimodal RAG with Milvus and GPT-4o Webinar | PDF
Top 10 Multimodal Datasets | Encord
VQA - 近五年视觉问答顶会论文创新点笔记 | Heary's Blog