Showing 120 of 120on this page. Filters & sort apply to loaded results; URL updates for sharing.120 of 120 on this page
LLM Human Preference Data - Ultrafeedback | Kaggle
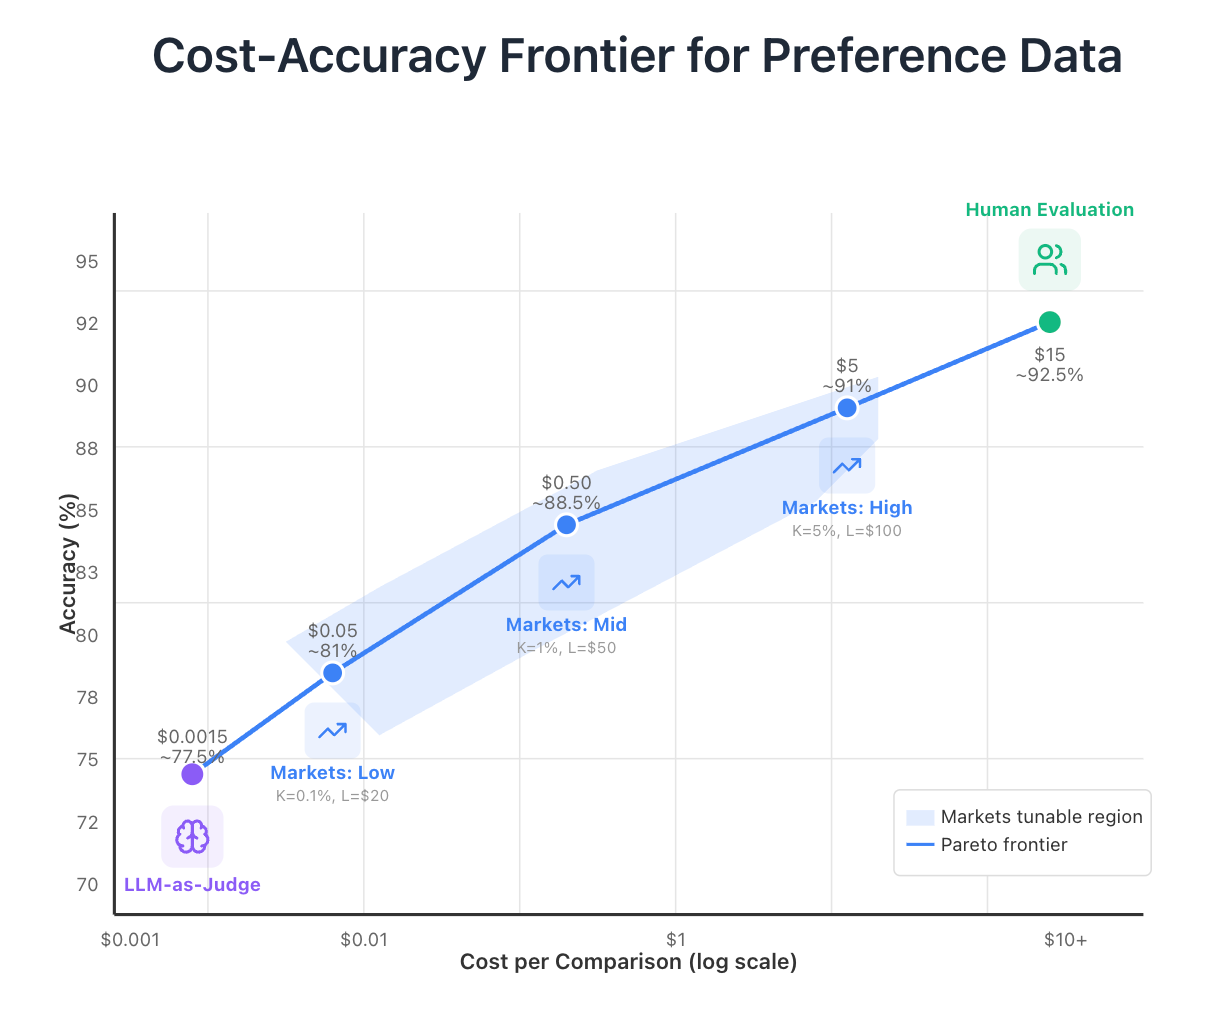
Markets as a Judge: Scaling Human Preference Data with Prediction ...
Human preference data for unverifiable tasks | User Intuition
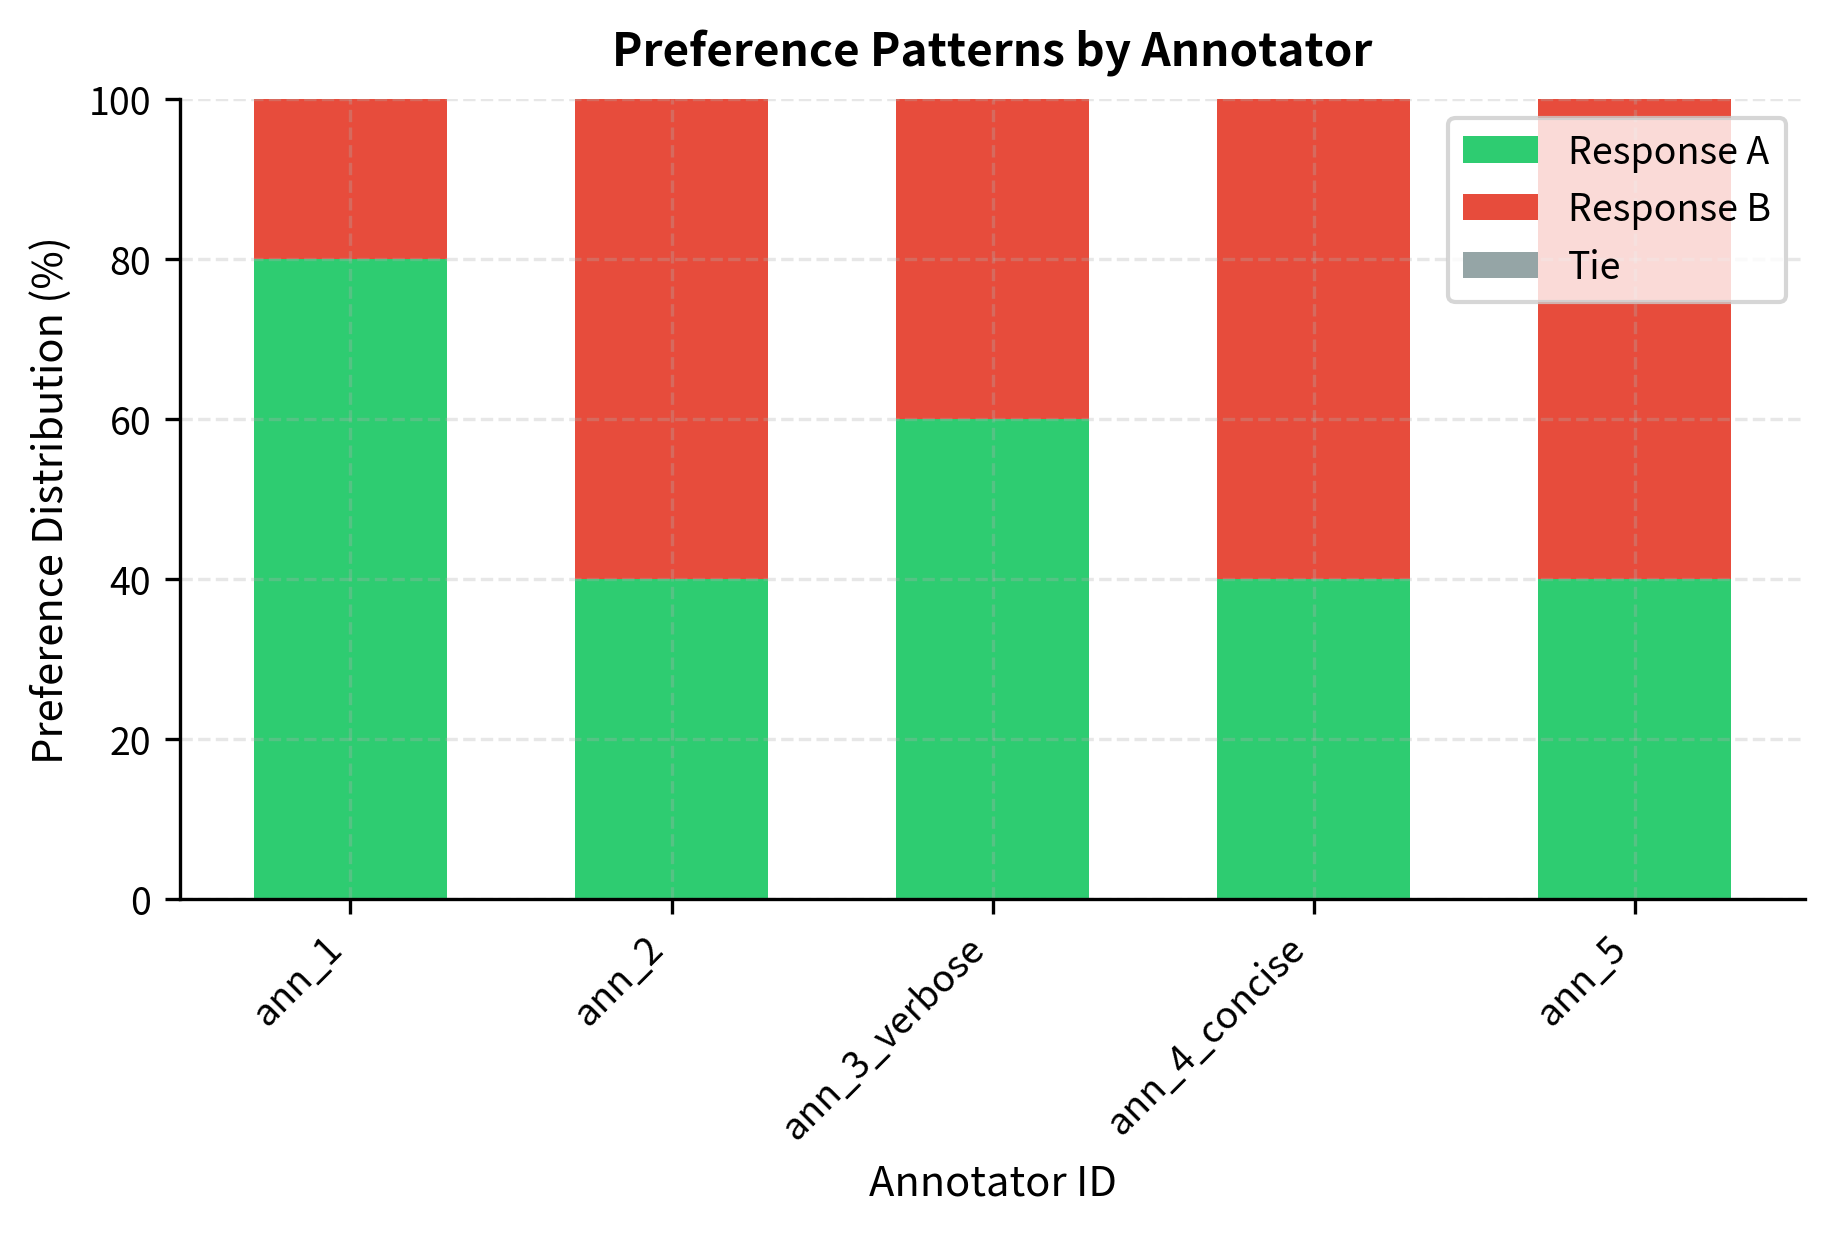
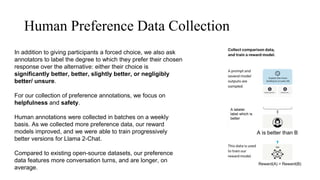
Human Preference Data Collection Strategies
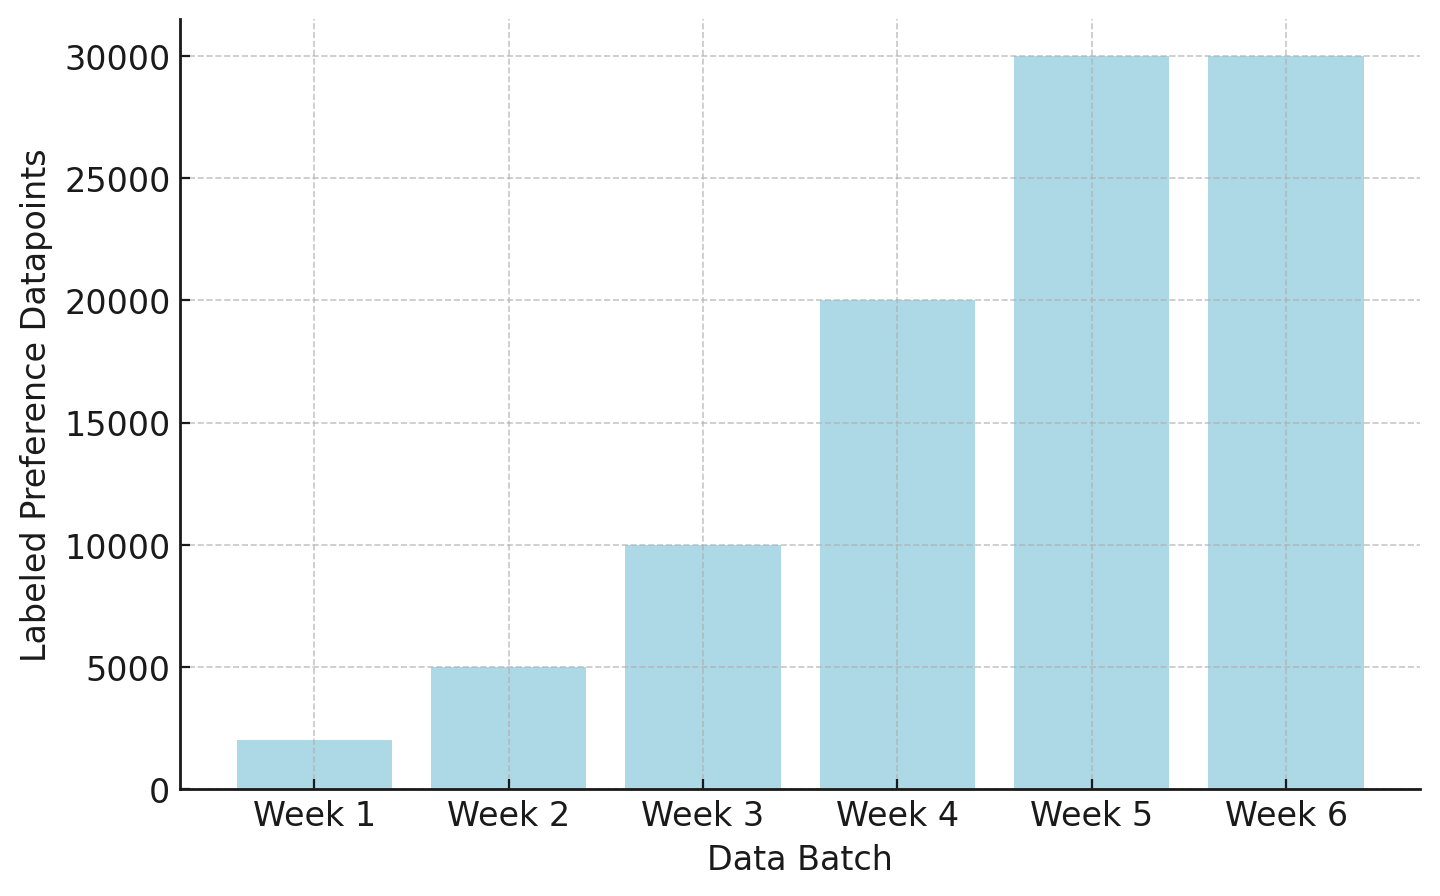
For AI Music, Human Preference Data Outweighs Compute Scale | RiffOn
Human Preference Data: Collection for LLM Alignment - Interactive ...
Histogram of human preference for GeDi, Neox baseline, Default CARP ...
Statistics of human preference amongst the generated descriptions for ...
Human preference in the warm-up stage. The unit denotes the difference ...
(PDF) WorldPM: Scaling Human Preference Modeling
Proposed (A) Human Preference Scaling Model and (B) Human-Demonstration ...
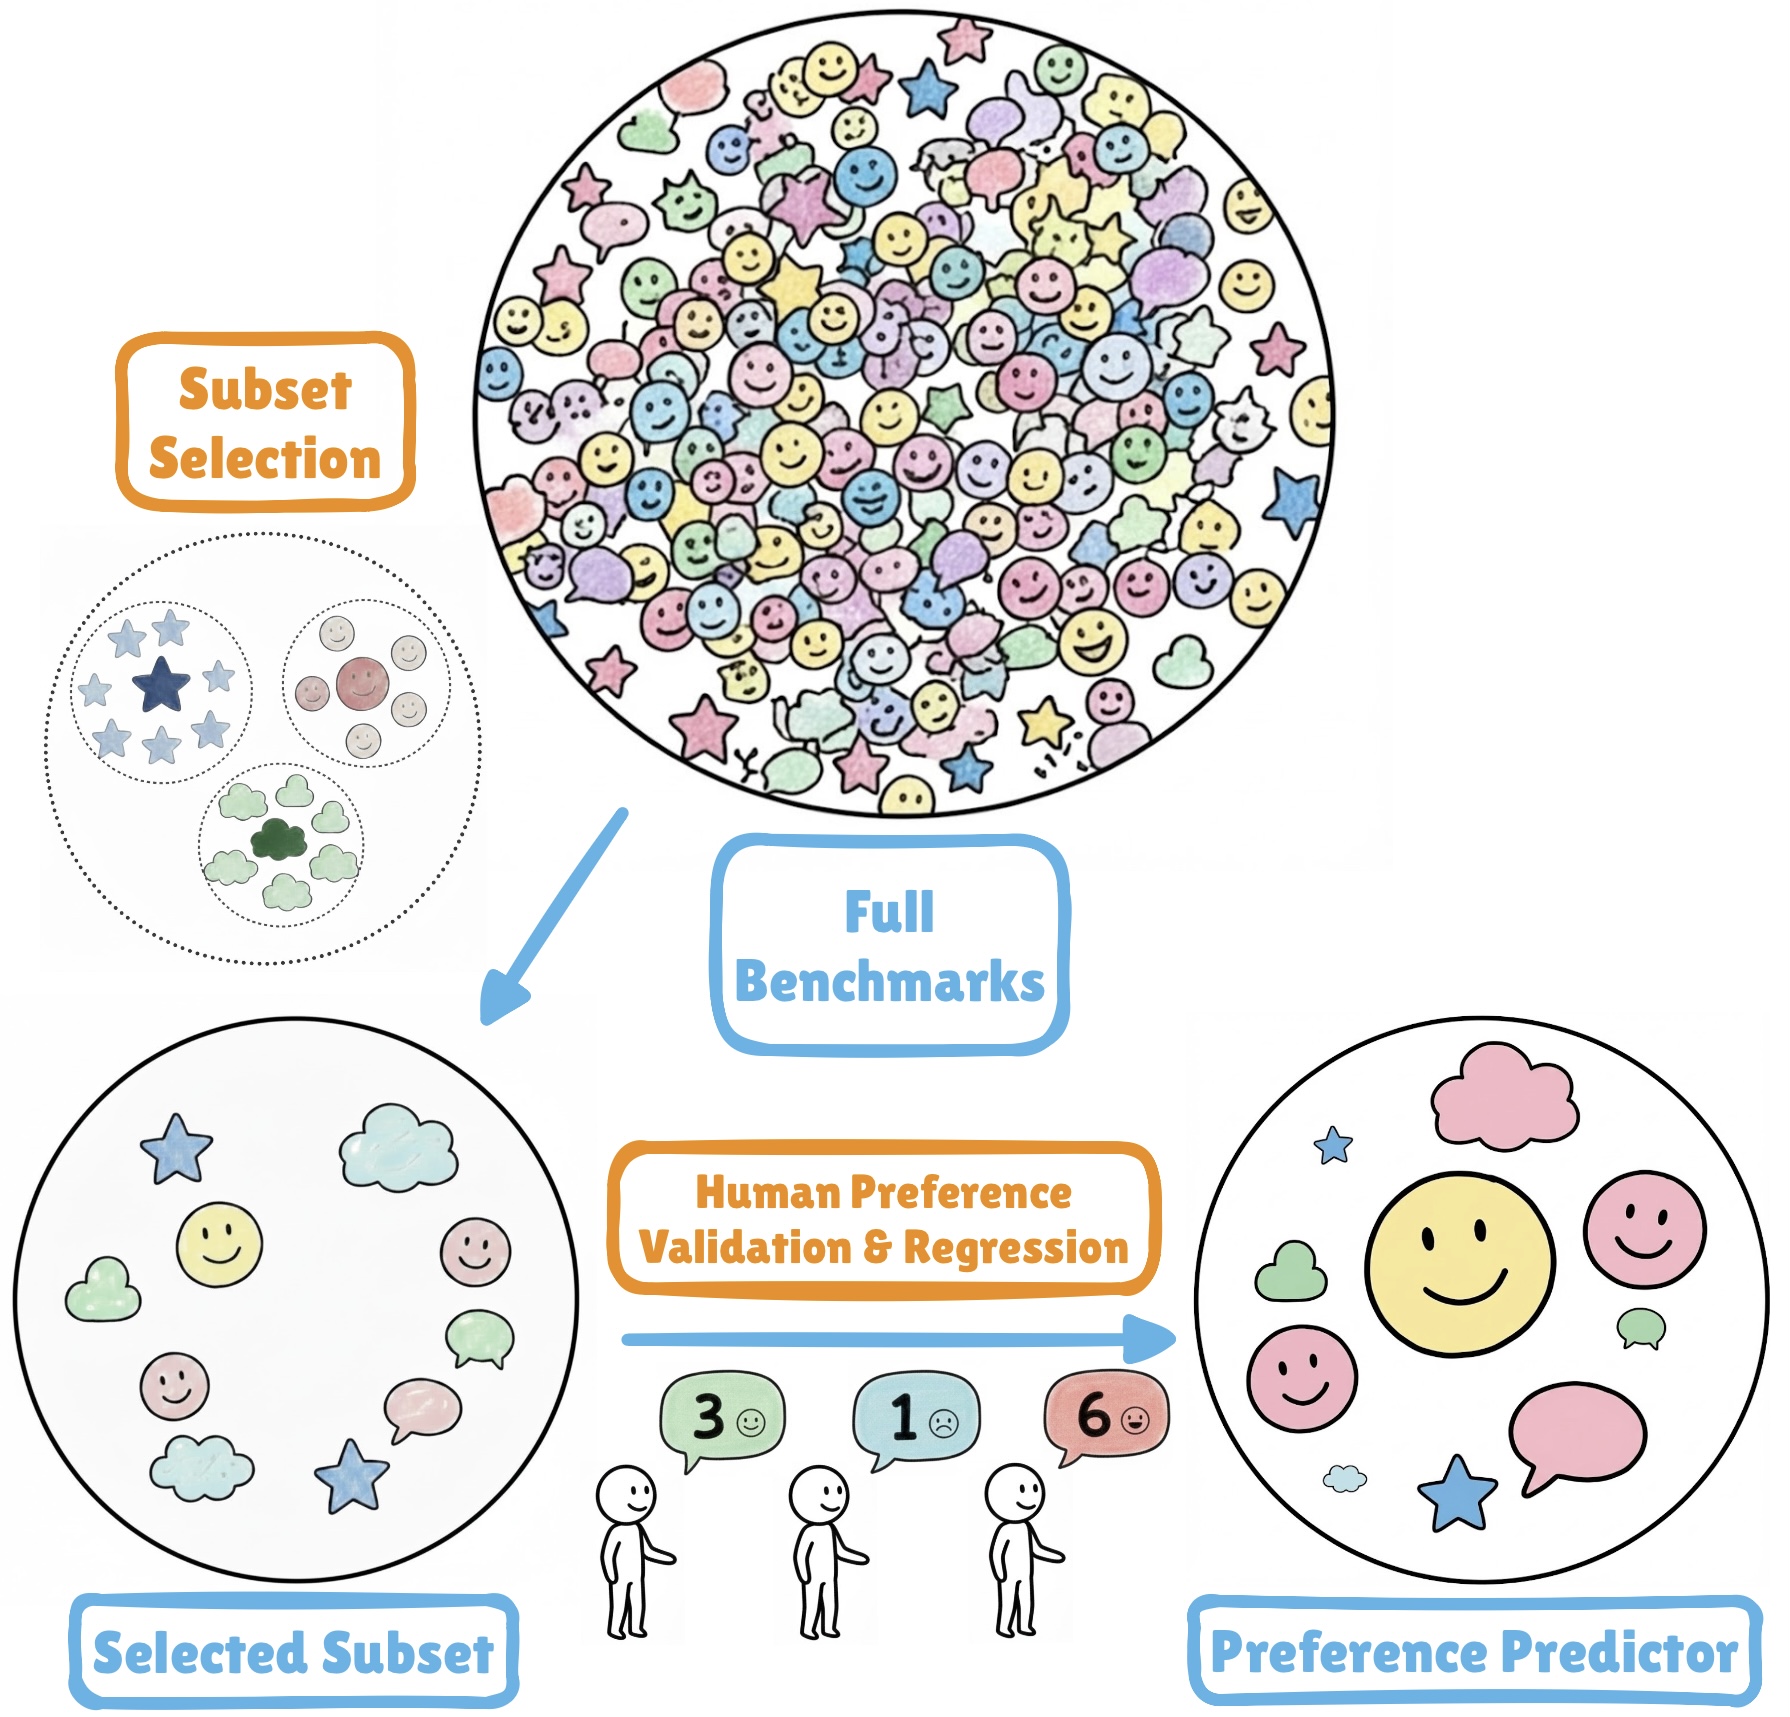
Putting HUMANS first: Efficient LAM Evaluation with Human Preference ...
Human preference evaluation. The left y-axis (and blue bar) represents ...
Rethinking Diverse Human Preference Learning through Principal ...
Modeling Human Preference to Improve LLM Performance - YouTube
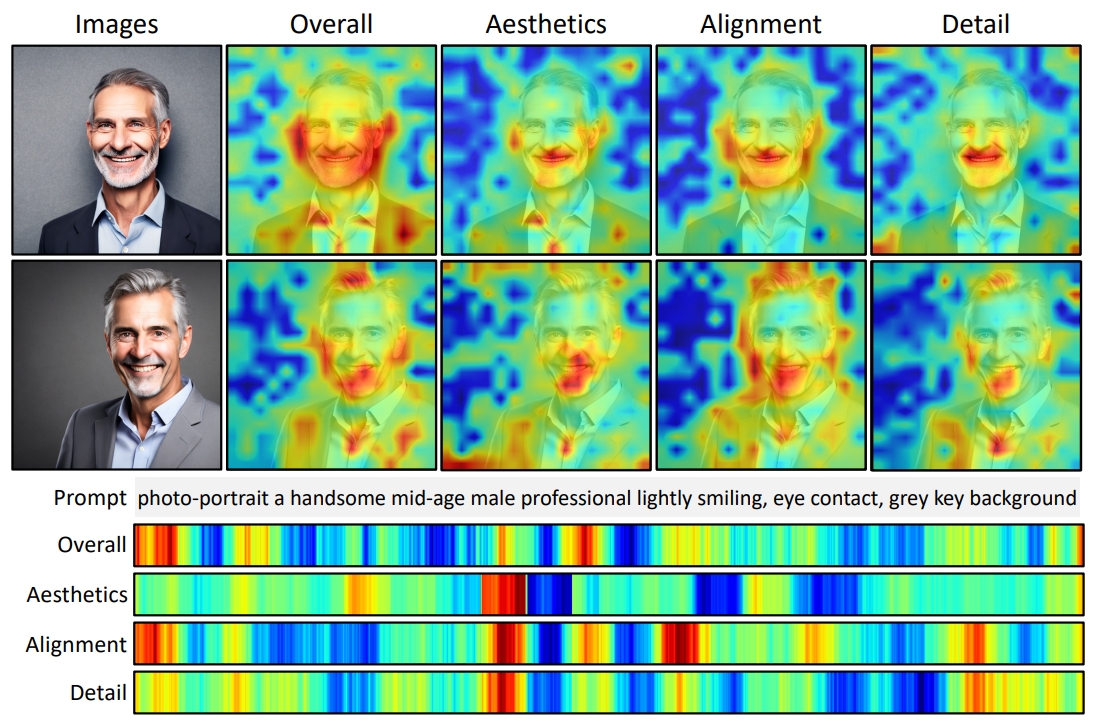
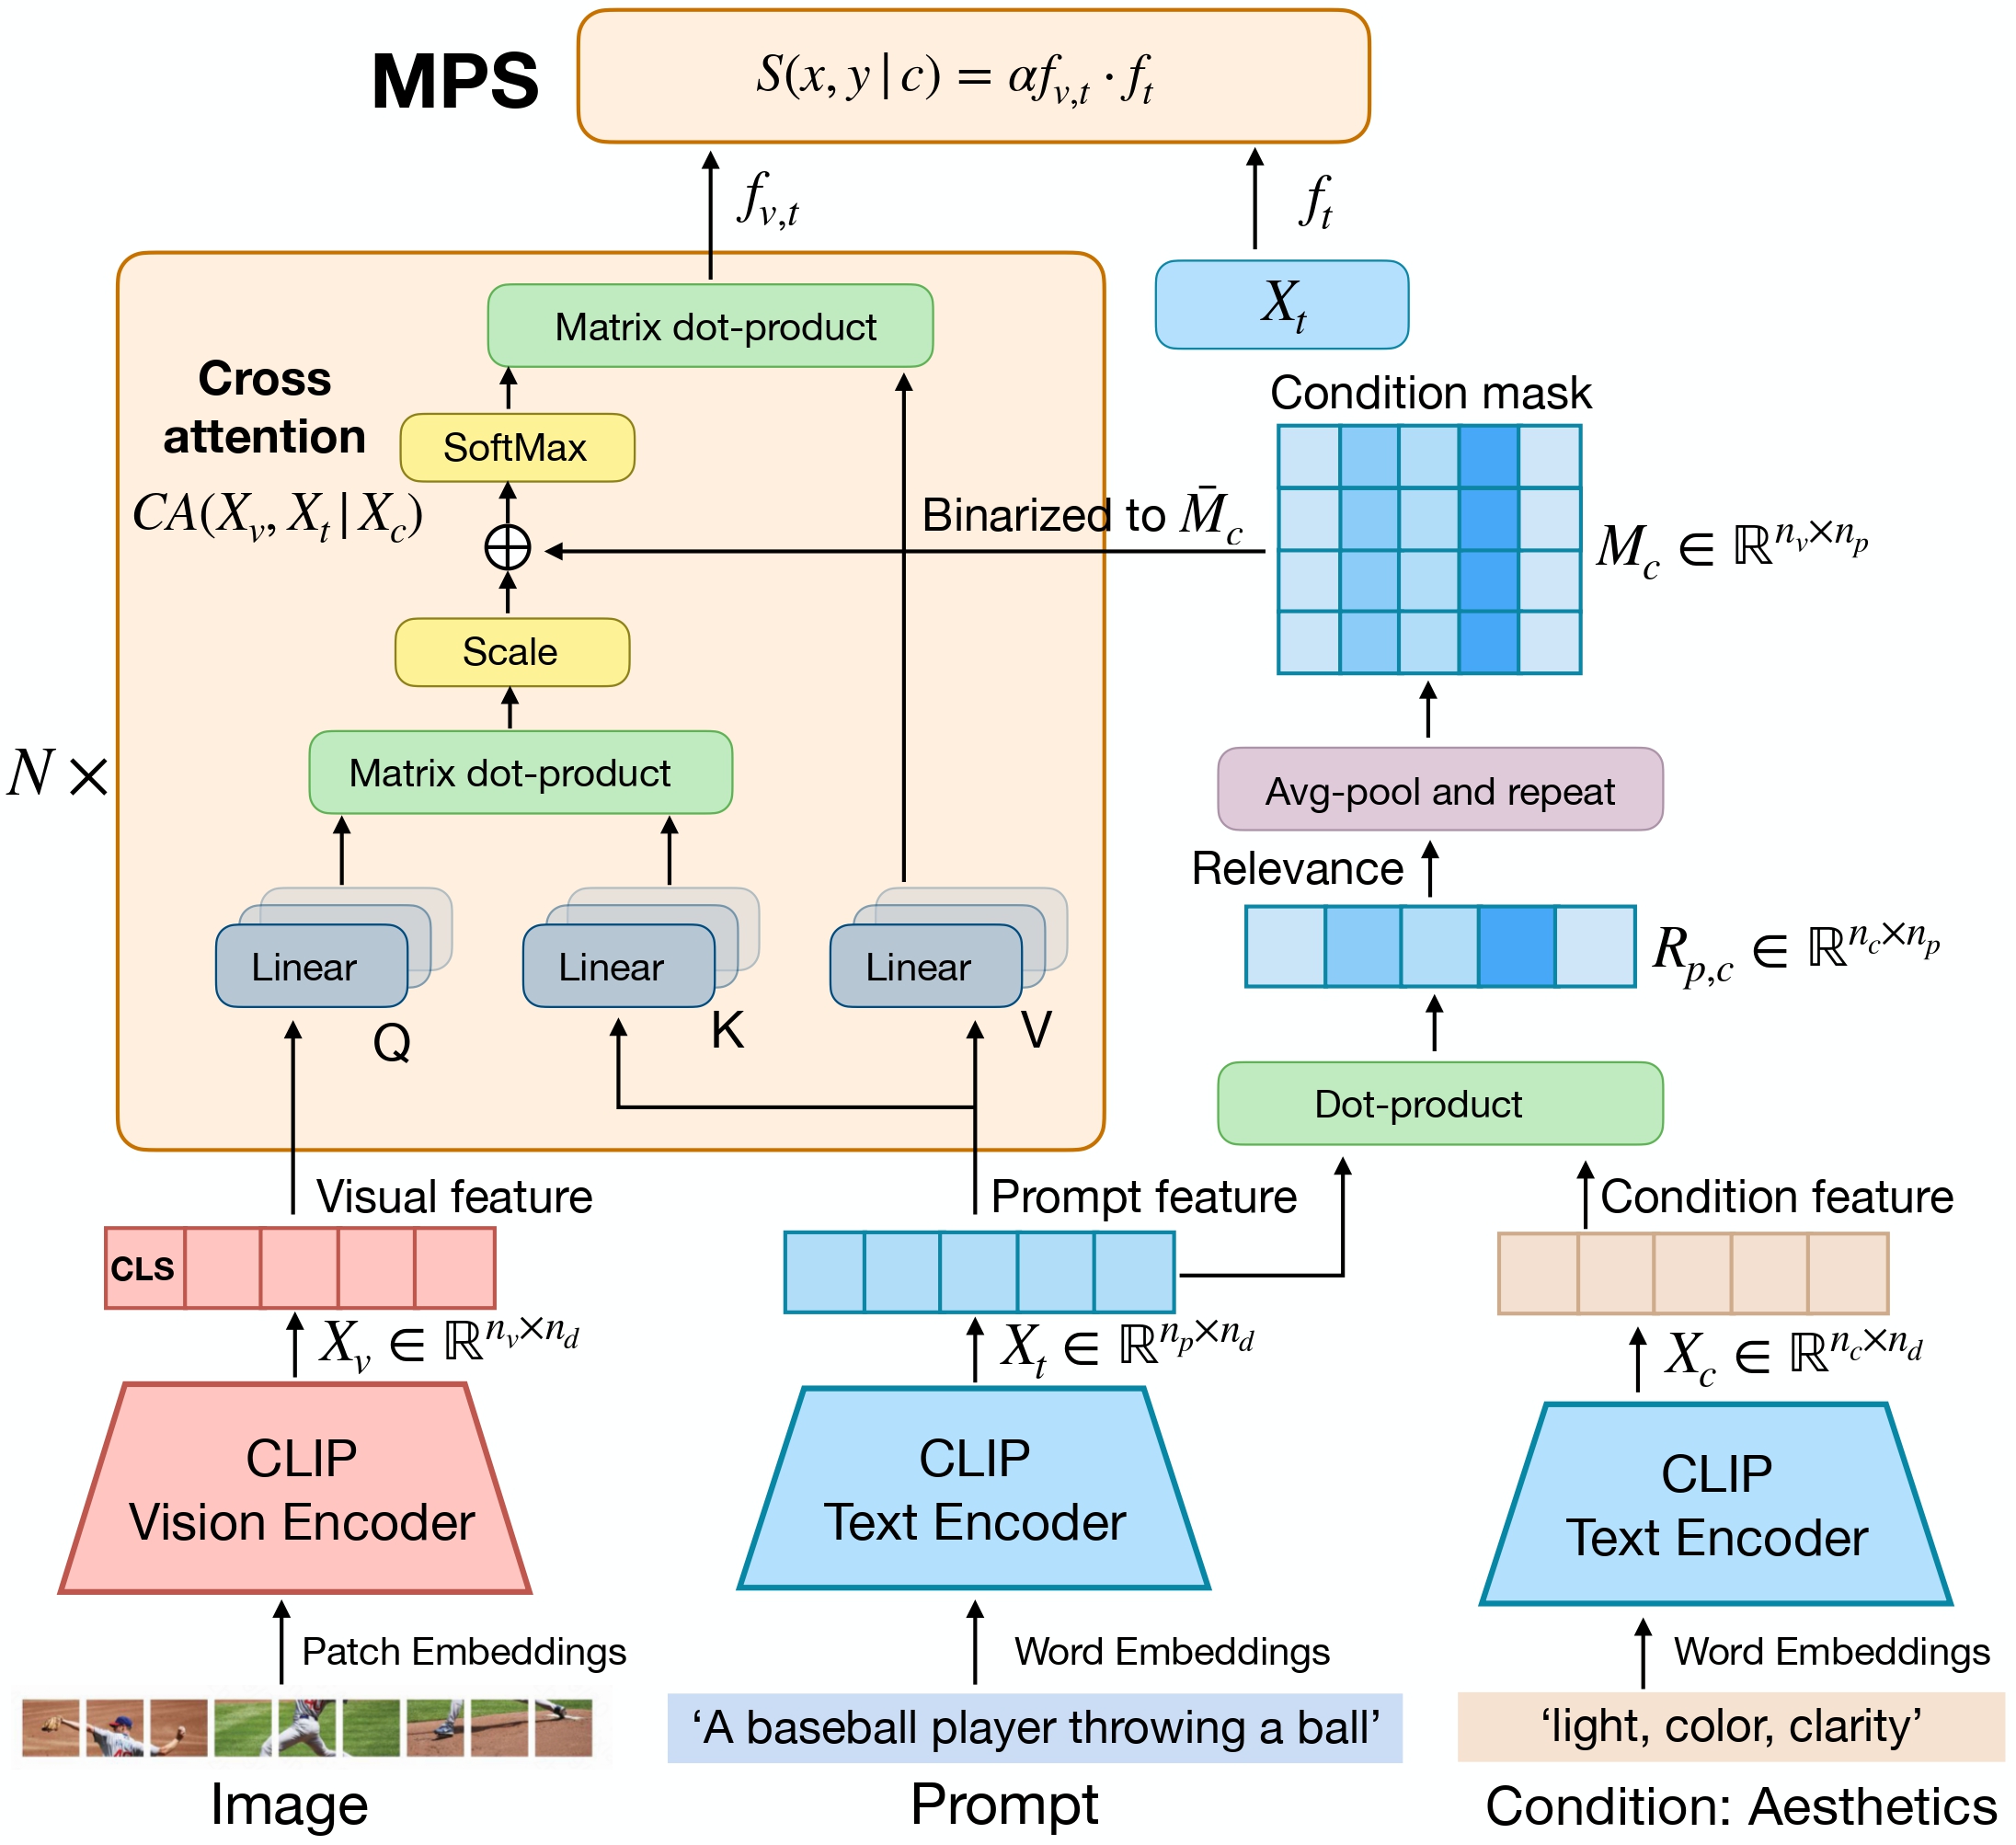
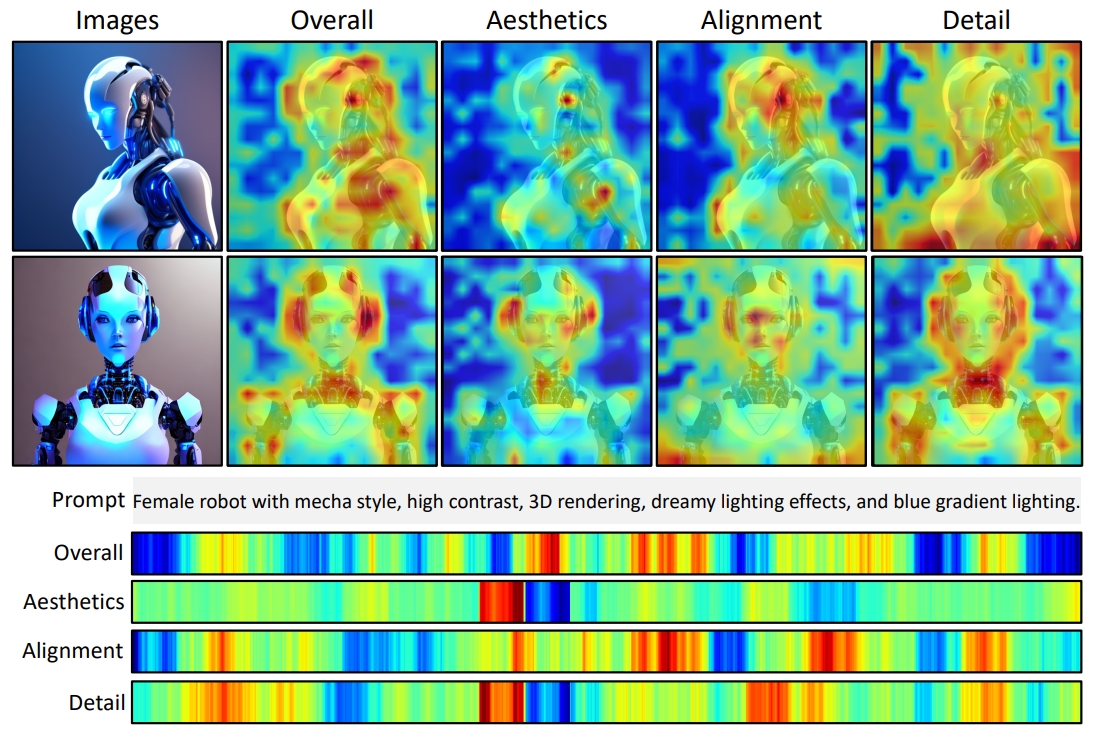
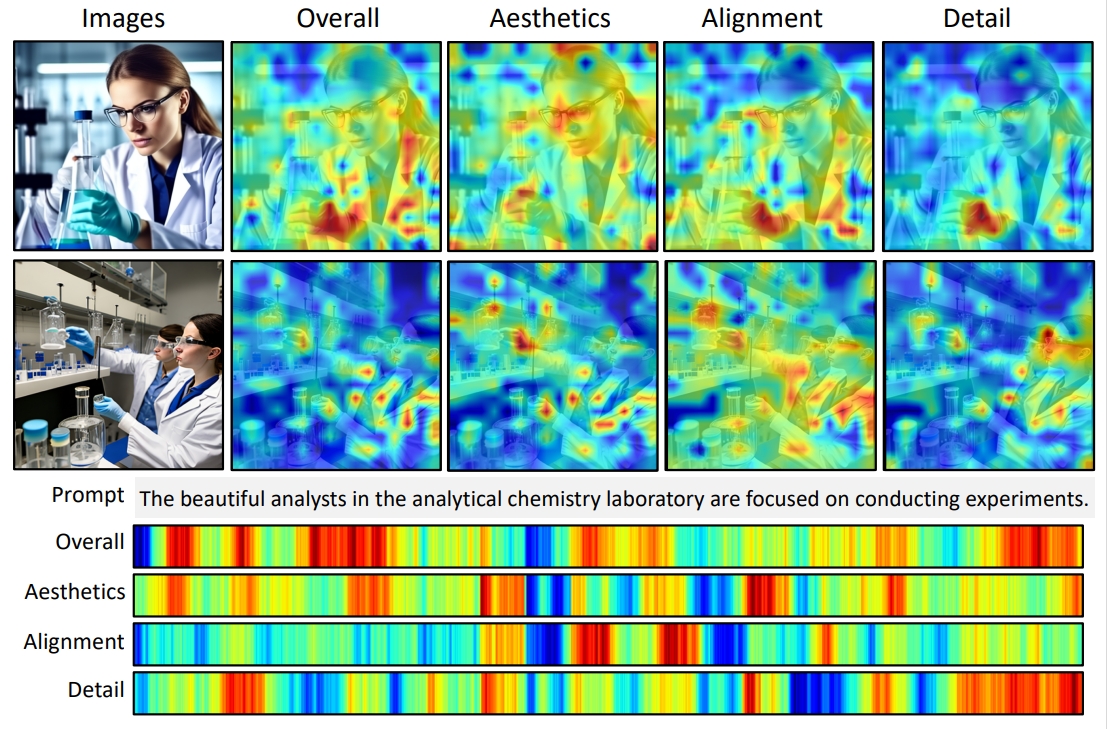
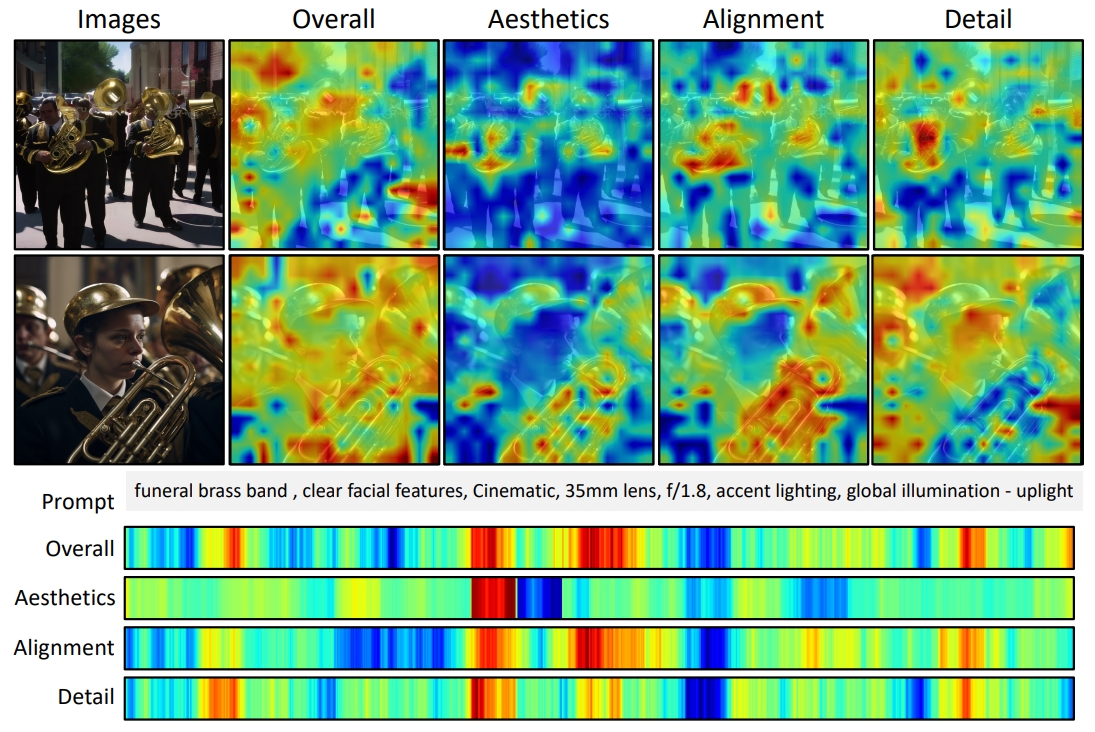
Learning Multi-dimensional Human Preference for Text-to-Image Generation
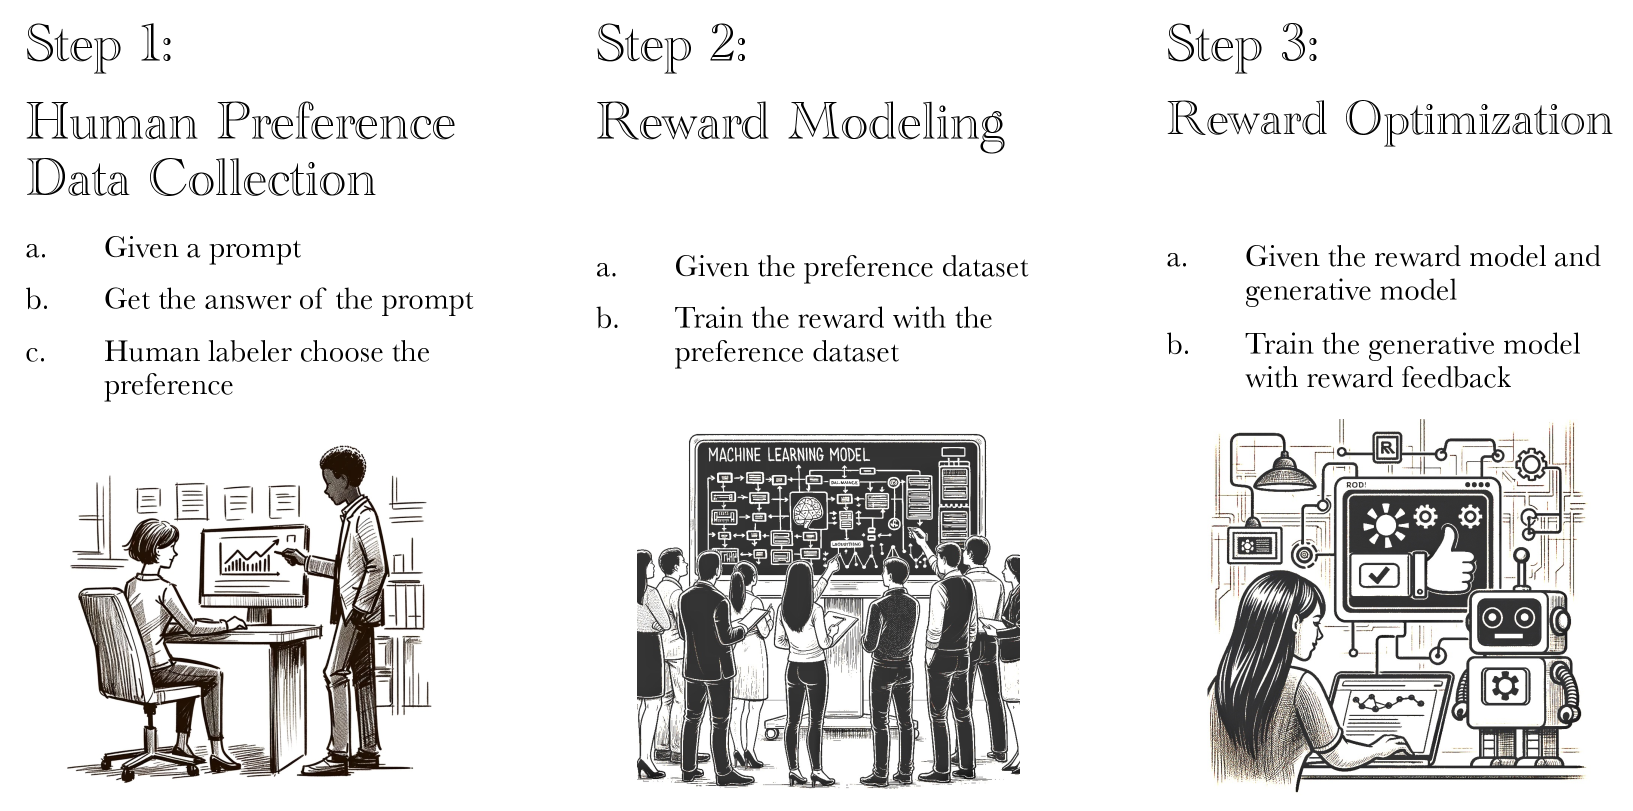
Preference Data | RLHF and Post-Training Book by Nathan Lambert
Unsupervised Human Preference Learning
HPSv3: Towards Wide-Spectrum Human Preference Score | AI Research Paper ...
VisionReward: Fine-Grained Multi-Dimensional Human Preference Learning ...
human preference dataset - a Norkia Collection
1.5 million human preference arena rankings on LLM responses - Not ...
PILAF: Optimal Human Preference Sampling for Reward Modeling | AI ...
| [WMT 2020 Zh-En]: distribution of human preference and reward model ...
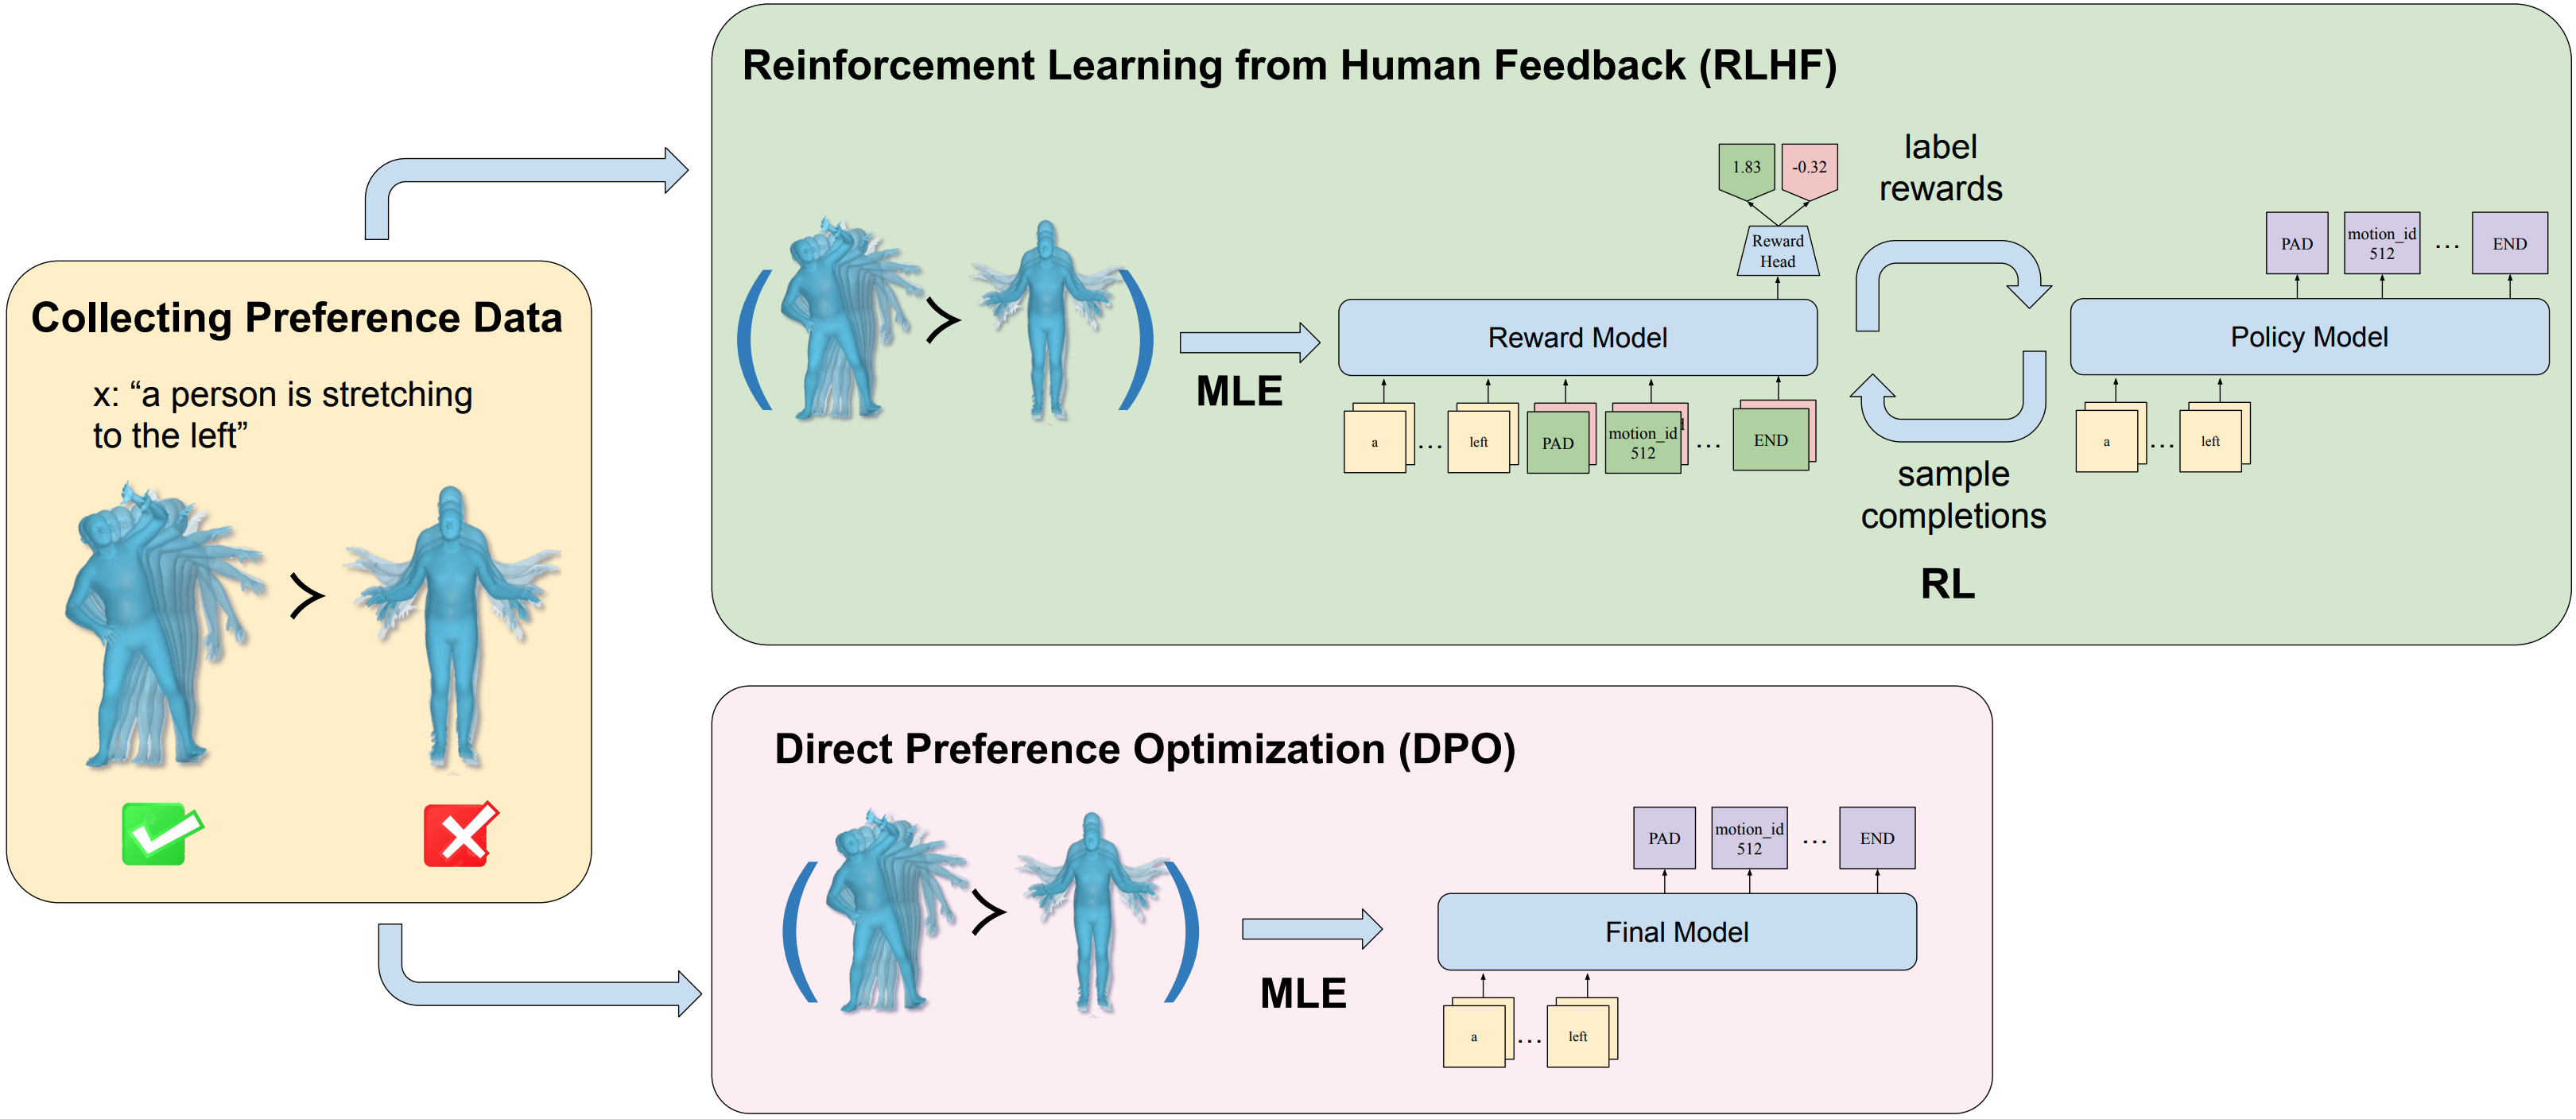
Exploring Text-to-Motion Generation with Human Preference | AI Research ...
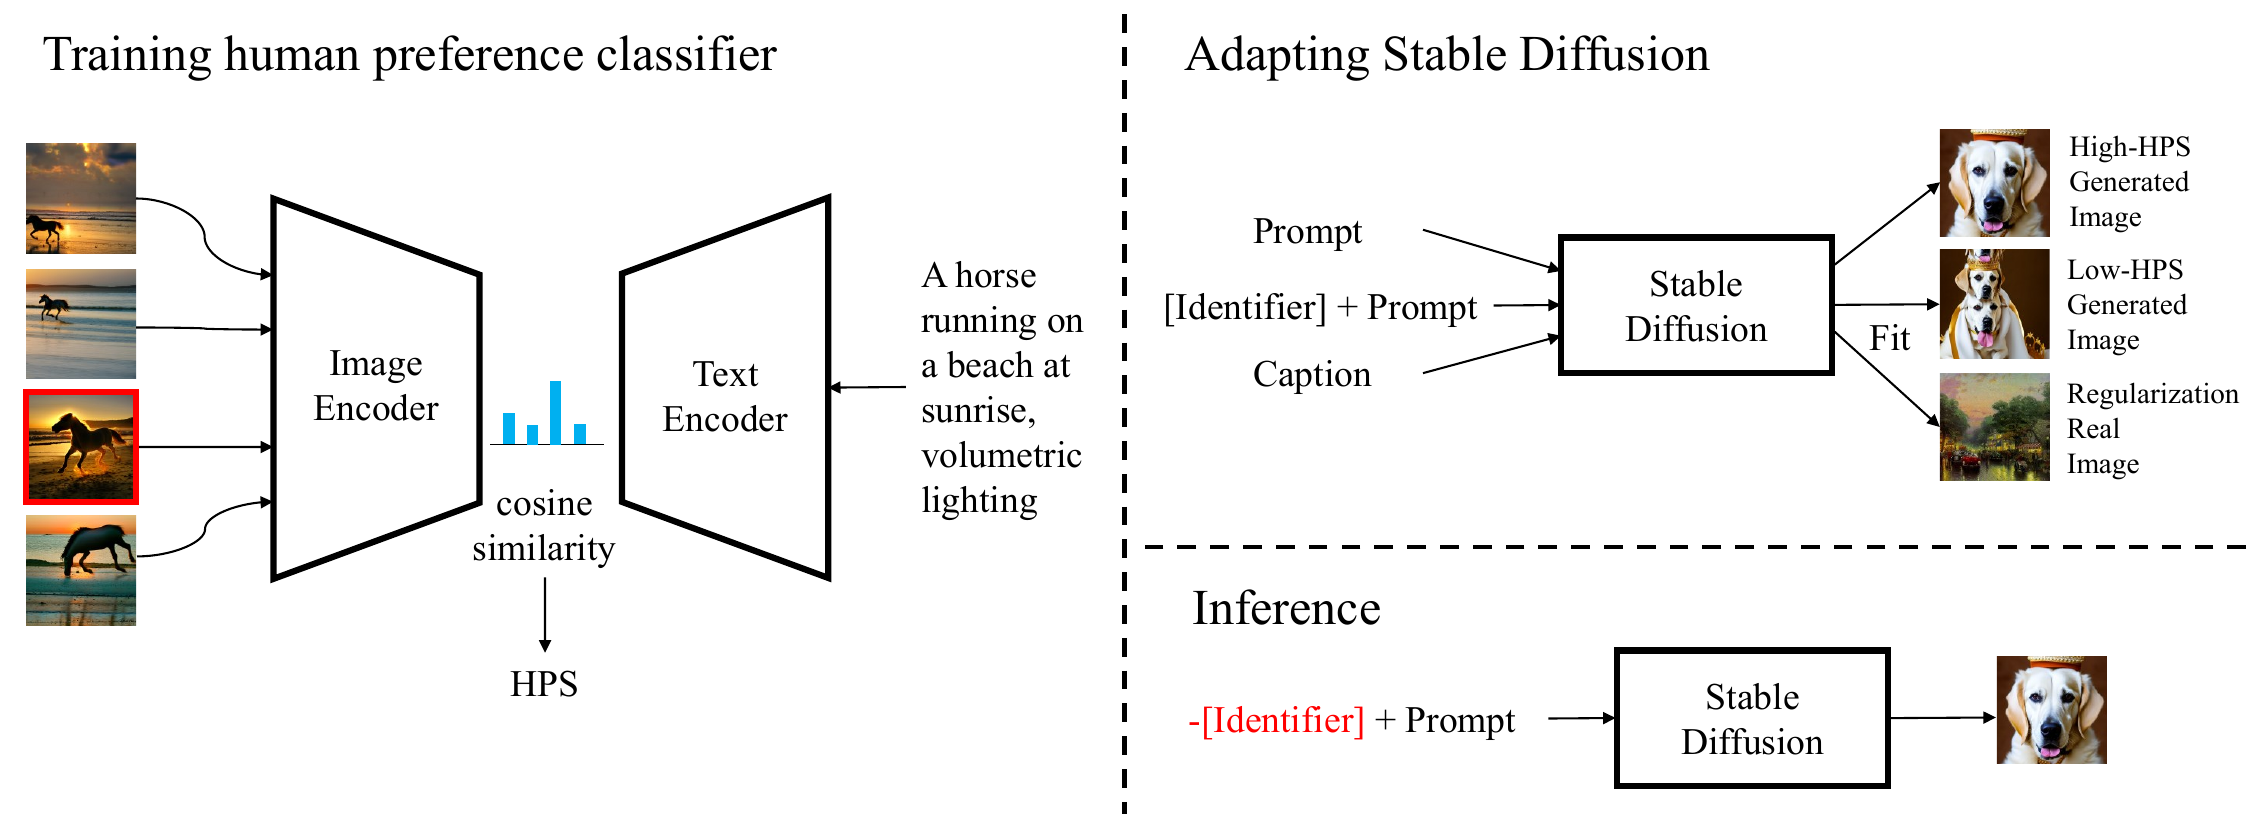
Human preference score:better aligning text-to-image models with human ...
HPSv3: Towards Wide-Spectrum Human Preference Score - Paper Details
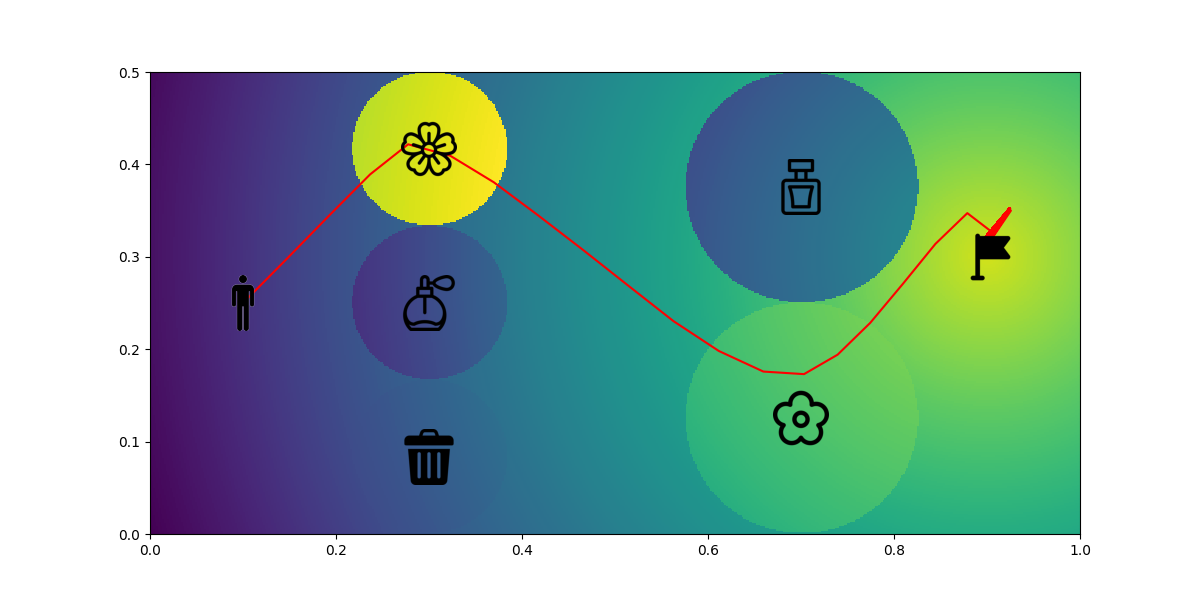
Human Preference Modeling Using Visual Motion Prediction Improves Robot ...
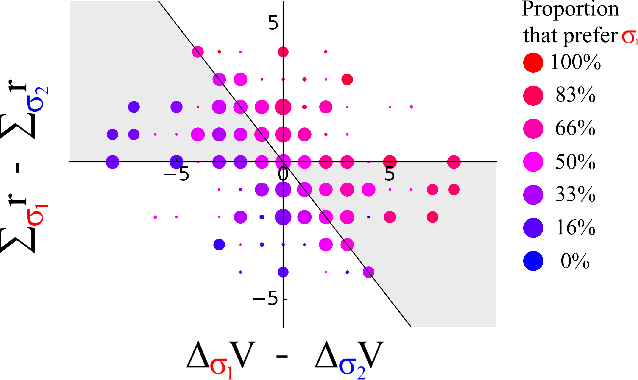
Figure 8 from Models of human preference for learning reward functions ...
Figure 1 from MSEED: Human Preference Dataset for Multidimensional ...
AI model rankings on human preference from Not Diamond’s arena mode ...
(PDF) F-Bench: Rethinking Human Preference Evaluation Metrics for ...
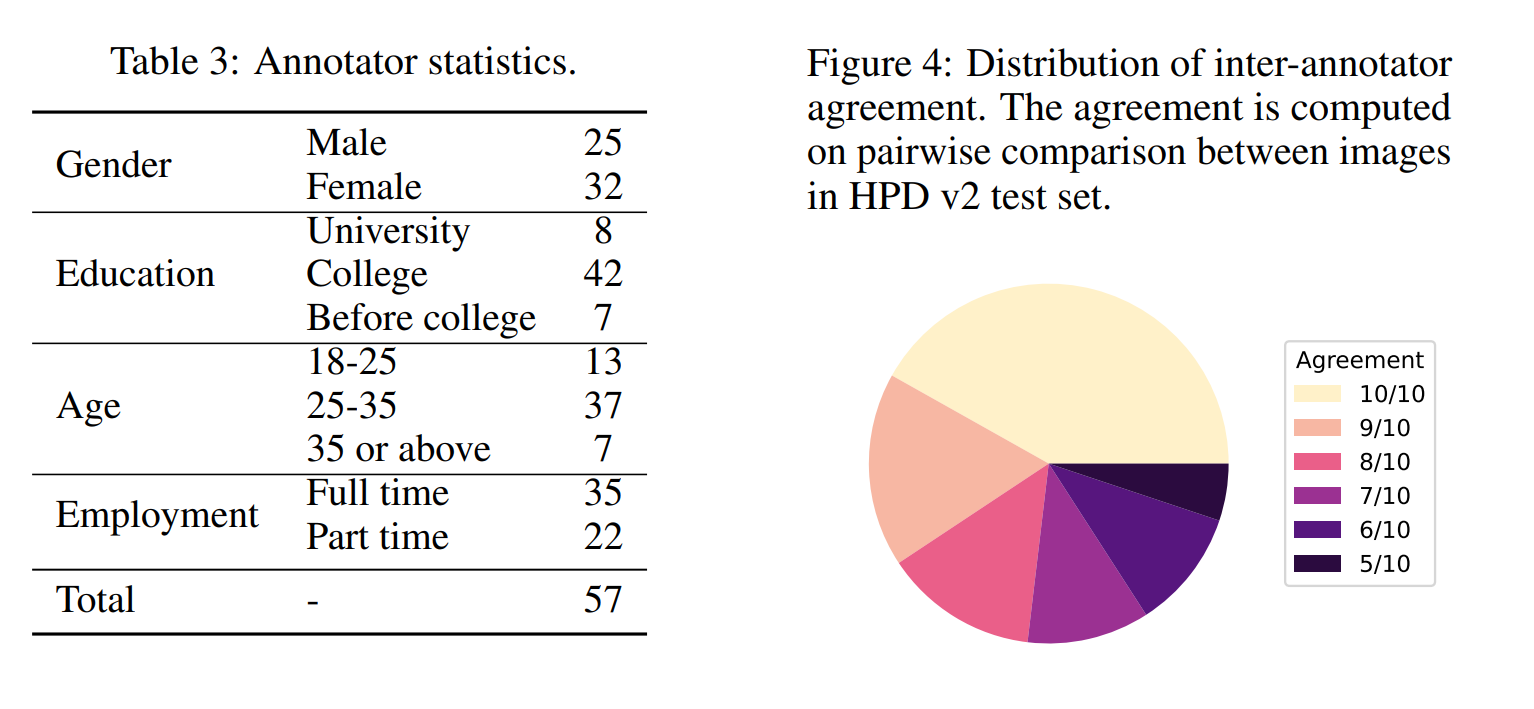
[2306.09341] Human Preference Score v2: A Solid Benchmark for ...
A Survey on Human Preference Learning for Aligning Large Language ...
Overall human preference counts for each pairwise choice | Download ...
GitHub - tgxs002/HPSv2: Human Preference Score v2: A Solid Benchmark ...
[논문 리뷰] F-Bench: Rethinking Human Preference Evaluation Metrics for ...
Better Aligning Text-to-Image Models with Human Preference
論文まとめ:Human Preference Score v2: A Solid Benchmark for Evaluating Human ...
Human preference scores for samples generated using NUQ versus ...
Human preference for different methods w.r.t. different questions ...
Main results of ImageReward and comparison methods on human preference ...
Unpacking Human Preference for LLMs: Demographically Aware Evaluation ...
[2602.23438] DesignSense: A Human Preference Dataset and Reward ...
DesignSense: A Human Preference Dataset and Reward Modeling Framework ...
Planning & Prediction with Human Preference via Deep Inverse ...
A Survey on Human Preference Learning for Large Language Models | AI ...
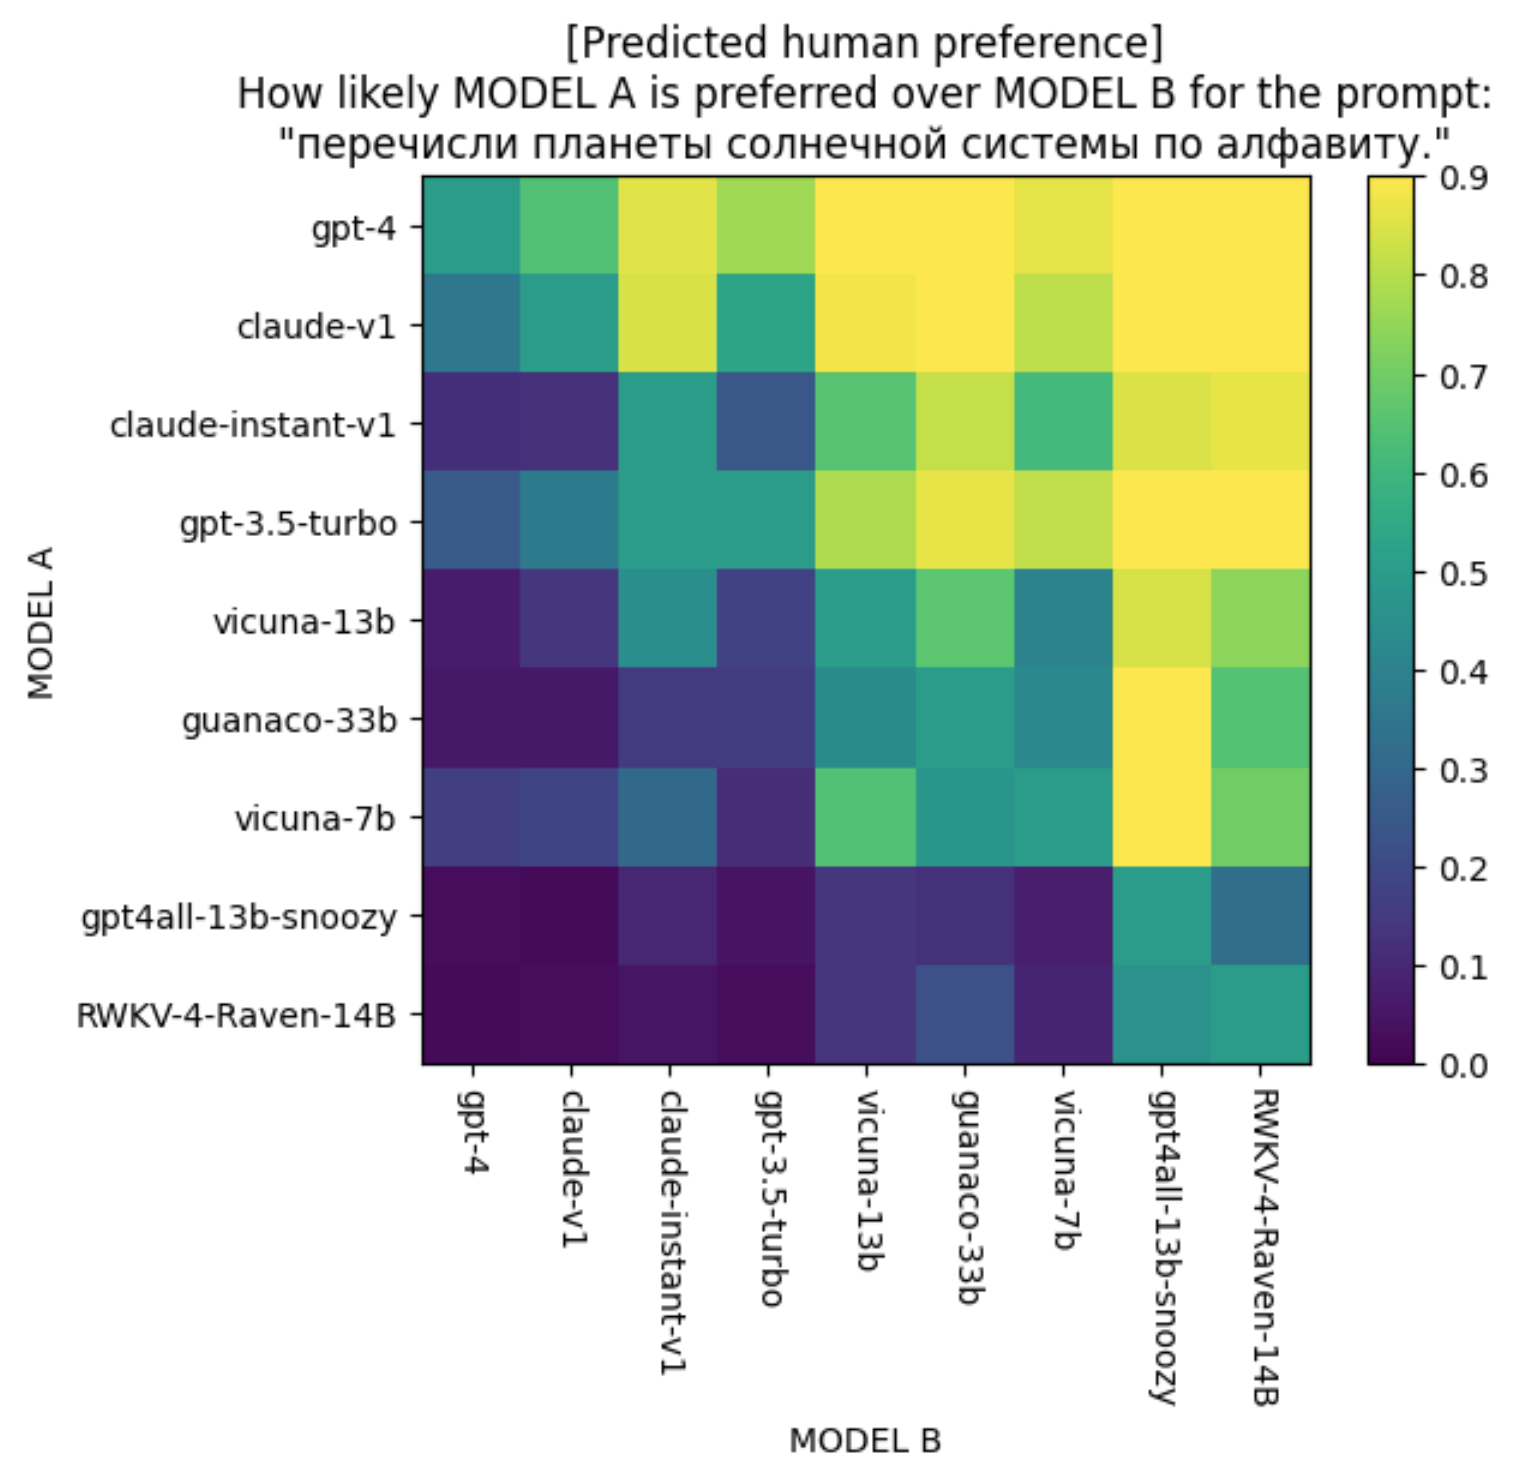
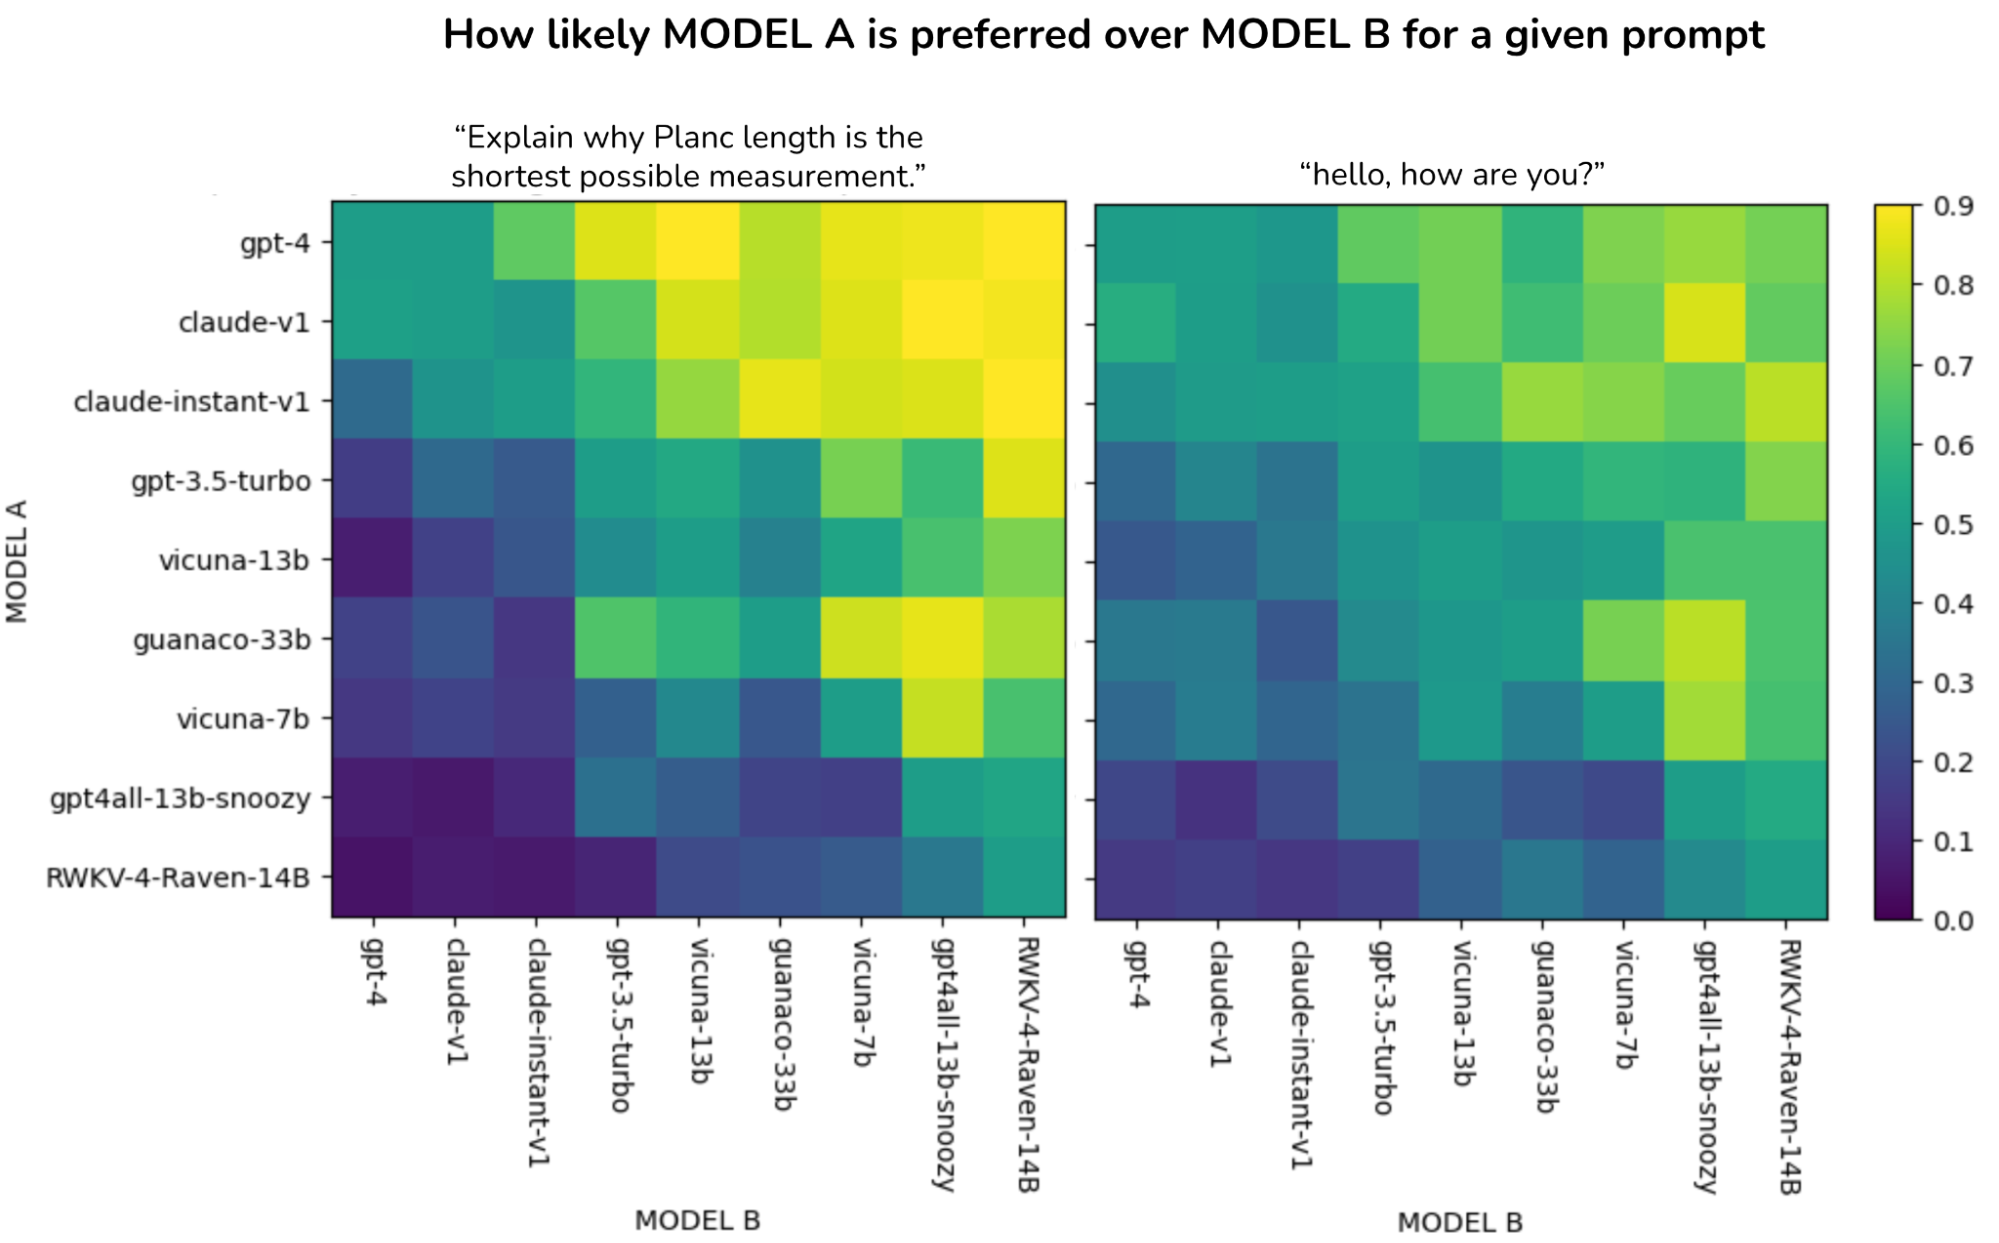
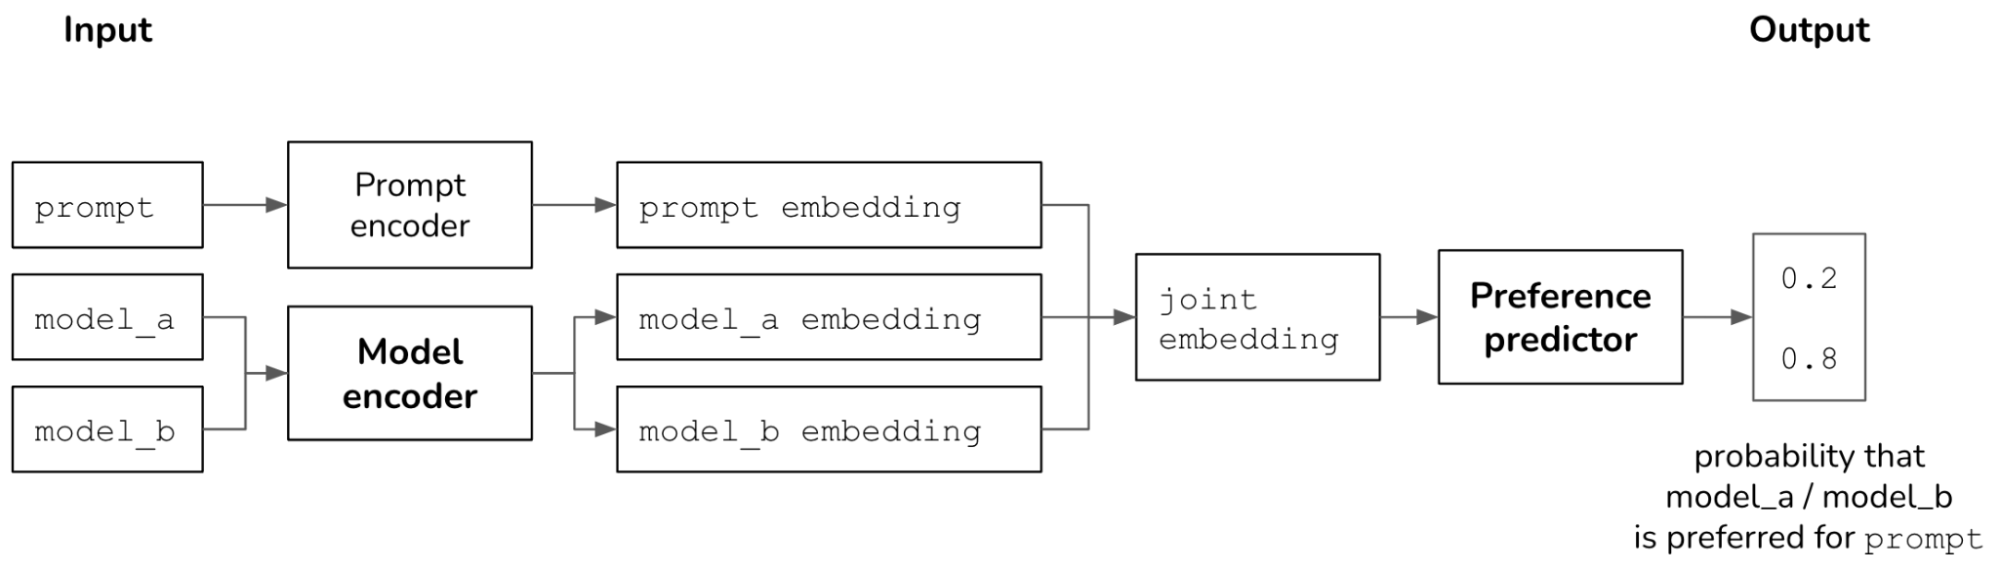
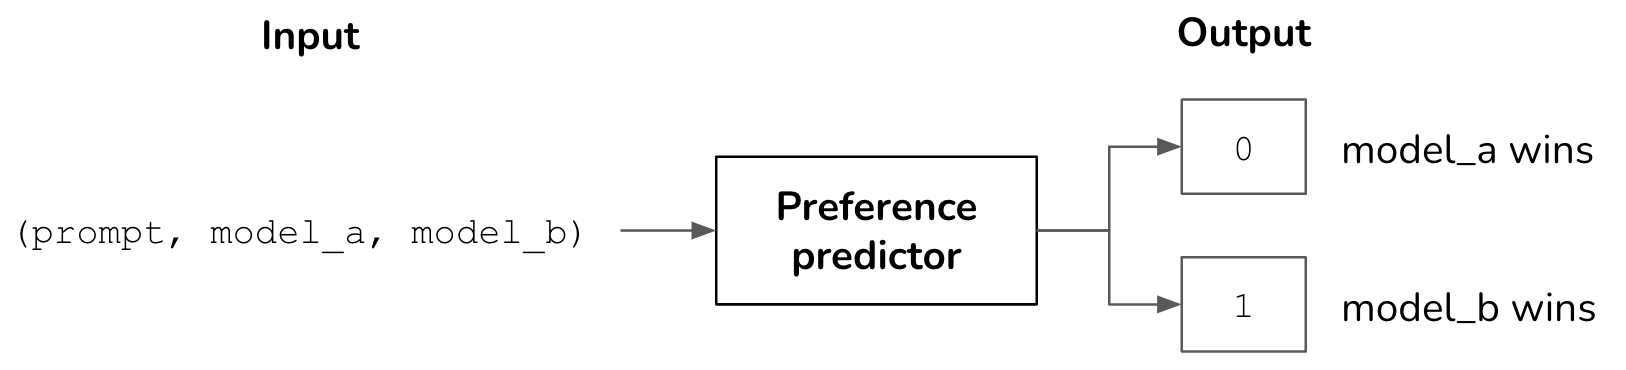
Predictive Human Preference: From Model Ranking to Model Routing
Active Preference Optimization for Sample Efficient RLHF | AI Research ...
What’s In My Human Feedback? Learning Interpretable Descriptions of ...
Reinforcement Learning From Human Feedback RLHF For Gen AI
[2304.04602] Learning a Universal Human Prior for Dexterous ...
ChatGPT Series: Learning from Human Preferences - Sijun He's ...
Preference for human, not algorithm aversion: Trends in Cognitive Sciences
Dual-IPO: Dual-Iterative Preference Optimization for Text-to-Video ...
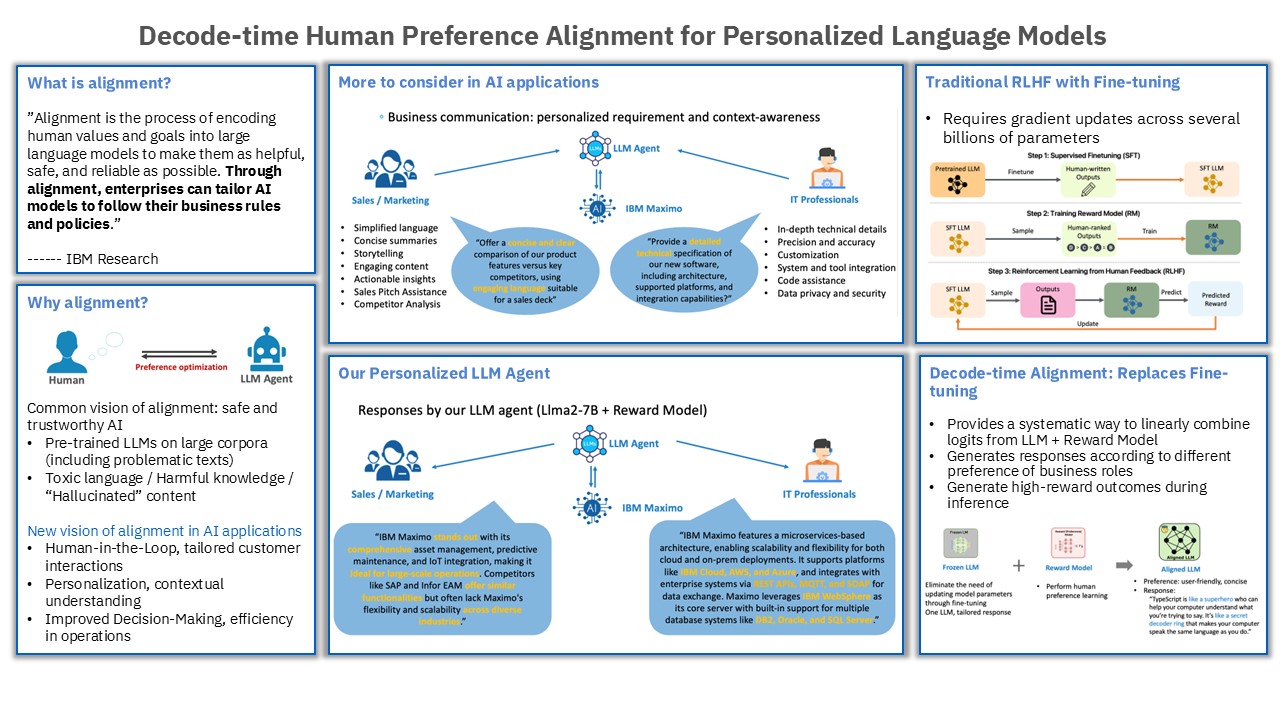
Towards Personalized Language Models via Inference-time Human ...
Innate and learned components of human visual preference: Current Biology
Paper page - HelpSteer3-Preference: Open Human-Annotated Preference ...
Approximating Human Preferences Using a Multi-Judge Learned System | AI ...
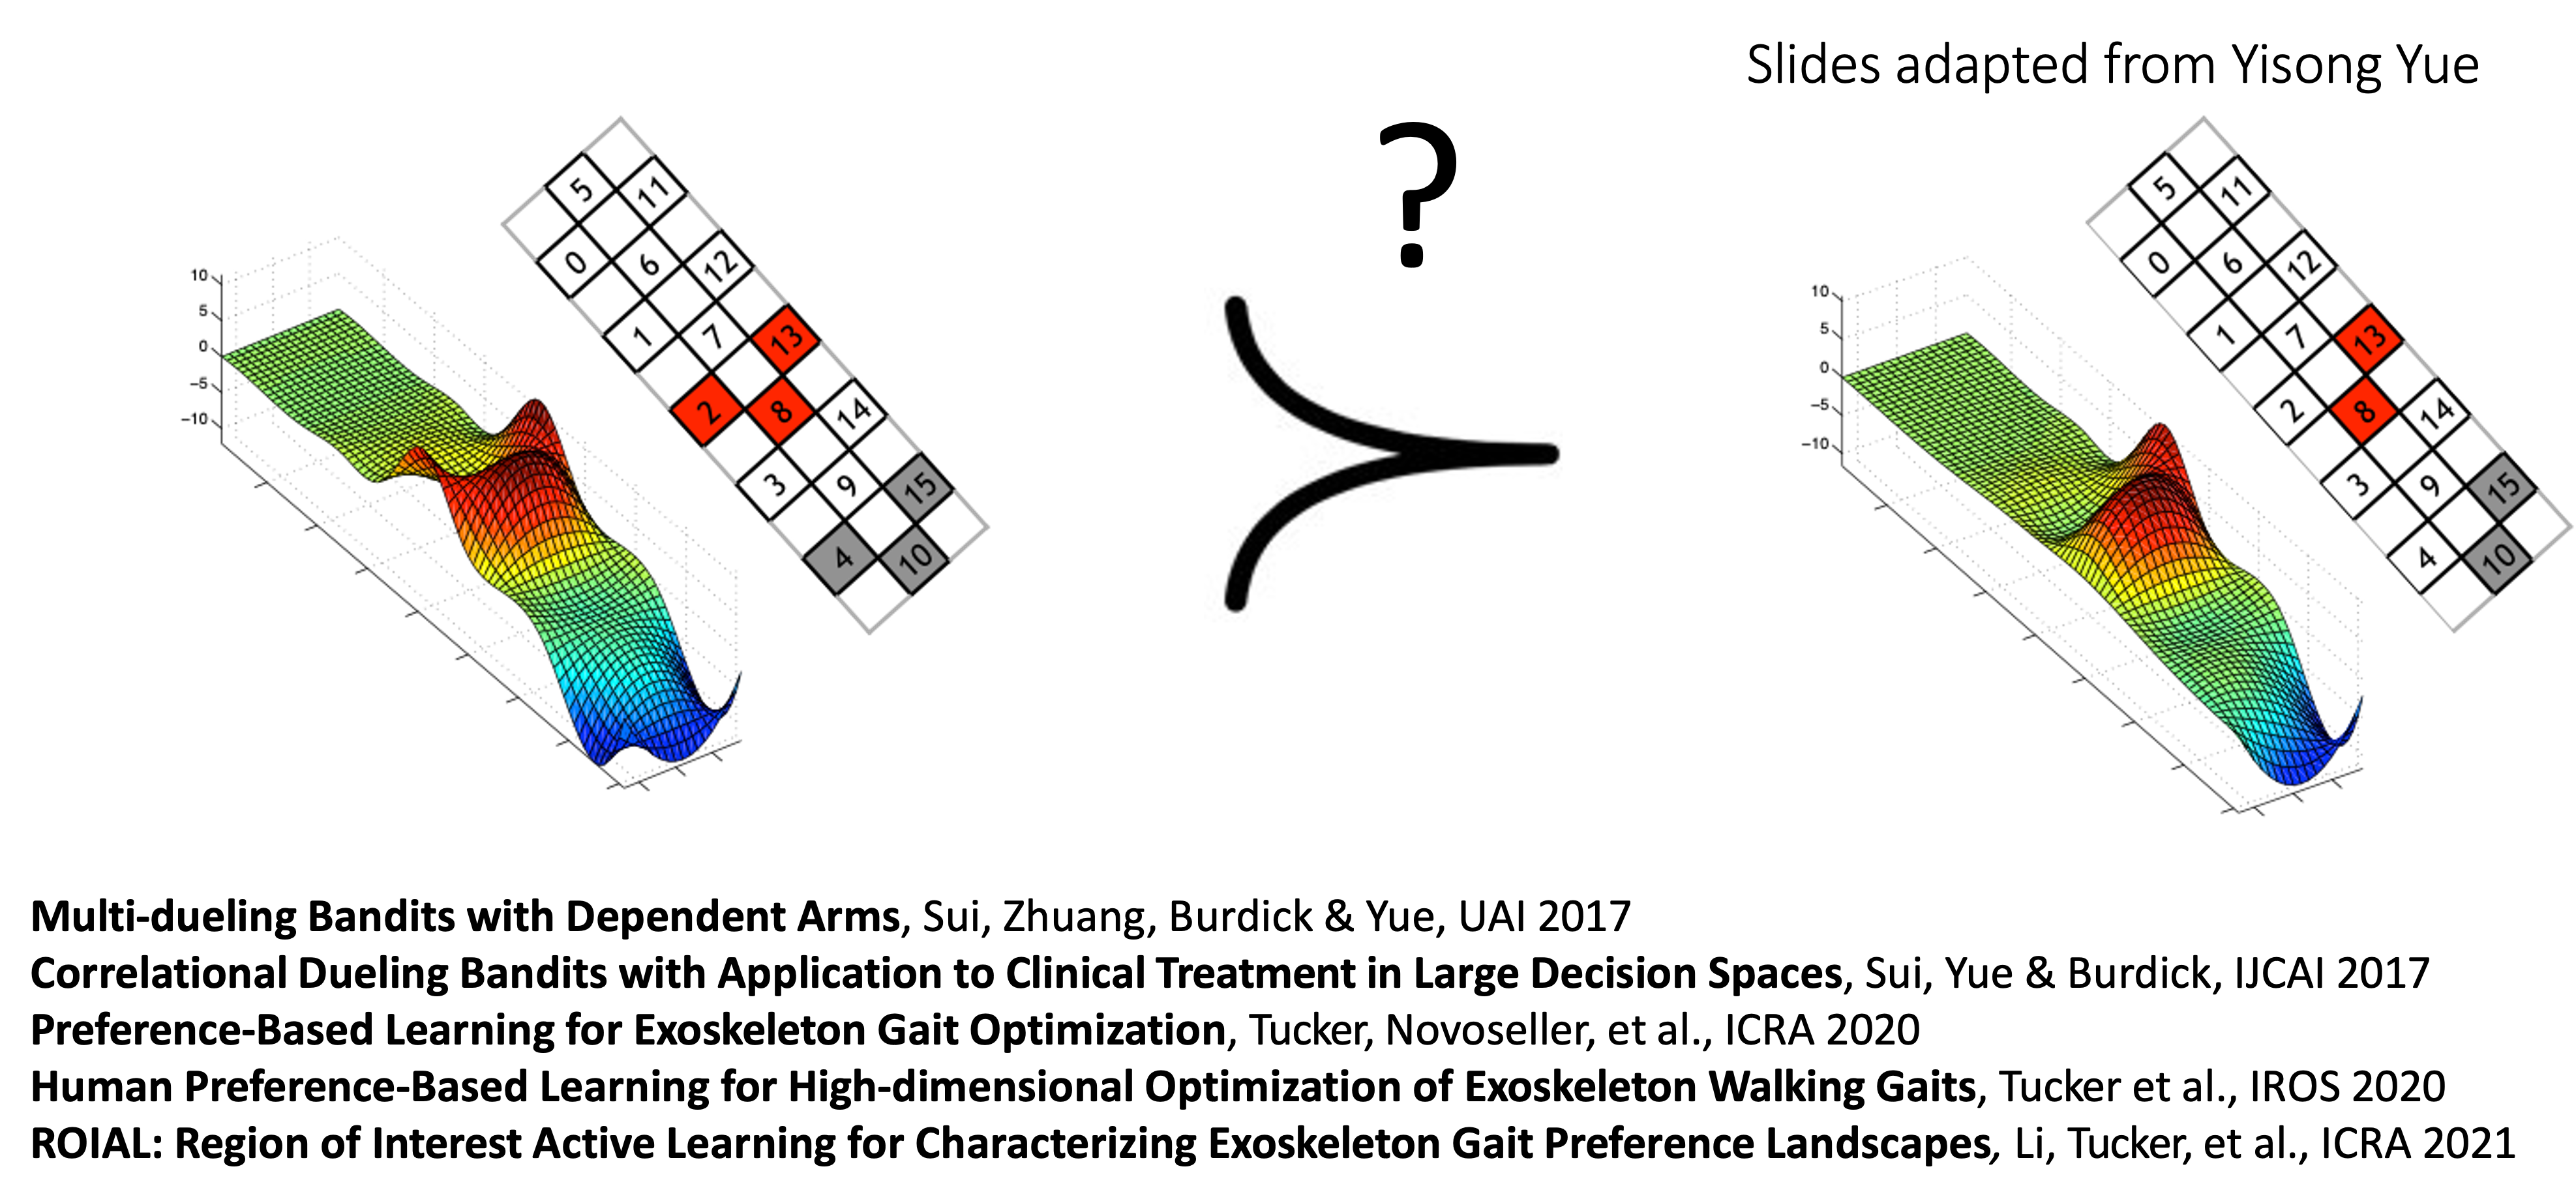
CS329H Slides – Machine Learning from Human Preferences
[2305.14702] DecipherPref: Analyzing Influential Factors in Human ...
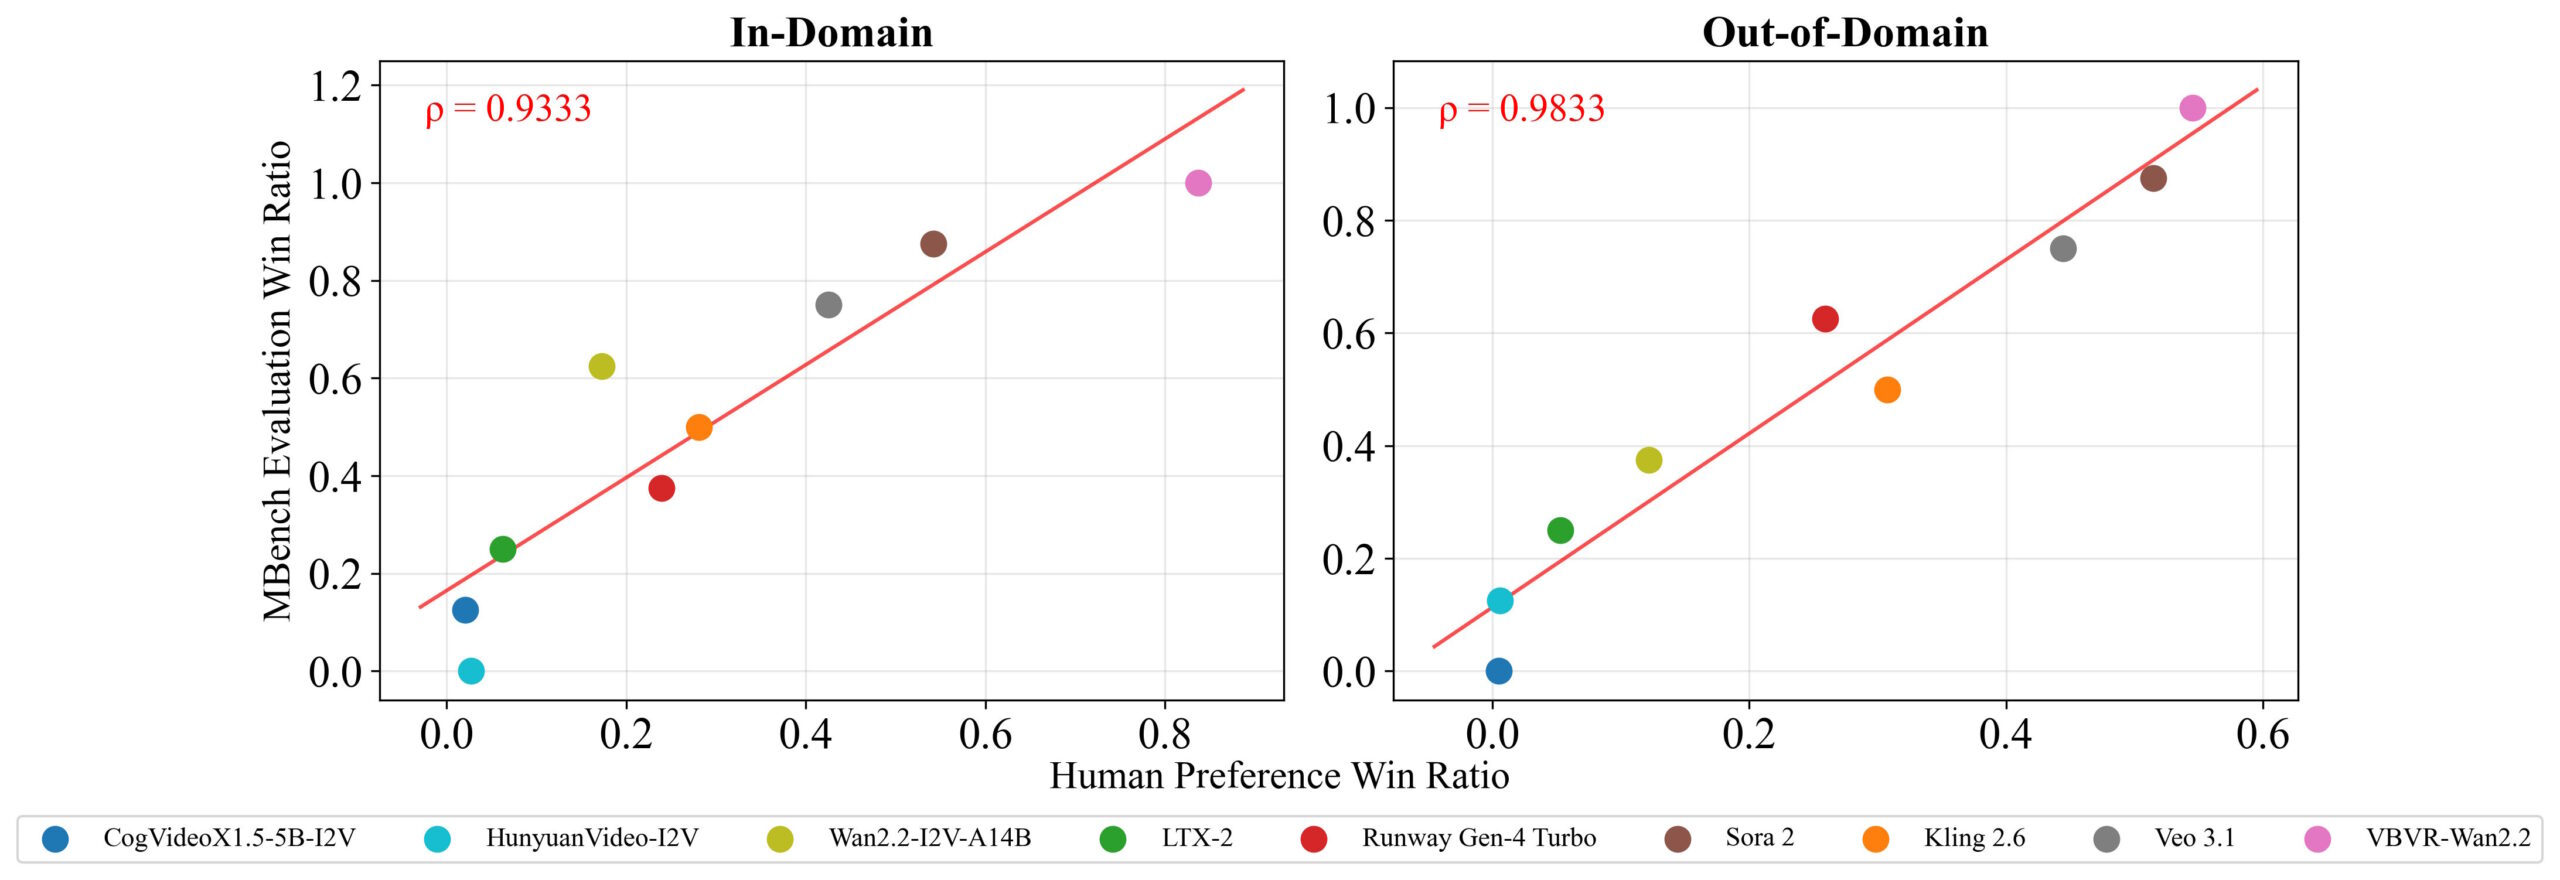
Video AI models hit a reasoning ceiling that more training data alone ...
The Evolutionary Origins of Human Patience: Temporal Preferences in ...
A data-driven, multivariate approach to human mate preferences. | H2020 ...
Human favoritism, not AI aversion: People’s perceptions (and bias ...
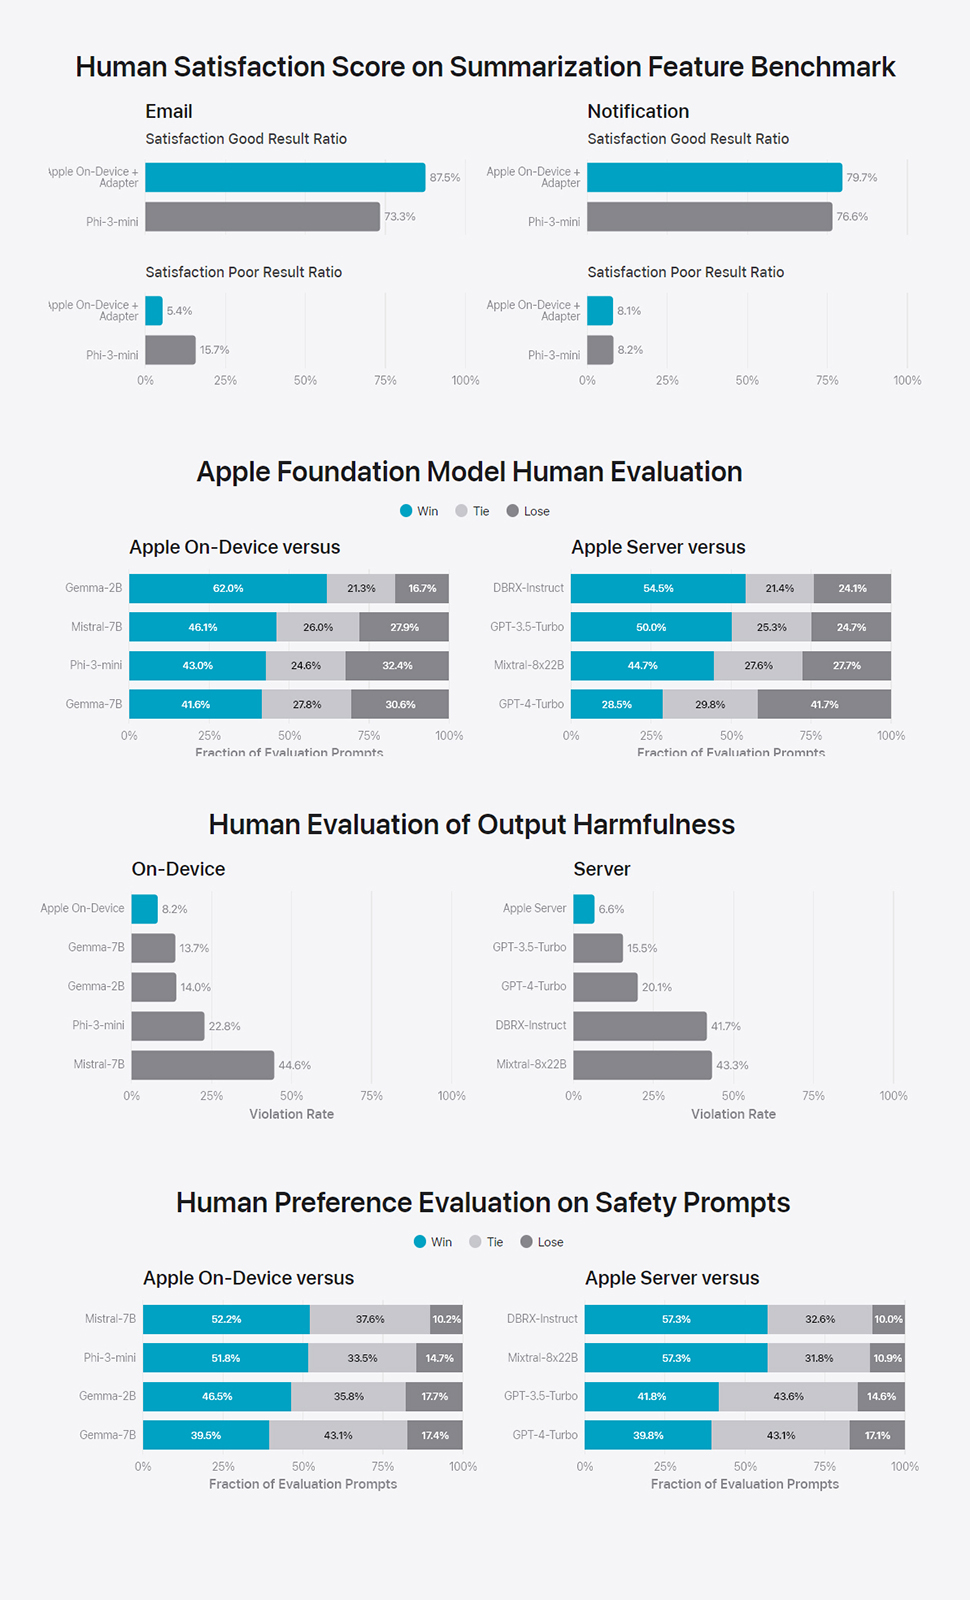
'Our models are preferred by human graders': How…
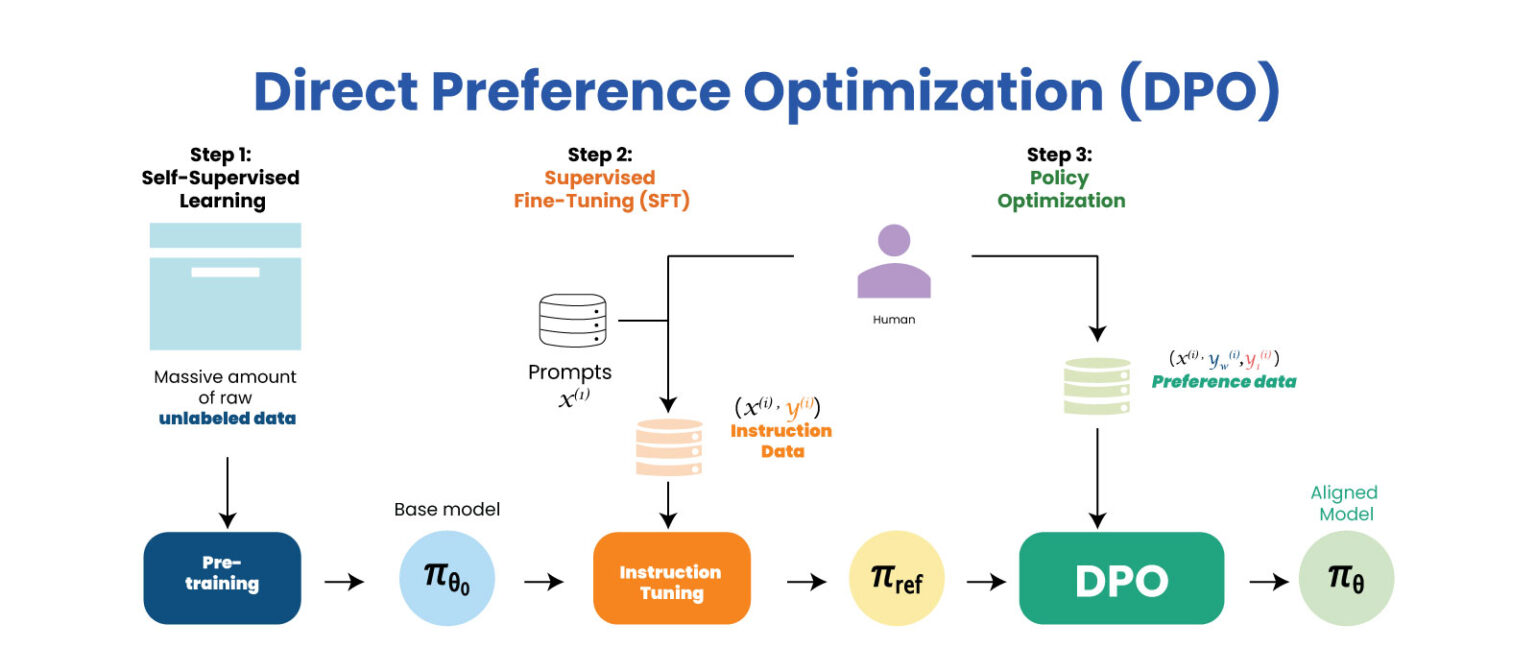
Fine-tune Llama 3 using Direct Preference Optimization
Frontiers: Can Large Language Models Capture Human Preferences ...
Learning Query-Specific Rubrics from Human Preferences for DeepResearch ...
Pretraining Language Models with Human Preferences — AI Alignment Forum
Frontiers | The detection and effect of social events on Wikipedia data ...
Taming Preference Mode Collapse via Directional Decoupling Alignment in ...
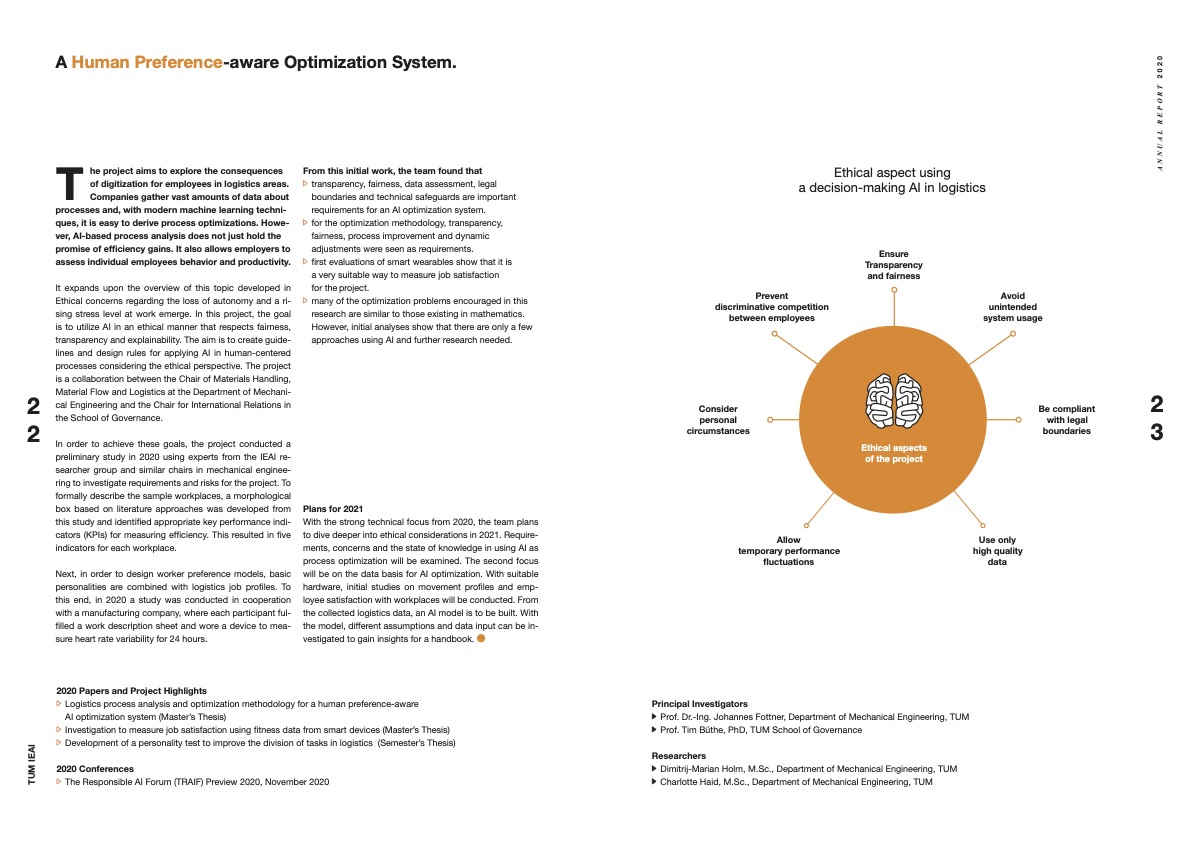
A Human Preference-Aware Optimization System - Institute for Ethics in ...
Percentage Human vs AI Output Source: Inspira AI Corp. analysis ...
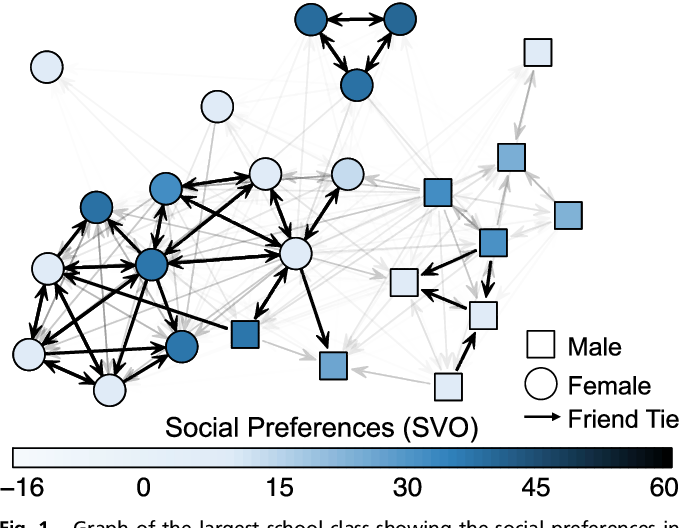
Figure 1 from Human social preferences cluster and spread in the field ...
When Human Preferences Flip: An Instance-Dependent Robust Loss for RLHF ...
AI Alignment with Human Preferences
Generative Interfaces for Language Models
Label Studio — Gallery of Generative AI Labeling Templates
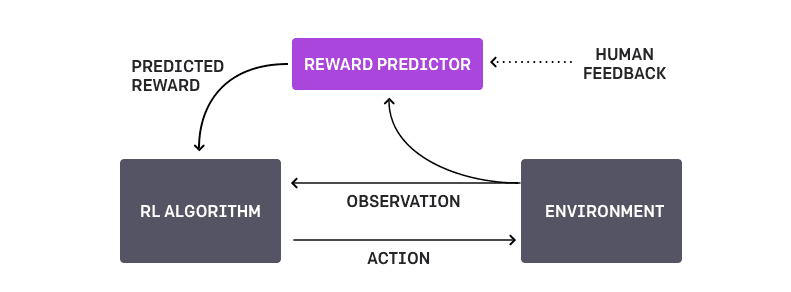
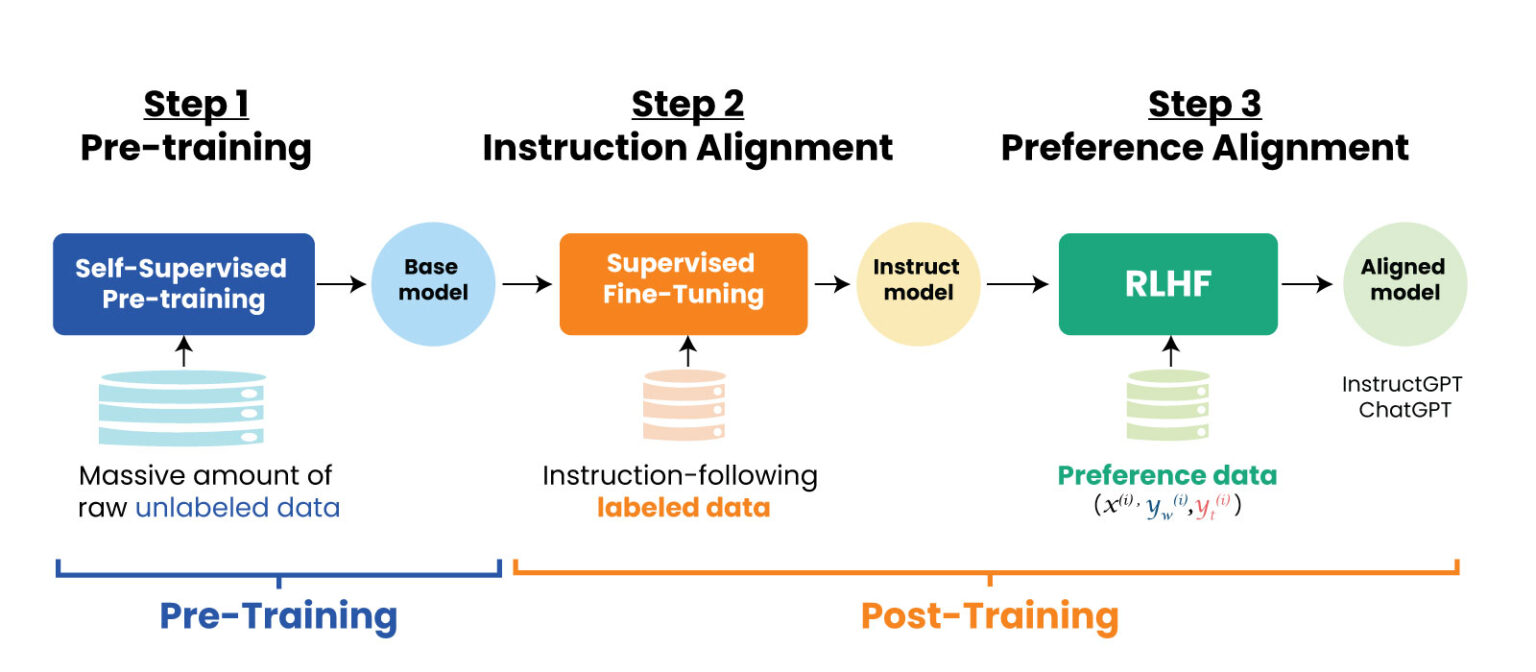
The Story of RLHF: Origins, Motivations, Techniques, and Modern ...
Towards Understanding Sycophancy in Language Models | AI Research Paper ...
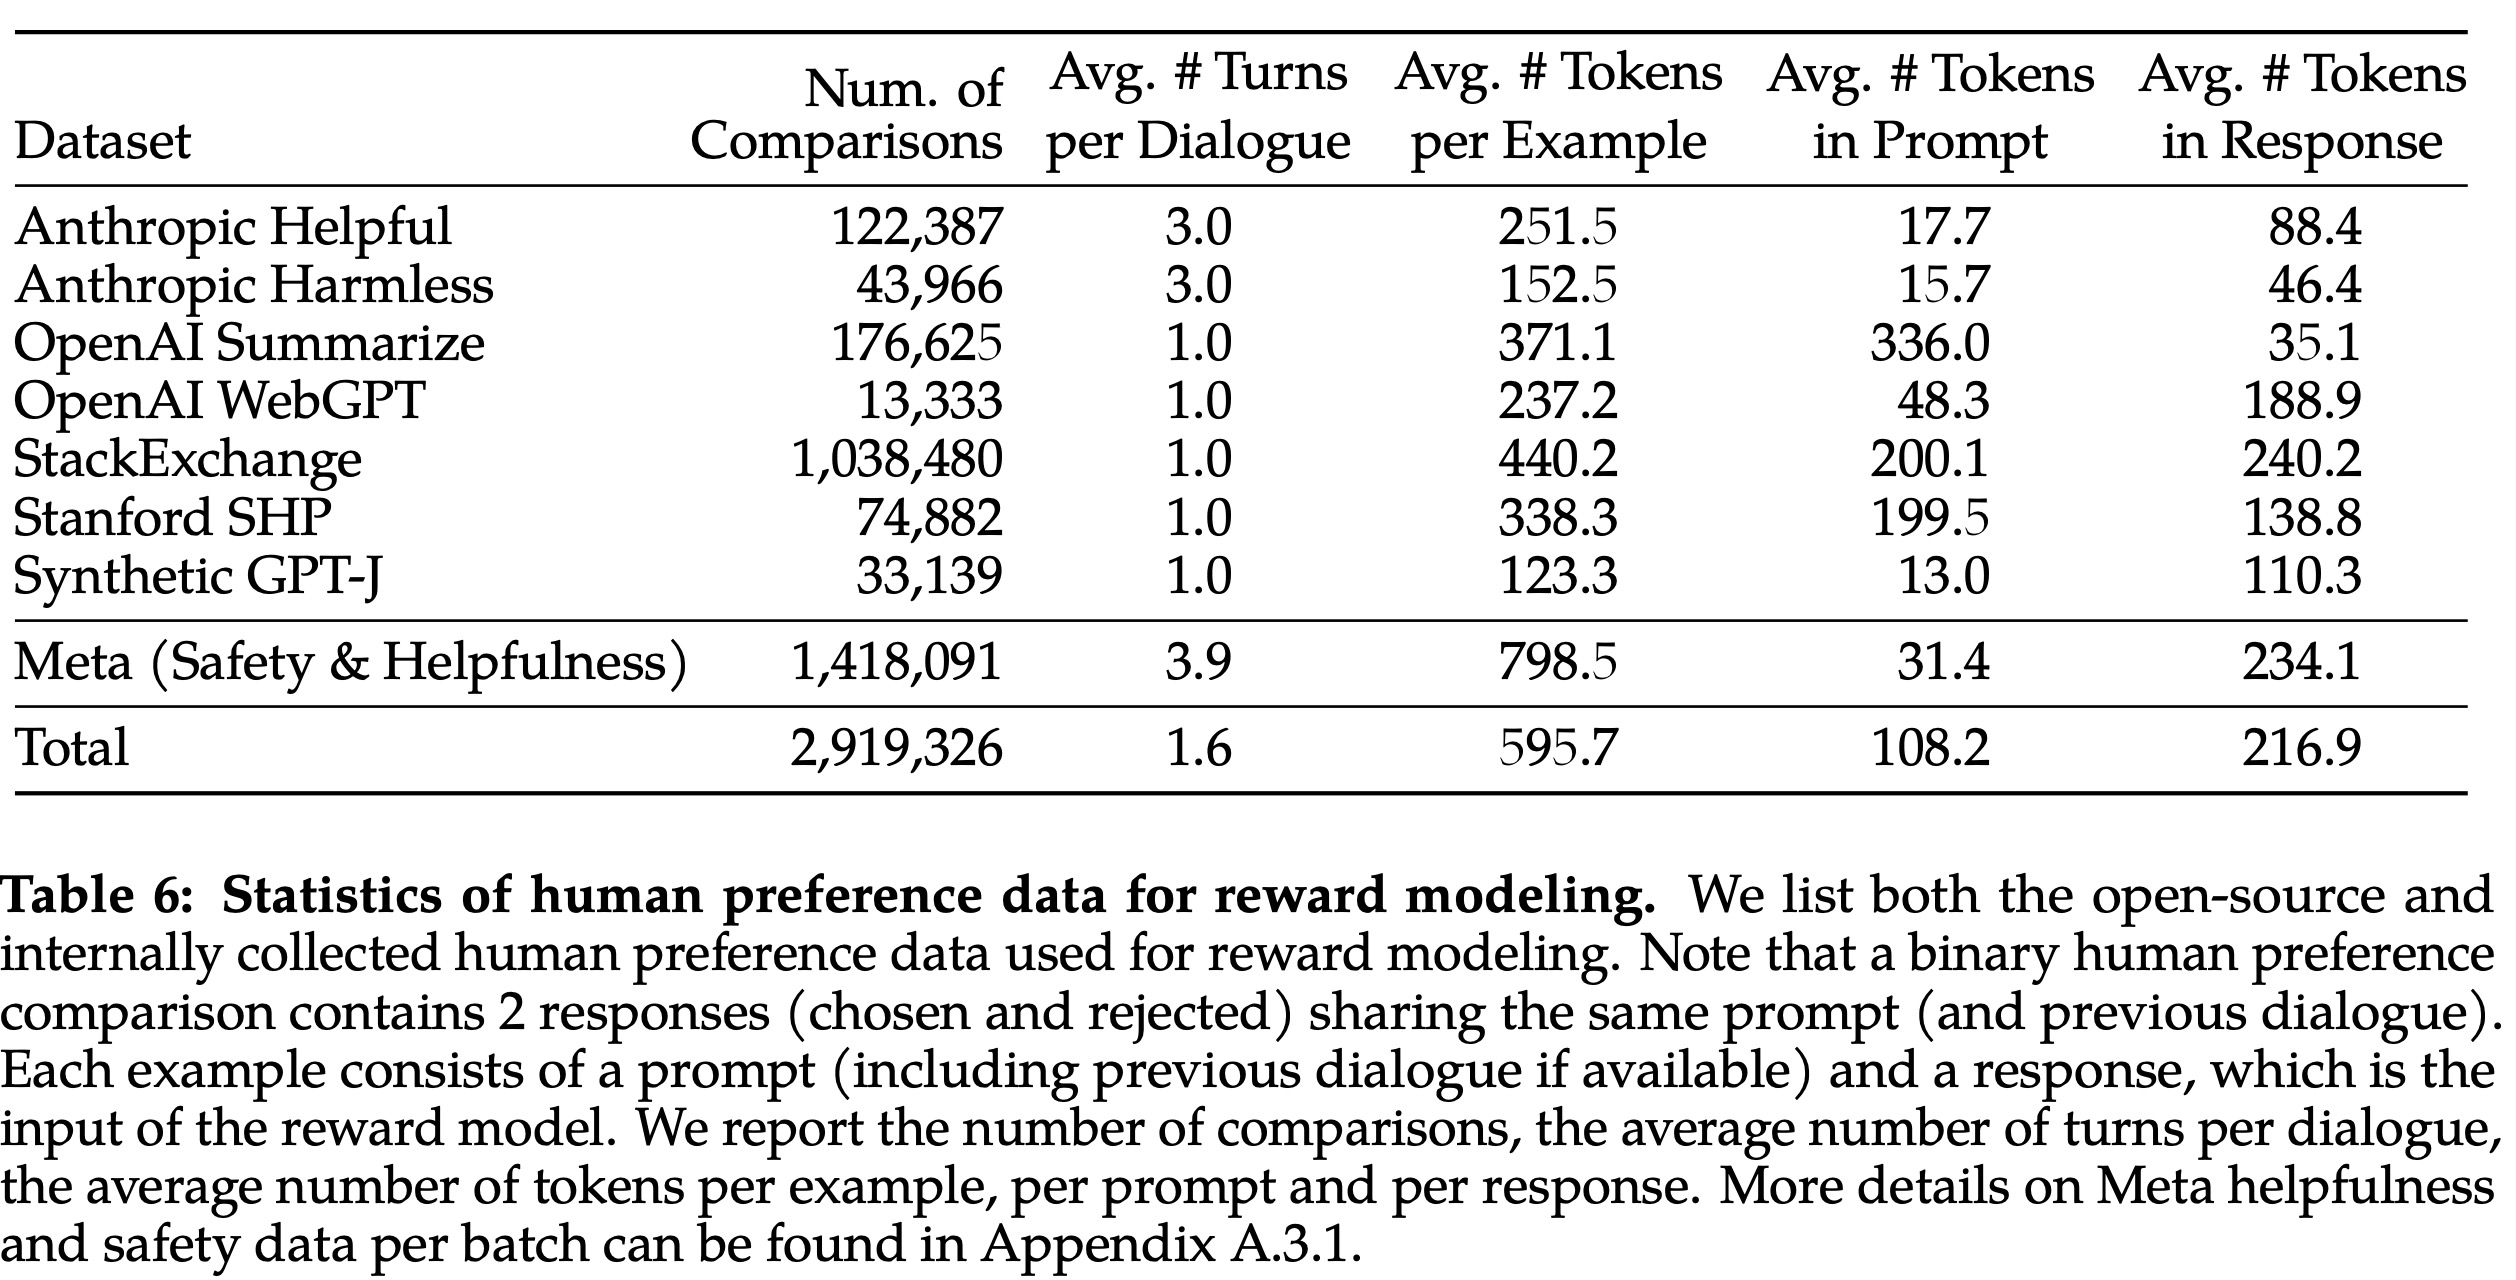
Llama 2: Open Foundation and Fine-tuned Chat Models | PPTX
Paper Review: Llama 2: Open Foundation and Fine-Tuned Chat Models ...
Interpreting Language Model Preferences Through the Lens of Decision ...
Do Explanations Generalize across Large Reasoning Models?
Prefer-DAS: Learning from Local Preferences and Sparse Prompts for ...
xswu/human_preference_dataset · Datasets at Hugging Face
awesome-llm-human-preference-datasets by glgh - SourcePulse
README.md · playgroundai/playground-v2.5-1024px-aesthetic at main
Evaluating and Optimizing Educational Content with Large Language Model ...
Socratis: Are Large Multimodal Models Emotionally Aware?
Kestrel: Grounding Self-Refinement for LVLM Hallucination Mitigation
glgh awesome-llm-human-preference-datasets · Discussions · GitHub
[2412.04431] Infinity∞: Scaling Bitwise AutoRegressive Modeling for ...
1: datapoints represent humans. We are interested in the fruit ...
Post-Training有多重要?一文带你了解全部细节-CSDN博客
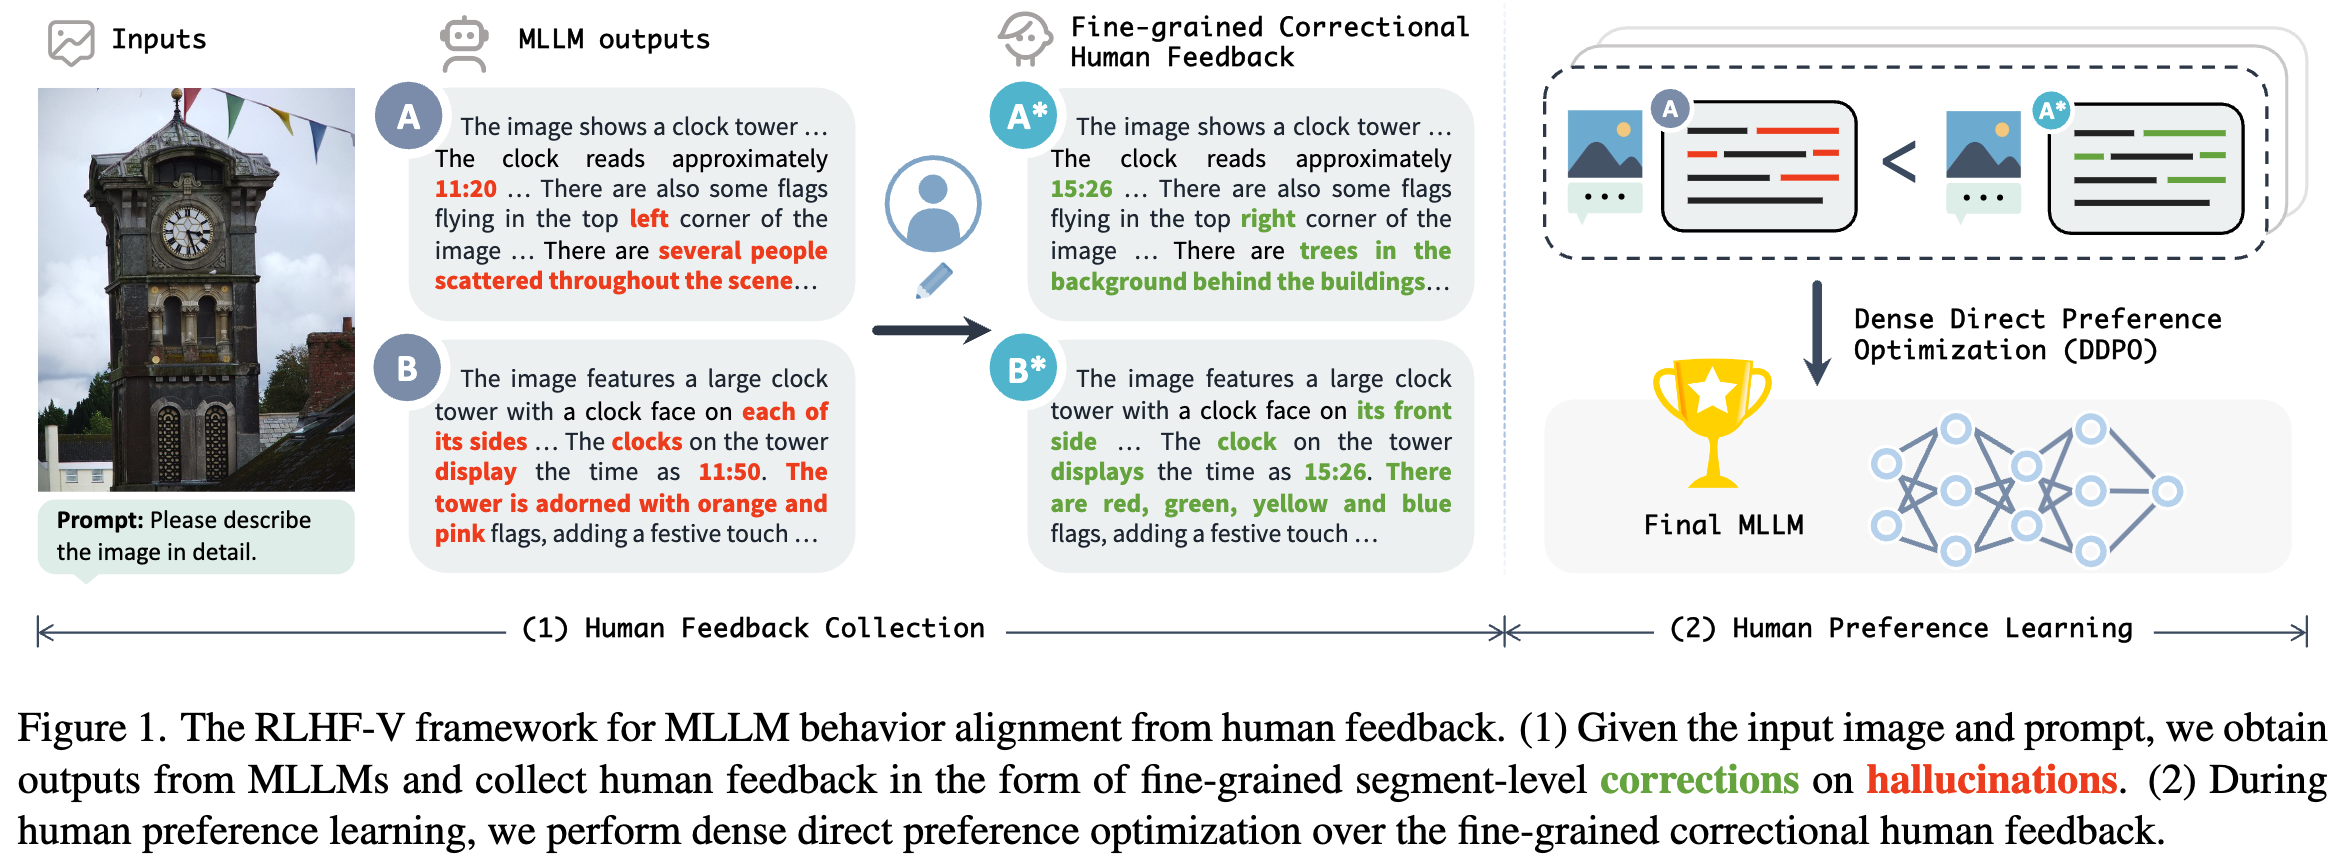
RLHF-V: Towards Trustworthy MLLMs via Behavior Alignment from Fine ...
Publications | Woody Gan's Personal Website
Towards Interactive Intelligence for Digital Humans
Beyond Overlap Metrics: Rewarding Reasoning and Preferences for ...
Molmo | Ai2
Customer Service Statistics 2026: Humans vs AI Trends