Showing 120 of 120on this page. Filters & sort apply to loaded results; URL updates for sharing.120 of 120 on this page
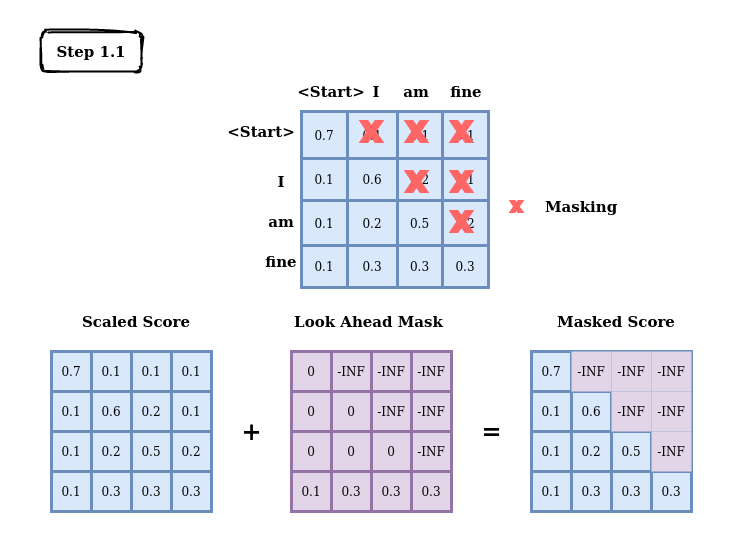
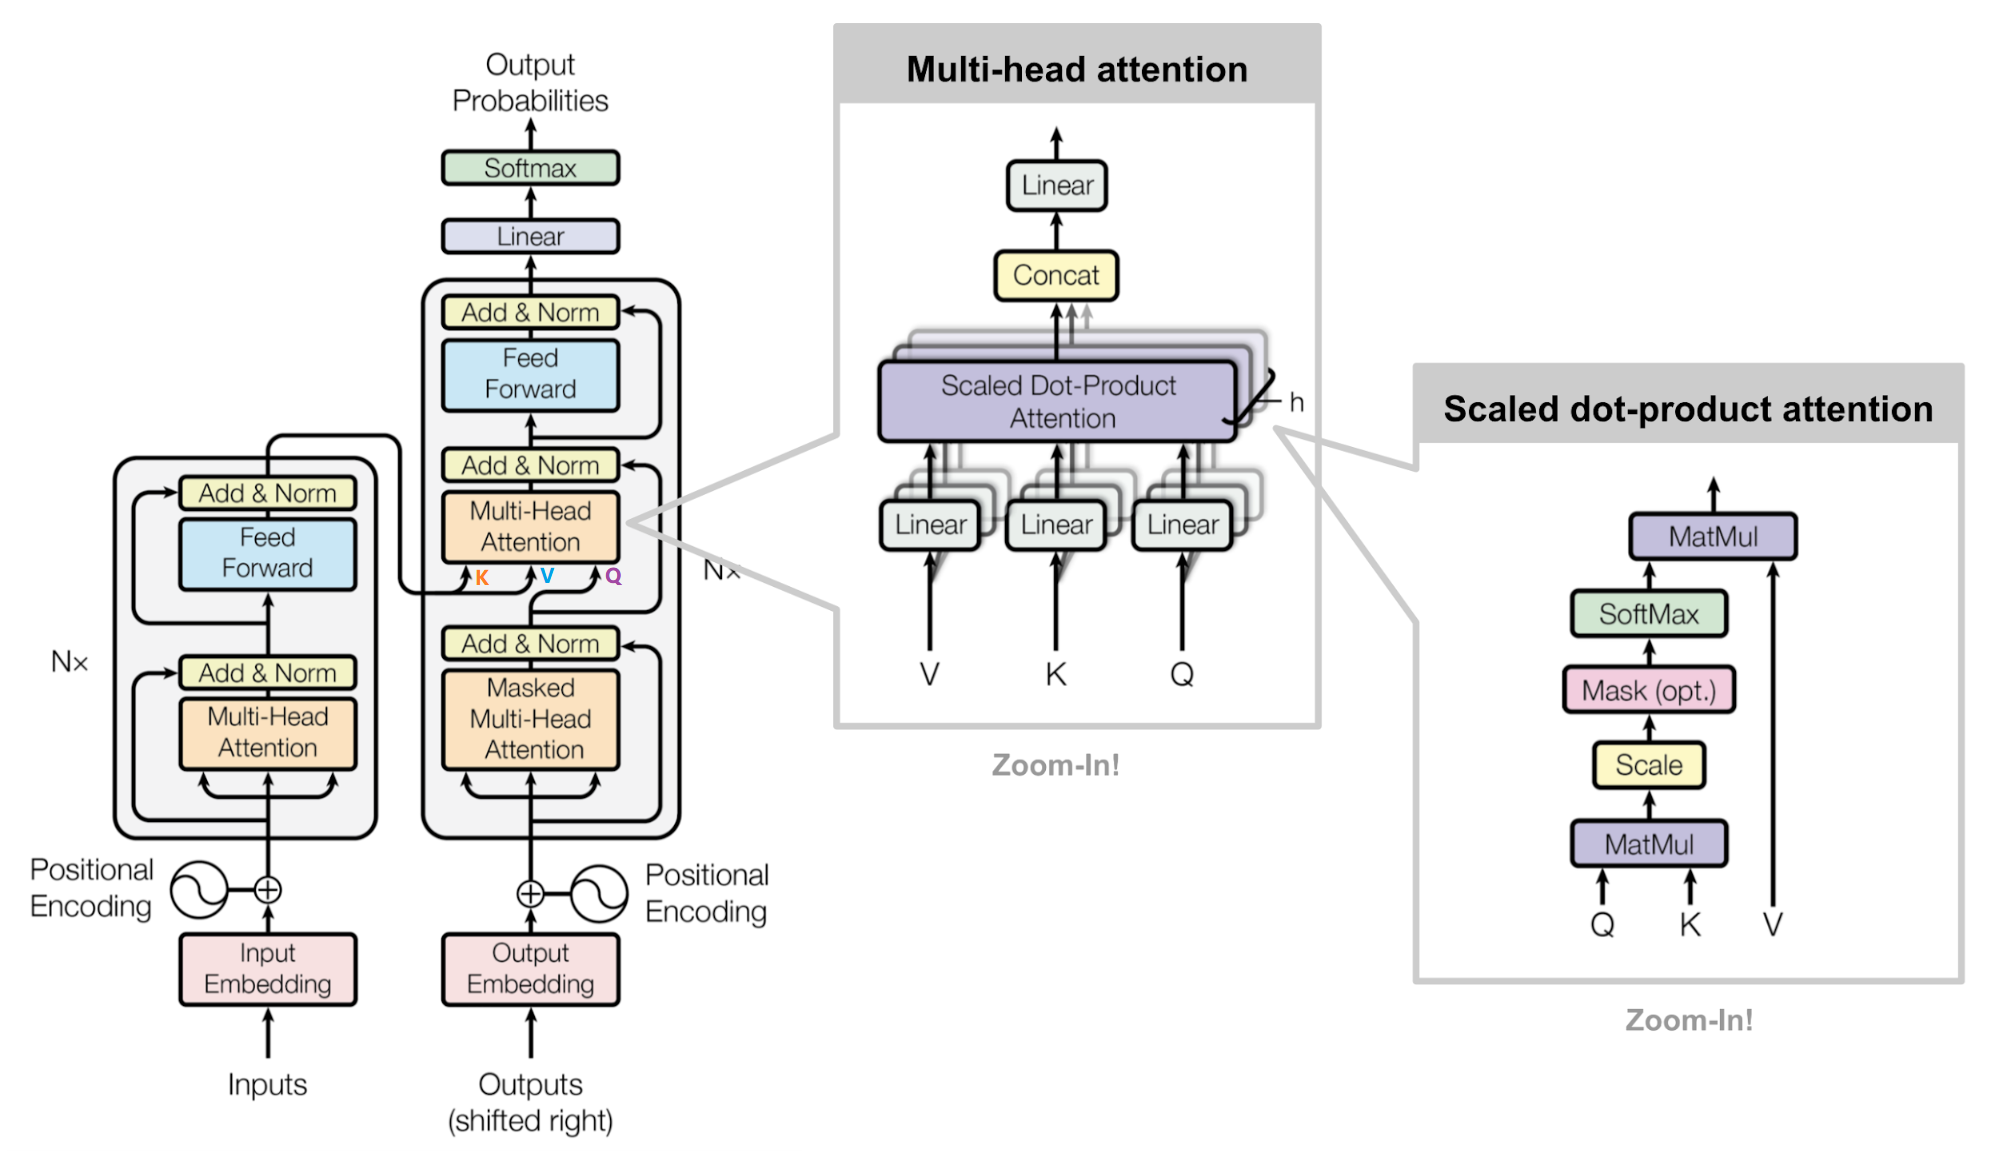
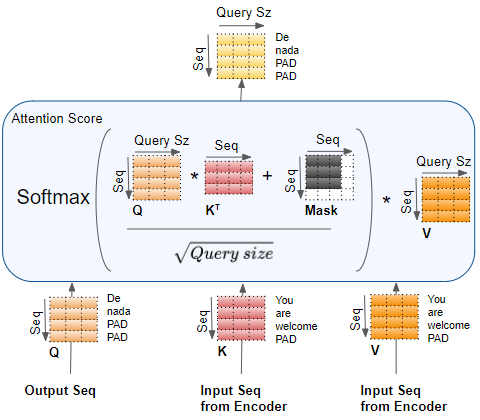
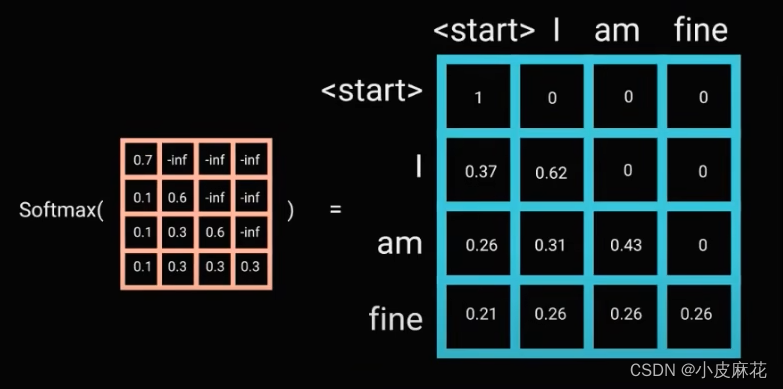
Masking in Transformer Encoder/Decoder Models - Sanjaya’s Blog
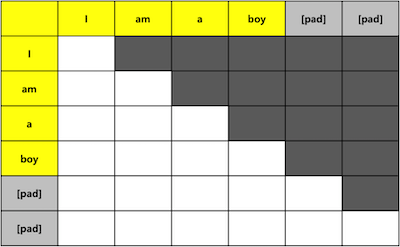
Transformer: Using Decoder input masking when only having a Transformer ...
Figure 1 from Effective Decoder Masking for Transformer Based End-to ...
natural language processing - Masking in Decoder of Transformer ...
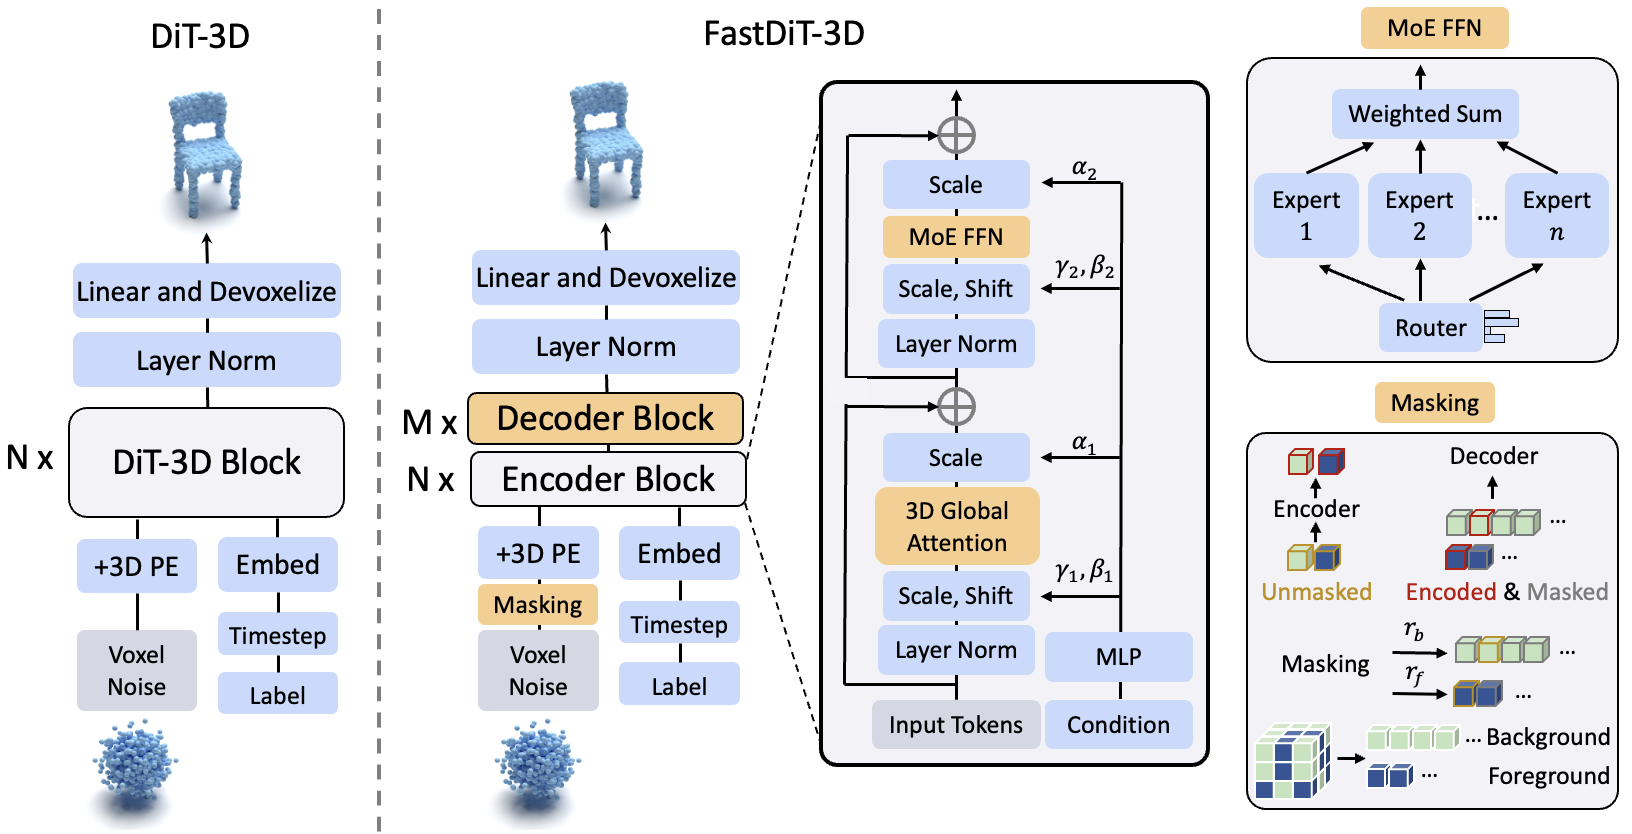
Fast Training of Diffusion Transformer with Extreme Masking for 3D ...
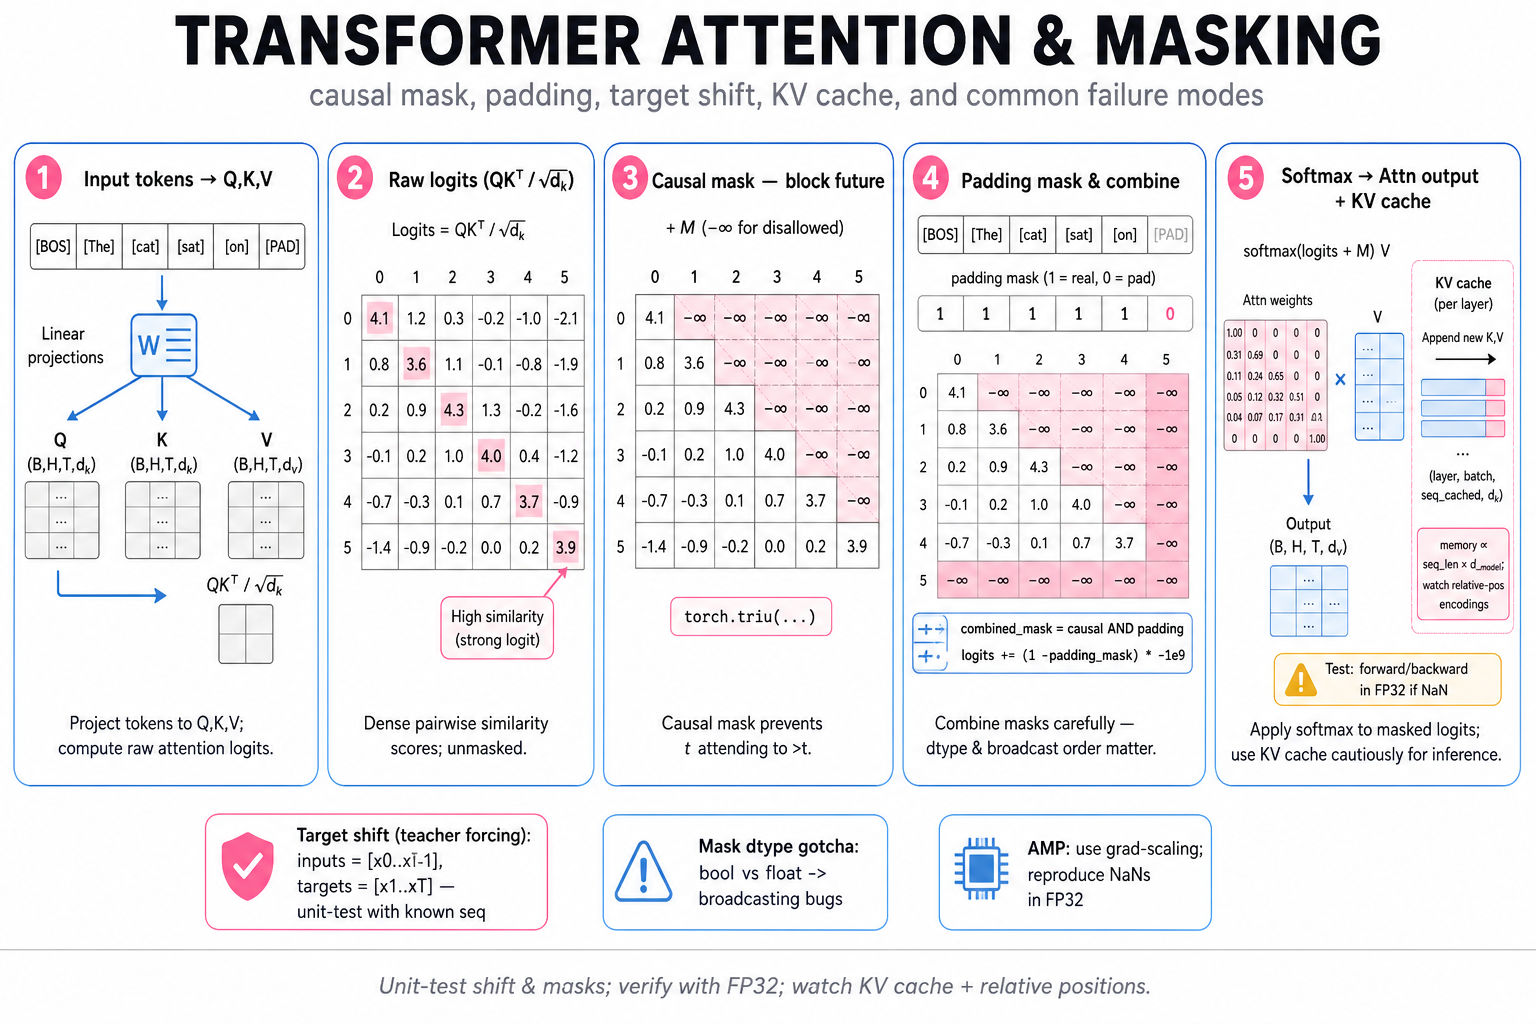
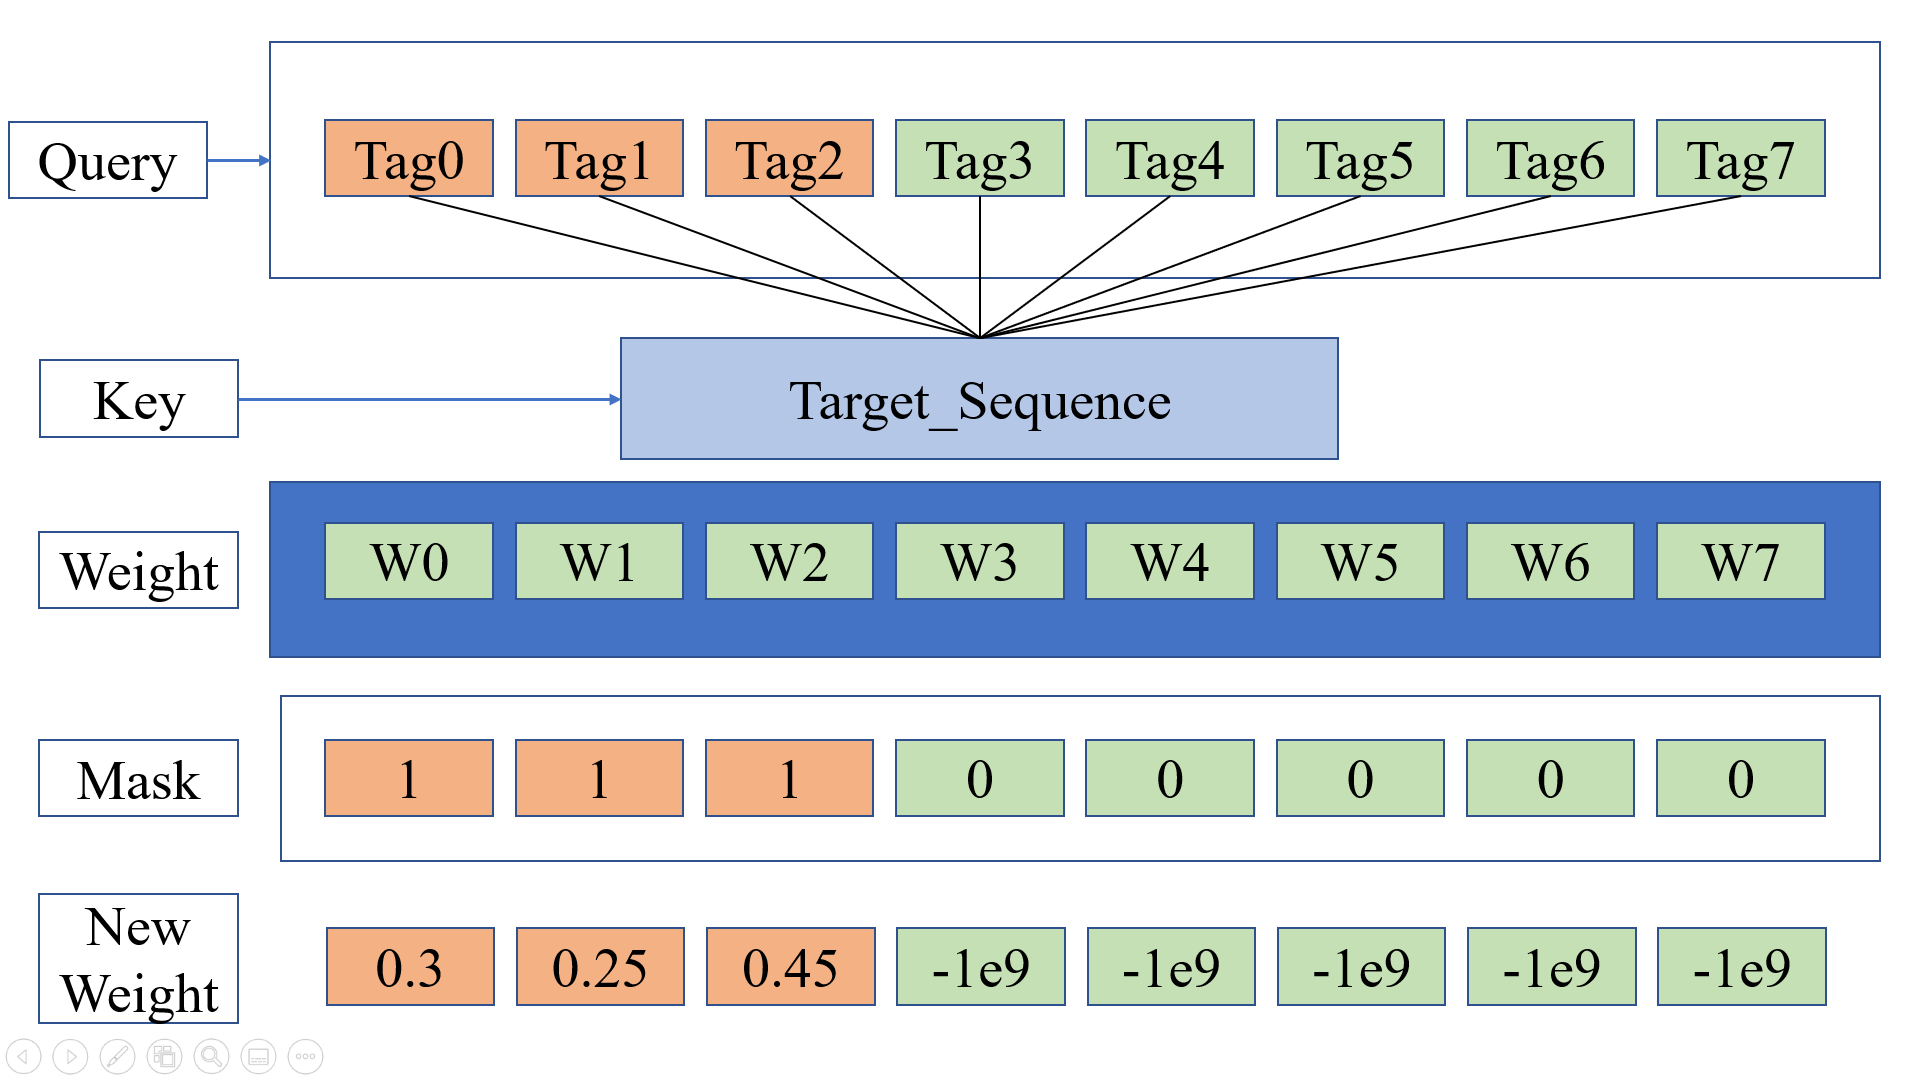
Transformer Attention And Masking — Tech Interview Concept | PracHub
Figure 1 from Eye-Tracking Features Masking Transformer Attention in ...
Linear Transformer Topological Masking with Graph Random Features | AI ...
Masking in Transformer decoders with -inf rather than 0s - nlp ...
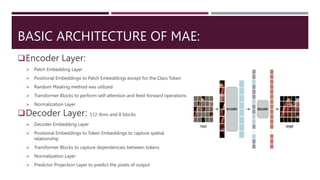
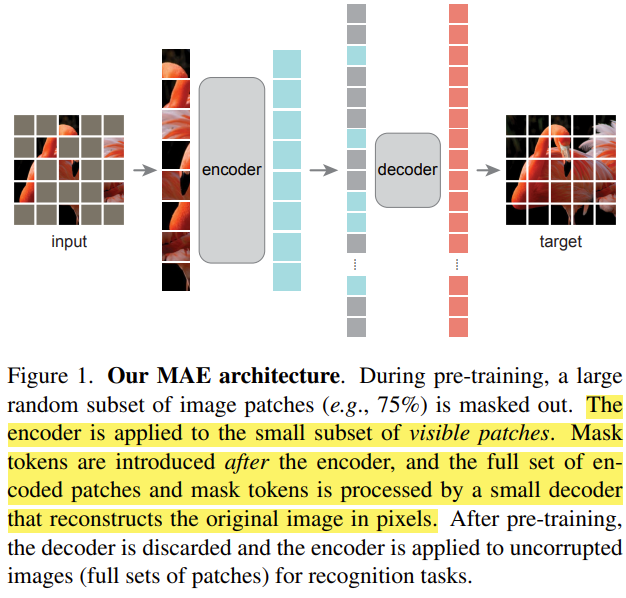
Masked Autoencoder Transformer at Theresa Sotelo blog
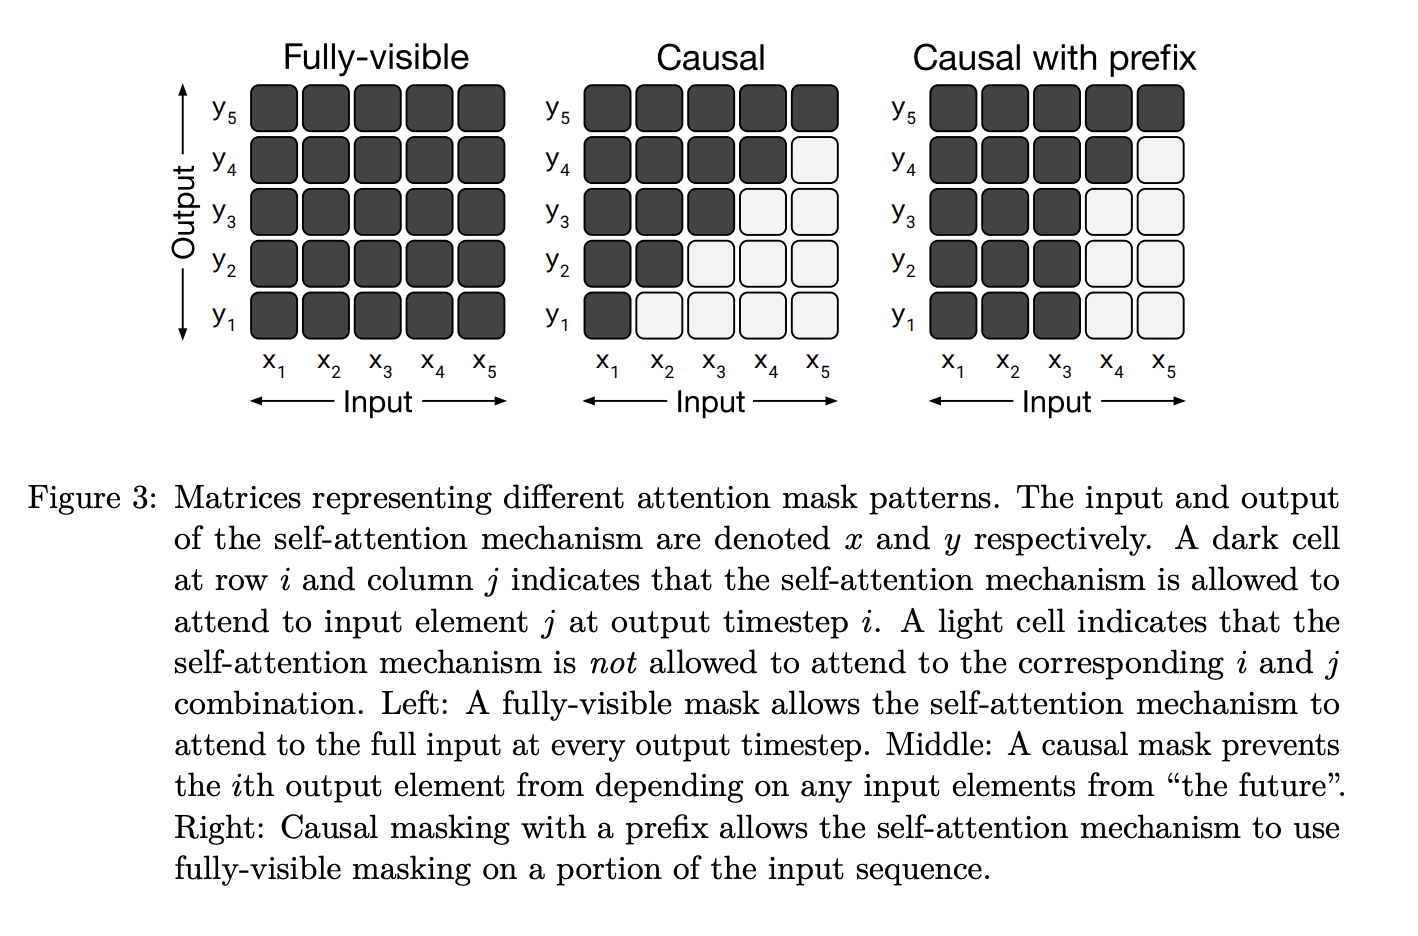
Glossing over the T5: Text-to-Text Transfer Transformer | Nihal D'Souza
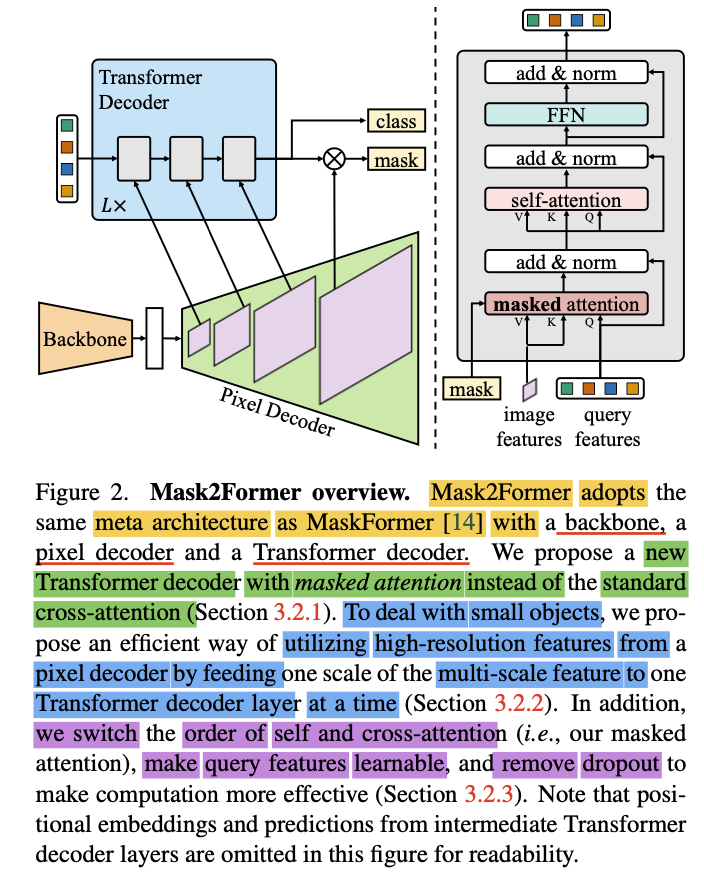
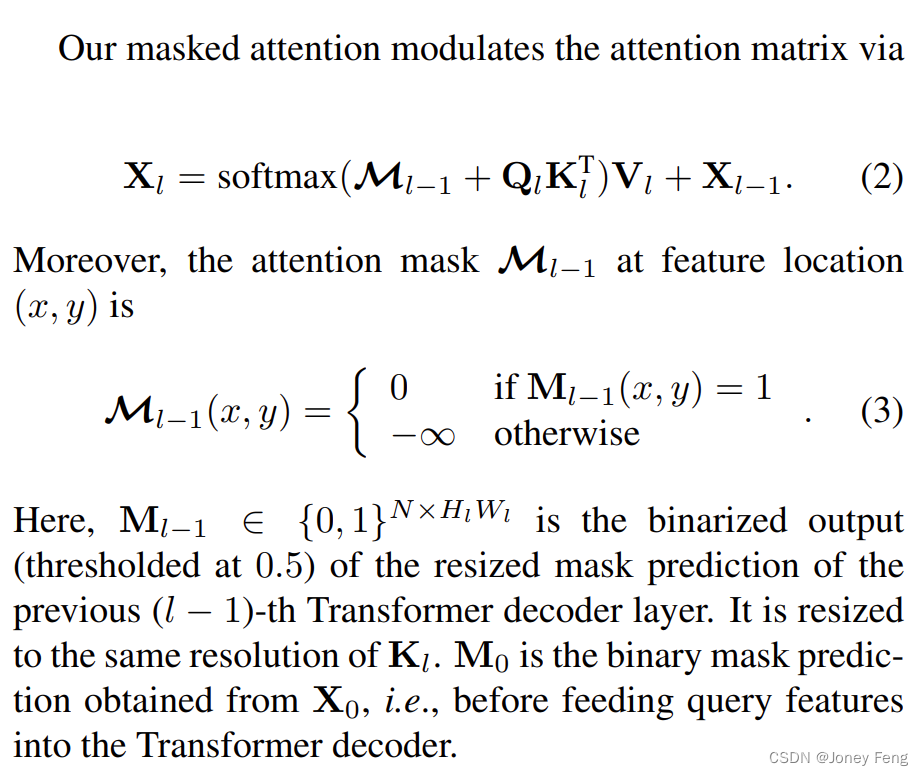
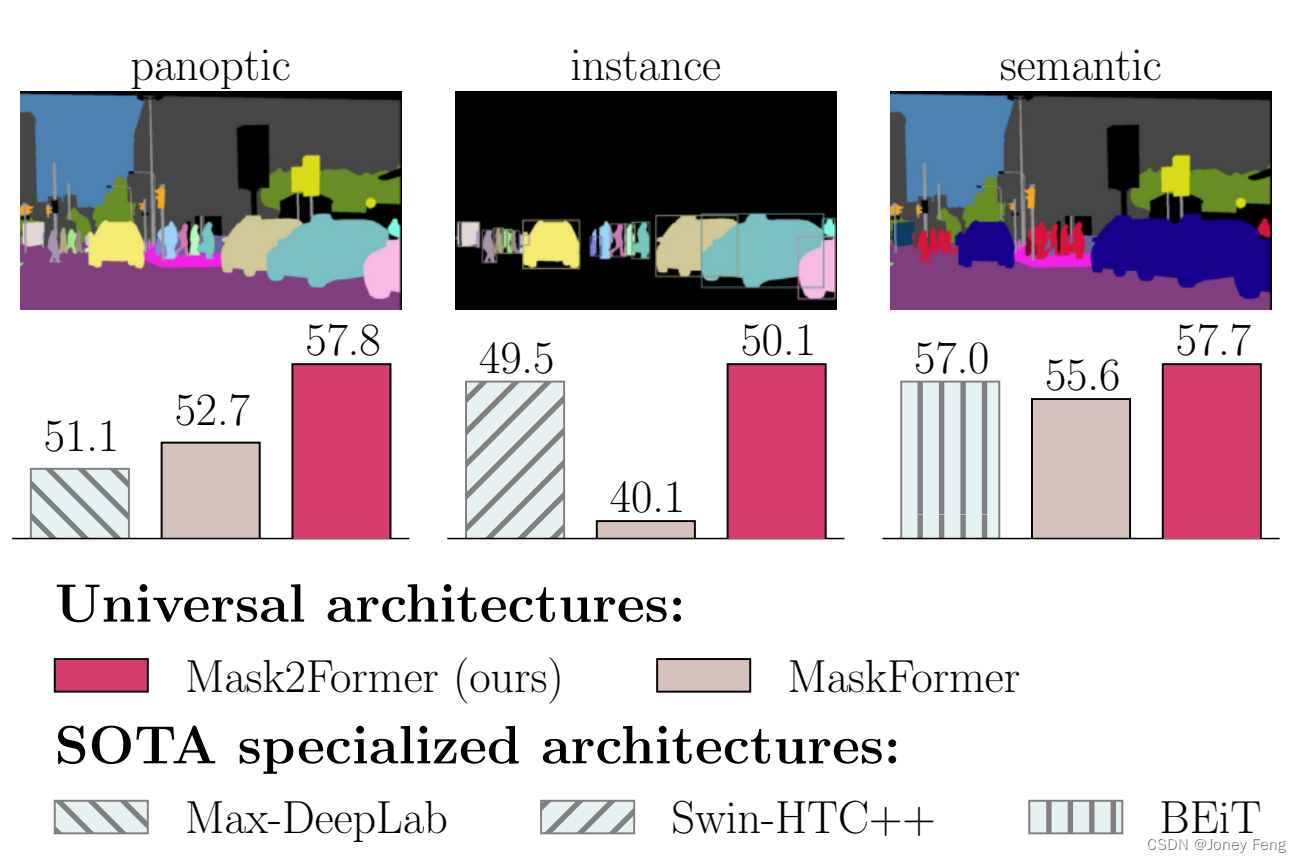
Masked-attention mask transformer for universal image segmentation 리뷰
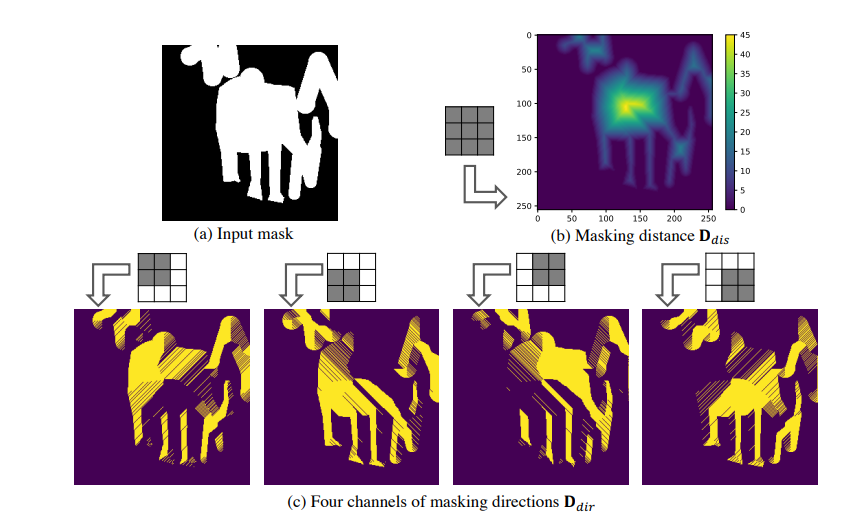
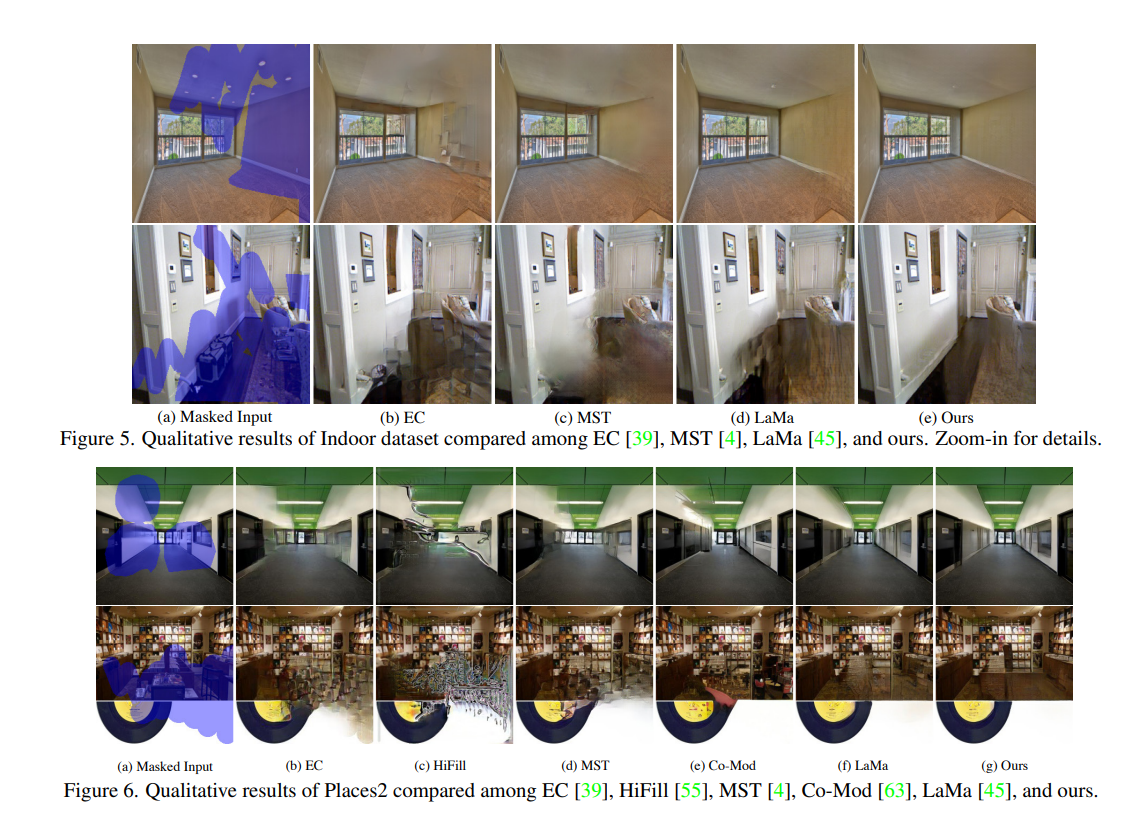
Incremental Transformer Structure Enhanced Image Inpainting with ...
Figure 1 from Apply Masked-attention Mask Transformer to Instance ...
Making Transformers See: BEiT’s Visual Tokens and Masking Magic | by ...
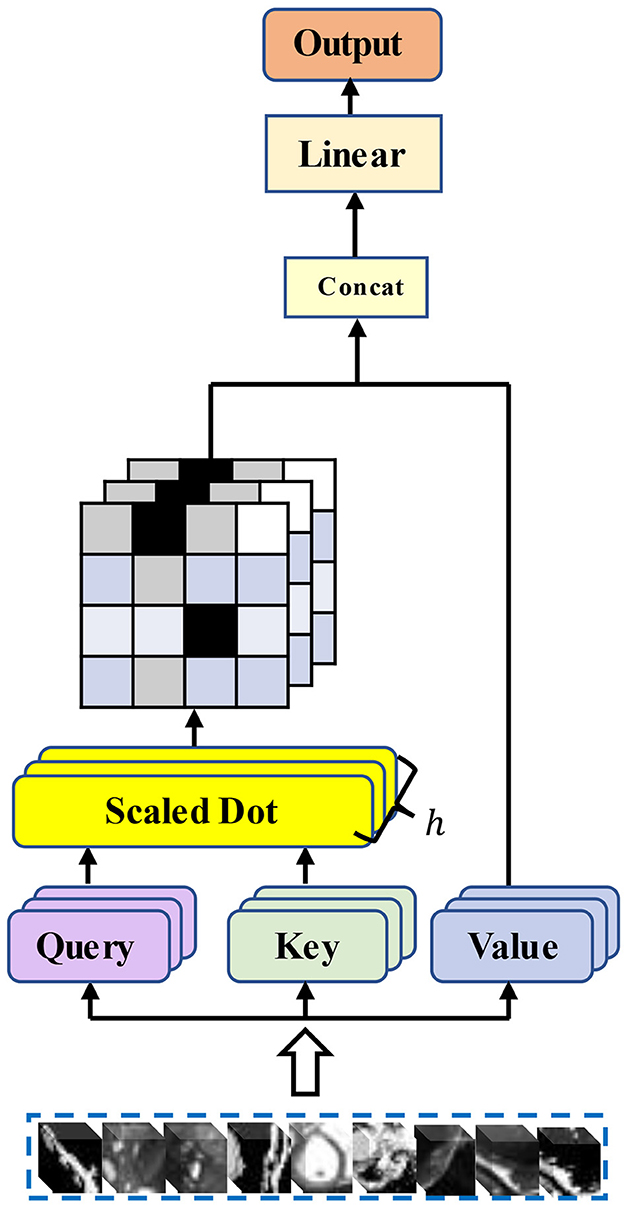
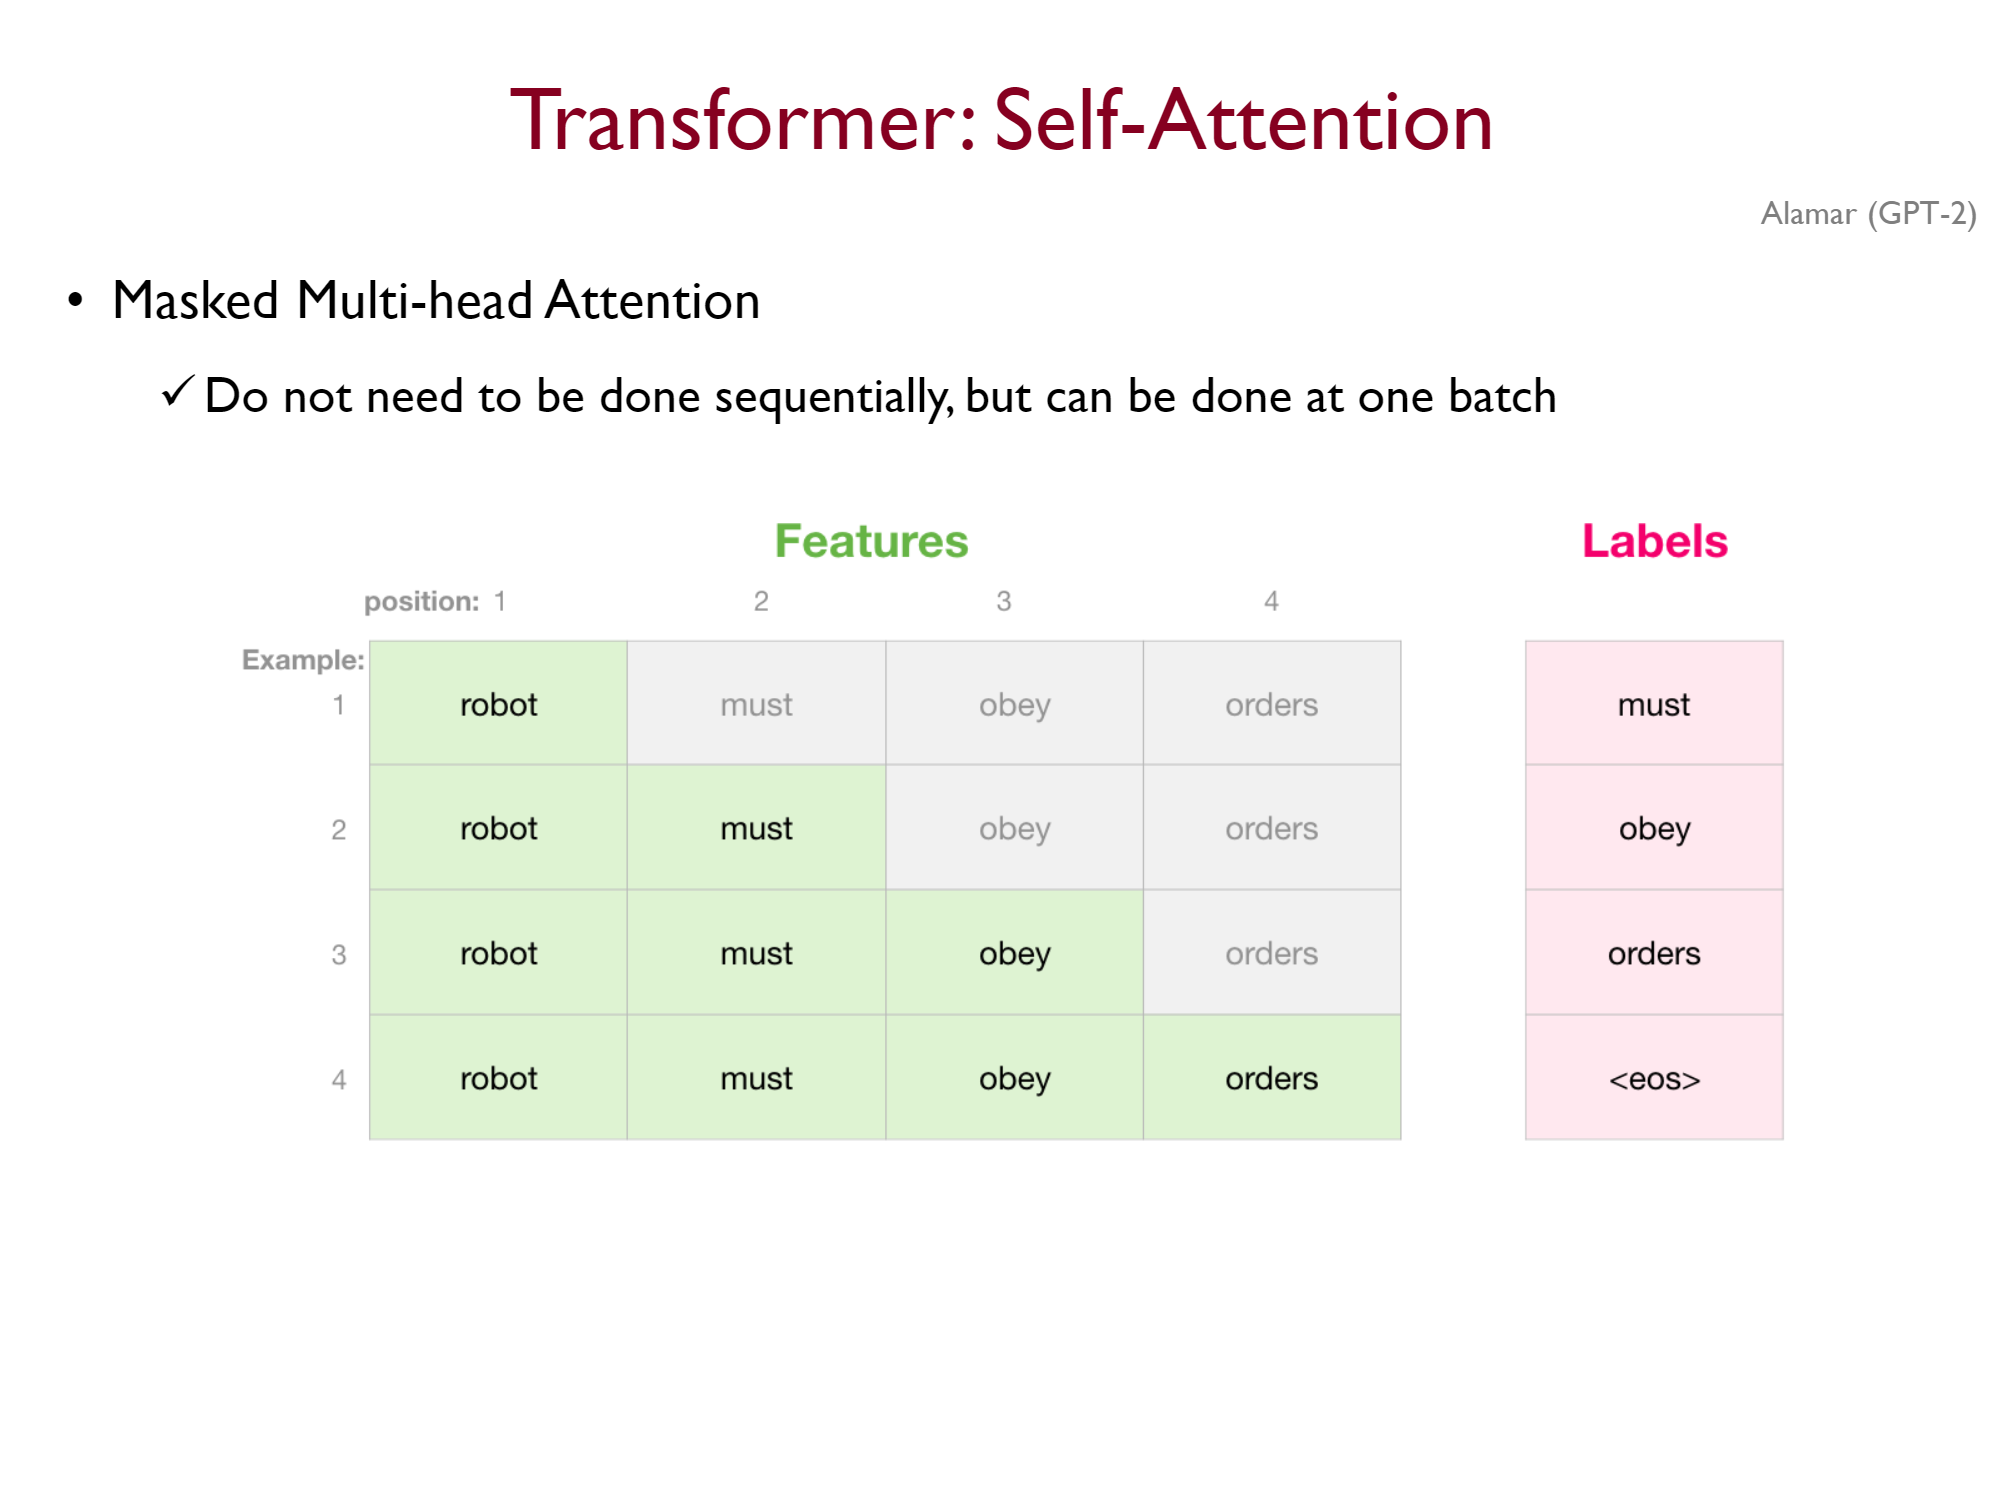
Transformer and Self-attention
Transformer, Multi-head Attetnion Pytorch Guide Focusing on Masking ...
【论文笔记】Mask2Former: Masked-attention Mask Transformer for Universal ...
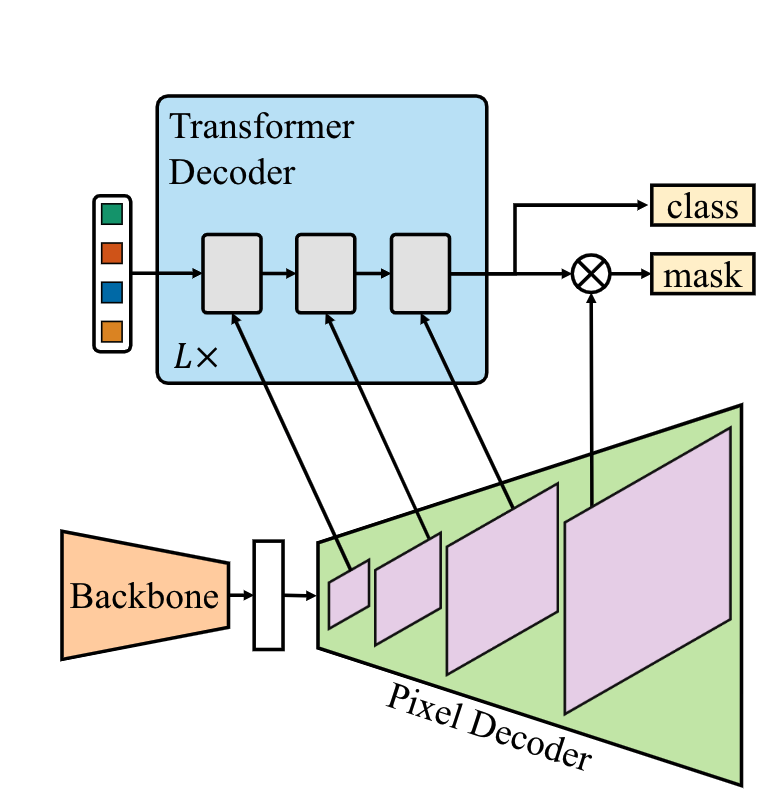
Mask2Former architecture. Each grey block in the transformer decoder ...
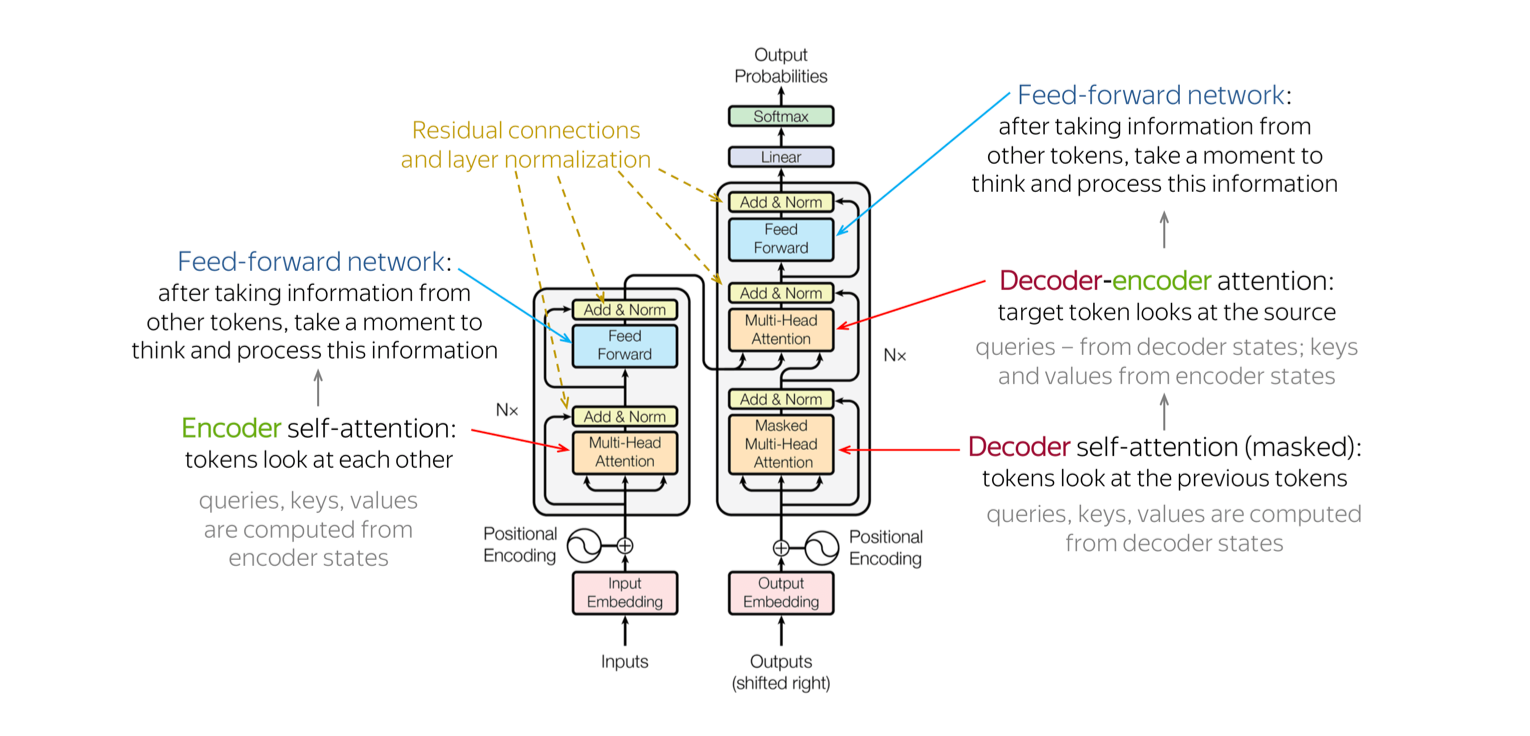
Visually Walking Through a Transformer Model
Chapter 3. Transformer and Attention
Label Mask AutoEncoder(L-MAE): A Pure Transformer Method to Augment ...
Figure 1 from Transformer Masked Autoencoders for Next-Generation ...
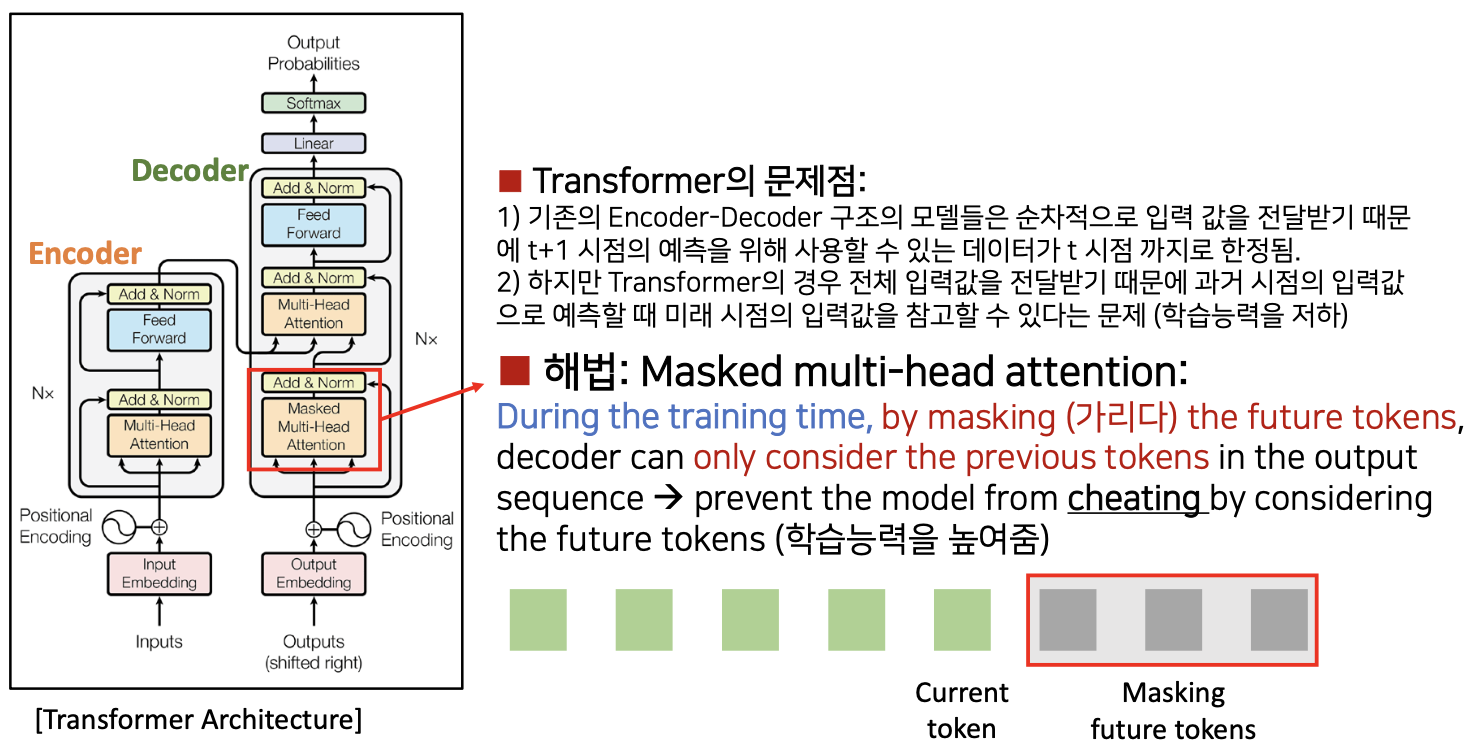
Transformer 네트워크 개념 소개
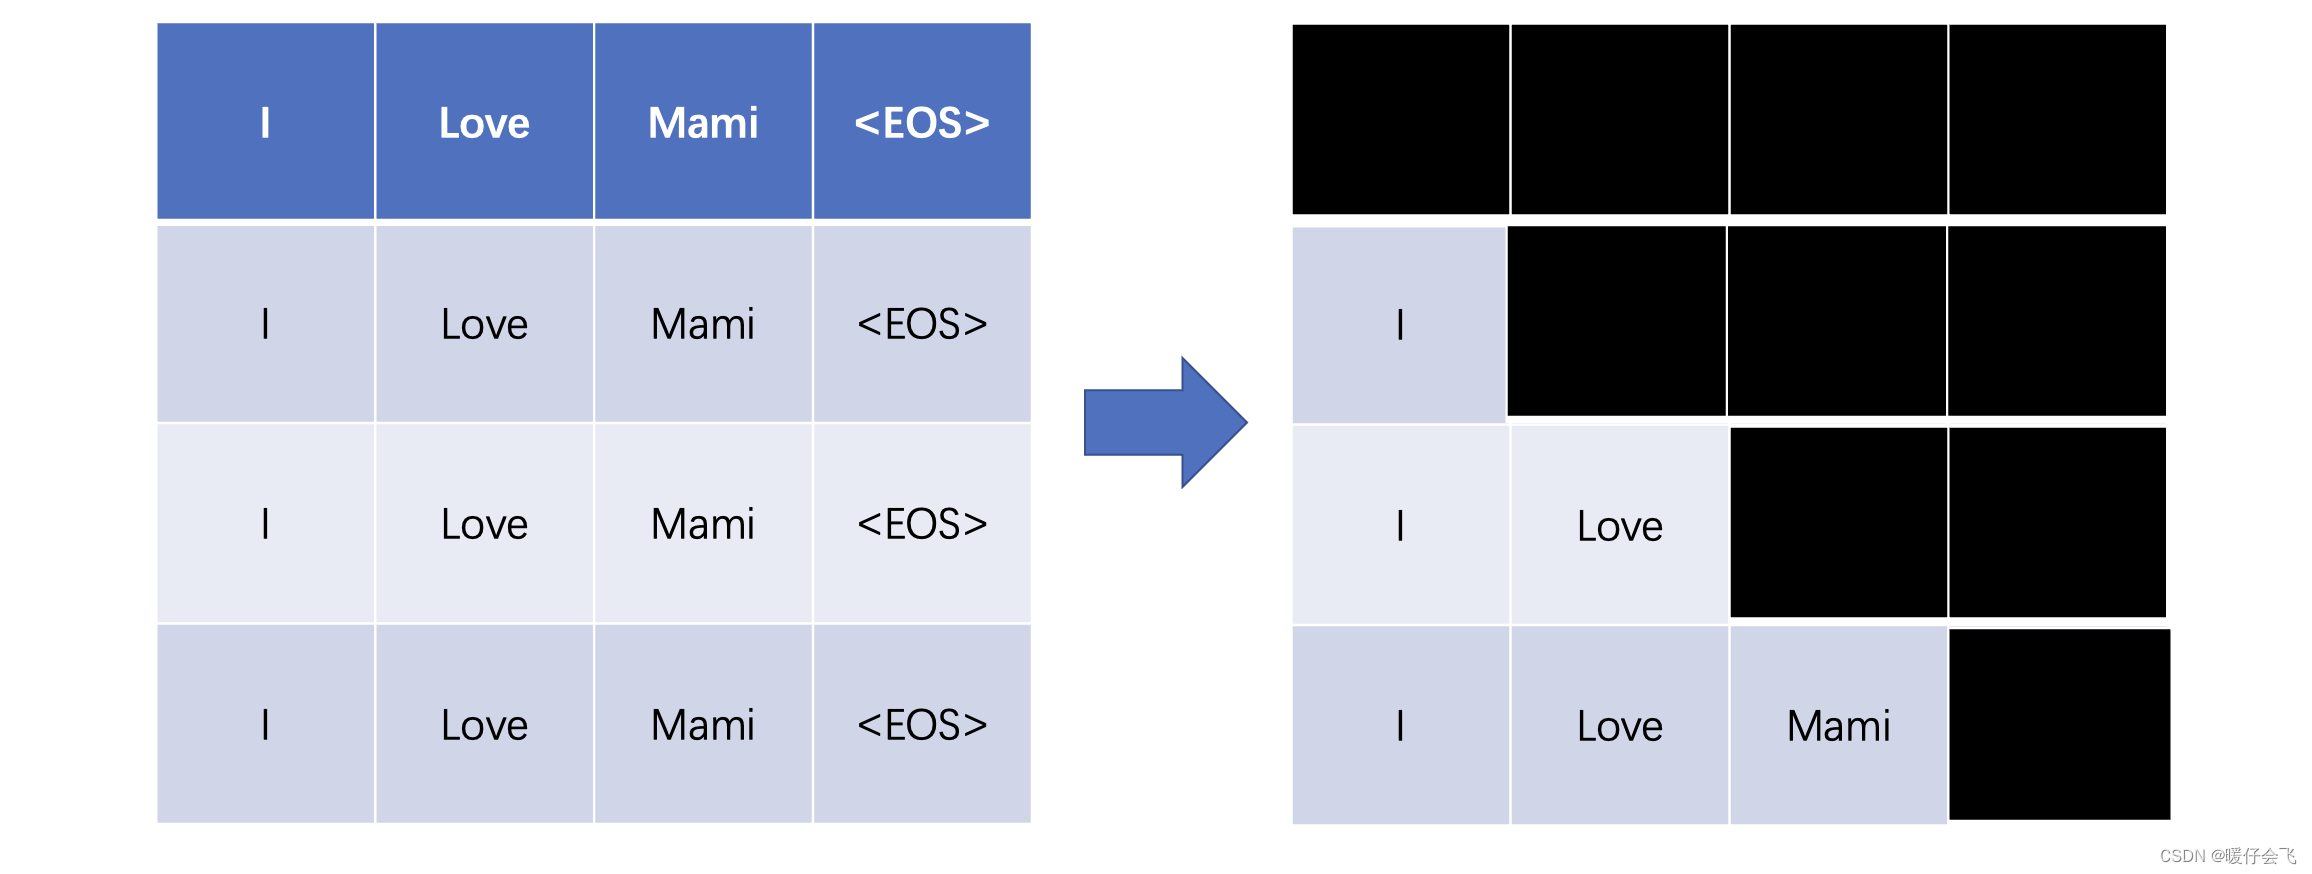
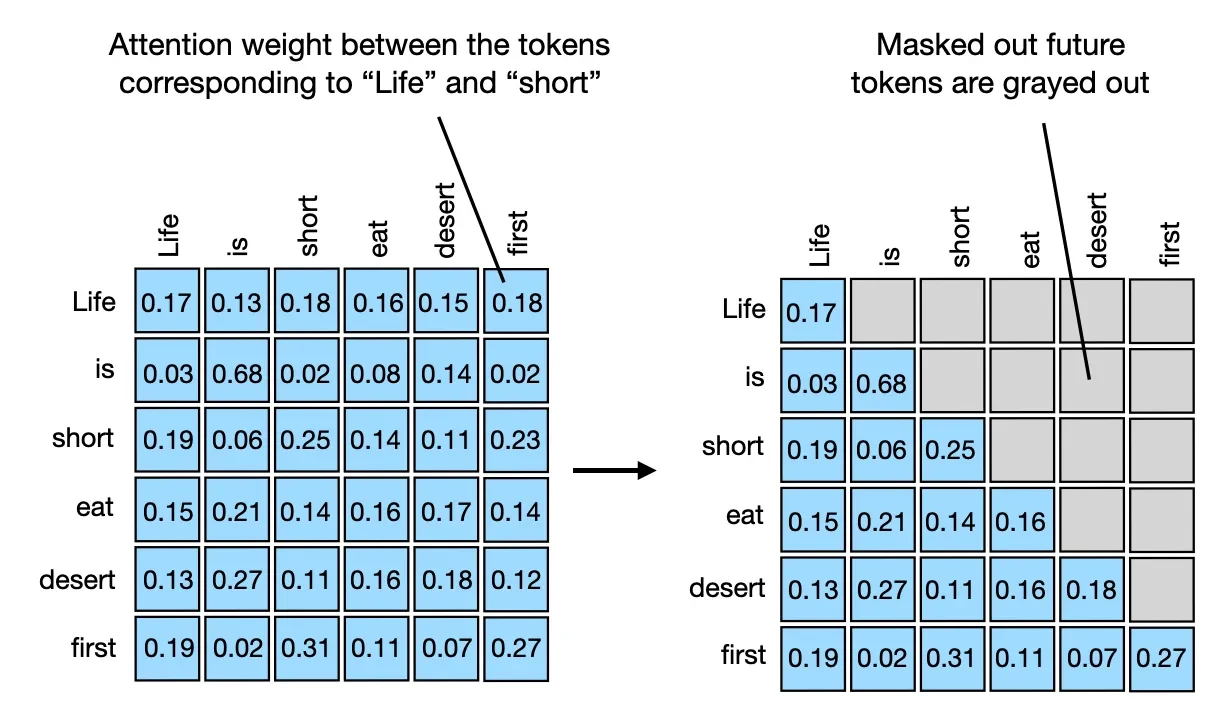
Transformer 解读之:用一个小故事轻松掌握 Decoder 端的 Masked Attention,为什么要使用 Mask ...
[论文评述] TrustEMG-Net: Using Representation-Masking Transformer with U ...
(a) Sparse transformer architecture (b) Decoder based full attention ...
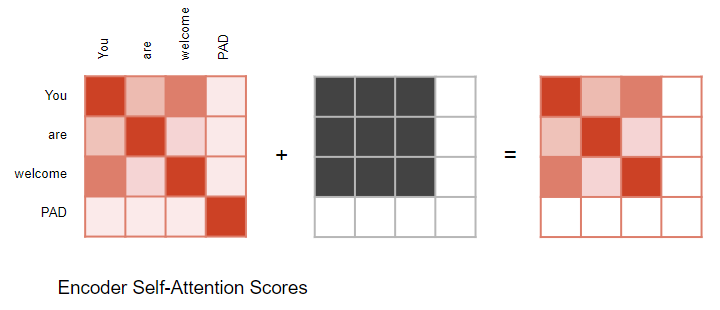
Transformer Mask Doesn't Do Anything - nlp - PyTorch Forums
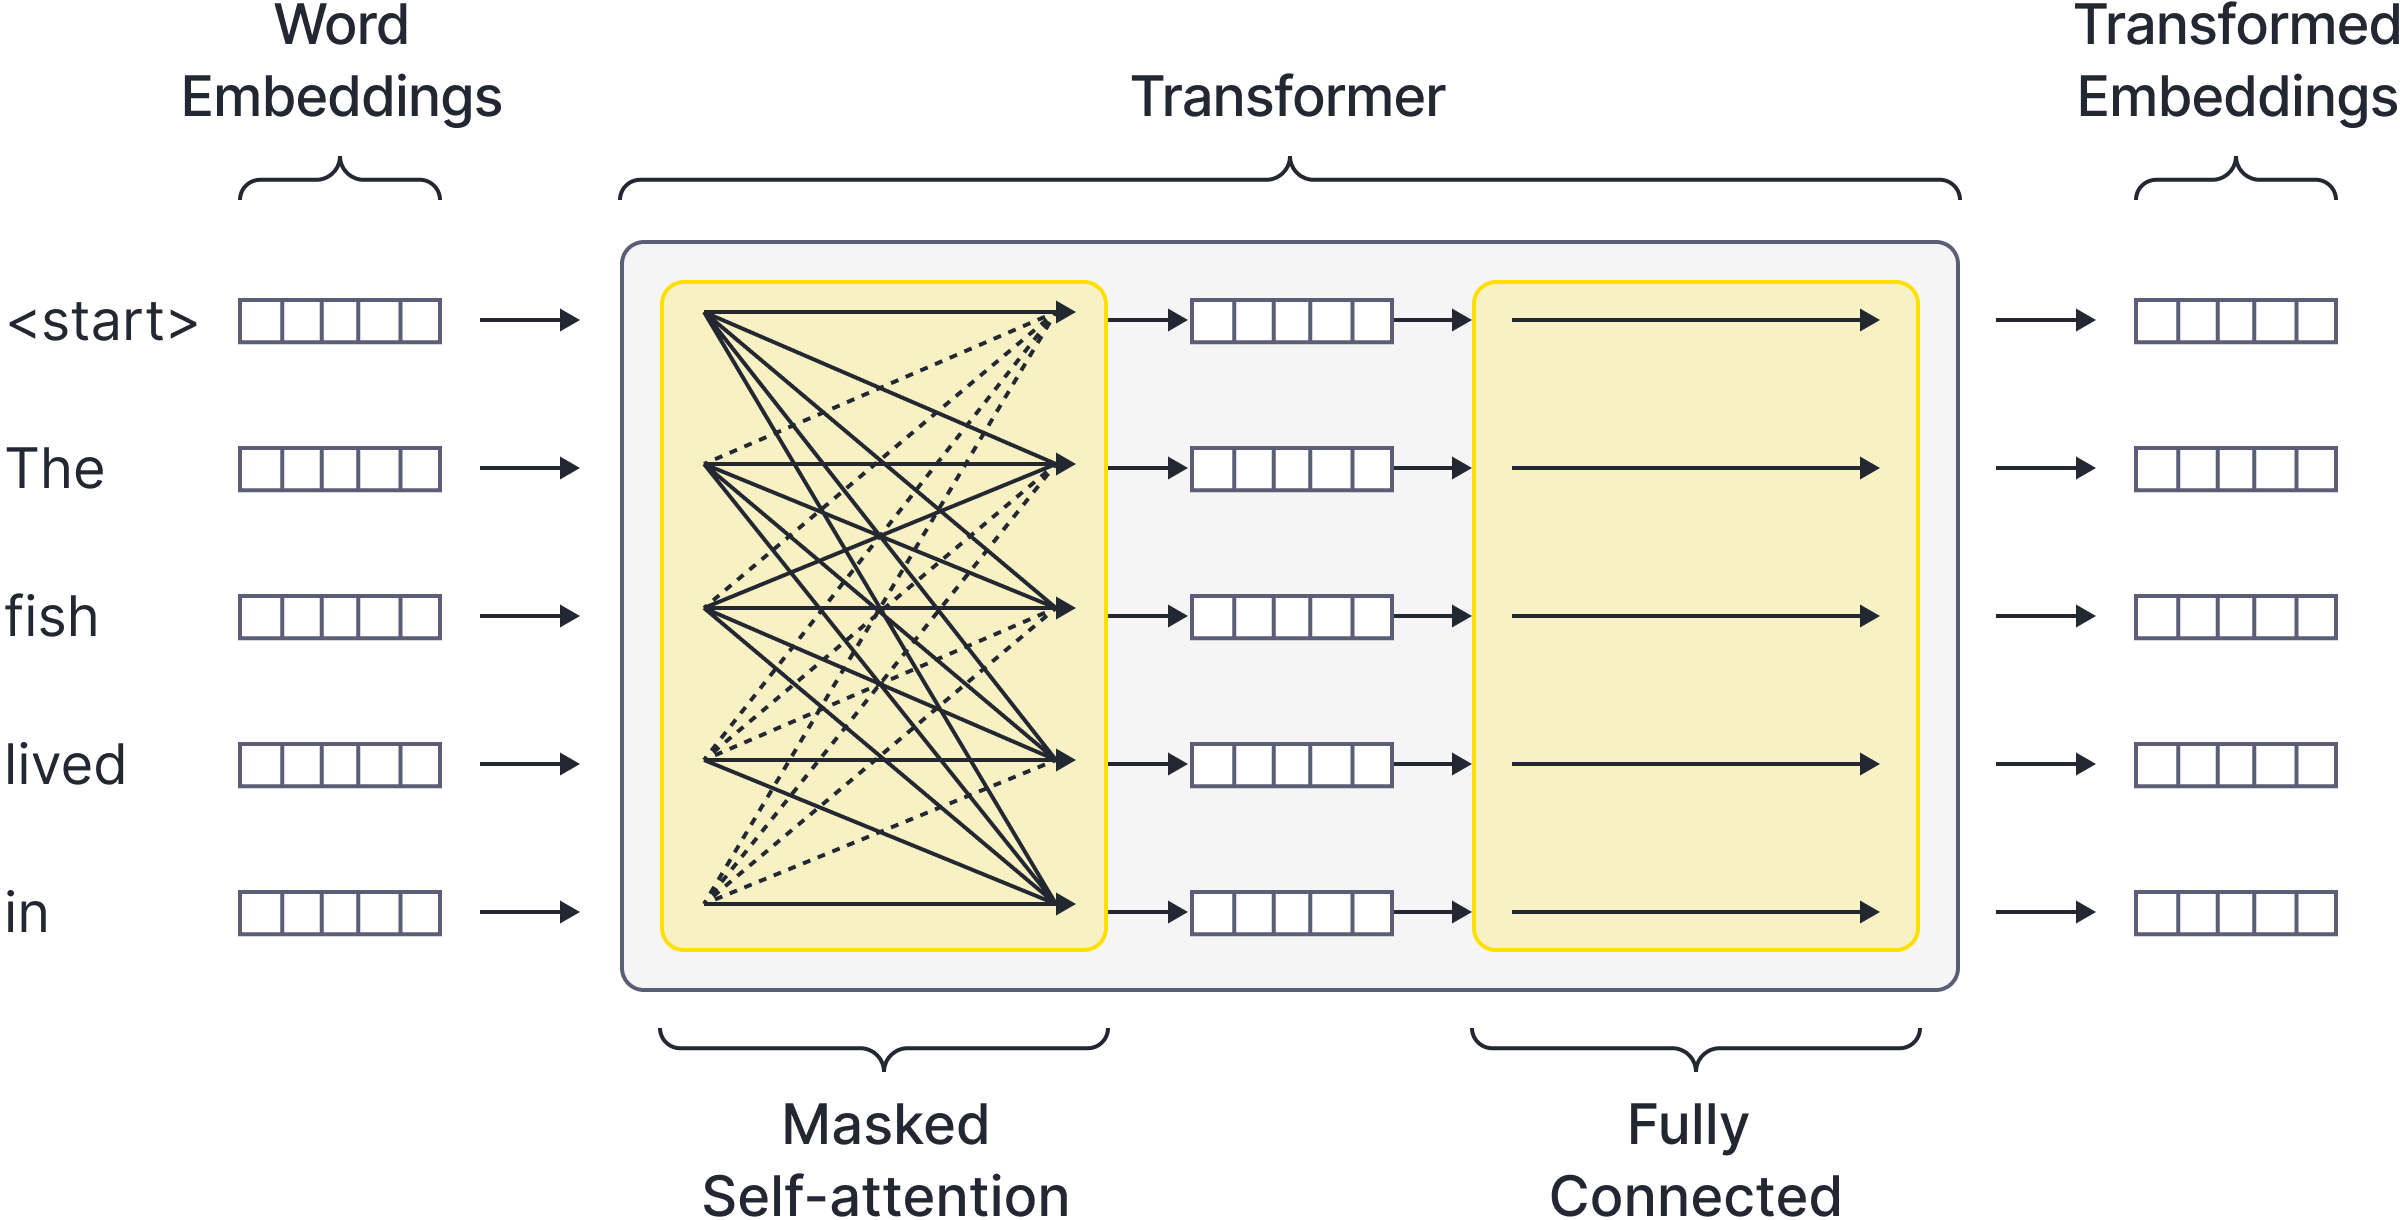
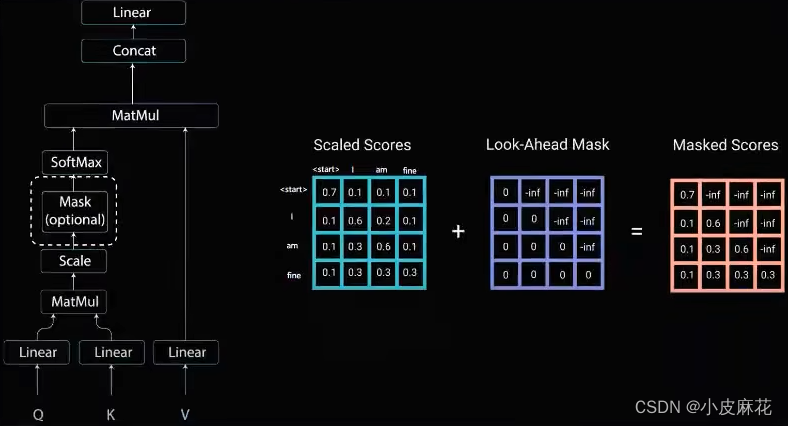
Transformer – Masked Self Attention – Praudyog
Self-attention masking for T5 encoder? - 🤗Transformers - Hugging Face ...
DDMT: Denoising Diffusion Mask Transformer Models for Multivariate Time ...
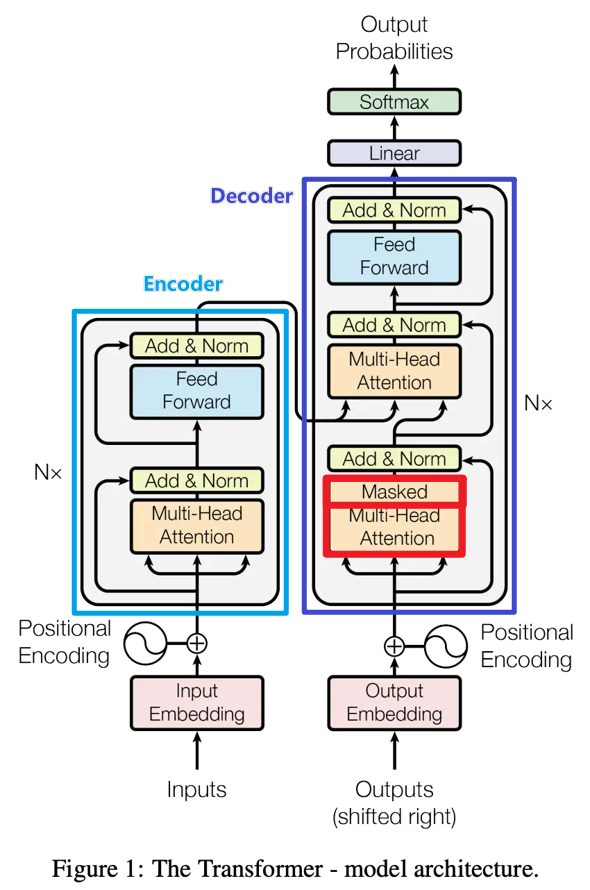
Transformer : encoder 및 decoder (Masked Self-attention)
Transformer is my need! | 🚀 田少晗的个人网站
Adapted Mask2Former architecture with separate transformer decoders for ...
Pytorch Transformer Encoder Mask – PJAQRD
Transformer in Pytorch
Transformer 中 Decoder 真的不需要 Mask - 知乎
Transformer - Implementation
(PDF) Label Mask AutoEncoder(L-MAE): A Pure Transformer Method to ...
[Mask2Former] Masked-attention Mask Transformer for Universal Image ...
transformer 中: self-attention 部分是否需要进行 mask?-极市开发者社区
Pytorch for Beginners #35 | Transformer Model: Encoder Attention ...
Efficient Transformer Encoders for Mask2Former-style models | AI ...
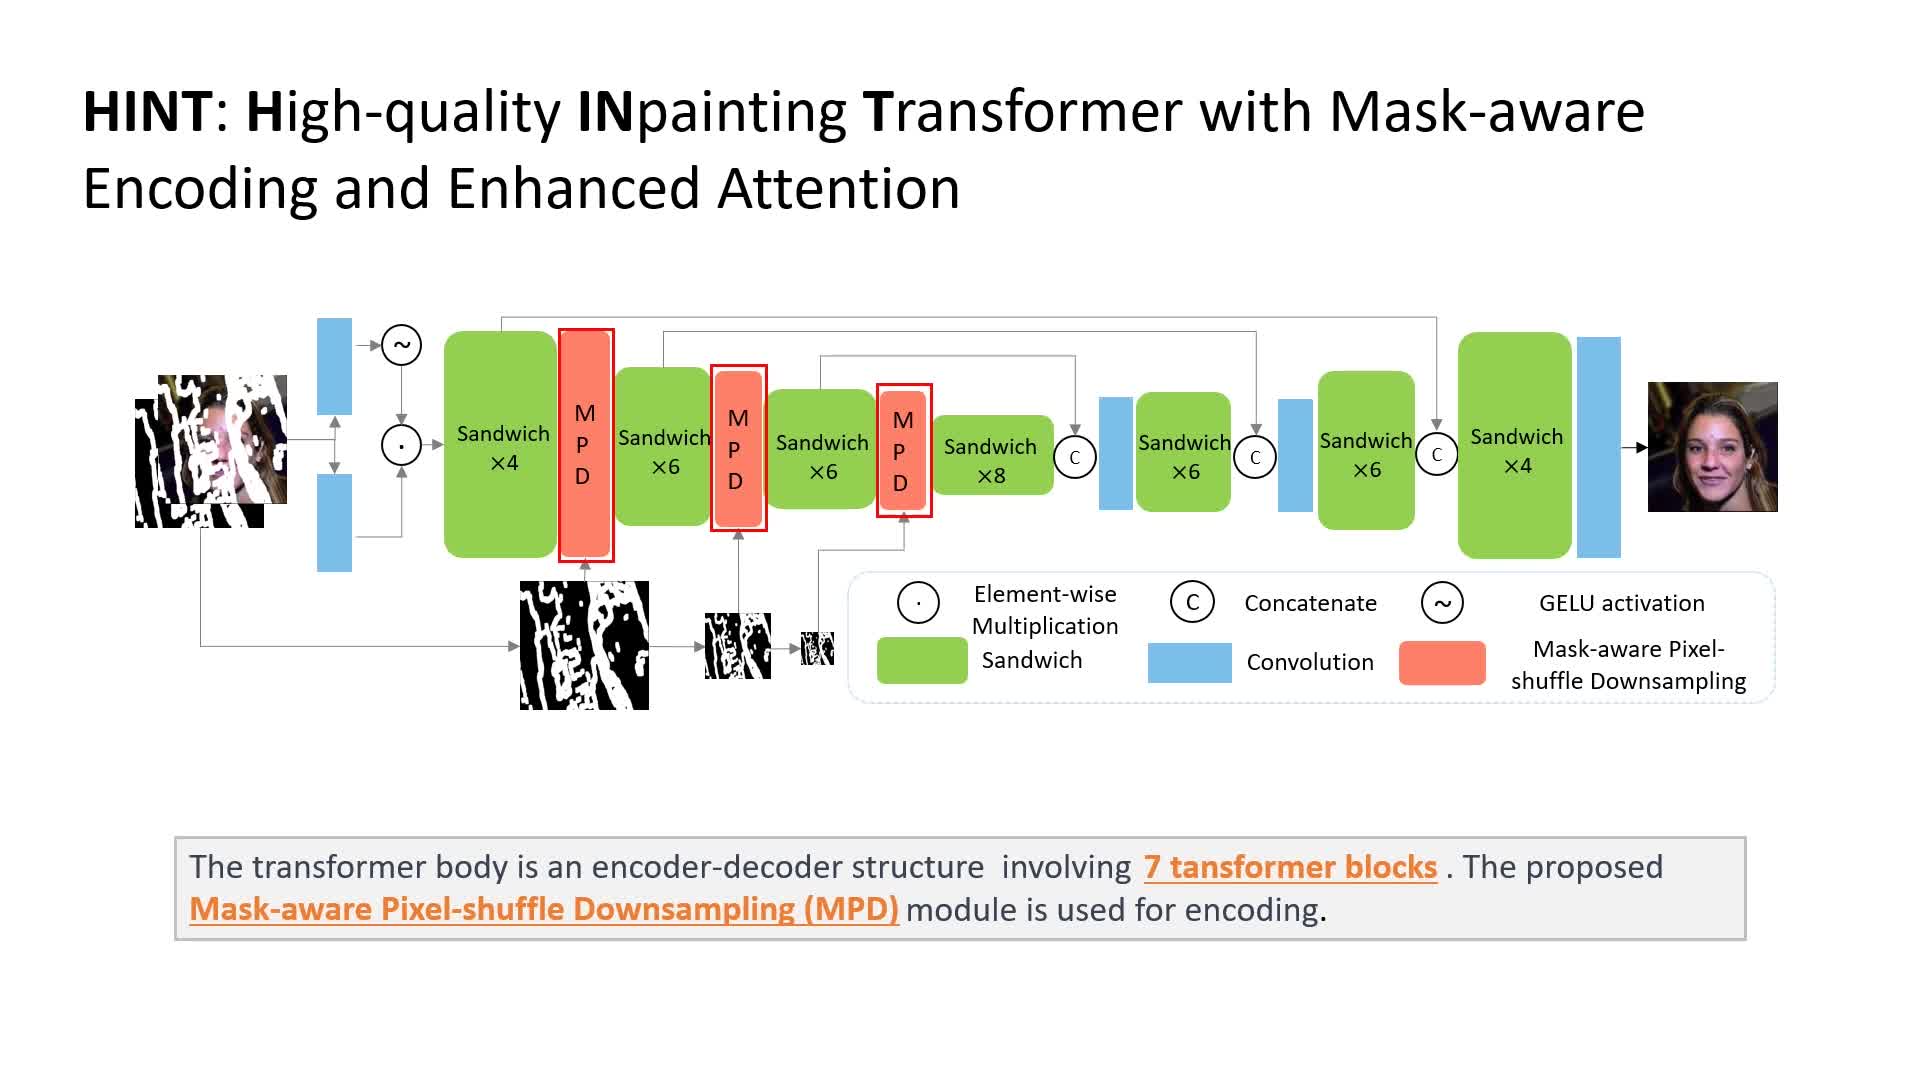
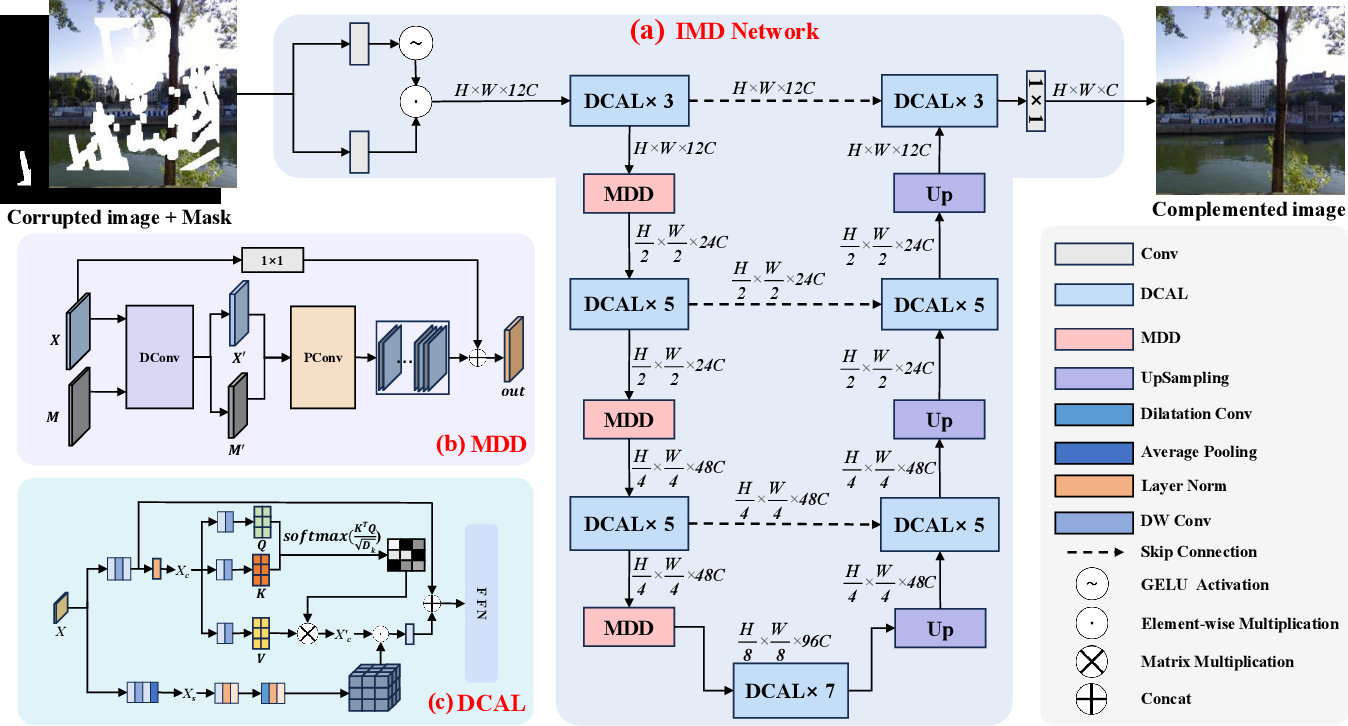
HINT: High-quality INpainting Transformer with Mask-Aware Encoding and ...
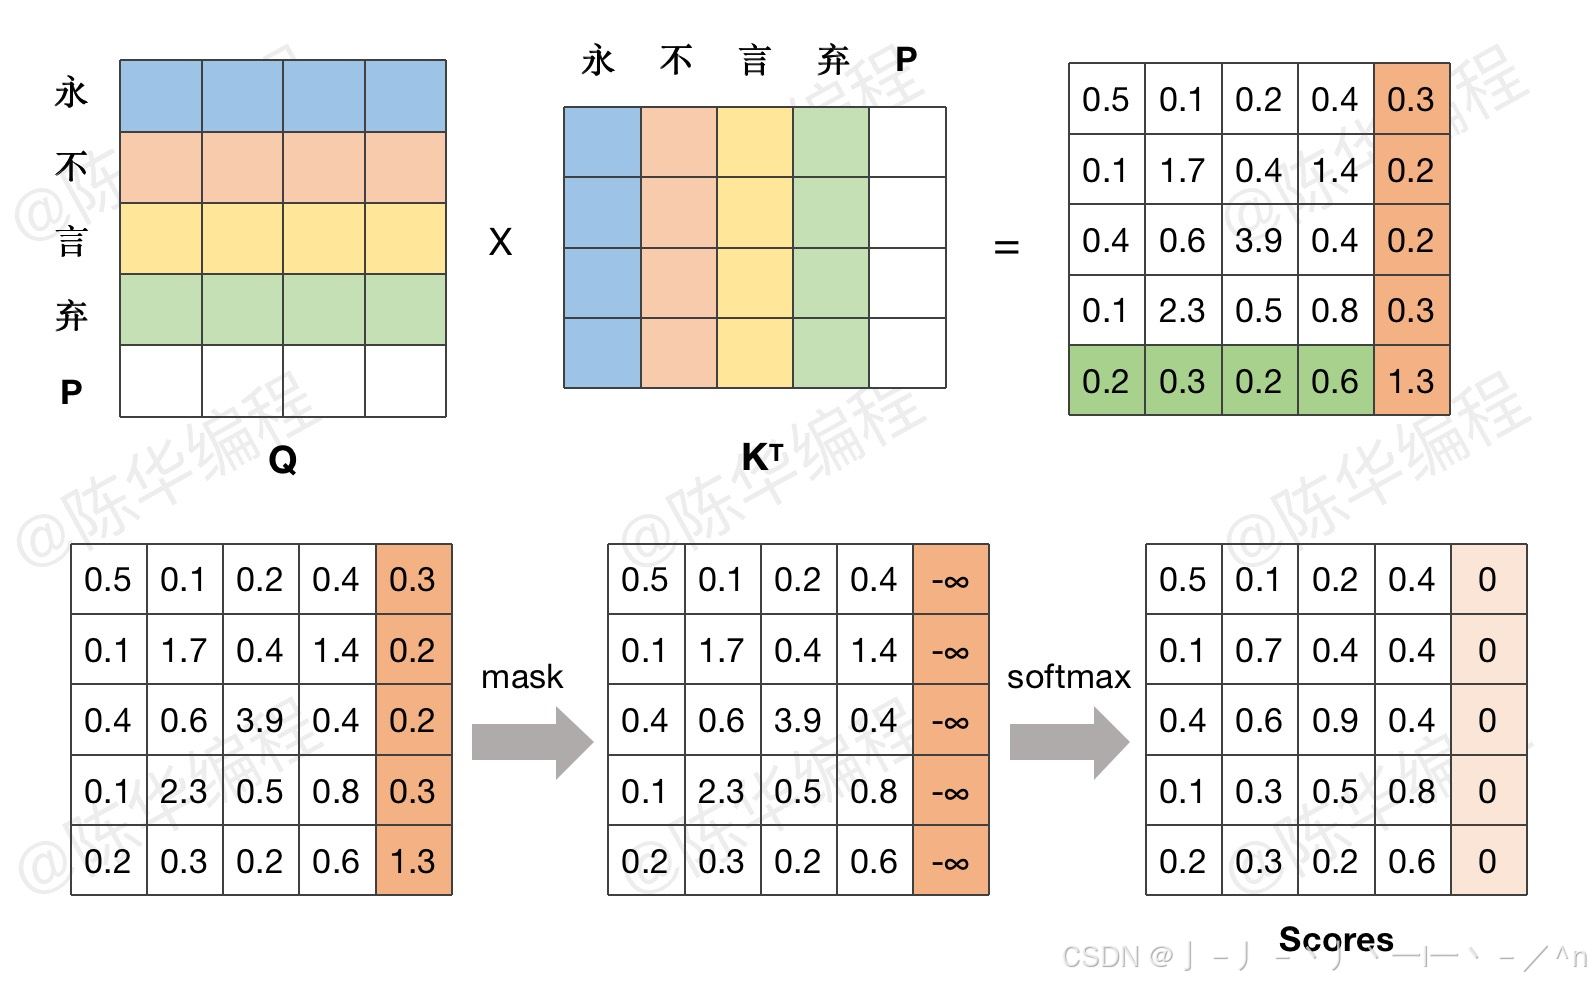
Transformer 源码中 Mask 机制的实现 - 虾野百鹤 - 博客园
Transformer - NLP Roadmap
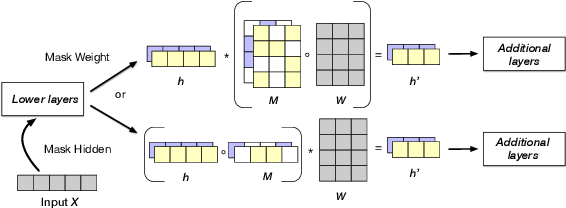
Figure 1 from Disentangling Representations of Text by Masking ...
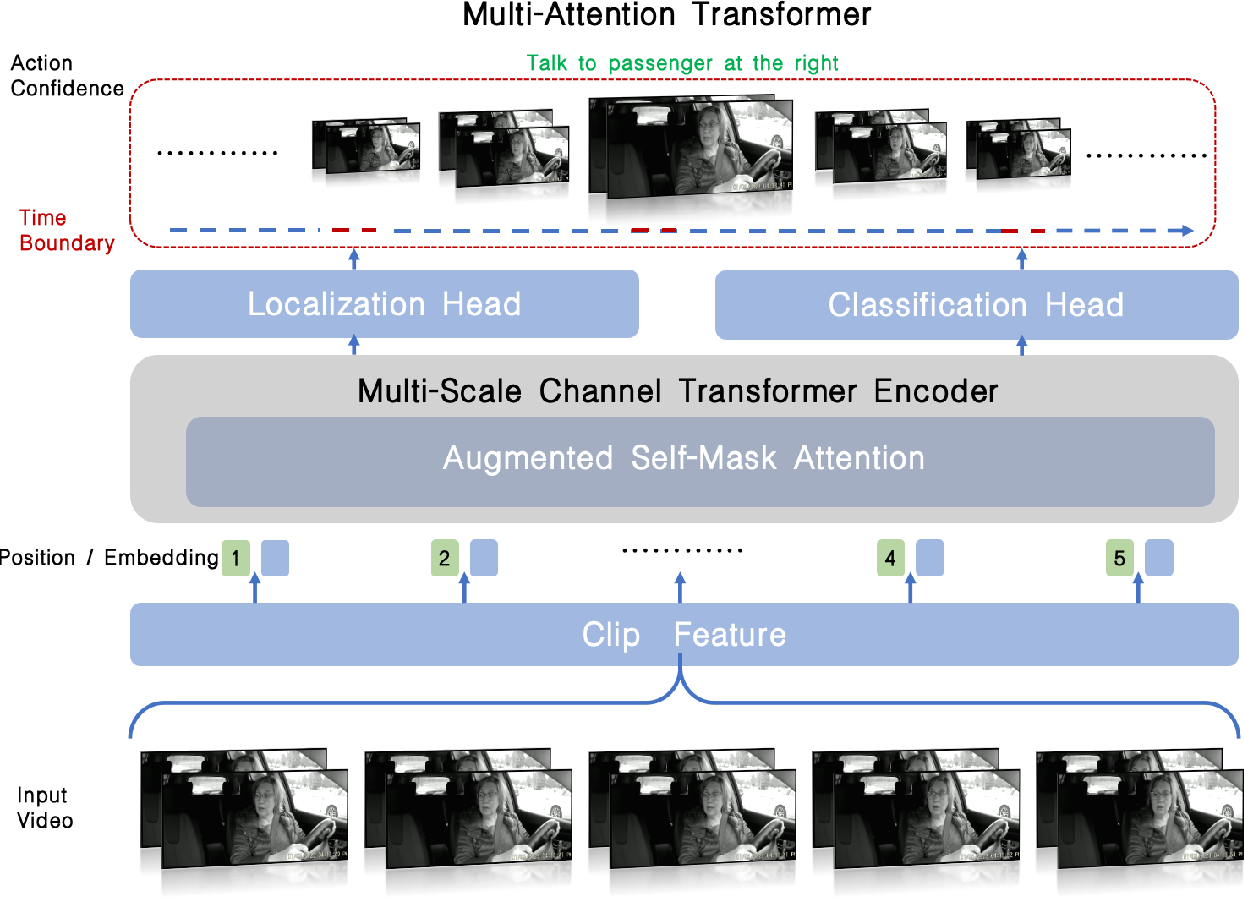
Figure 2 from Augmented Self-Mask Attention Transformer for ...
三十六章:Masked-attention Mask Transformer for Universal Image Segmentation ...
Figure 1 from Image Inpainting Transformer with Mask-Aware Encoding and ...
TrustEMG-Net: Using Representation-Masking Transformer with U-Net for ...
Enhancing Mask Transformer with Auxiliary Convolution Layers for ...
Transformer — Attention is All You Need — A Paper Summary | by Denaya ...
Paper | Incremental Transformer Structure Enhanced Image Inpainting ...
Figure 2 from Mask-Guided Transformer for Human-Object Interaction ...
Paper page - Incremental Transformer Structure Enhanced Image ...
分享自己的论文 TLM: Token-Level Masking for Transformers - 知乎
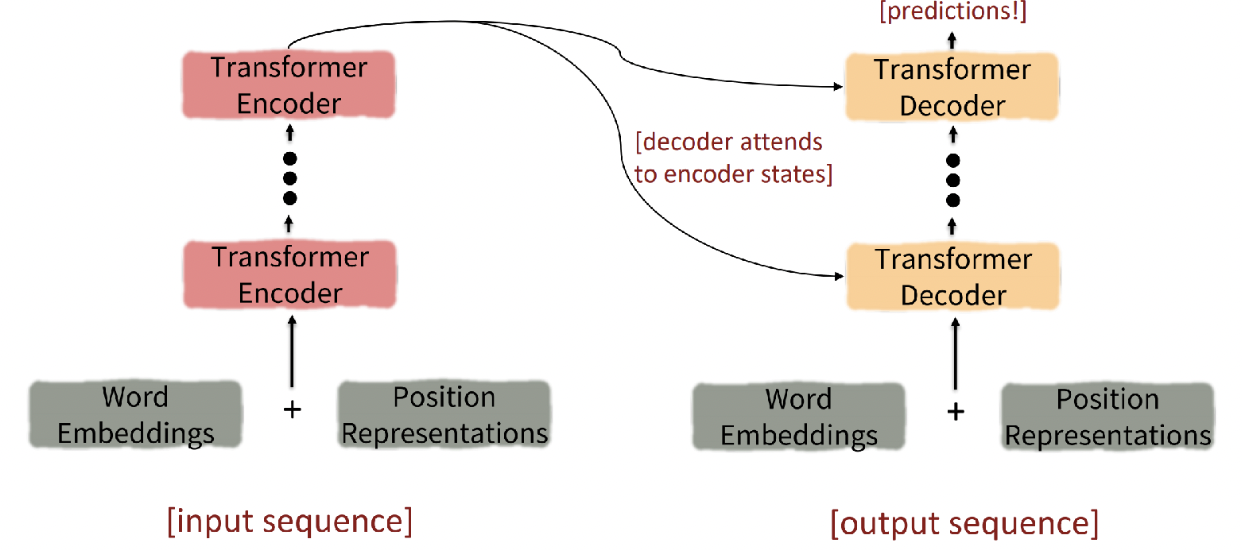
Decoder vs Encoder in Transformer Models | AI Tutorial | Next Electronics
(PDF) Disentangling Representations of Text by Masking Transformers
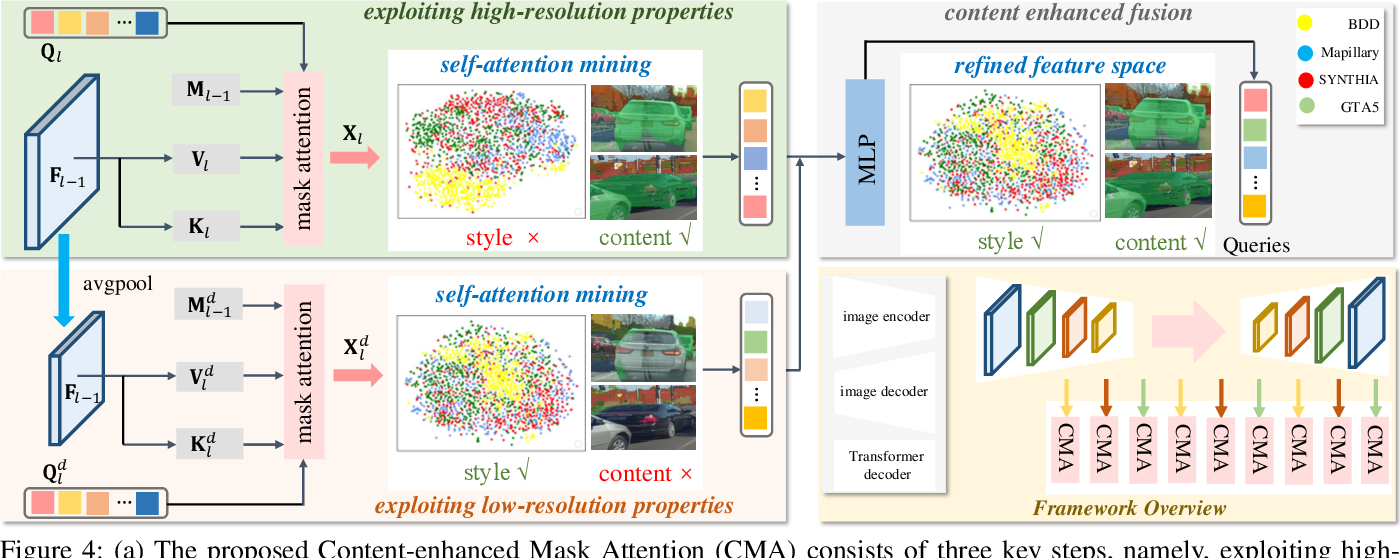
Figure 4 from Learning Content-enhanced Mask Transformer for Domain ...
PMT: Plain Mask Transformer for Image and Video Segmentation with ...
The Mask-Guided Transformer (MGT) structure mainly consists of four ...
Transformer (Attention Is All You Need) 구현하기 (2/3) | Reinforce NLP
Ahsen Khaliq on LinkedIn: M2T: Masking Transformers Twice for Faster ...
Tìm hiểu mô hình Transformer - Ngươi Không Phải Là Anh Hùng, Ngươi Là ...
Figure 1 from Mean Shift Mask Transformer for Unseen Object Instance ...
Object Detection in Medical Images Based on Hierarchical Transformer ...
GitHub - rlucatoor/masked-transformer: A Pytorch implementation of a ...
FlashAttention-2 论文解读_flashattention2论文-CSDN博客
machine learning - Why do we mask input tokens for the decoder in a ...
[2022] Masked Autoencoders for Point Cloud Self-supervised Learning - 知乎
Transformers — Visual Guide
[Paper reading]Masked Autoencoders | by Janey | Medium
深度学习进阶之Transformer - AI备忘录
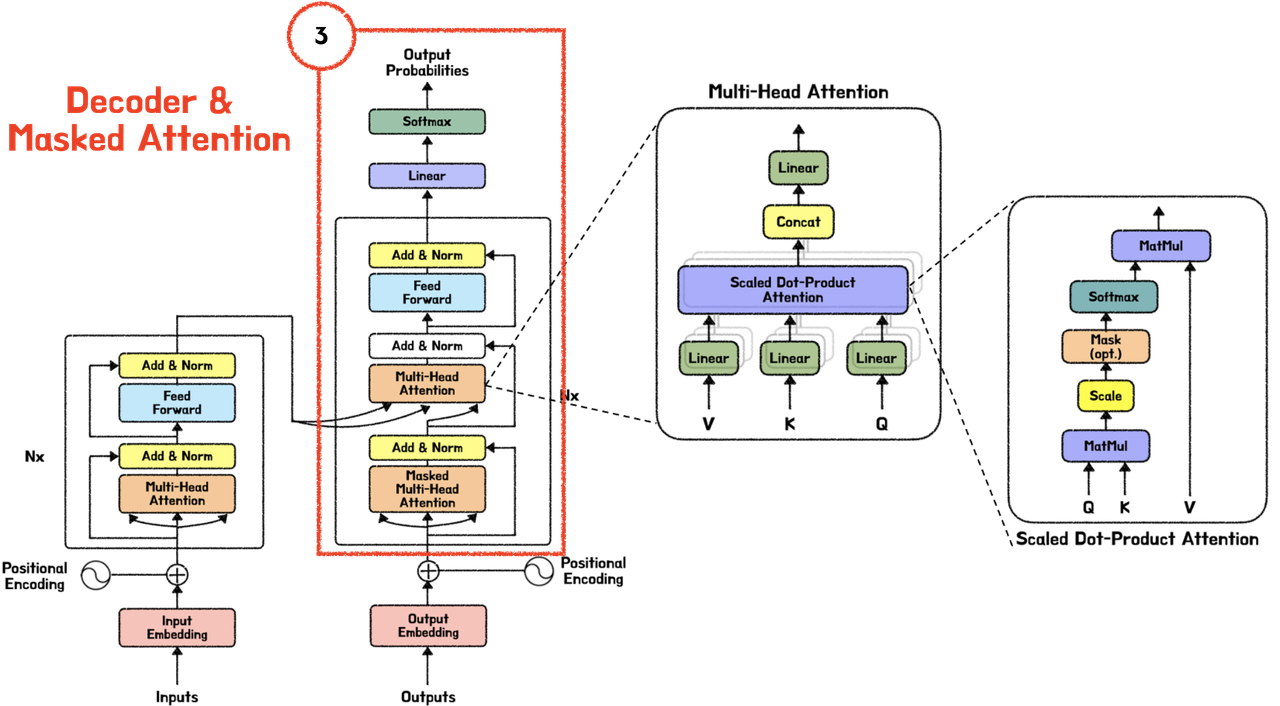
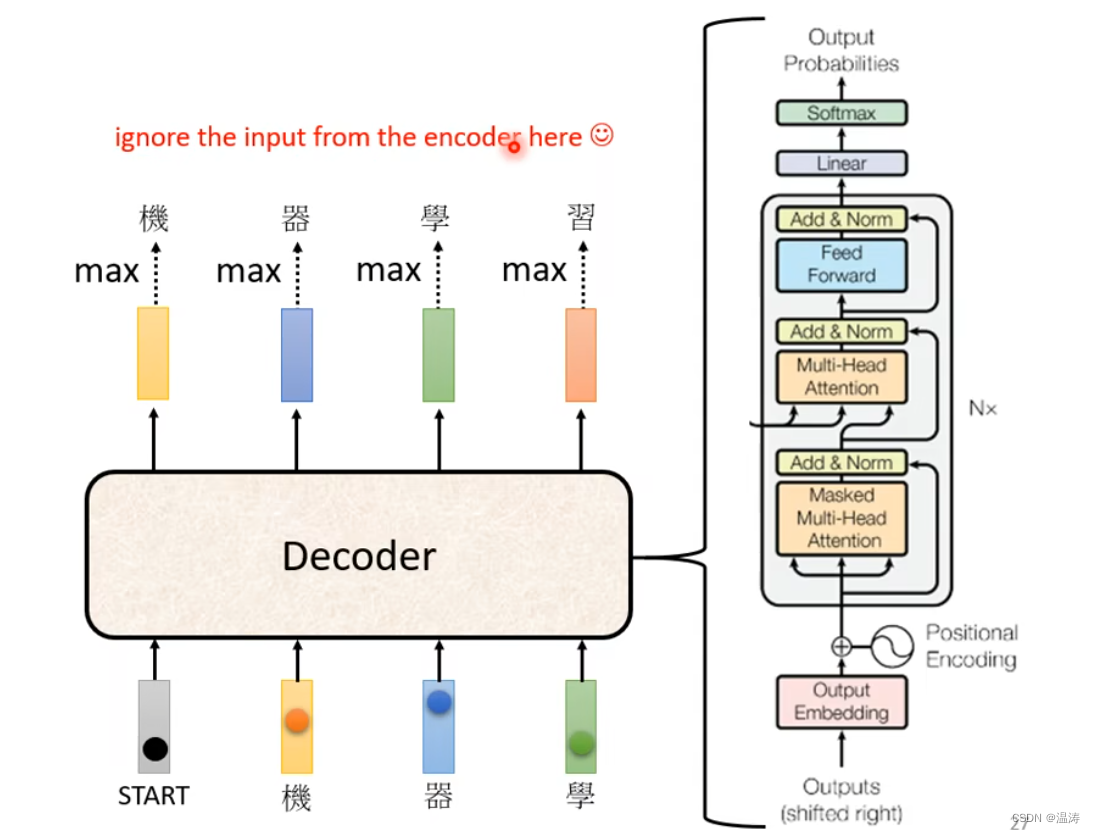
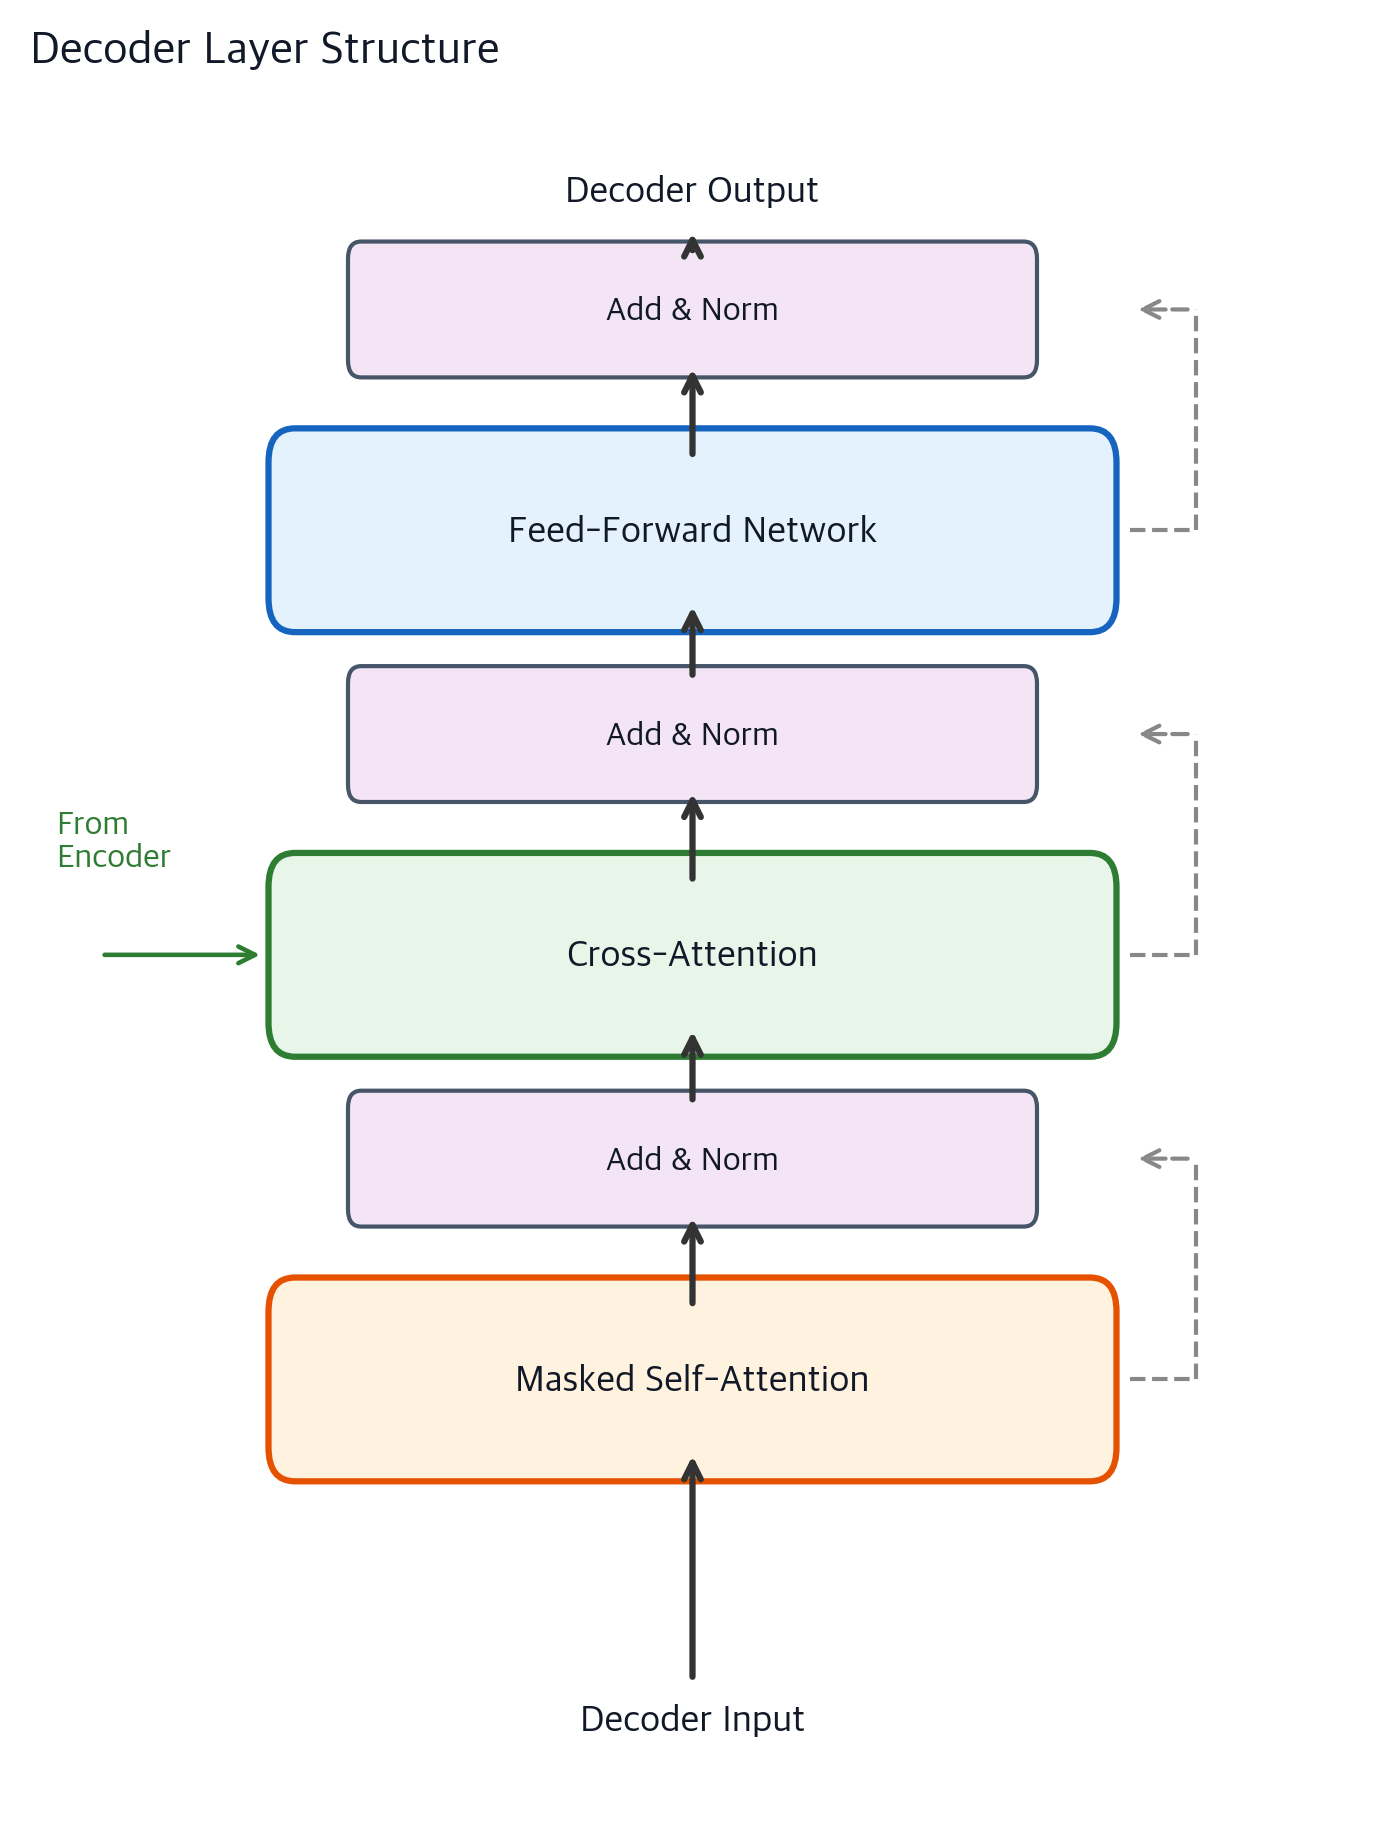
트랜스포머(Transformer) 파헤치기—3. Decoder & Masked Attention
Mask2Former来了!用于通用图像分割的 Masked-attention Mask Transformer-CSDN博客
Transformer和自注意力机制Self-Attention详解和时间复杂度计算+Image Transformer简介_注意力机制的时间 ...
Transformer相关——(7)Mask机制 | 冬于的博客
Transformers Explained Visually - Multi-head Attention, deep dive ...
Illustration of the proposed Transformer-based Mask Detection Module ...
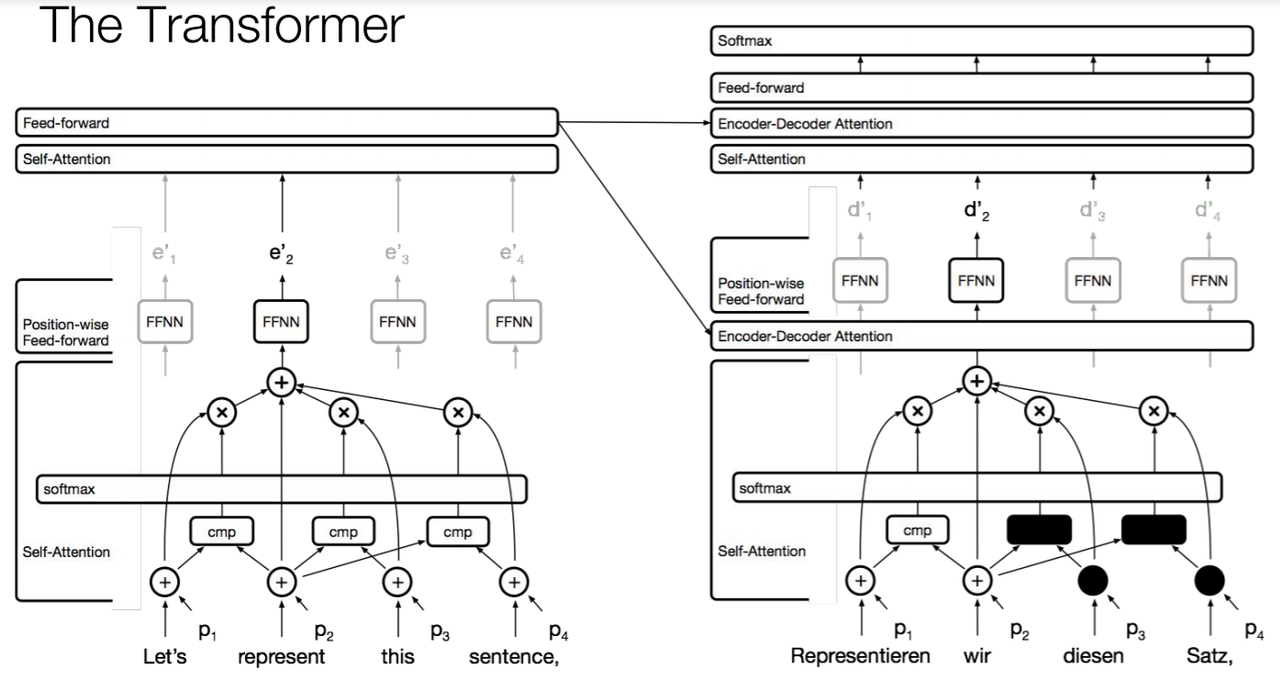
[CS224n] Lecture 9 : Self-Attention and Transformers
[2312.10726] Towards Compact 3D Representations via Point Feature ...
模型结构|解读transformer模型中三种attention和mask(一)_casual mask-CSDN博客
| Assignment on Masked Autoencoders (MAE) | | PPTX
对Transformer中的MASK理解_mask transformer-CSDN博客
Transformers - Part 7 - Decoder (2): masked self-attention - YouTube
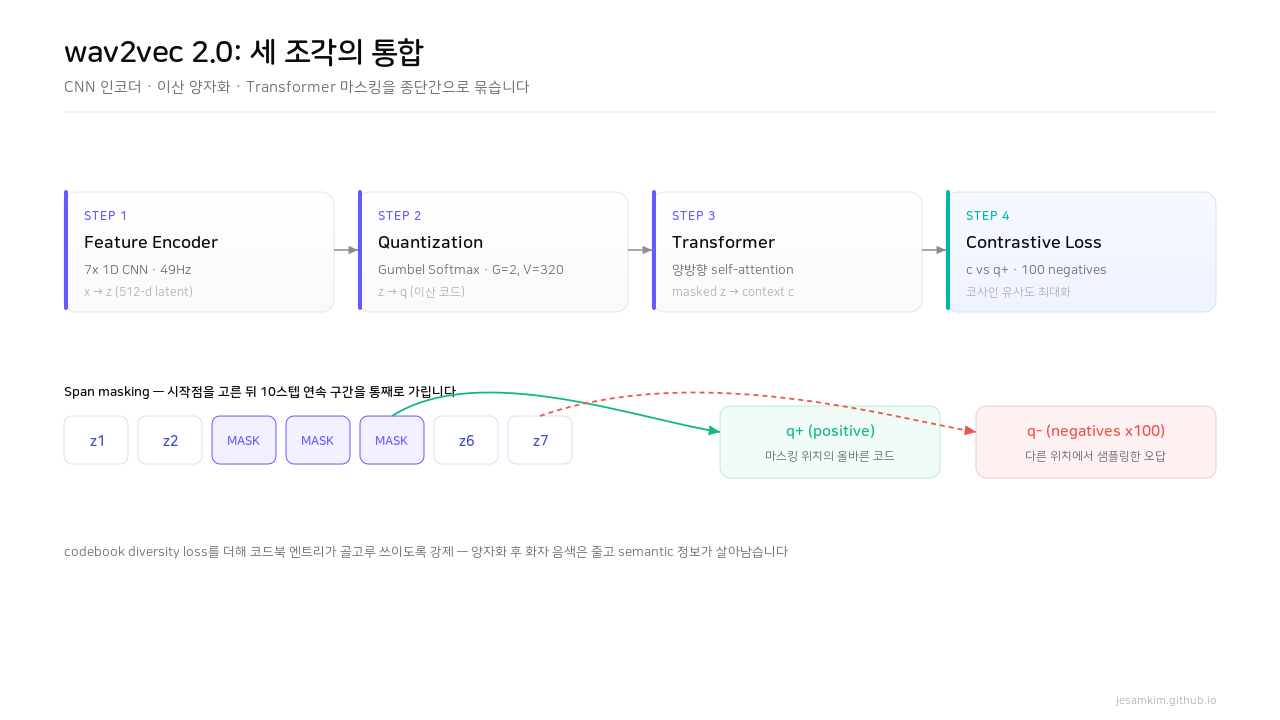
음성을 이해하고 만들기까지: SSL부터 Zero-Shot Voice Cloning으로 가는 길 | AI Tech Blog
P11机器学习--李宏毅笔记(Transformer Decoder)Testing部分_transformer decoder的输入 ...
解析Transformer Decoder掩码机制训练与评估方法-开发者社区-阿里云
Transformer学习笔记 | Palind's Blog
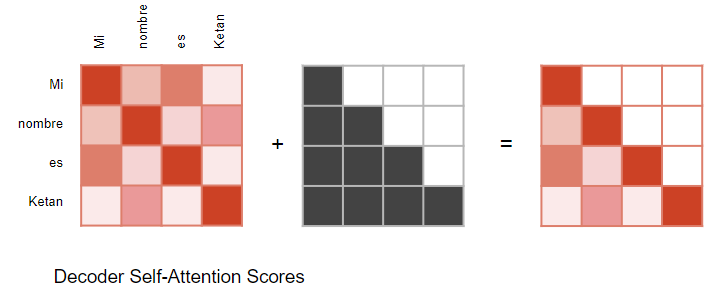
Transformers Explained Visually - How it works, step-by-step | Ketan ...
llm 参数量-计算量-显存占用分析 - Zhang
MAE (Masked Auto-Encoder)论文总结 - Picassooo - 博客园
Transformer万字深度解读(附PyTroch实现代码) | MLOasis
maskformer | Akshath Raghav R
Google Colab
深入理解Transformer中的解码器原理(Decoder)与掩码机制 - 技术栈
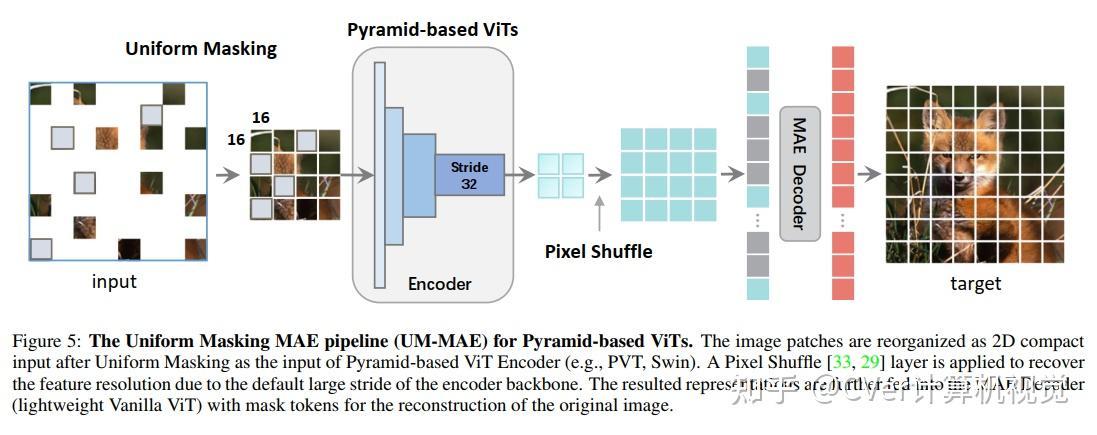
Uniform Masking:基于金字塔的视觉Transformer启用MAE预训练 - 知乎
一文解读Masked Autoencoder(MAE)-CSDN博客
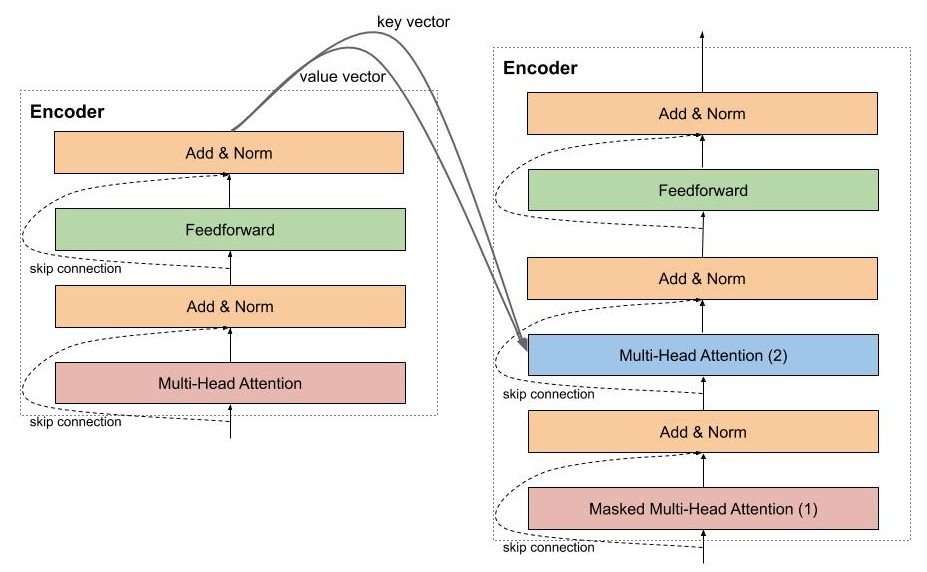
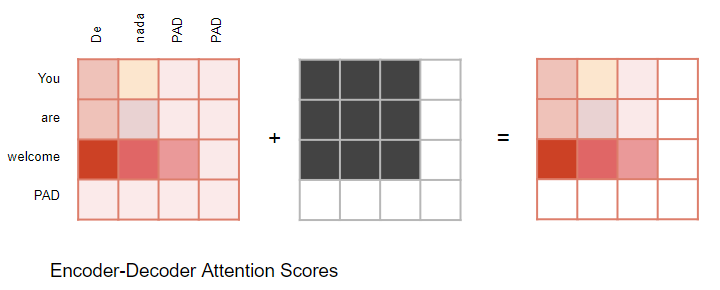
Cross-Attention: Connecting Encoder and Decoder in Transformers ...
transformer模型 - 小小臭妮 - 博客园
The graphical representation of Bidirectional encoder representations ...
Speeding up Inference in Transformers - RBC Borealis
What Is Kapton? Uses, Properties and High-Temperature Applications