Showing 120 of 120on this page. Filters & sort apply to loaded results; URL updates for sharing.120 of 120 on this page
Vision Transformer in Practice: From Patch Tokens to Scaling Laws | by ...
[论文评述] Less is more: Summarizing Patch Tokens for efficient Multi-Label ...
Moonstone: Wooded Patch Tokens – Gamers Village
ARAM Players To Start Earning Mastery Tokens After Patch 13.5 - The ...
Major Change Alert: VMware Patch Downloads Now Require Tokens – Angry Admin
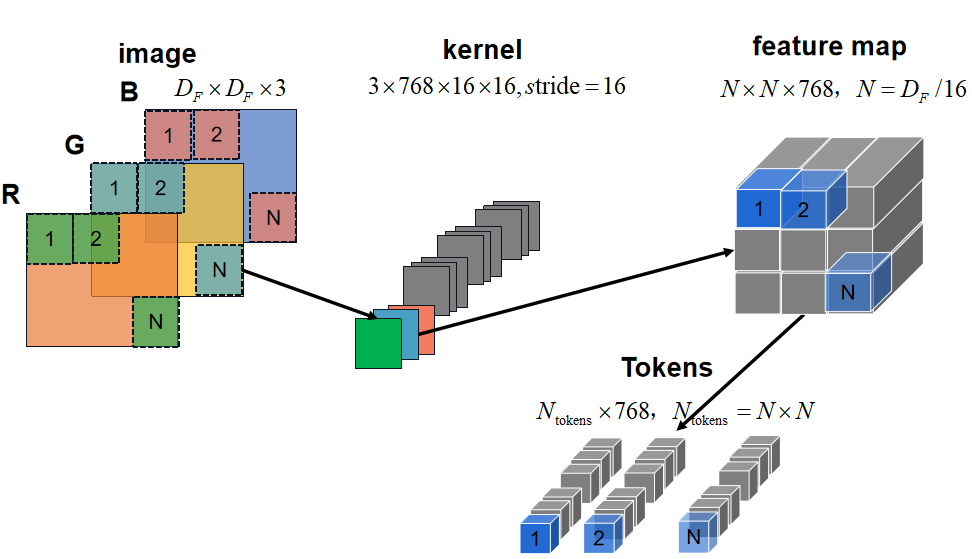
VisionTransformer(一)—— Embedding Patched与Word embedding及其实现_vit patch ...
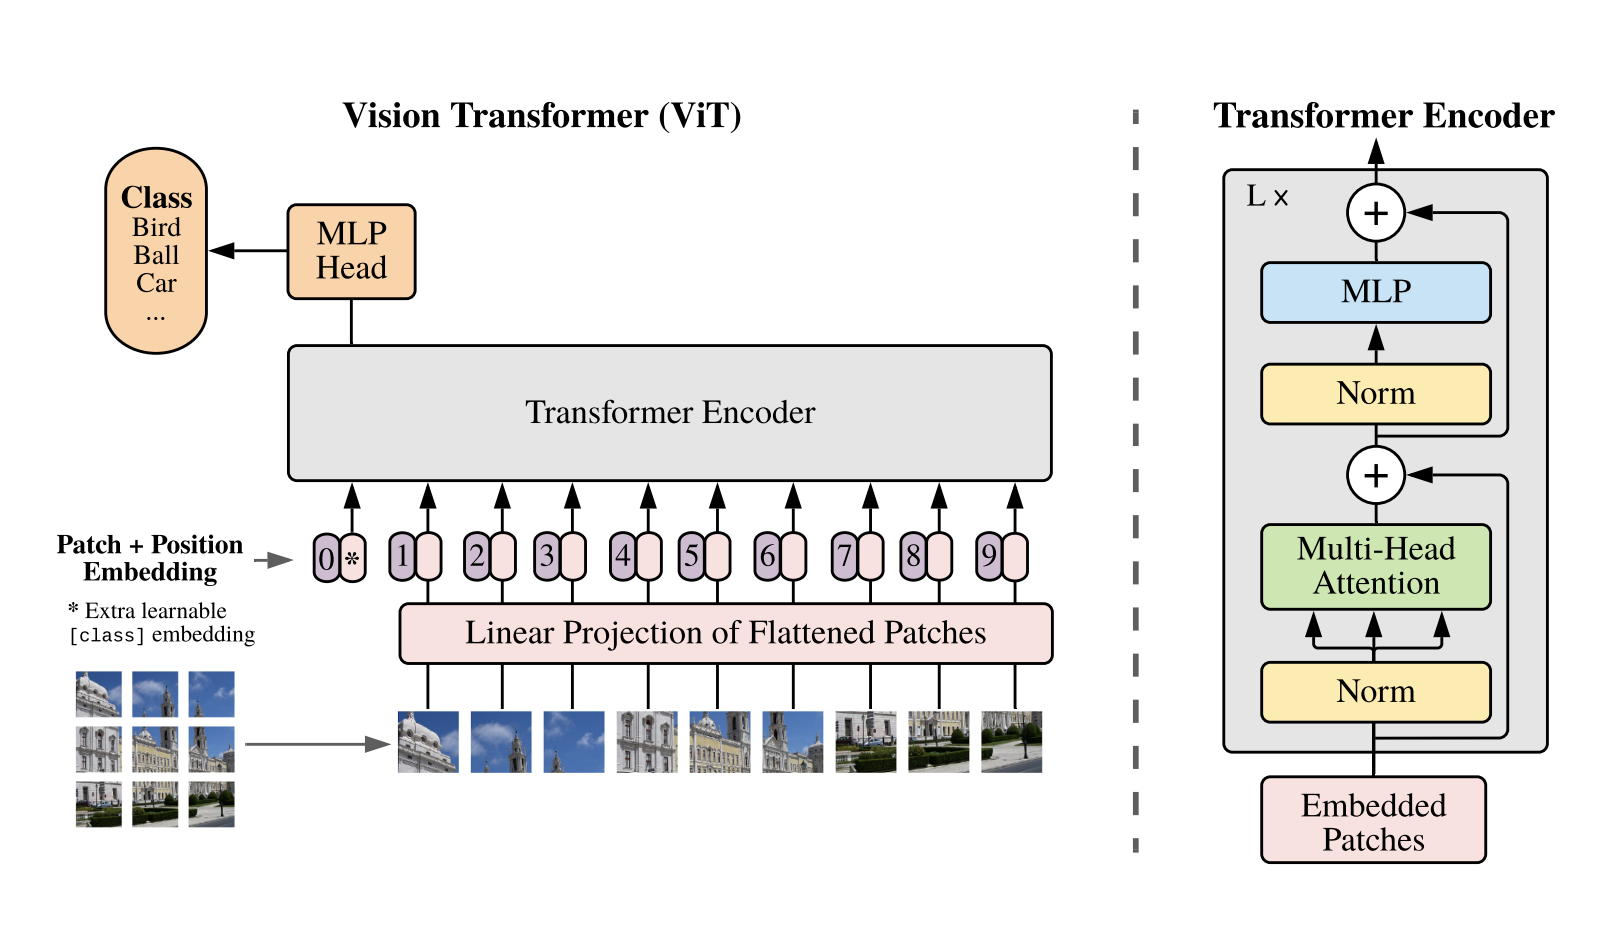
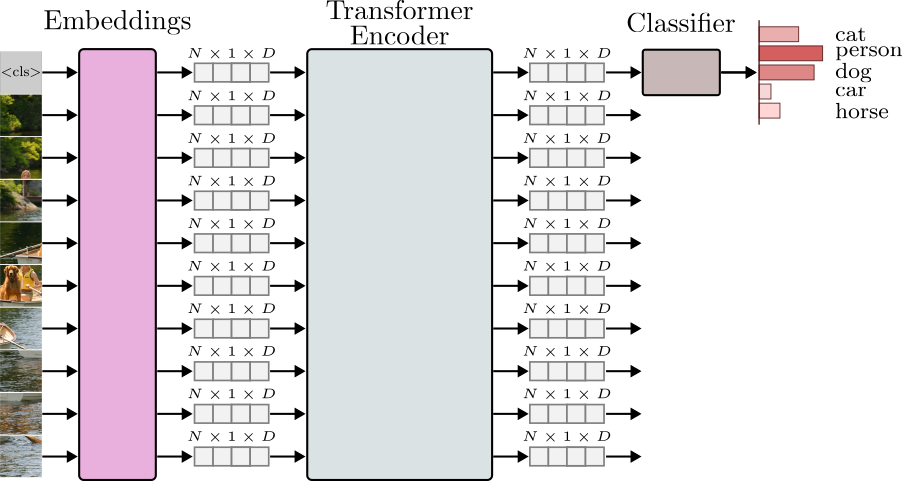
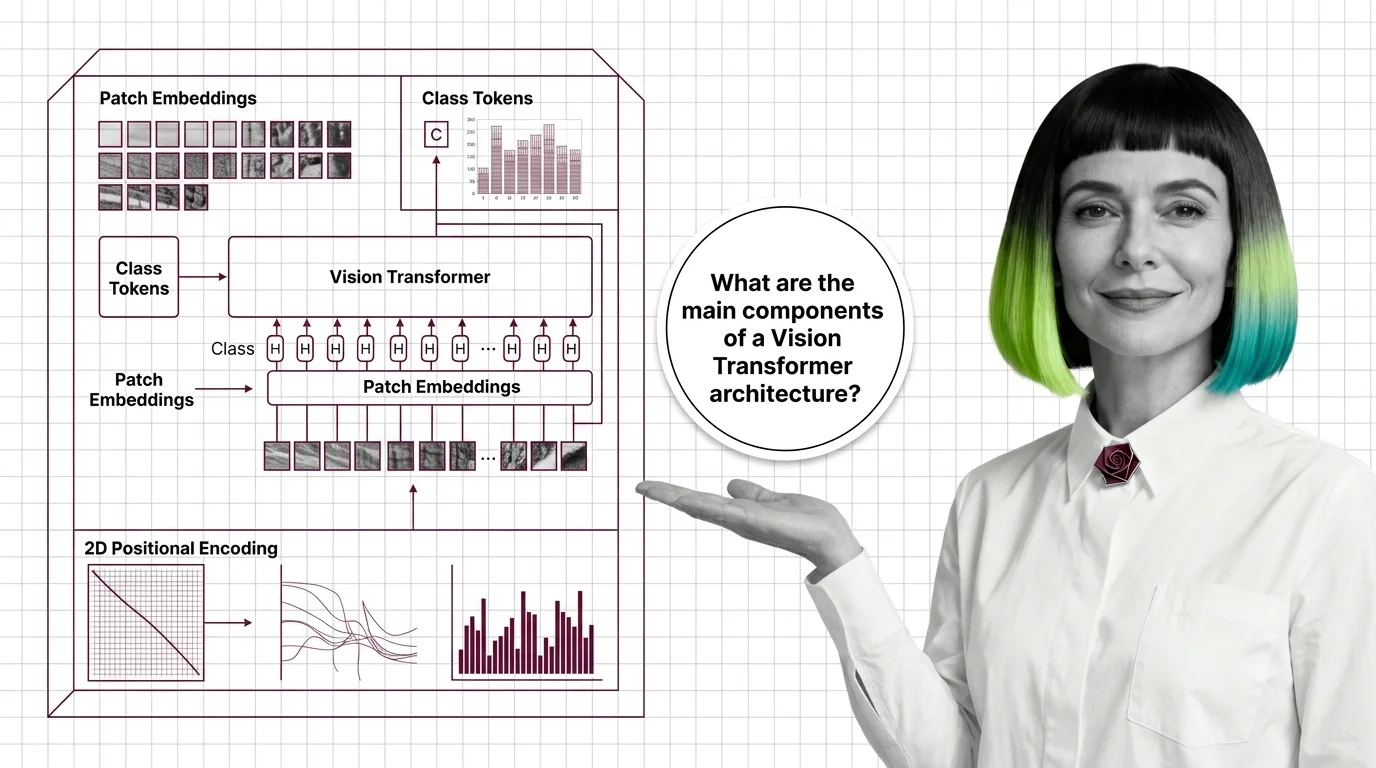
The vision transformer architecture. We take 16X16X16 size of tokens in ...
[论文评述] Unmute the Patch Tokens: Rethinking Probing in Multi-Label Audio ...
Unmute the Patch Tokens: Rethinking Probing in Multi-Label Audio ...
Left: Distances among input patch tokens. Each row/column represents ...
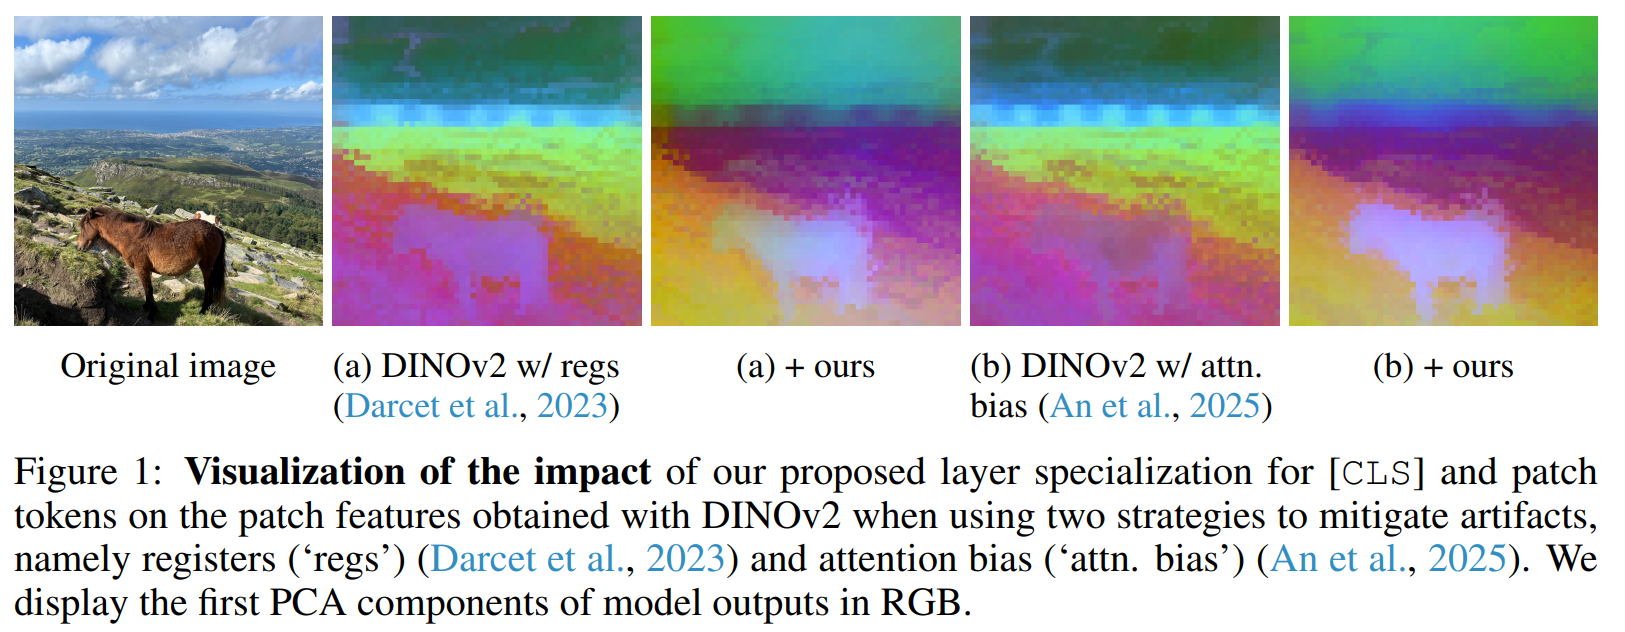
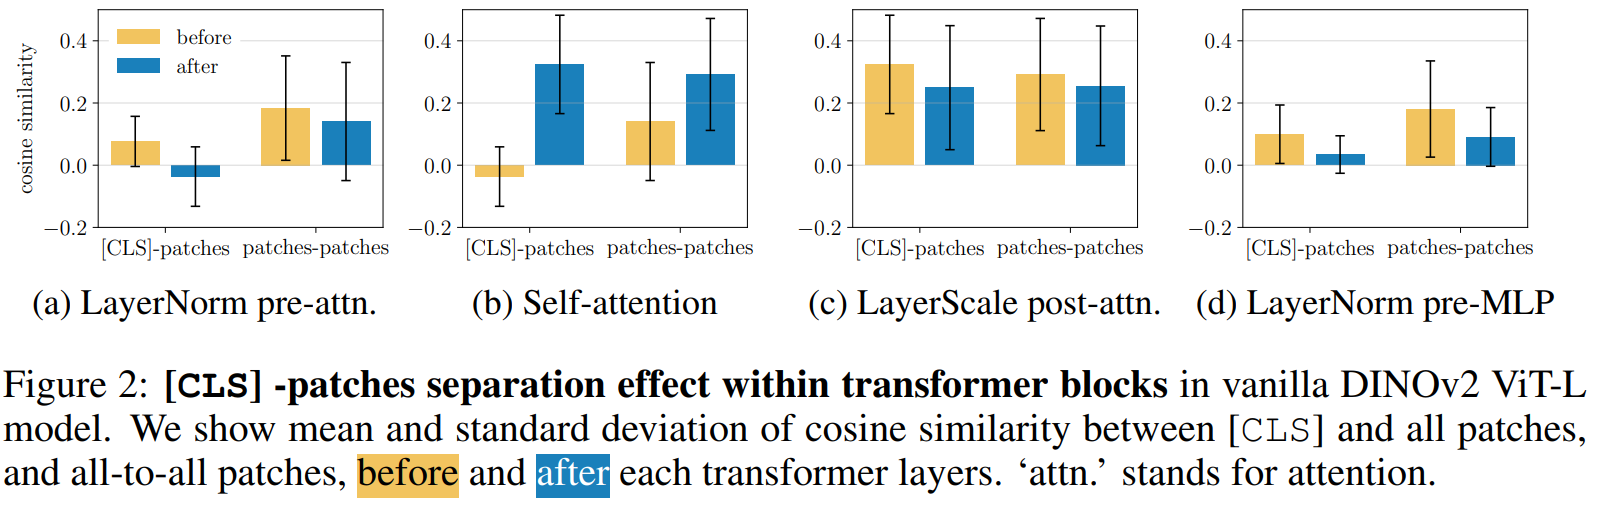
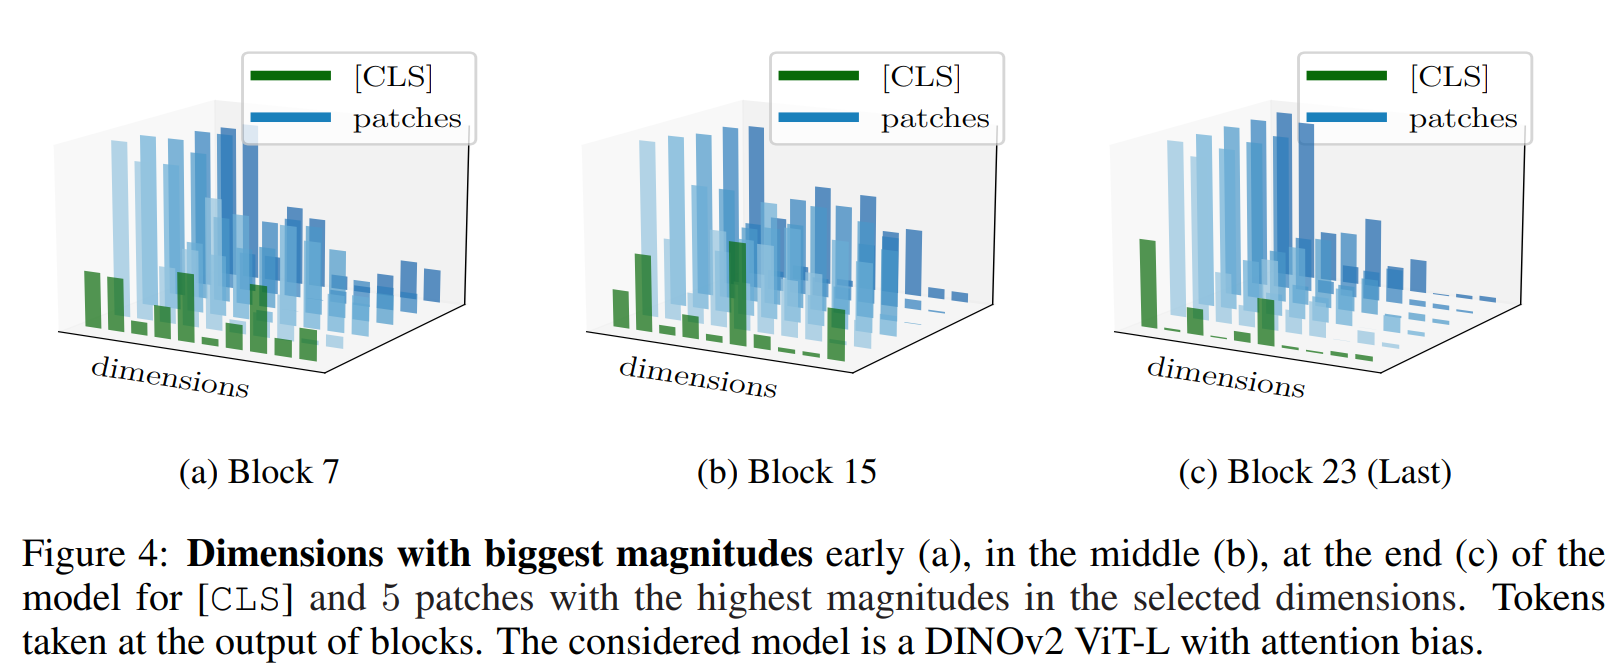
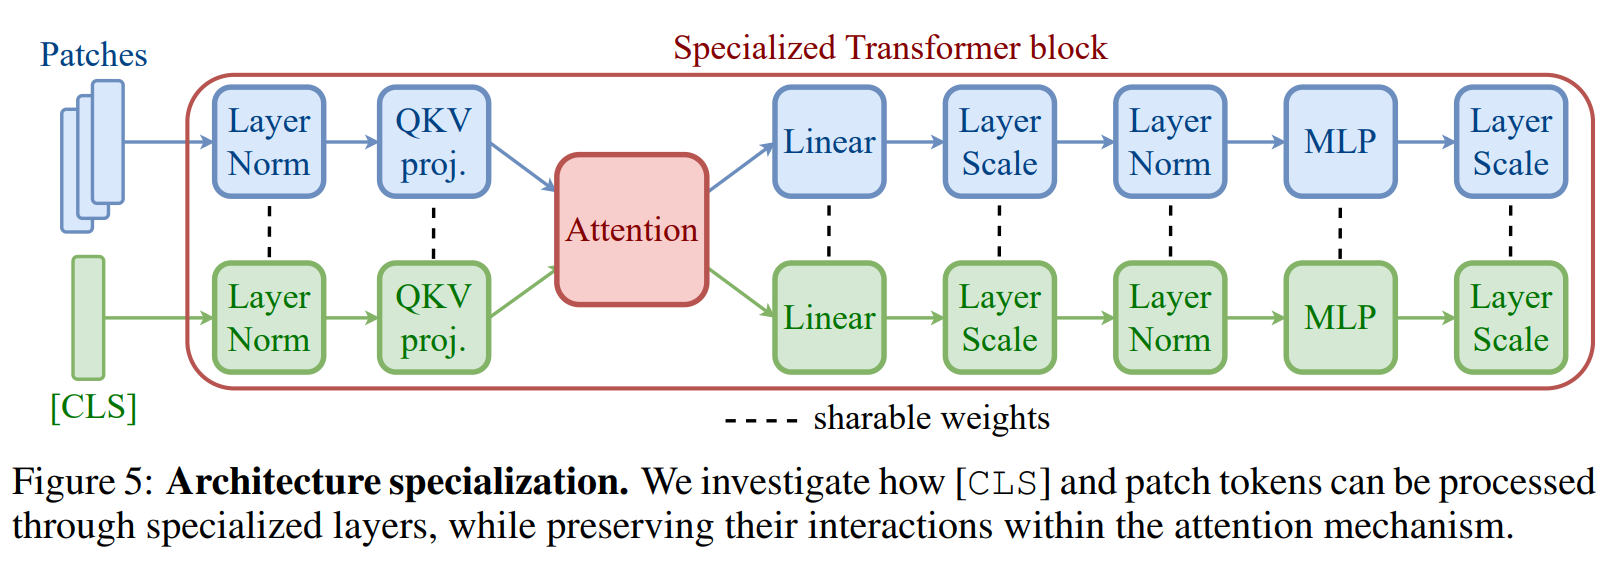
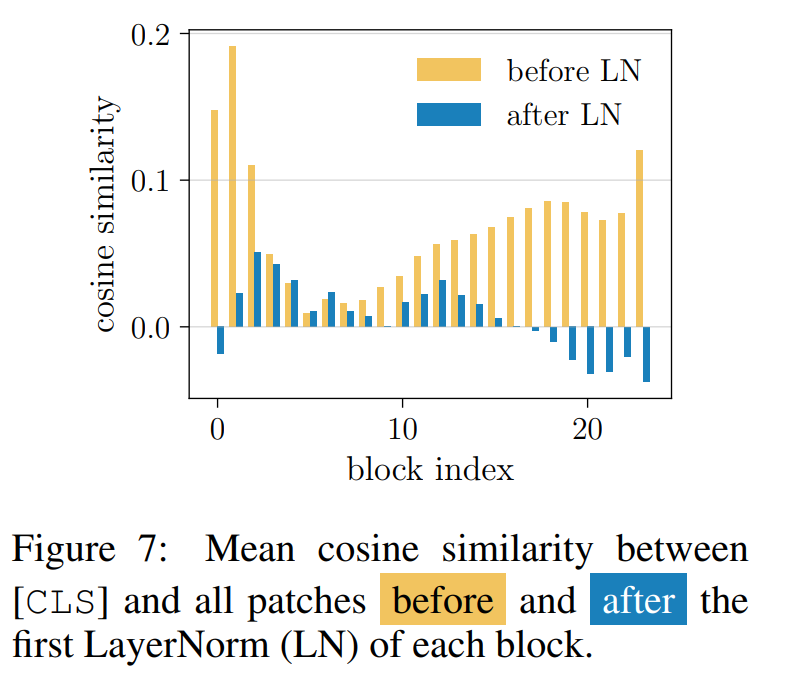
重新审视视觉Transformer中的[CLS]与Patch Token交互_revisiting [cls] and patch token ...
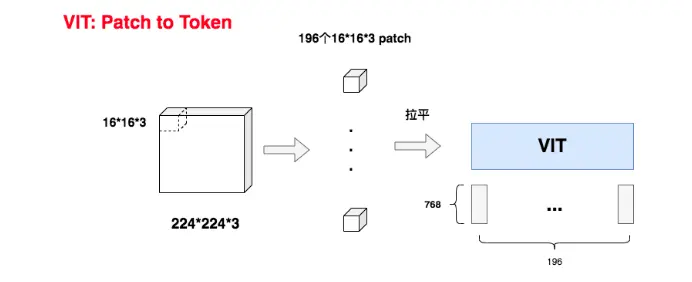
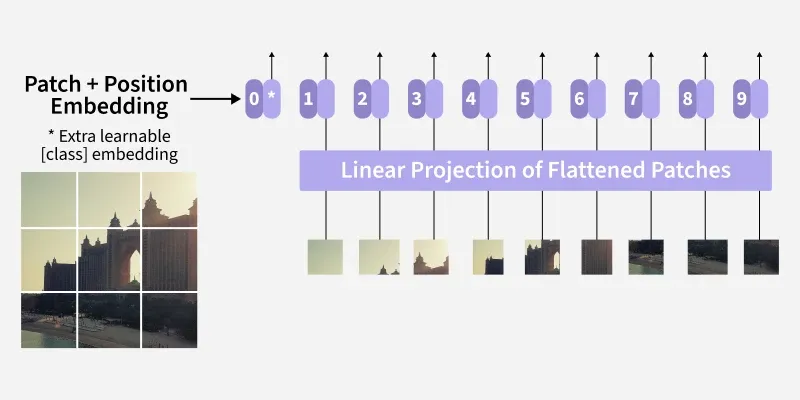
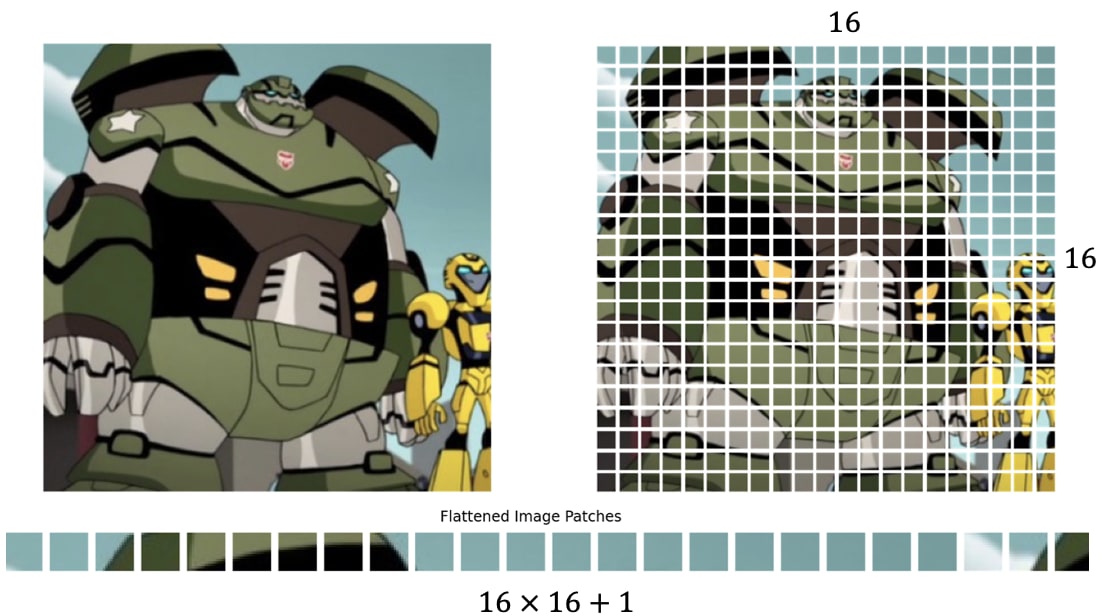
Vision Transformers Explained (Part 2): How Patches Become Tokens | by ...
TAP into the Patch Tokens: Leveraging Vision Foundation Model Features ...
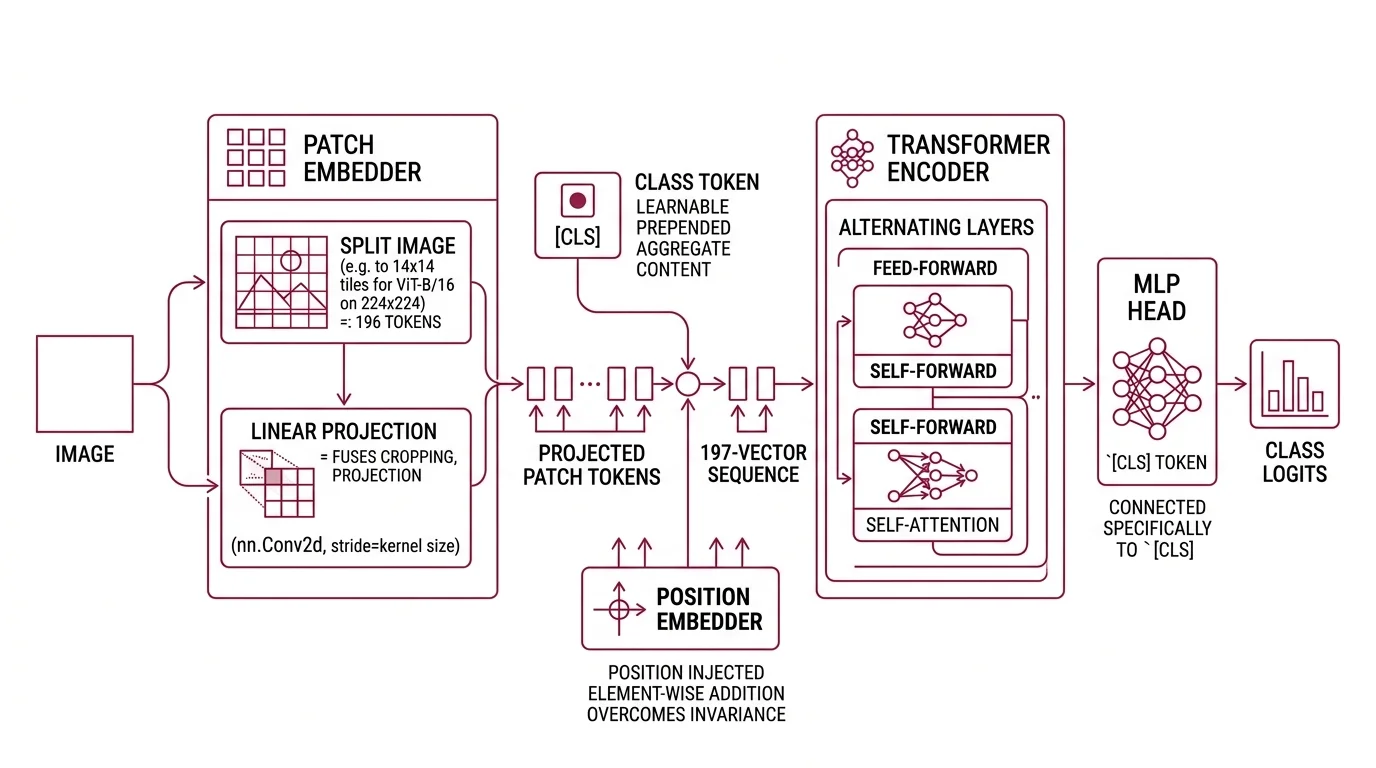
What Is a Vision Transformer? Patches to Tokens
How To Get Anniv Patch Token Free Fire (FF) - Esports
Cara Dapatkan Red Patch Token Free Fire (FF) – Esportsku
Tokens And Patches, 8+ Pieces | Property Room
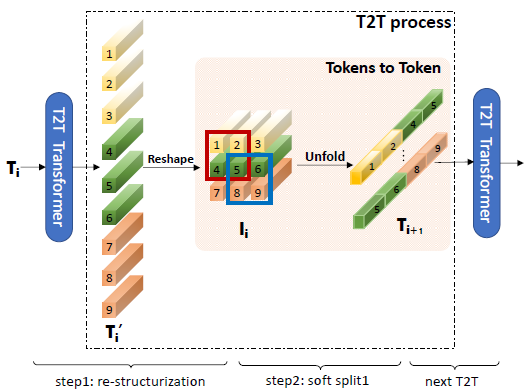
Token representation. (a) Pixel to token. (b) Patch to token. (c ...
SLEEP TOKEN -- Patch (1).jpg
Sleep Token Patch - Etsy Denmark
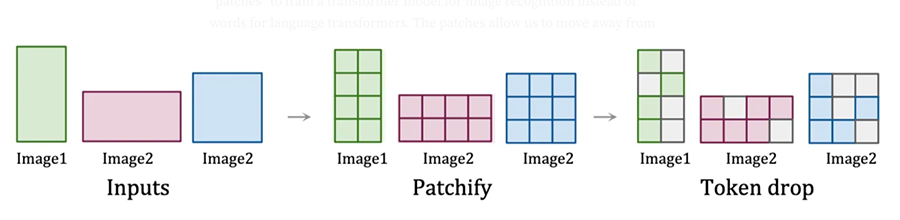
Transformers Everywhere - Patch Encoding Technique for Vision ...
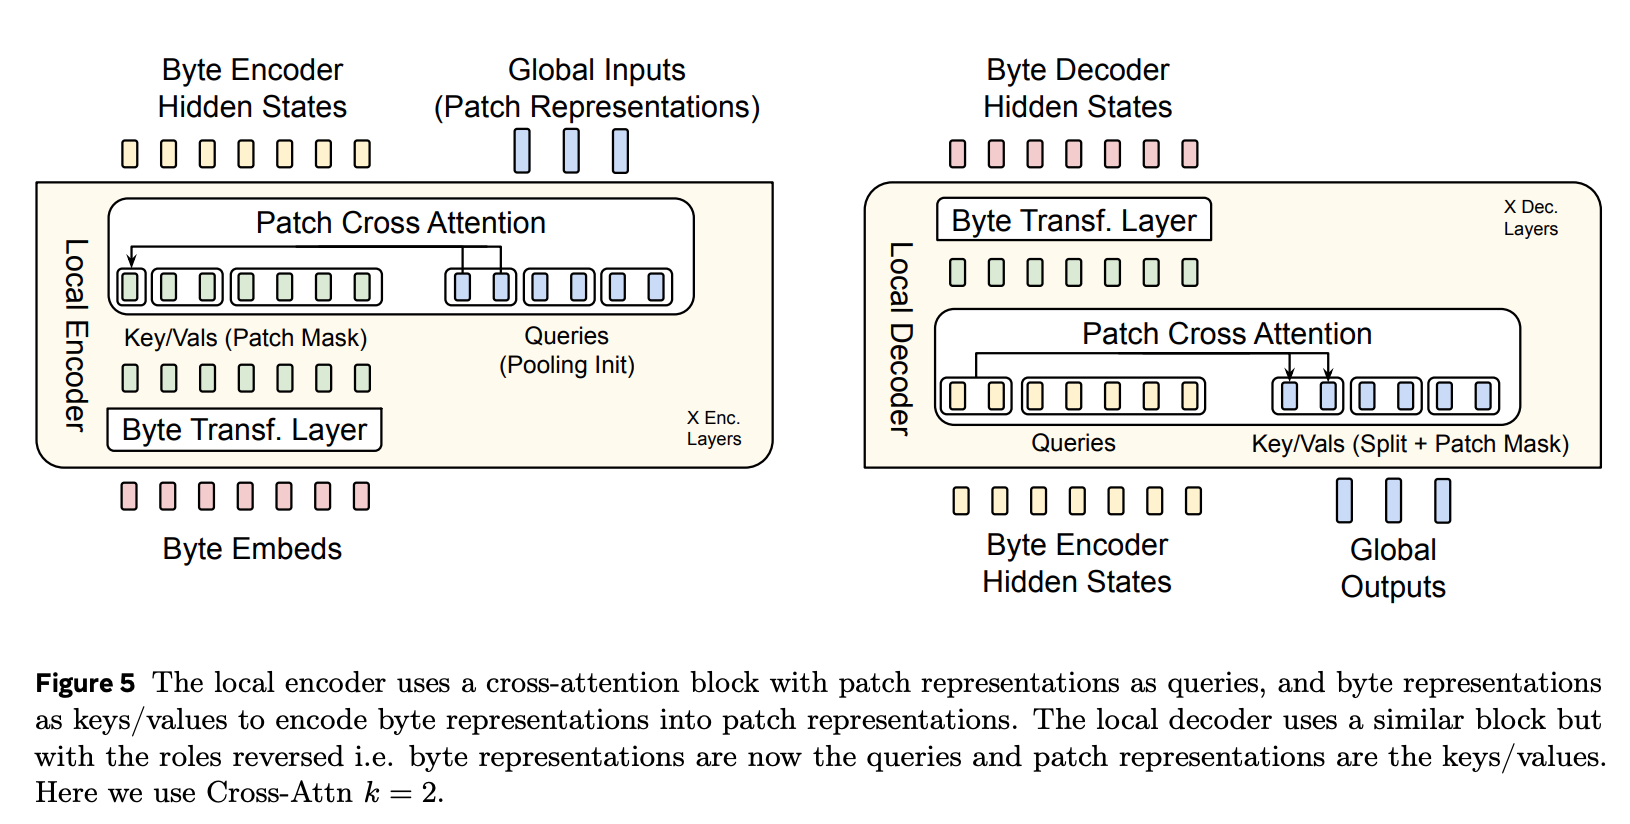
(논문 요약) Byte Latent Transformer; Patches Scale Better Than Tokens ...
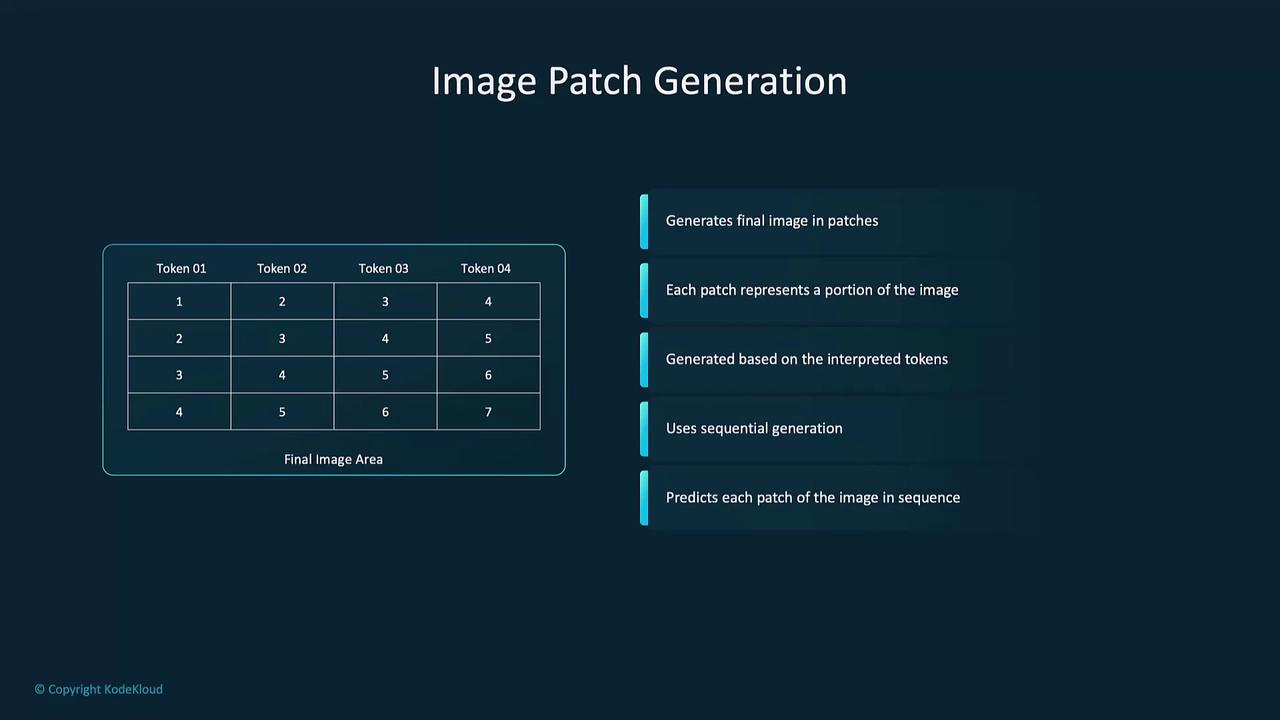
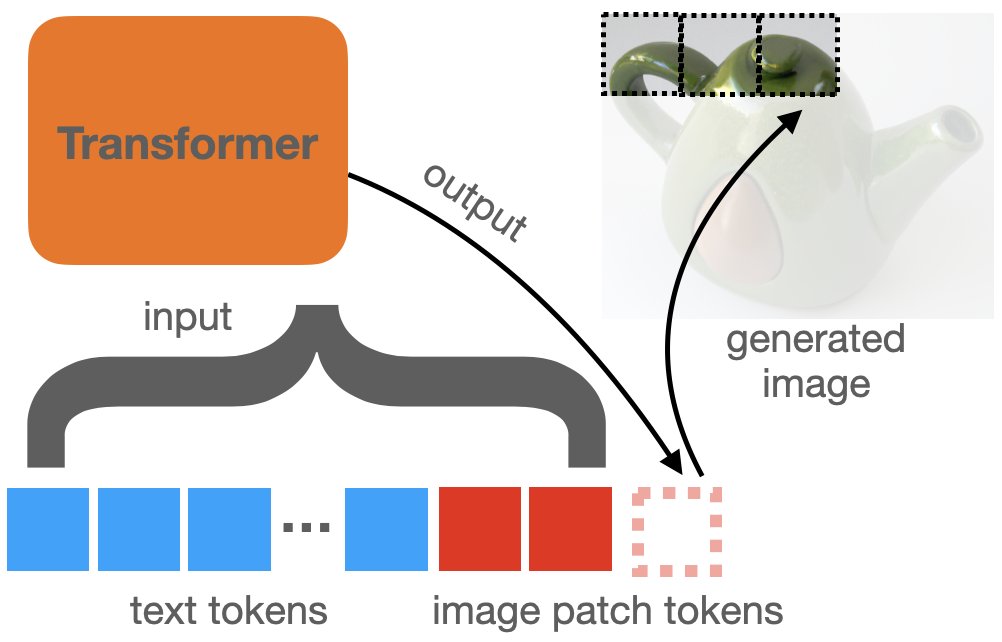
Figure 2 from Next Patch Prediction for Autoregressive Visual ...
Sol Patch Kids crypto project: patch token listings, events, analysis ...
Sleep Token Hypnosis Patch Rock Band Mascot Woven Sew-On – Patch Collection
LaVergne Amusement Park Token – GHOST PATCH
ViT的若干细节 | Swift's Blog
transformer中patch与token?_transformer token-CSDN博客
Model overview of a vision transformer. An input image is split into ...
Sora AI: Zugriff und Verwendung (mit Beispielen)
视觉Transformer(Vision Transformer) - 郑之杰的个人网站
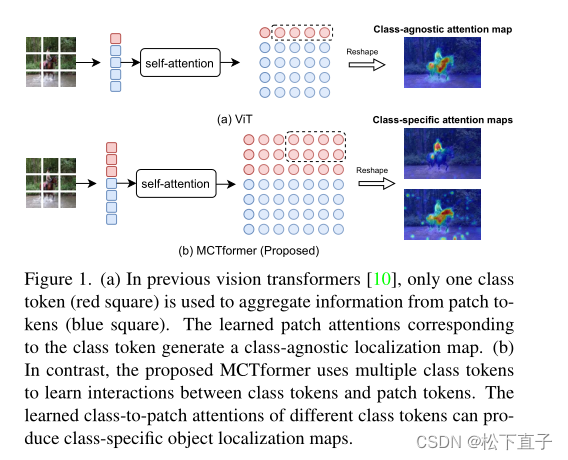
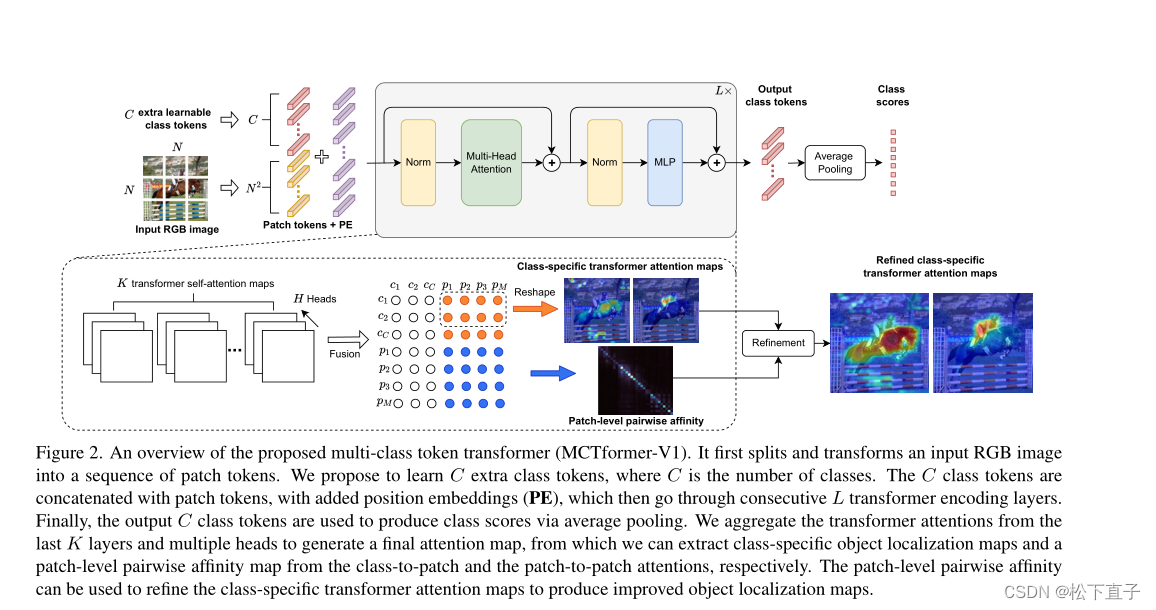
【论文阅读】《Multi-class Token Transformer for Weakly Supervised Semantic ...
Token Contrast for Weakly-Supervised Semantic Segmentation —— CVPR2023 - 知乎
用于弱监督语义分割的多类token transformer_multi-class token transformer for weakly ...
重新审视视觉Transformer中的[CLS]与Patch Token交互 - 技术栈
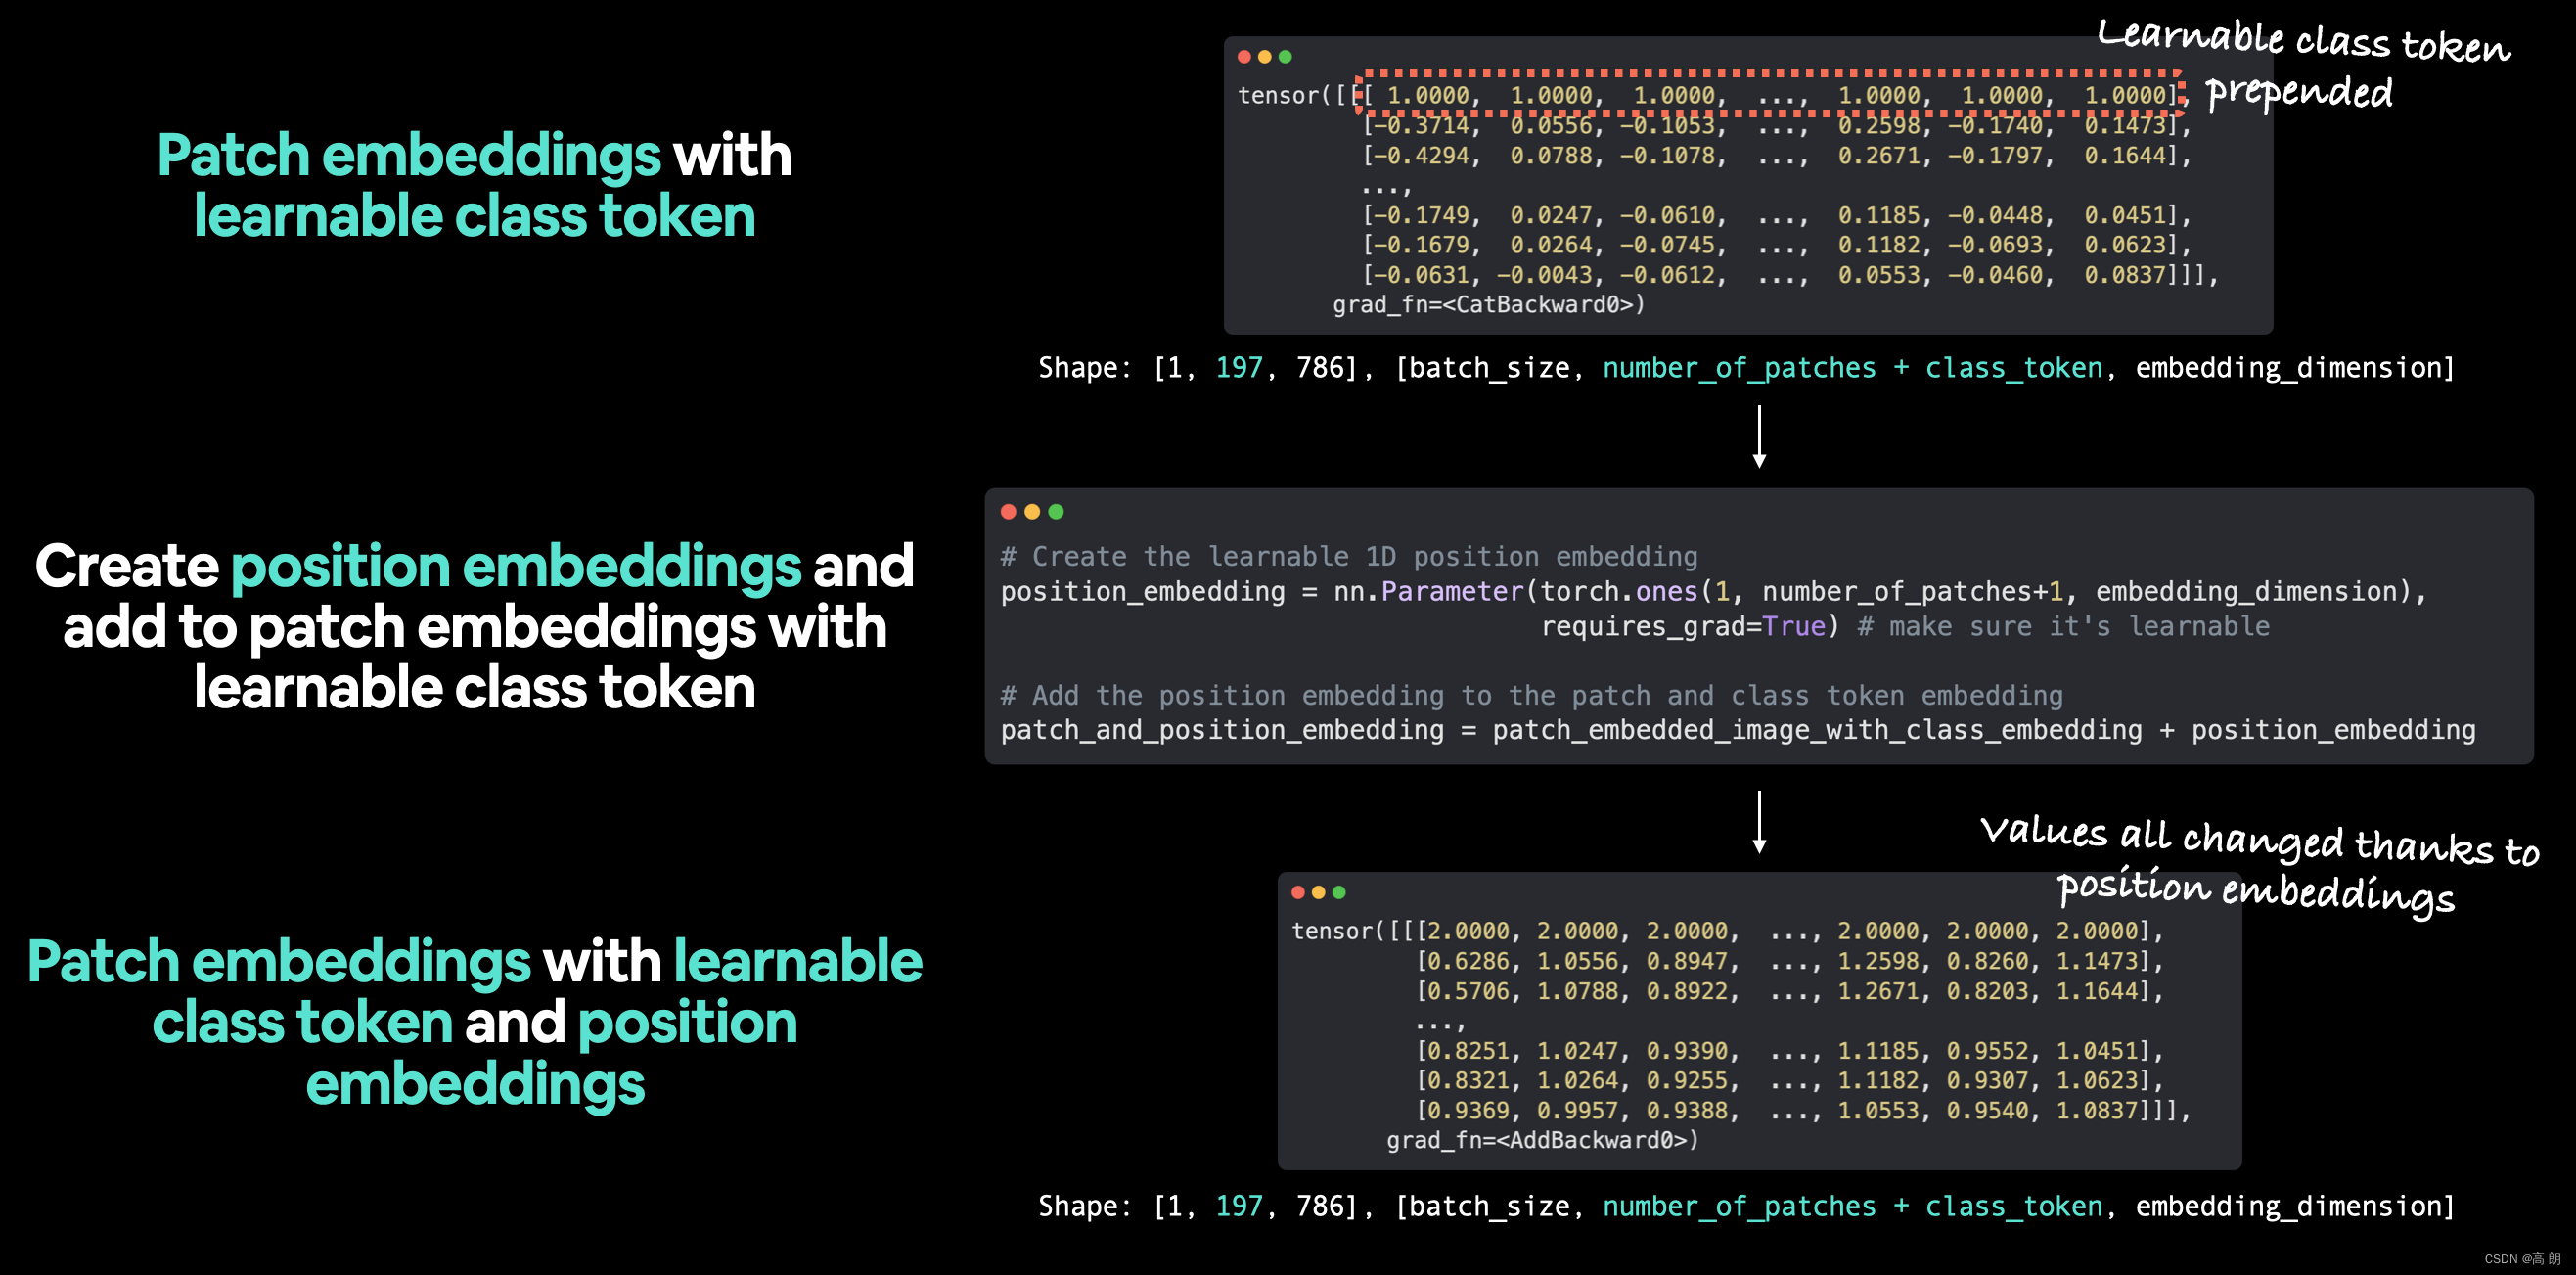
CV中token、Patch Embedding、positional encoding的概念(多模态、ViT、Transformer)-CSDN博客
Vision Transformer in PyTorch
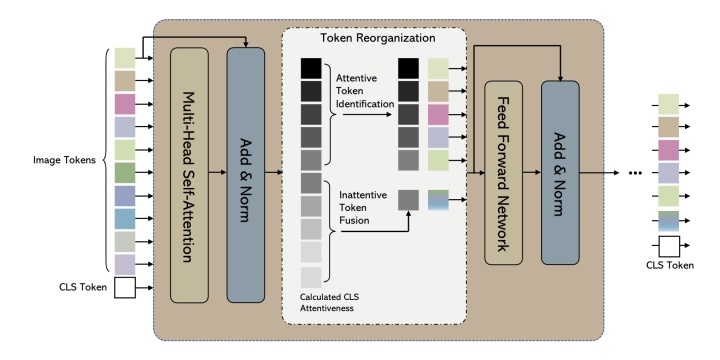
【简读】EViT: Expediting Vision Transformers Via Token Reorganizations - 知乎
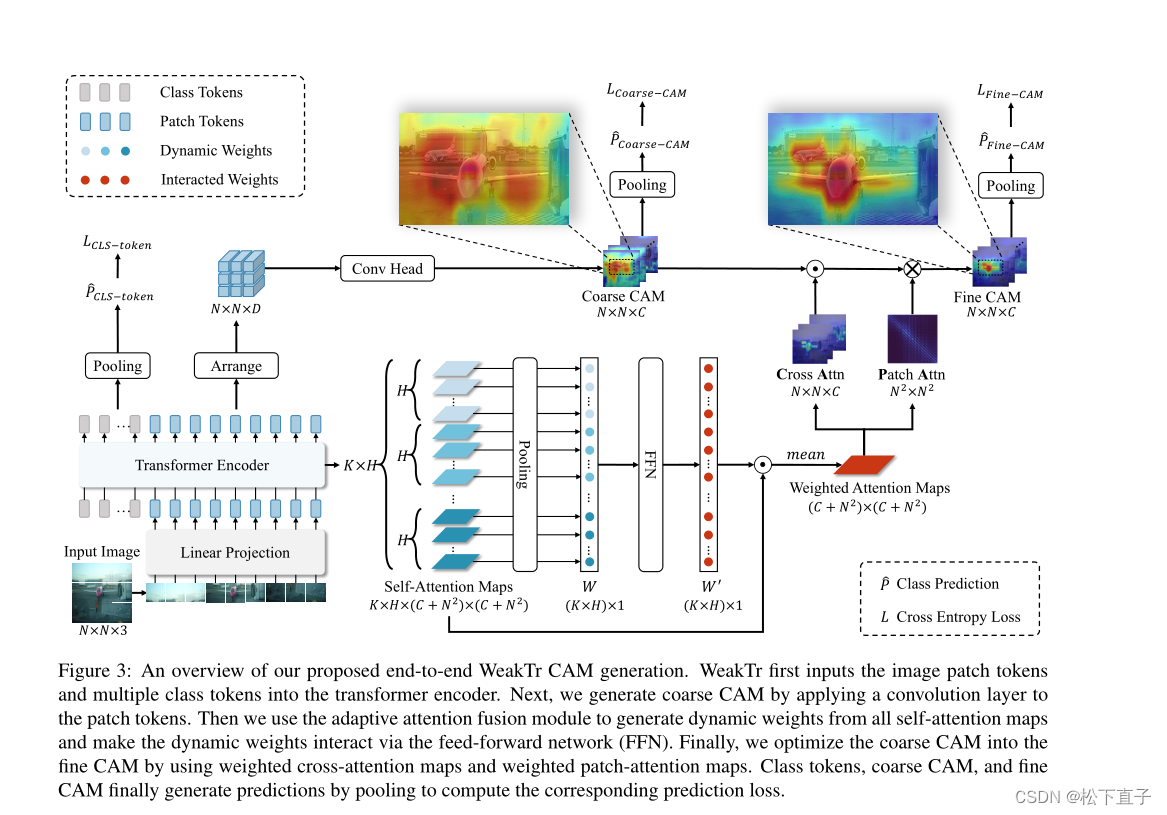
WeakTr阅读笔记-CSDN博客
Full article: Scene-level buildings damage recognition based on Cross ...
The overall architecture of TSD. First, a convolutional token embedding ...
ViT模型中的tokens和patches概念辨析_vit token-CSDN博客
Vision Transformer 超详细解读 (原理分析+代码解读) (十五) - 知乎
From Vision Transformer Paper to code
【Pytorch】论文复现 Vision Transformer (ViT)_vit复现-CSDN博客
【图像分类】【深度学习】【Pytorch版本】VisionTransformer模型算法详解_vit算法-CSDN博客
【论文精读】BEIT:Pre-Training of Image Transformer - 知乎
Molmo VLM AI: Paper Explanation and Demo Applications - Ai2
Patch-as-Decodable-Token: Towards Unified Multi-Modal Vision Tasks in ...
Vision Transformer (ViT) 代码实现PyTorch版本 - 知乎
An Intuitive Introduction to the Vision Transformer - Thalles' blog
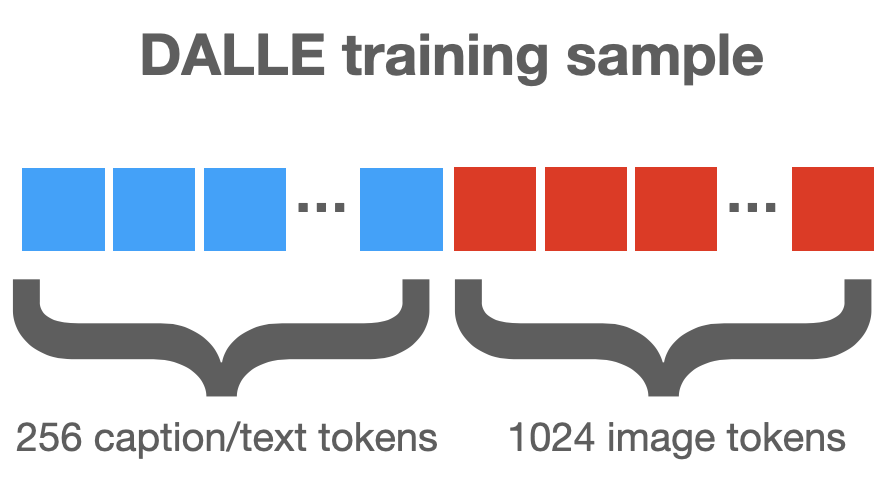
Understanding DALL E Text to Image Generation - KodeKloud
VD3D: Taming Large Video Diffusion Transformers for 3D Camera Control
图解+代码 Swin Transformer 1: W-MSA和Patch Merging - 知乎
batch, patch, token,iteration, epoch分别是什么?_patch token-CSDN博客
1.一脚踹进ViT——Pytorch搭建ViT框架_pytorch vit-CSDN博客
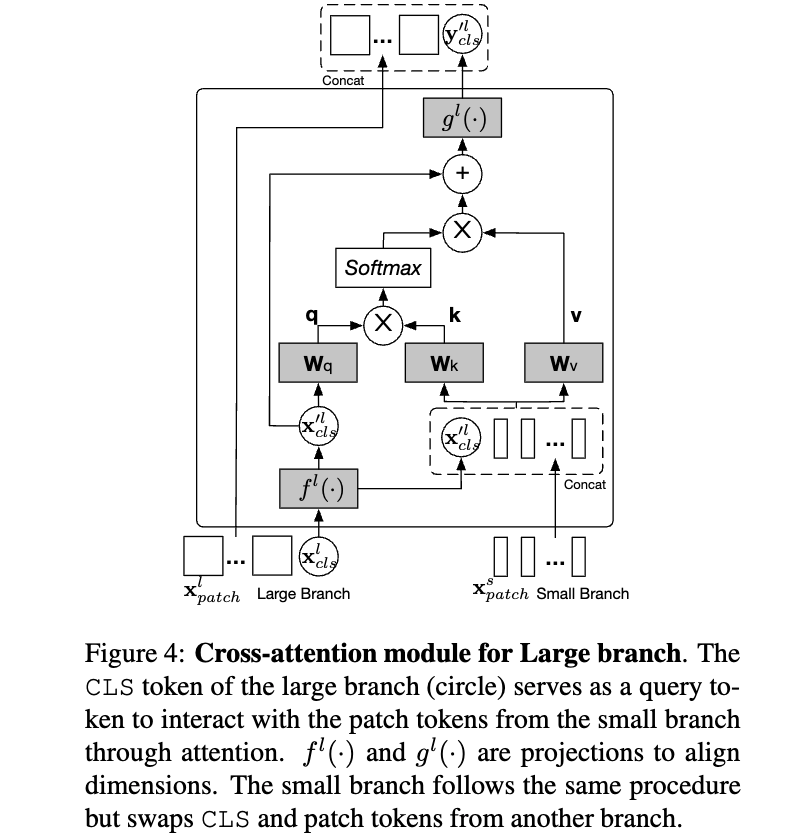
ICCV2021 MIT-IBM开源:Transformer走向多分支、多尺度_token
Thread by @tomgoldsteincs on Thread Reader App – Thread Reader App
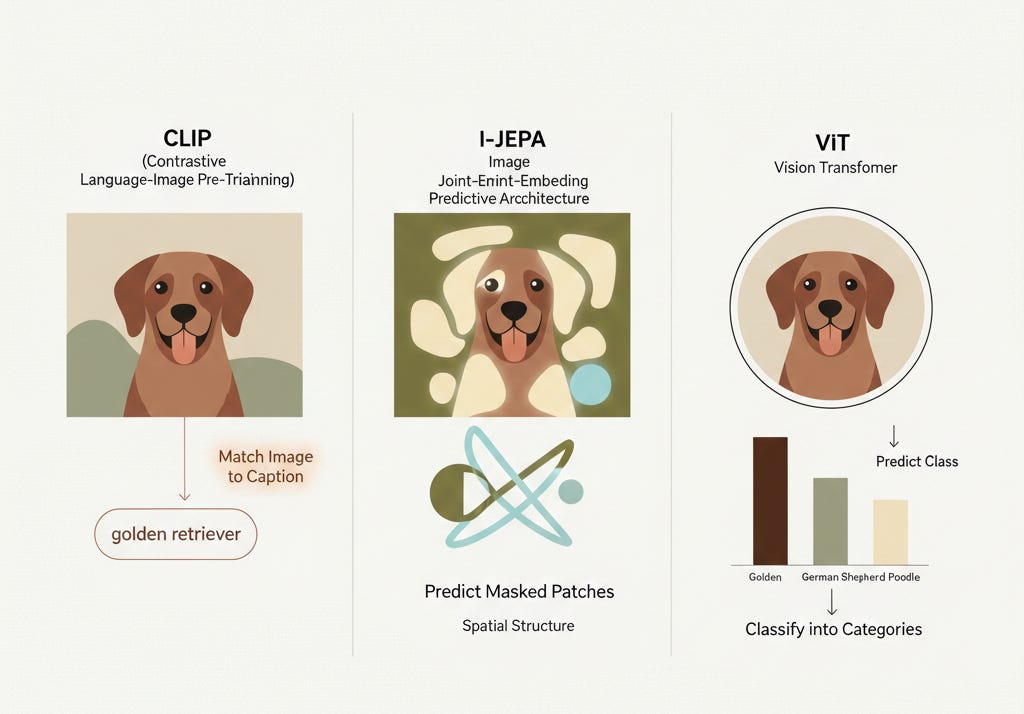
Vision-Language Models & CLIP | LeetLLM
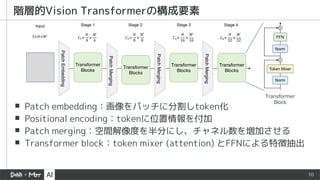
近年のHierarchical Vision Transformer | PPTX
LLM_log #009: An Image is Worth 16×16 Words — From Transformers to ...
[논문 리뷰]_Vision Transformer for small size datasets
Vision Transformer (ViT) Architecture - GeeksforGeeks
Vision Transformers and Image Encoders | LeetLLM
一文细数 73 个 Vision transformer 家族成员-极市开发者社区
Understanding Multimodal LLMs – by Sebastian Raschka, PhD – Amyris ...
TransMIL_MIL文献阅读(1)_transmil实现-CSDN博客
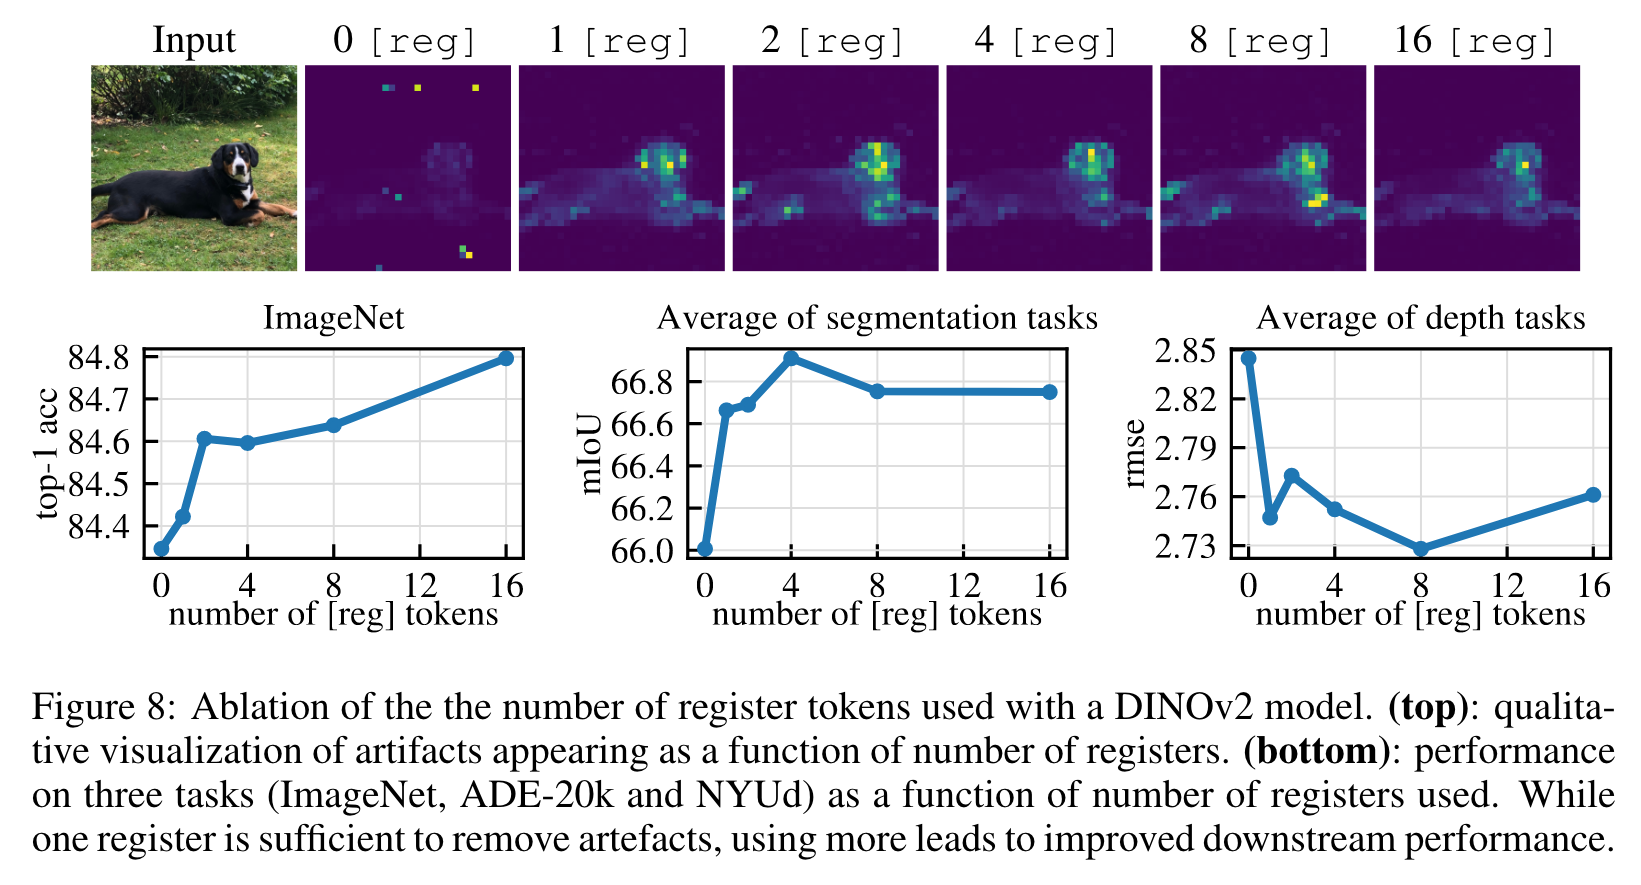
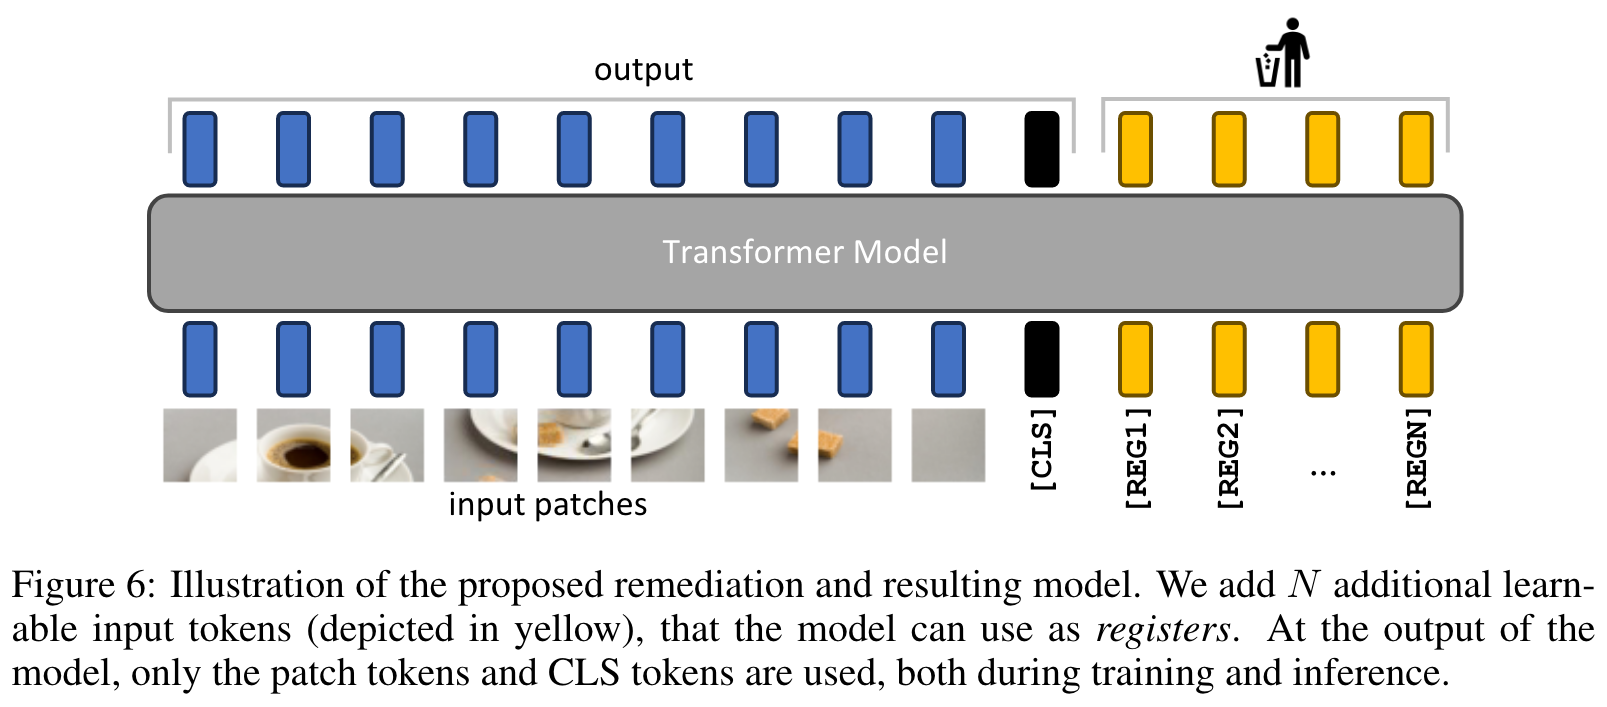
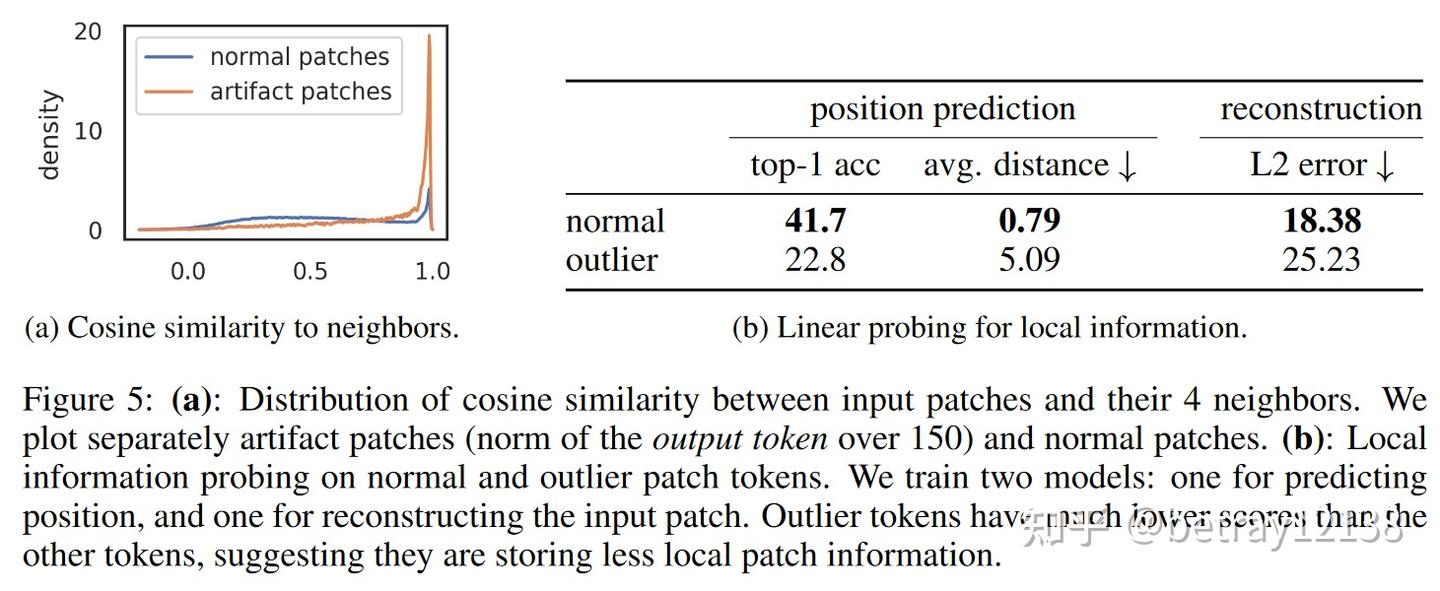
Vision Transformers Need Registers | Qiang Zhang
Equi-ViT: Rotational Equivariant Vision Transformer for Robust ...
Stitching Vision into LLMs: A Comparative Analysis of Embedding Spaces
[2021 ICCV] CrossViT: Cross-Attention Multi-Scale Vision Transformer ...
CogVLA: Cognition-Aligned Vision-Language-Action Model via Instruction ...
The Mythos We Have At Home: A Patch-Diffing Pipeline for N-Day ...
How To Compute The Token Consumption Of Vision Transformers? » ML Digest
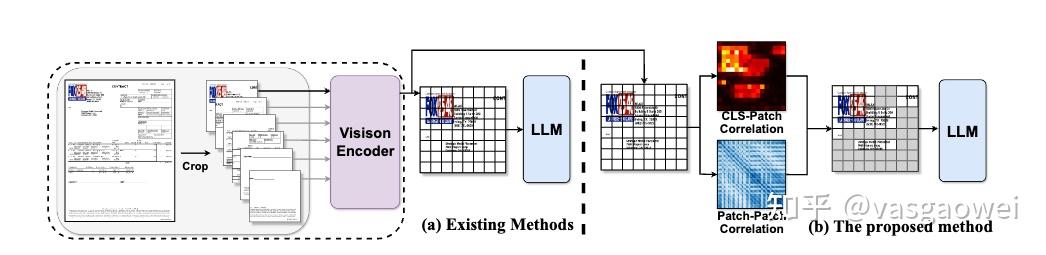
TokenCorrCompressor:Token级别相关性引导的视觉Token压缩 - 知乎
Token Refinement Module when used with the self-ensemble helps align ...
Token Contrast for Weakly-Supervised Semantic Segmentation —— CVPR2023 ...
Vision Transformers Explained at Hunter Berry blog
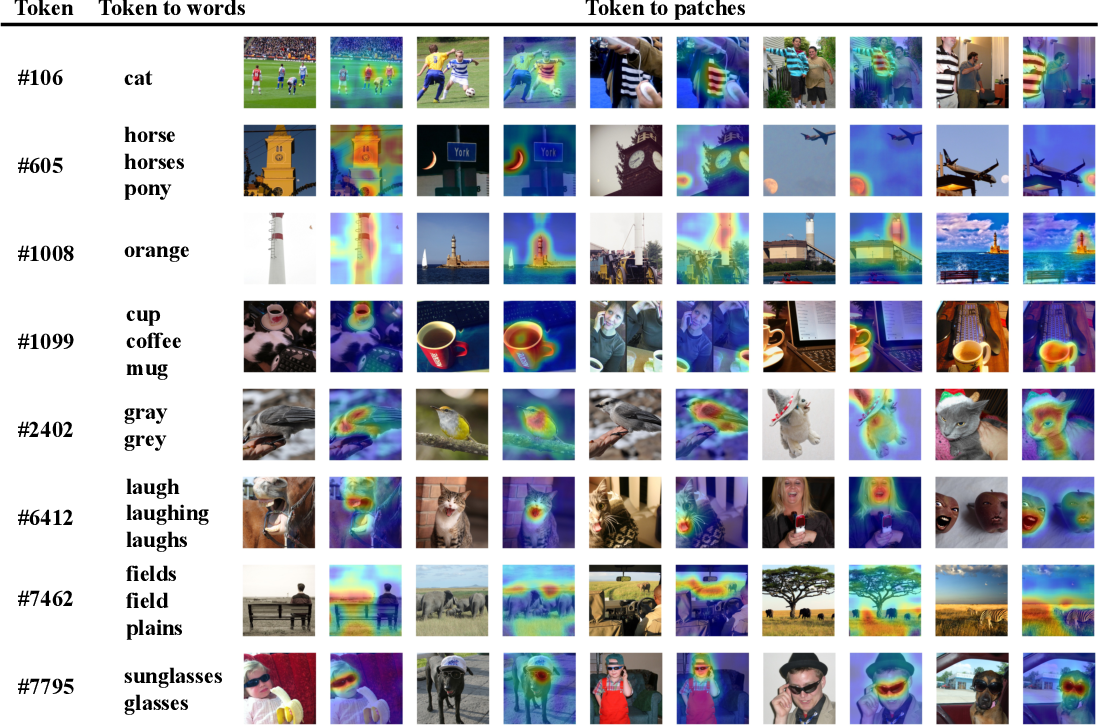
ViQ: text-aligned visual tokens, quantized at any image resolution ...
Figure 6 from Revisiting Multimodal Representation in Contrastive ...
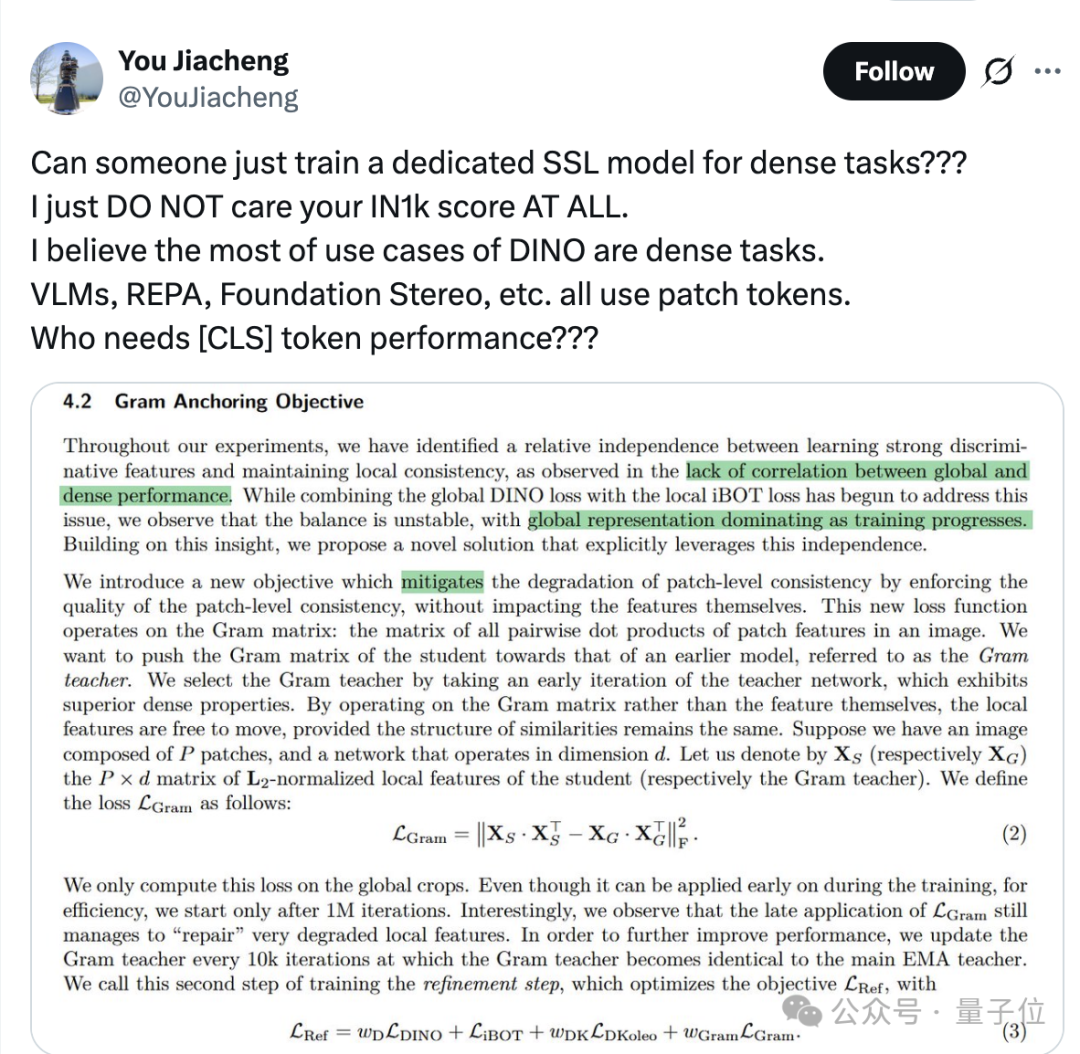
推特吵架吵出篇论文!谢赛宁团队新作iREPA只要3行代码 - 知乎
Token Merging. (a) With ToMe, similar patches are merged in each ...
Digitized and Embroidered myself a Sleep Token Patch! : r/SleepToken
复现篇:Vision Transform复现及讲解_vision transformer论文代码复现-CSDN博客
Illustration of the crop method in Figure 3. | Download Scientific Diagram
【论文阅读】Masked Autoencoders Are Effective Tokenizers for Diffusion Models ...
Deep learning image classification strategy. (a) ViT model architecture ...
What Is a Vision Transformer? How ViT Works
Vision Transformers, Explained | Towards Data Science
Synchronous Inhibition and Activation for Weakly Supervised Semantic ...
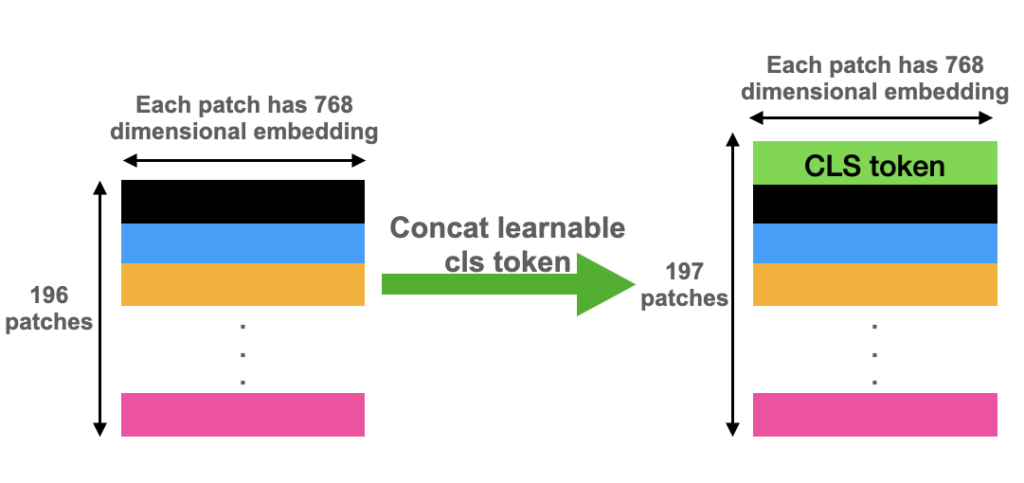
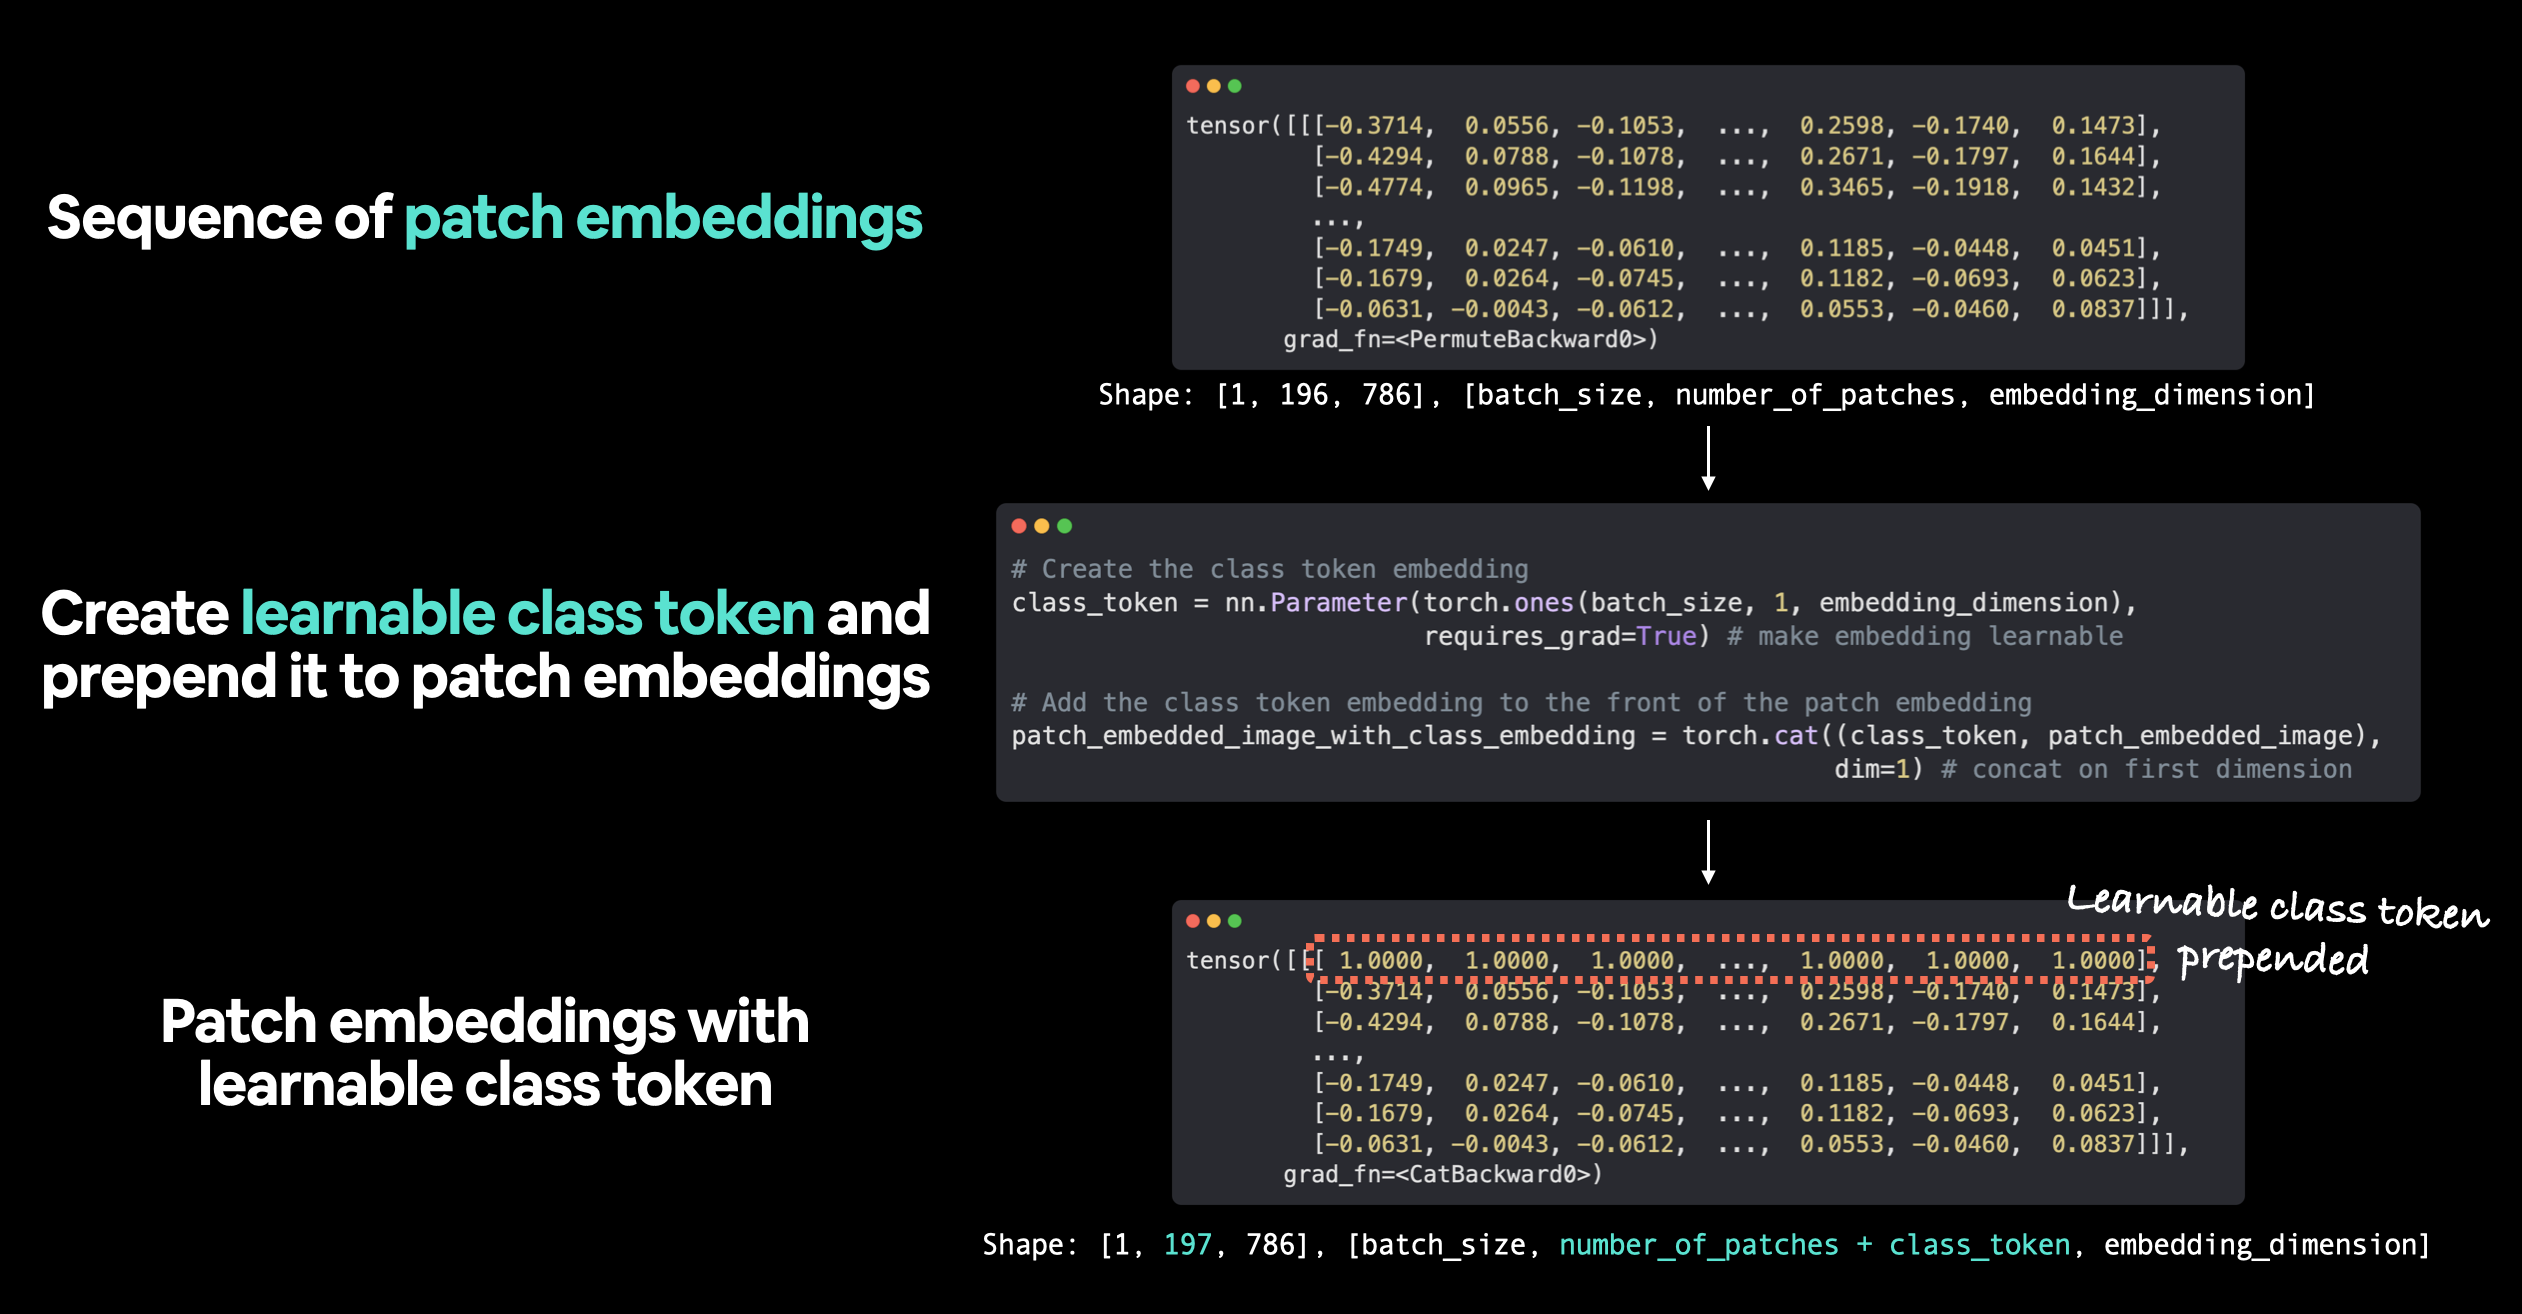
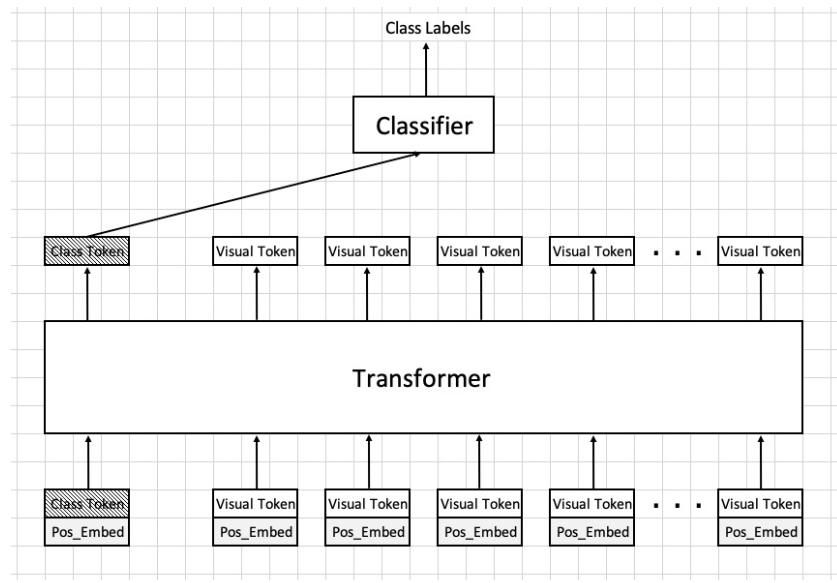
Vit Cls Token : Understanding the Vision Transformer and Counting Its ...
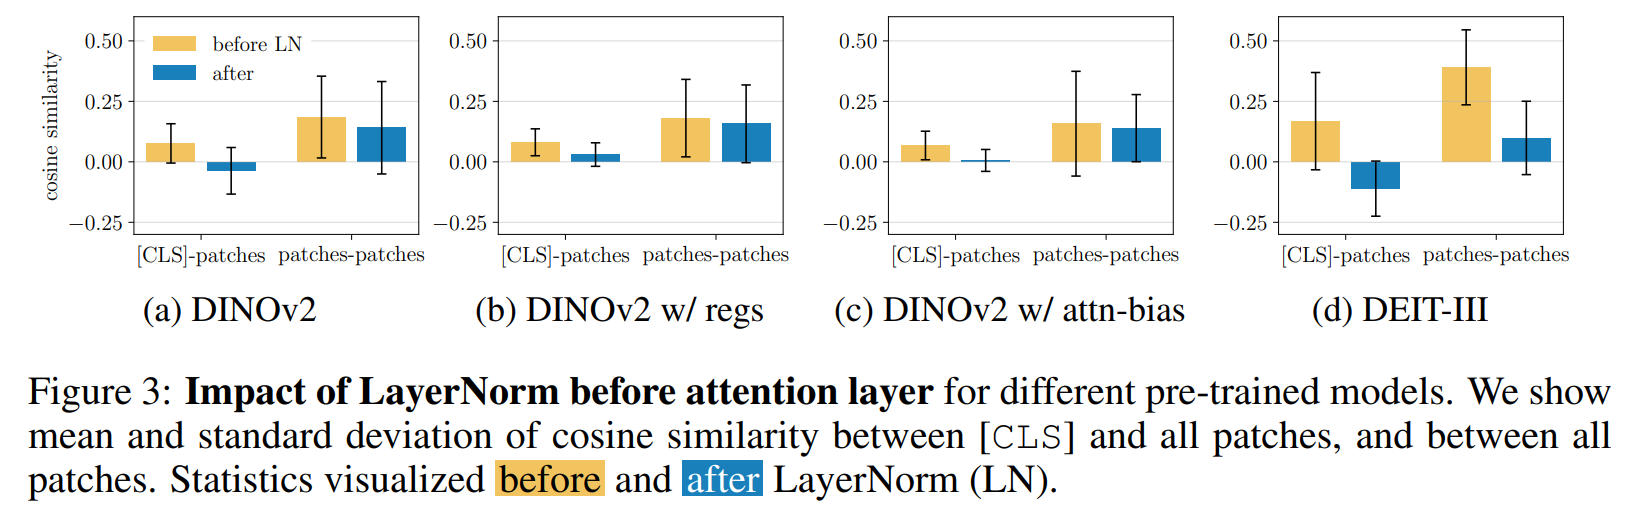
VISION TRANSFORMERS NEED REGISTERS - 知乎
Towards Multimodal Interpretability: Learning Sparse Interpretable ...
Figure 1 from ParFormer: Vision Transformer Baseline with Parallel ...
How to Train a Vision Transformer (ViT) from Scratch | Towards Data Science
Curia: A Multi-Modal Foundation Model for Radiology | AI Research Paper ...
[论文阅读] MIM | CCViT:基于 Patches 质心重建的 MIM 框架 - 知乎
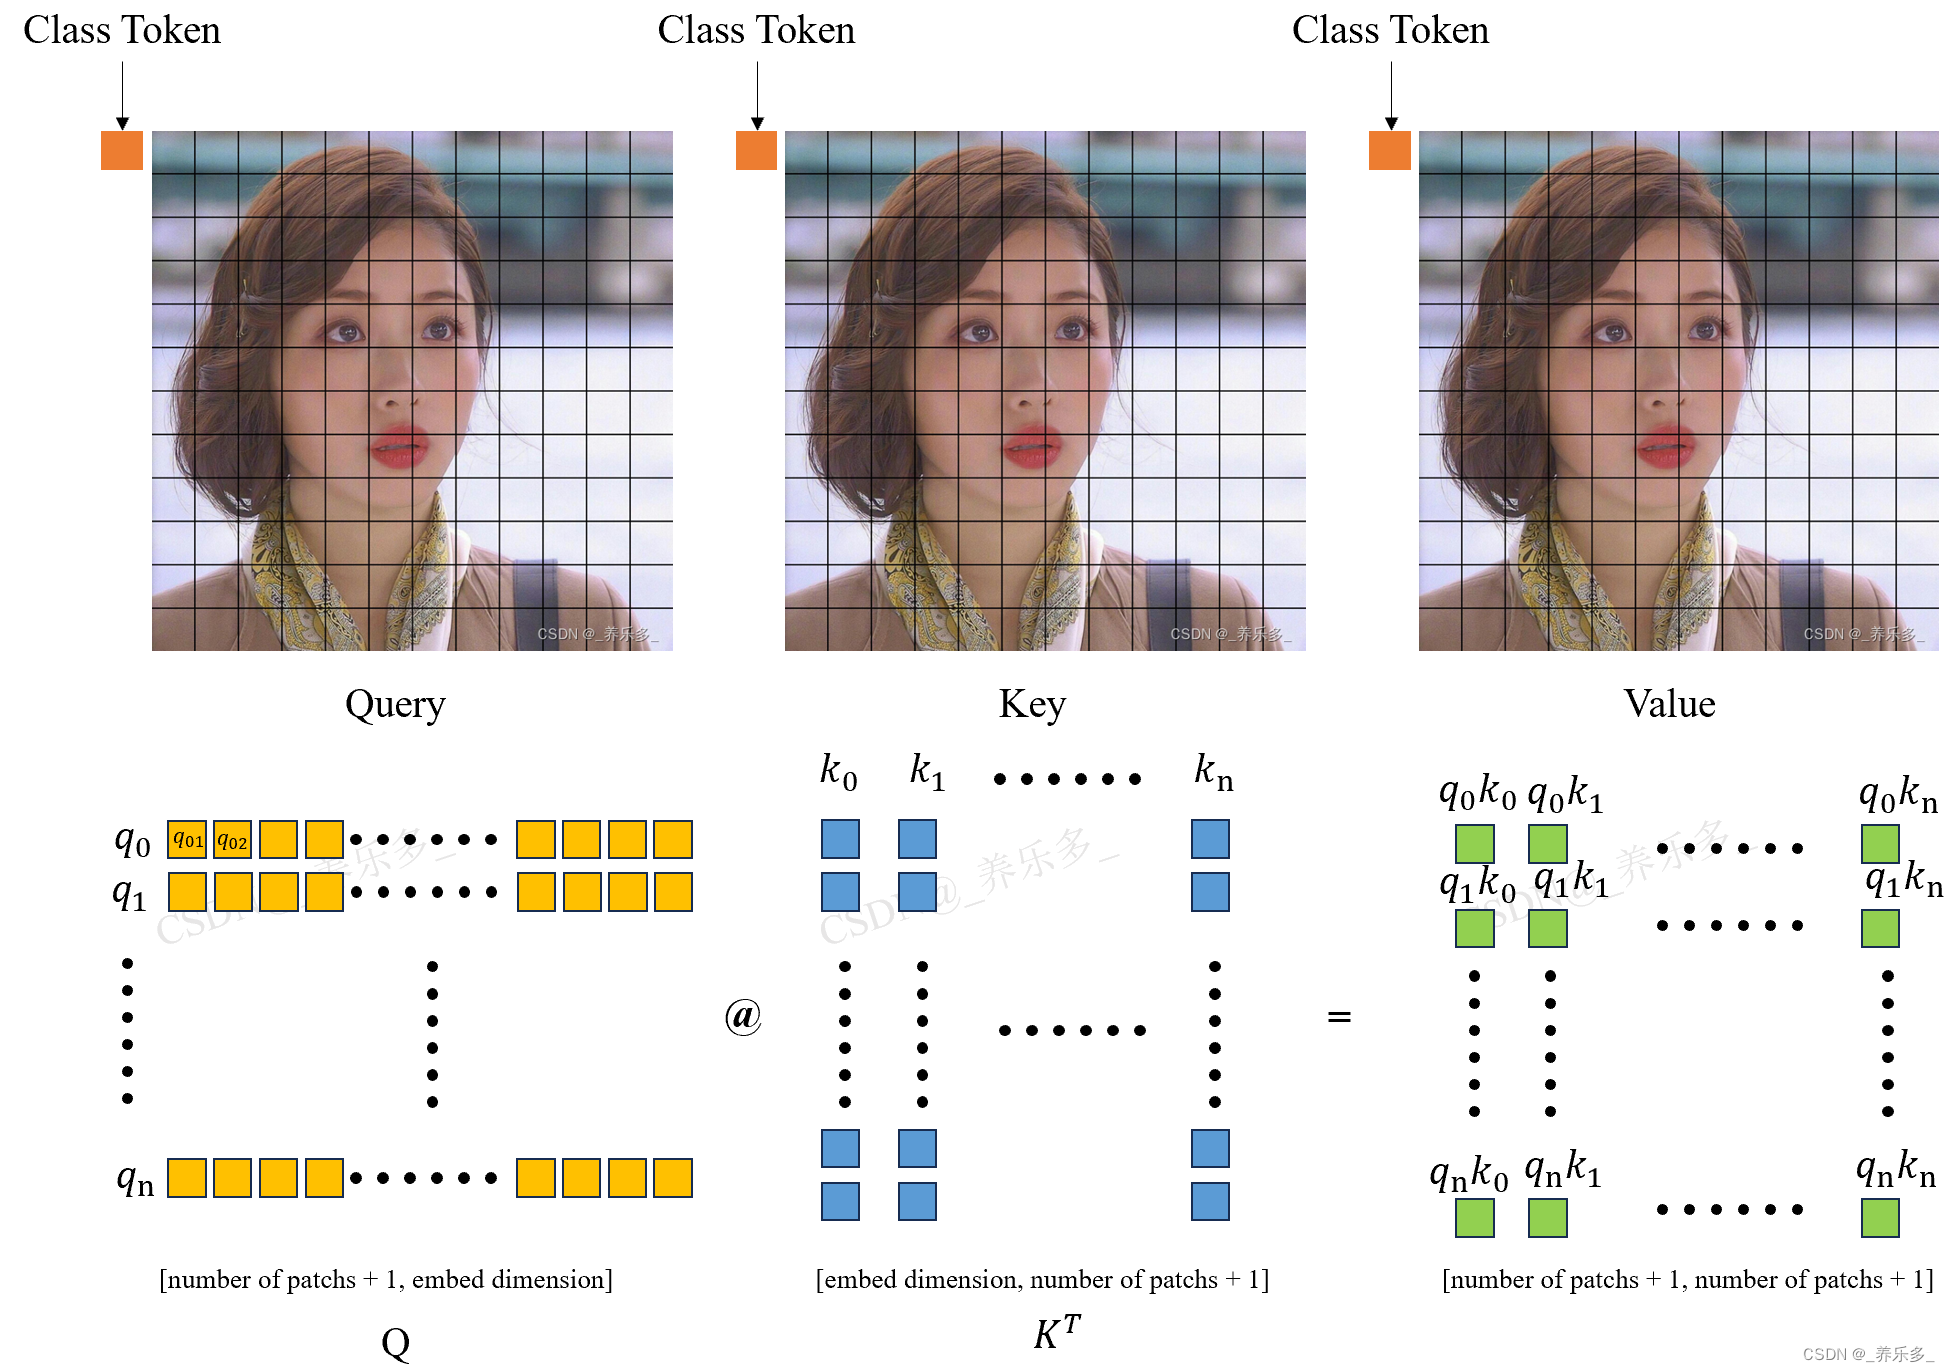
Vision Transformer (ViT):图像分块、图像块嵌入、类别标记、QKV矩阵与自注意力机制的解析_Python机器学习专栏 ...
Pawpatch Recruit Token | Magic: the Gathering MTG Cards
Tested Vision Transformers' Architectures for Federated Adversarial ...
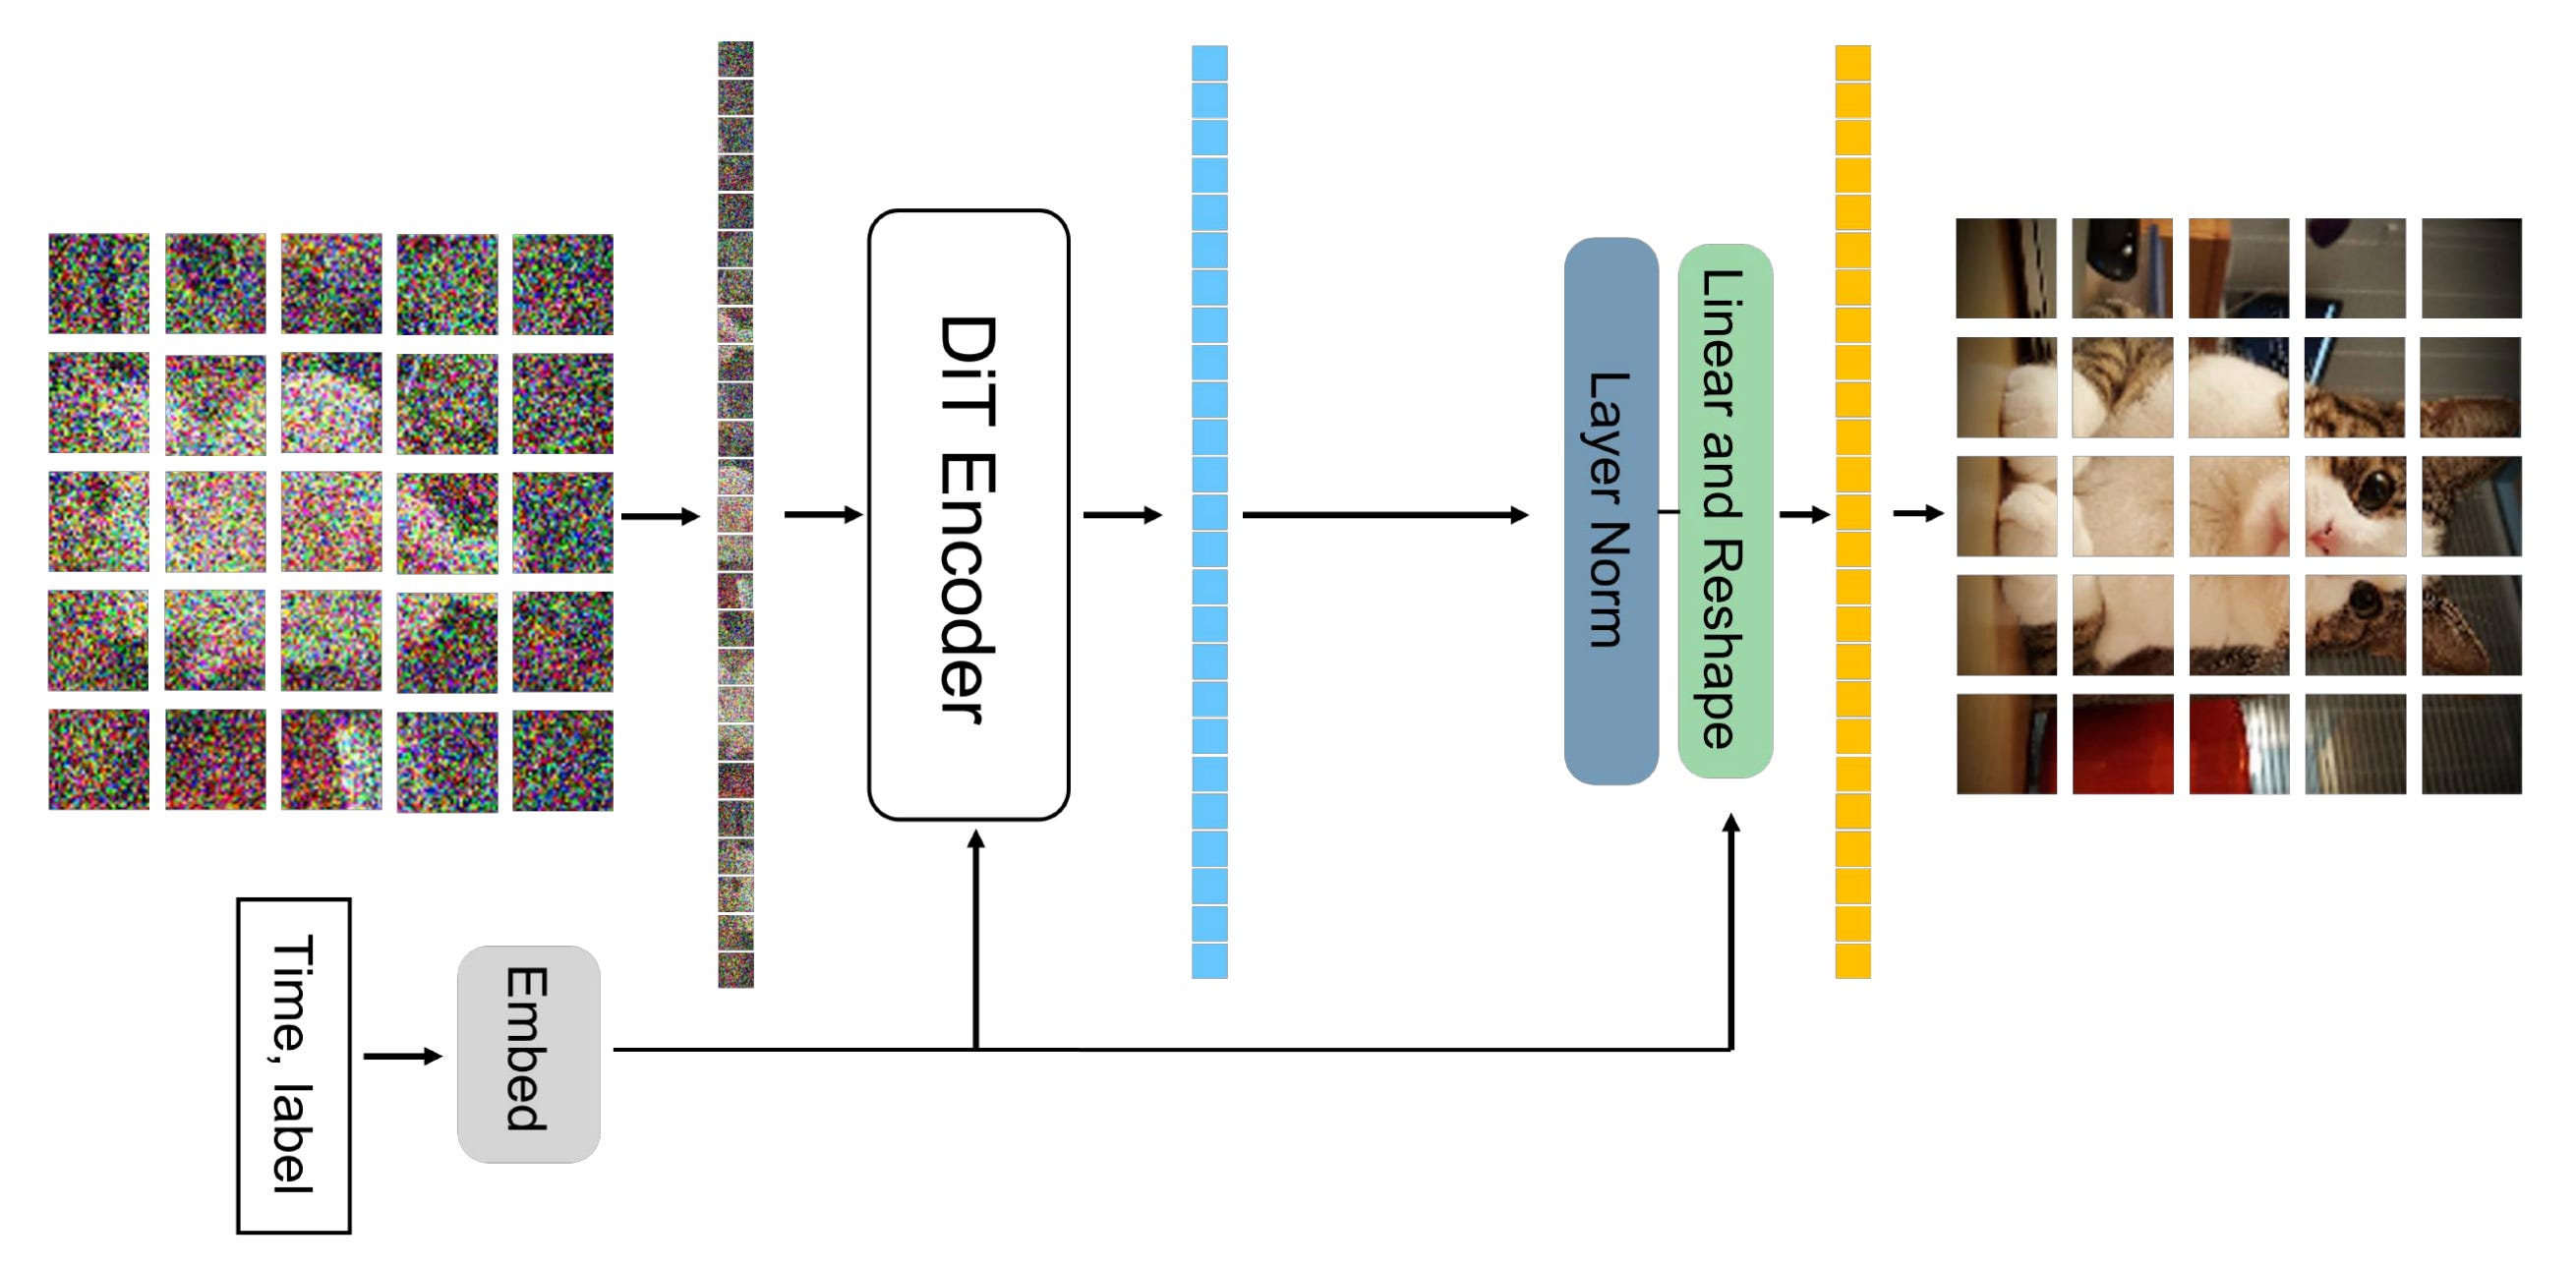
47. DiT: Diffusion Transformer - by Massimiliano Viola
Figure 4 from Revisiting Multimodal Representation in Contrastive ...
ViTok-v2: Fully Native Resolution Auto-Encoder Scaled to 4.5 Billion ...