Showing 73 of 73on this page. Filters & sort apply to loaded results; URL updates for sharing.73 of 73 on this page
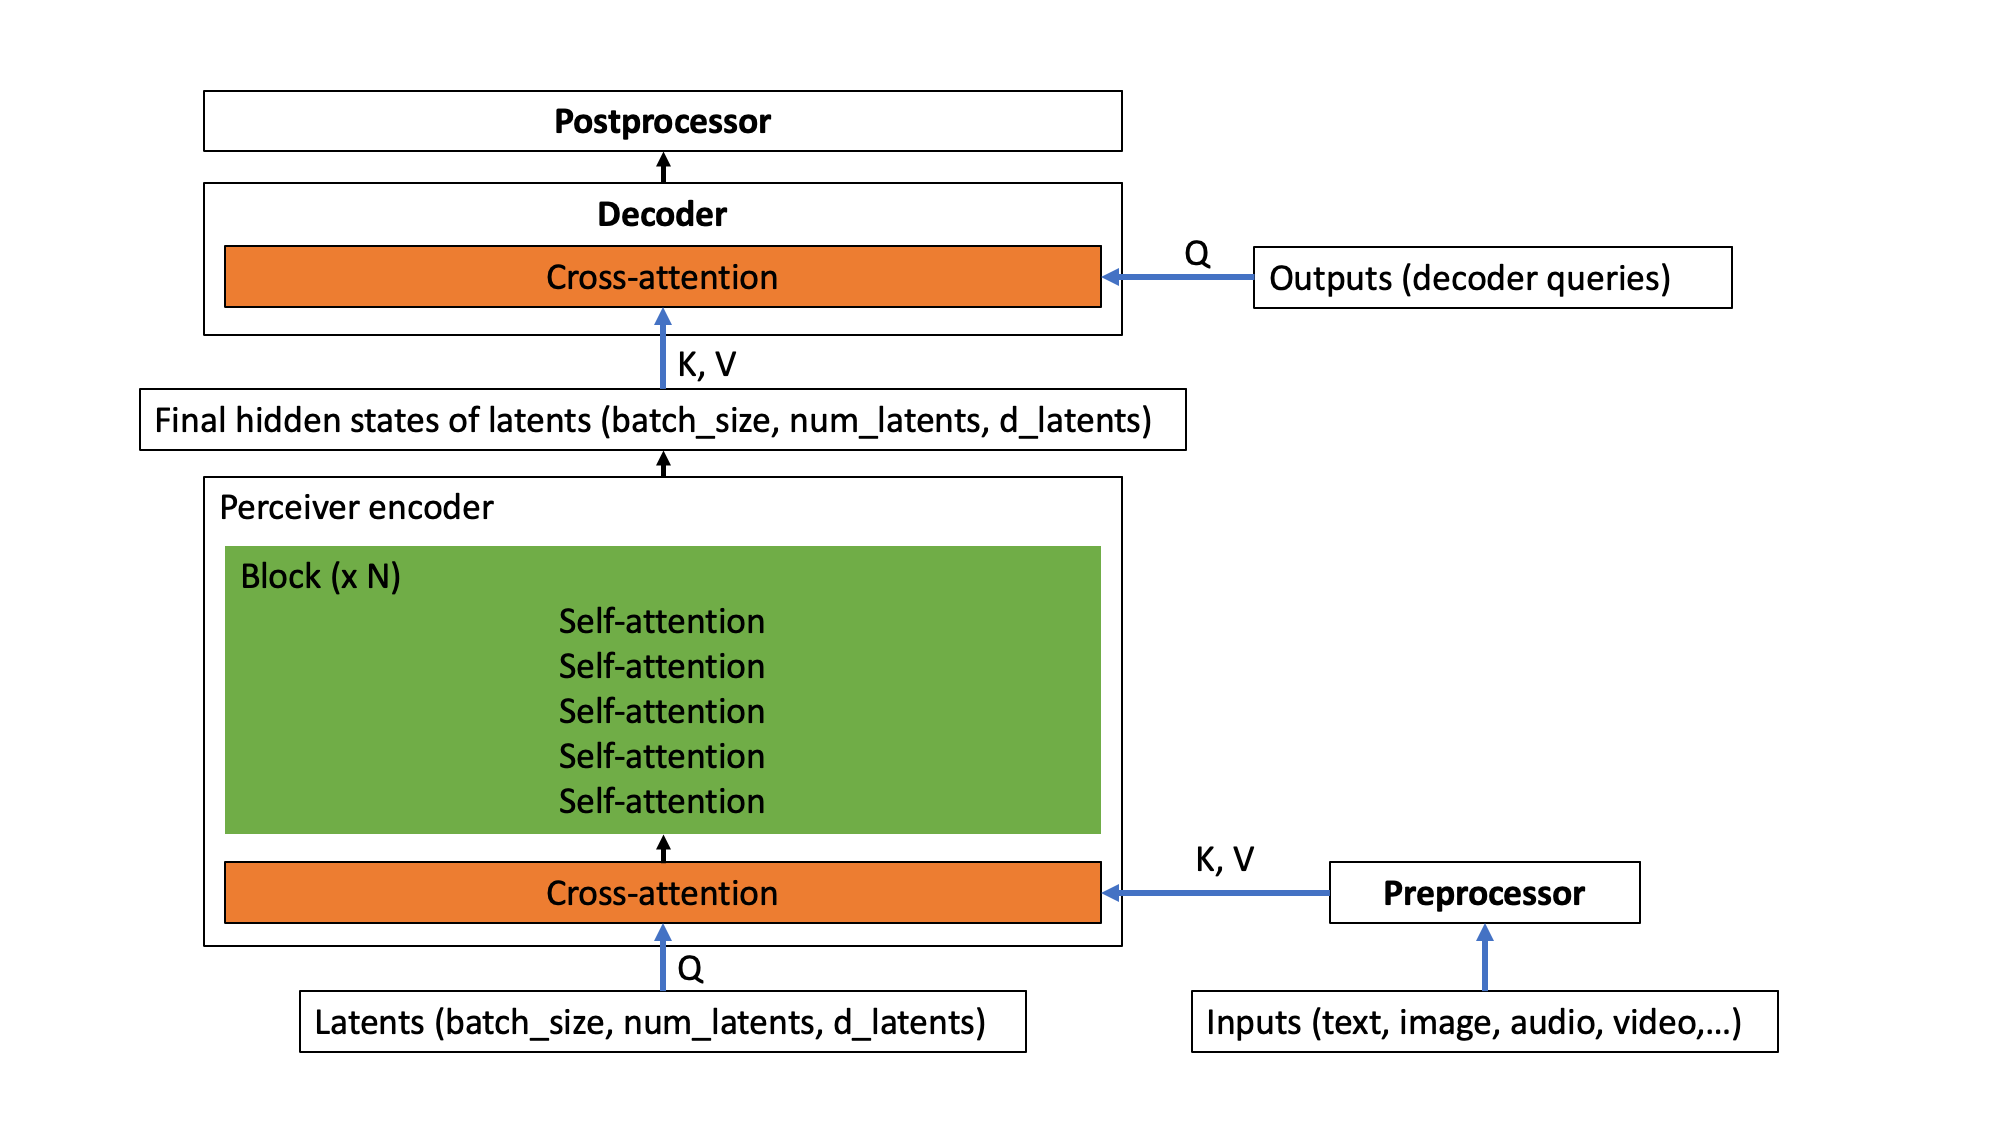
Perceiver (IO) - 知乎
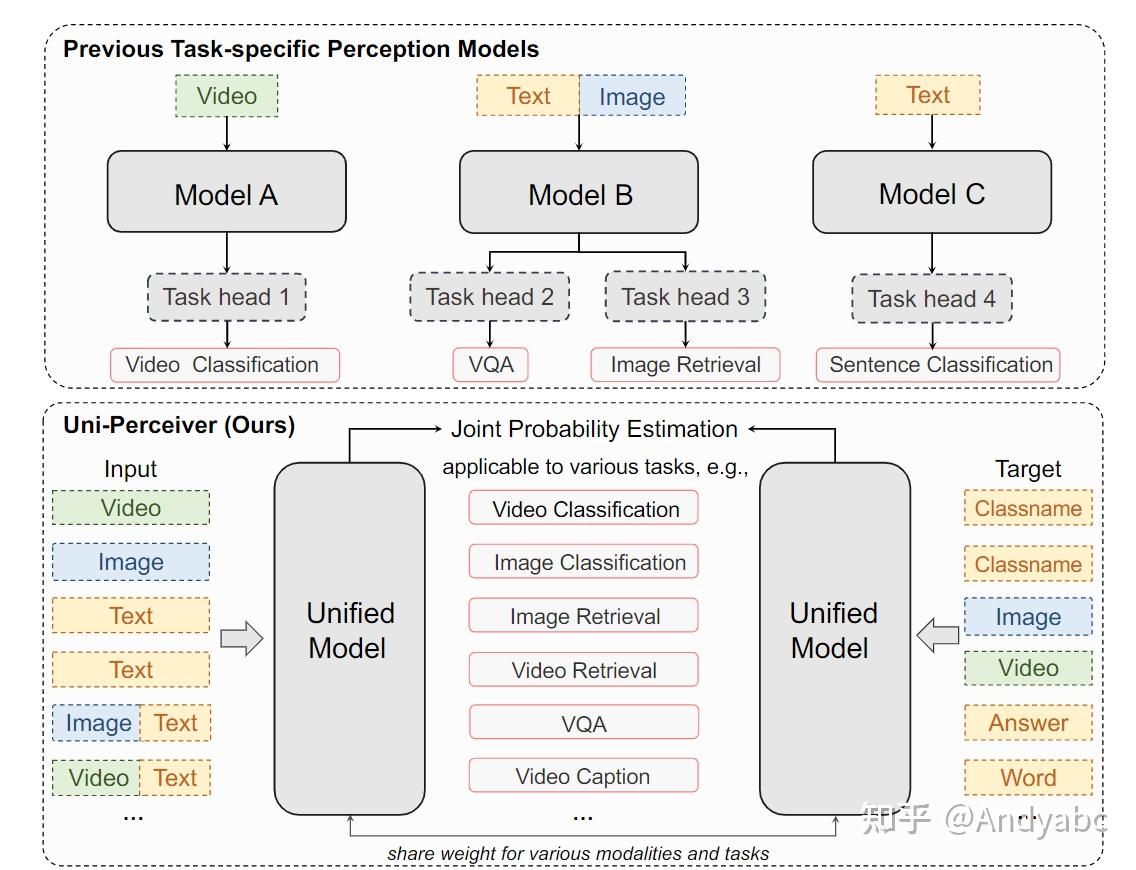
【通用感知】《Perceiver, Perceiver IO, Uni-Perceiver》 - 知乎
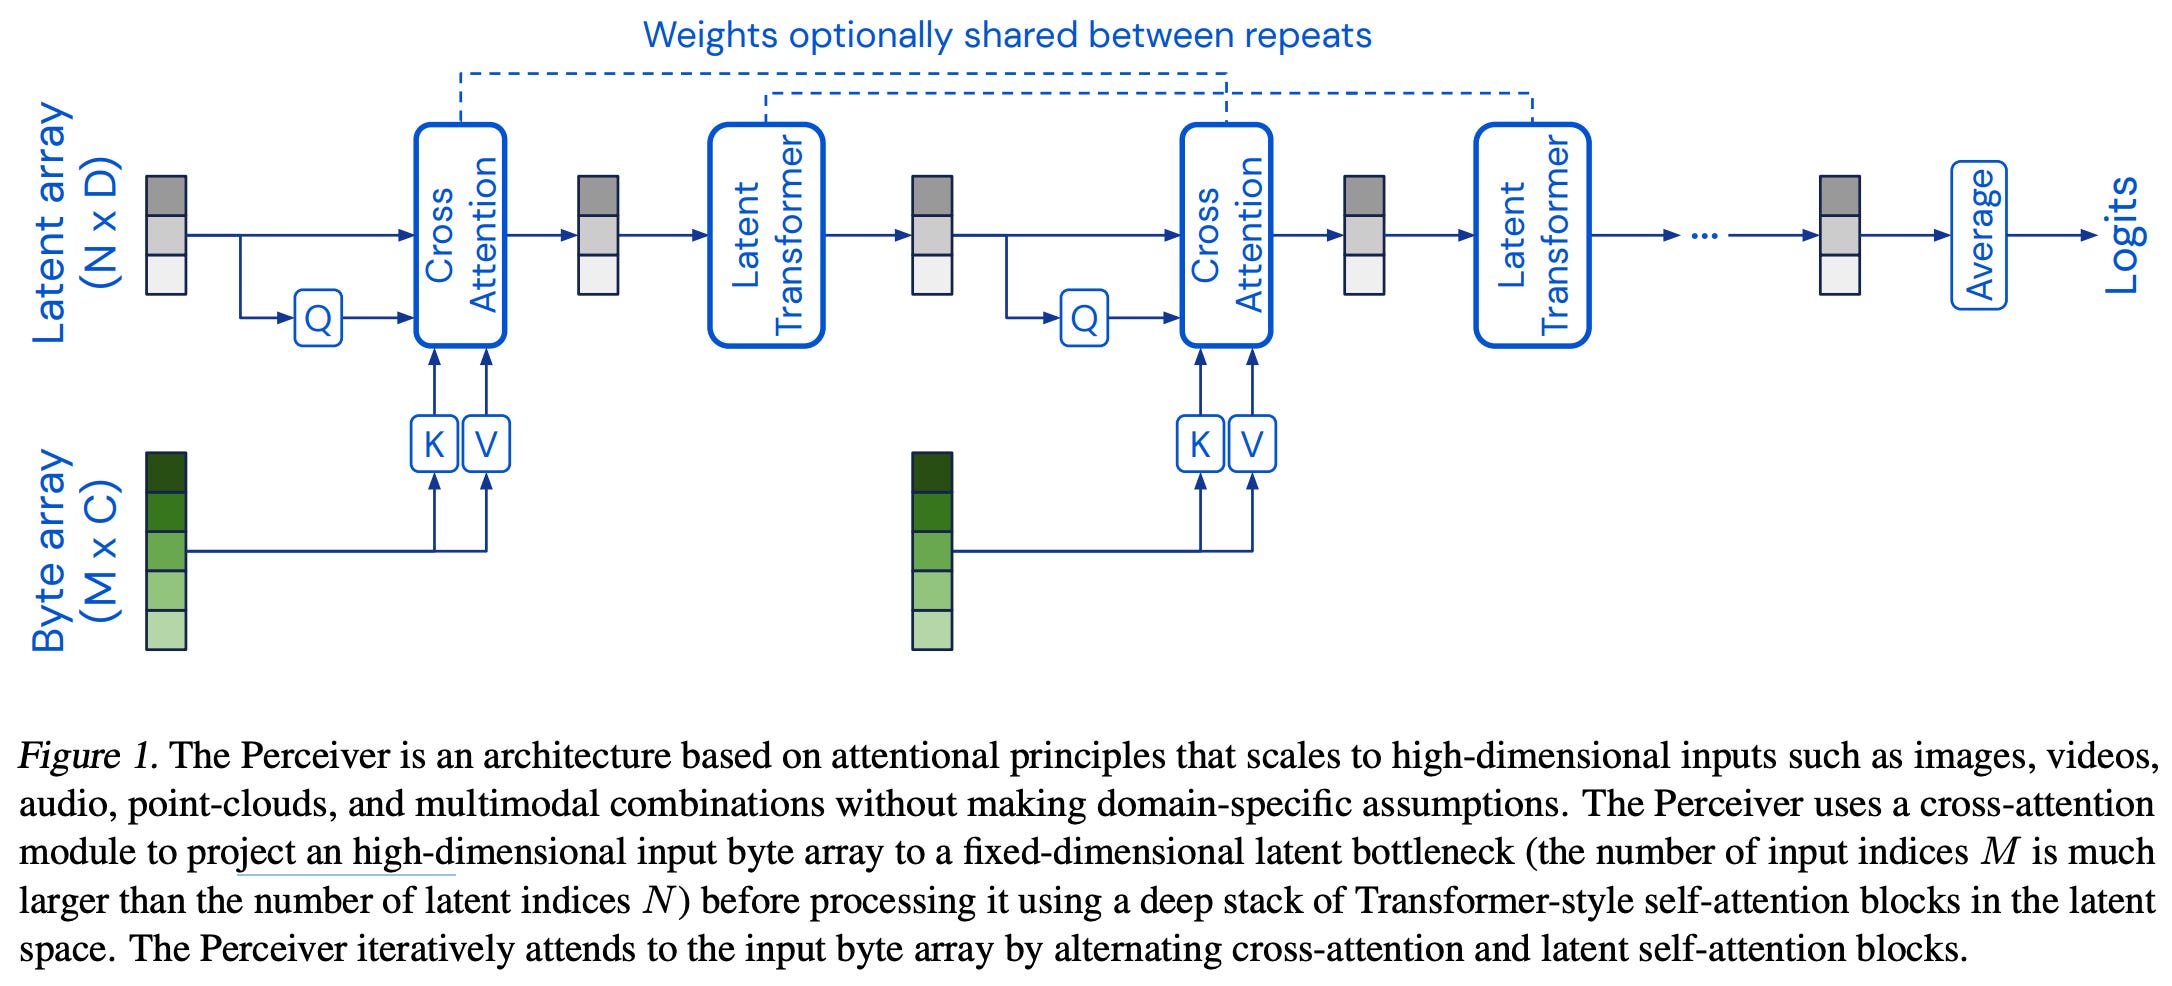
Perceiver architecture. Jaegle, A., Gimeno, F., Brock, A., Vinyals, O ...
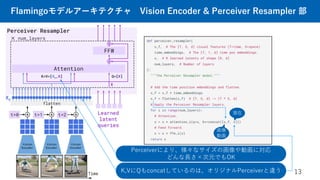
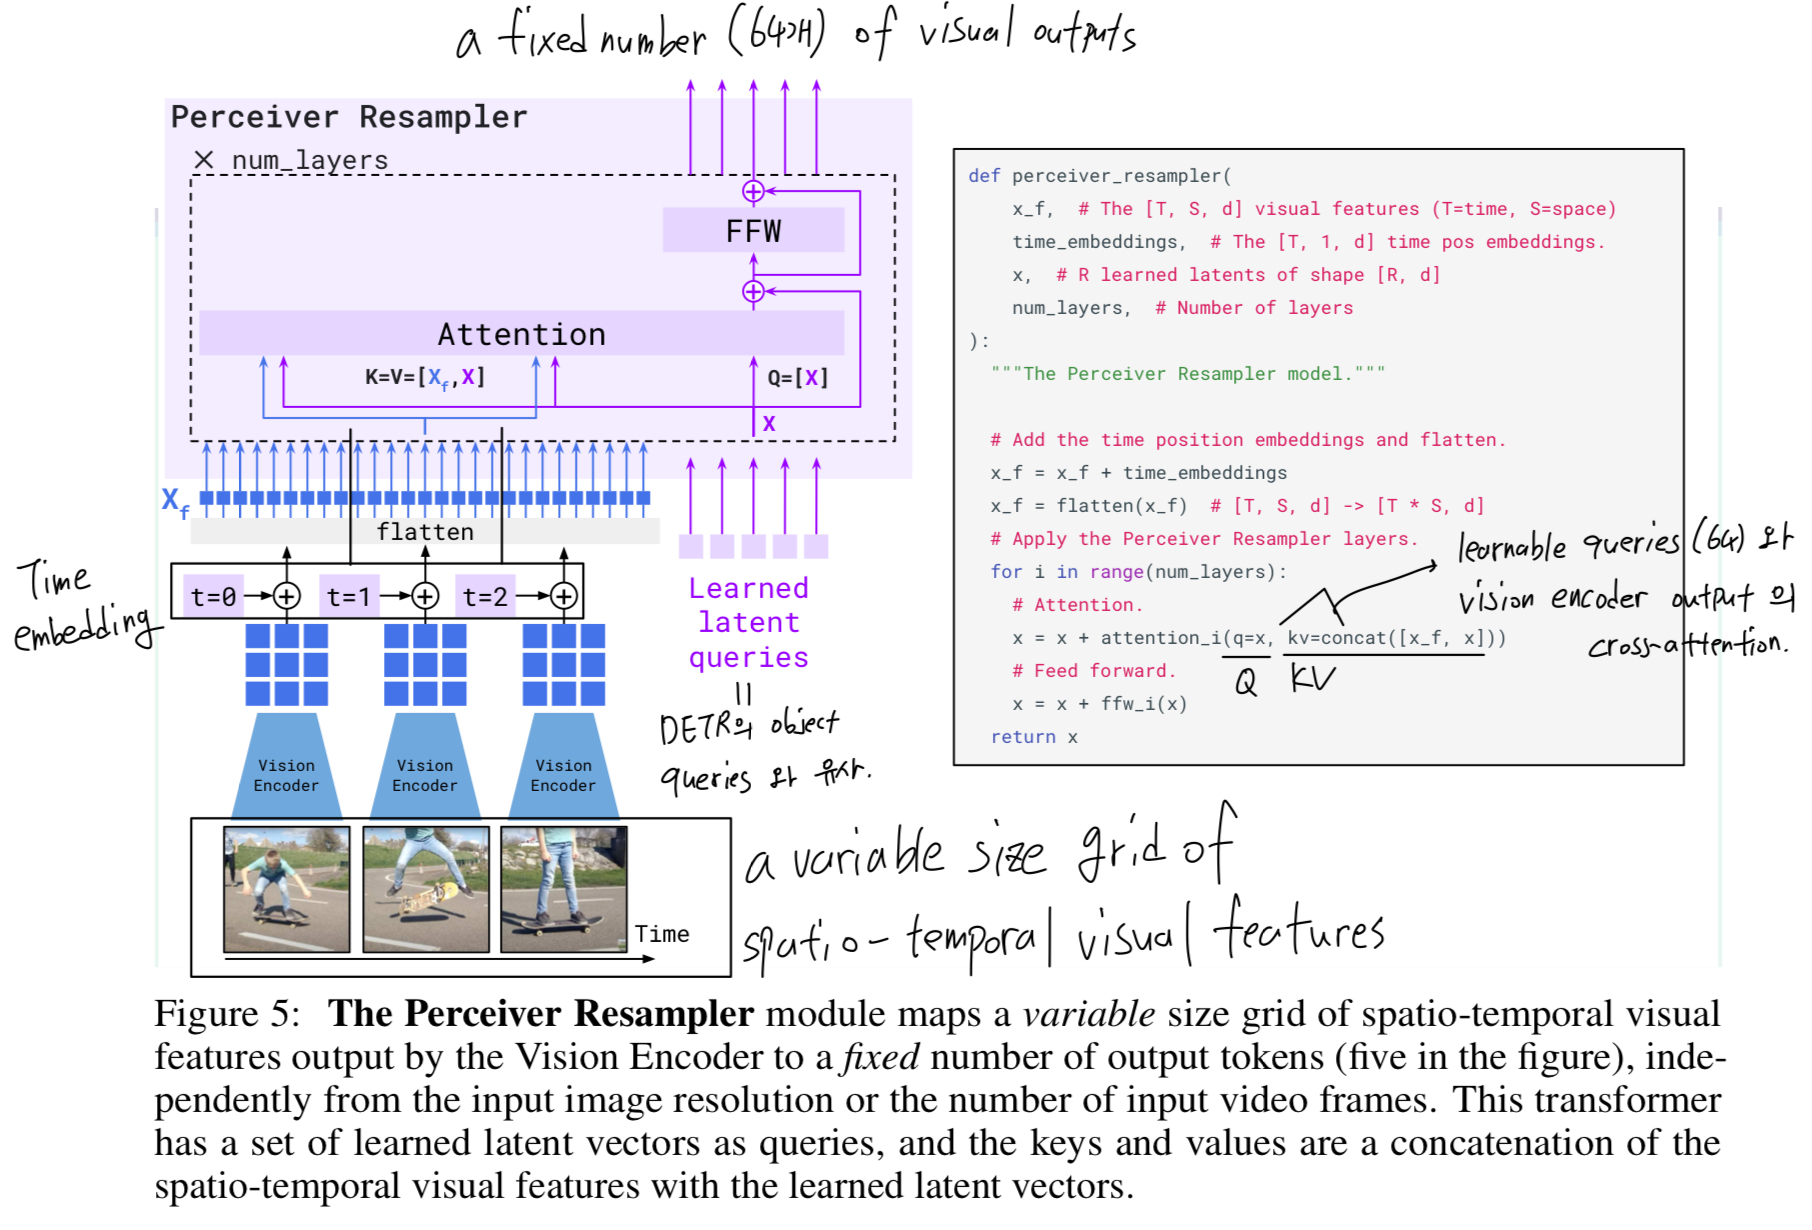
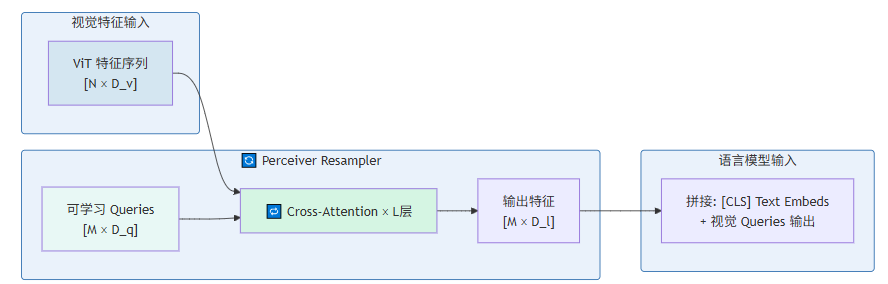
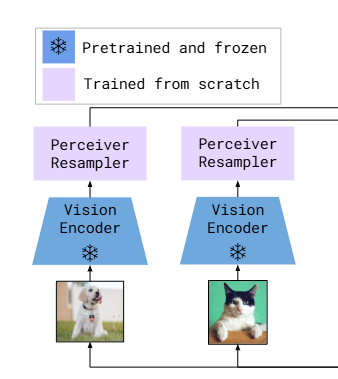
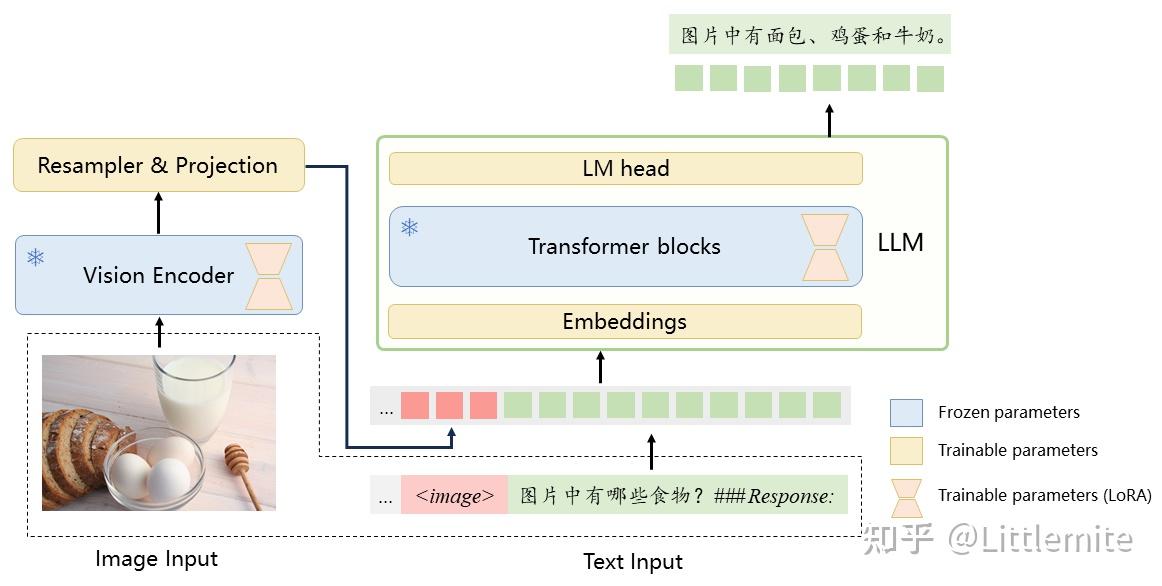
详细解释 Perceiver Resampler模块-CSDN博客
Perceiver IO: a scalable, fully-attentional model that works on any ...
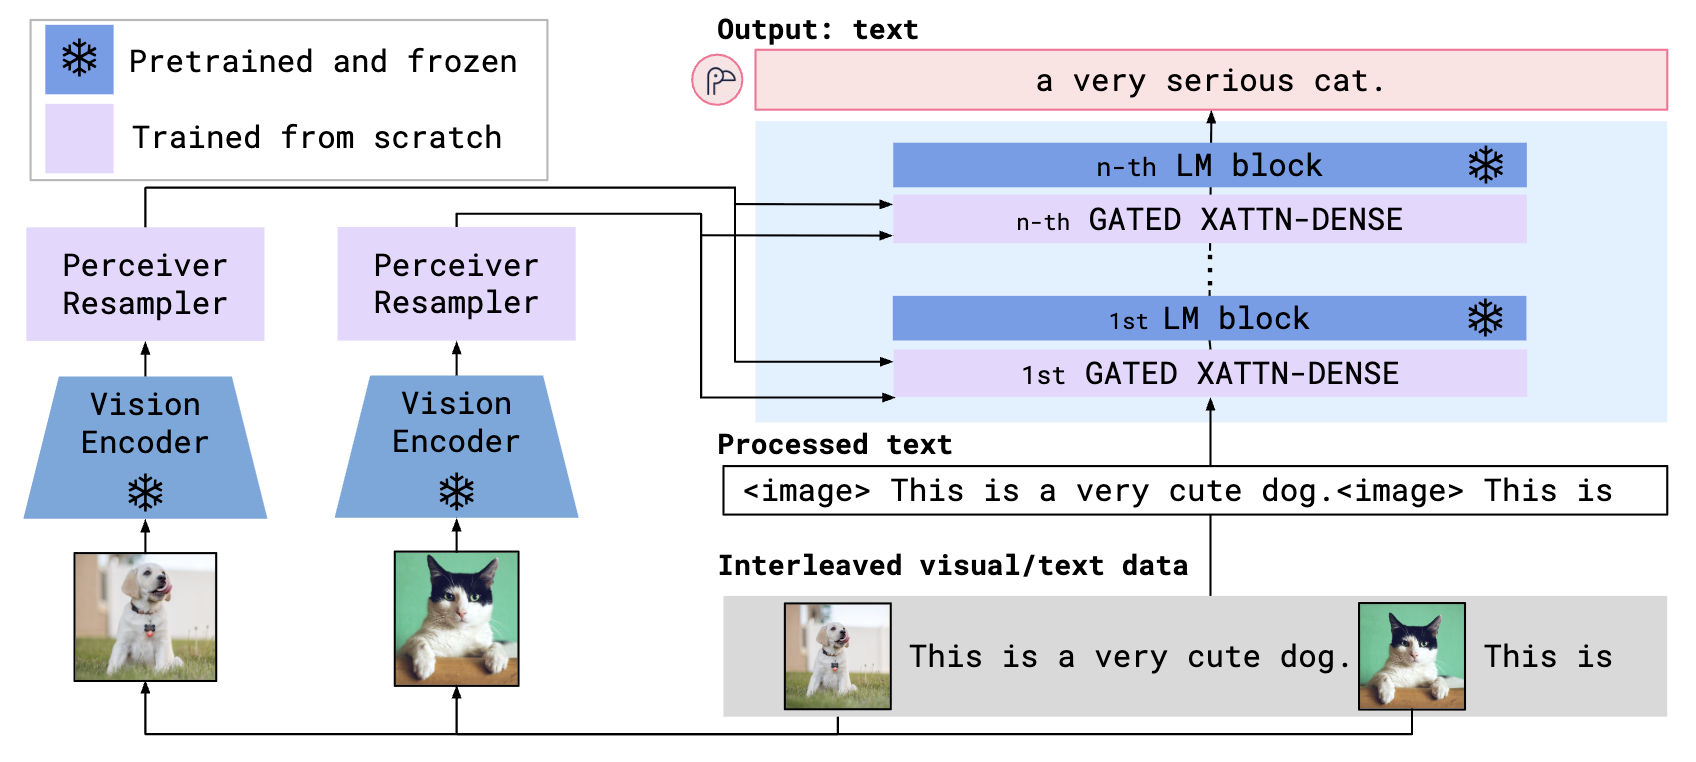
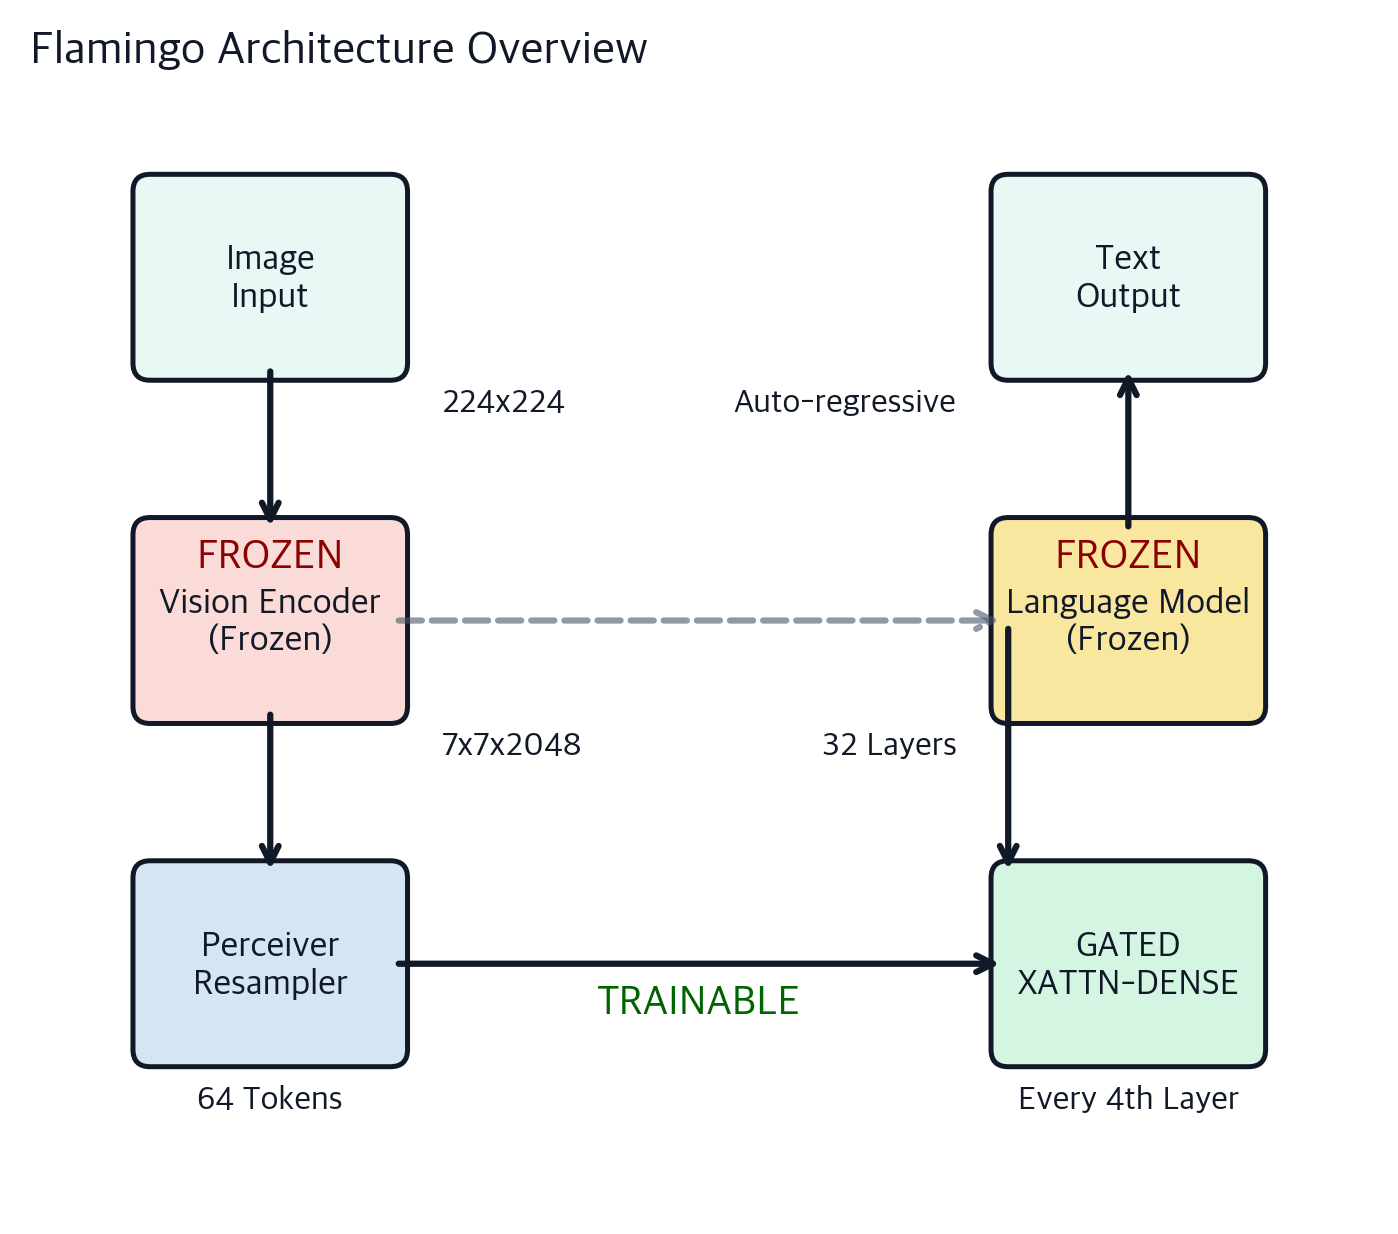
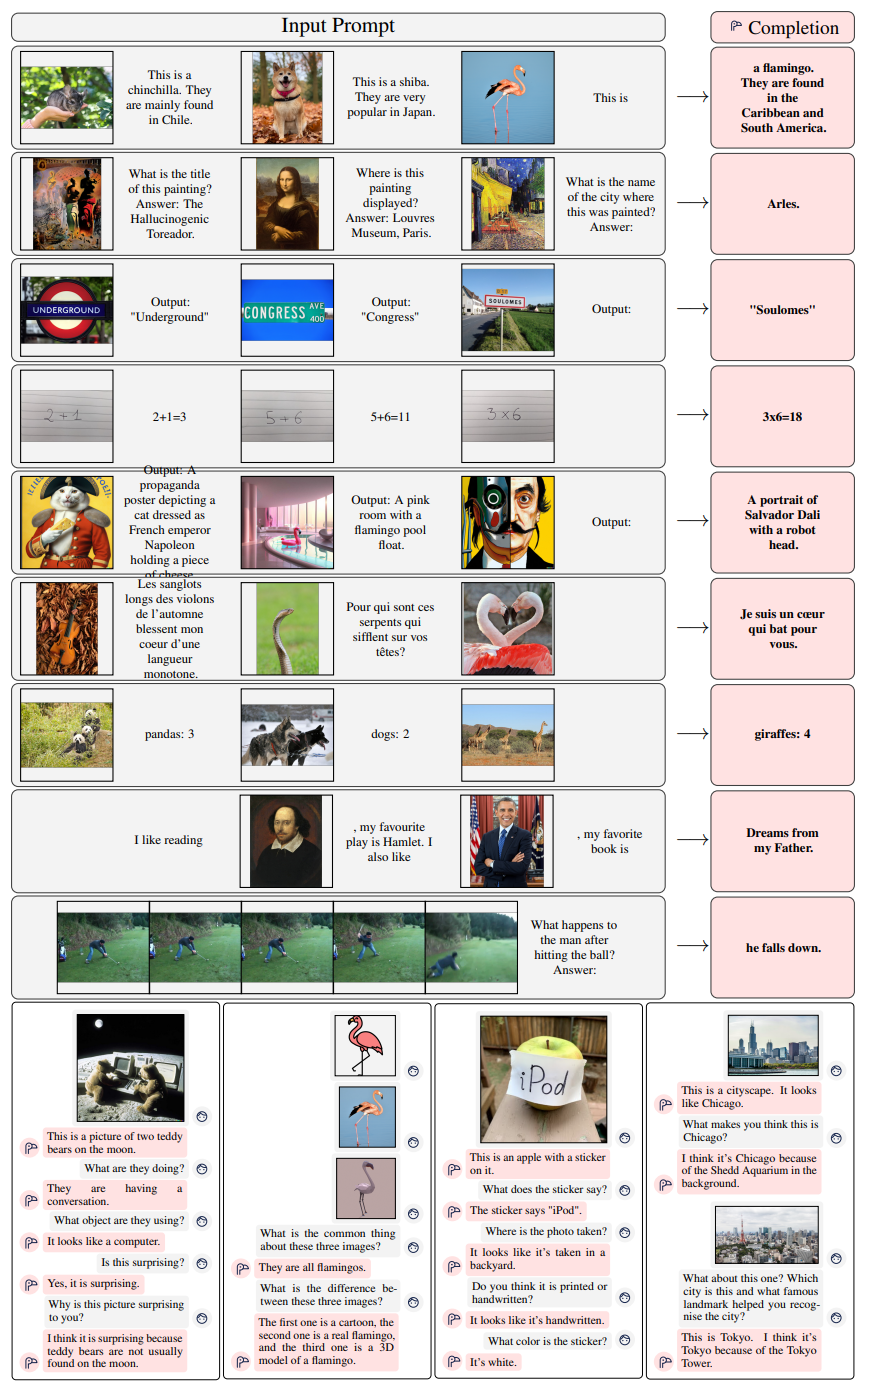
DeepMind Flamingo: A Visual Language Model for Few-Shot Learning ...
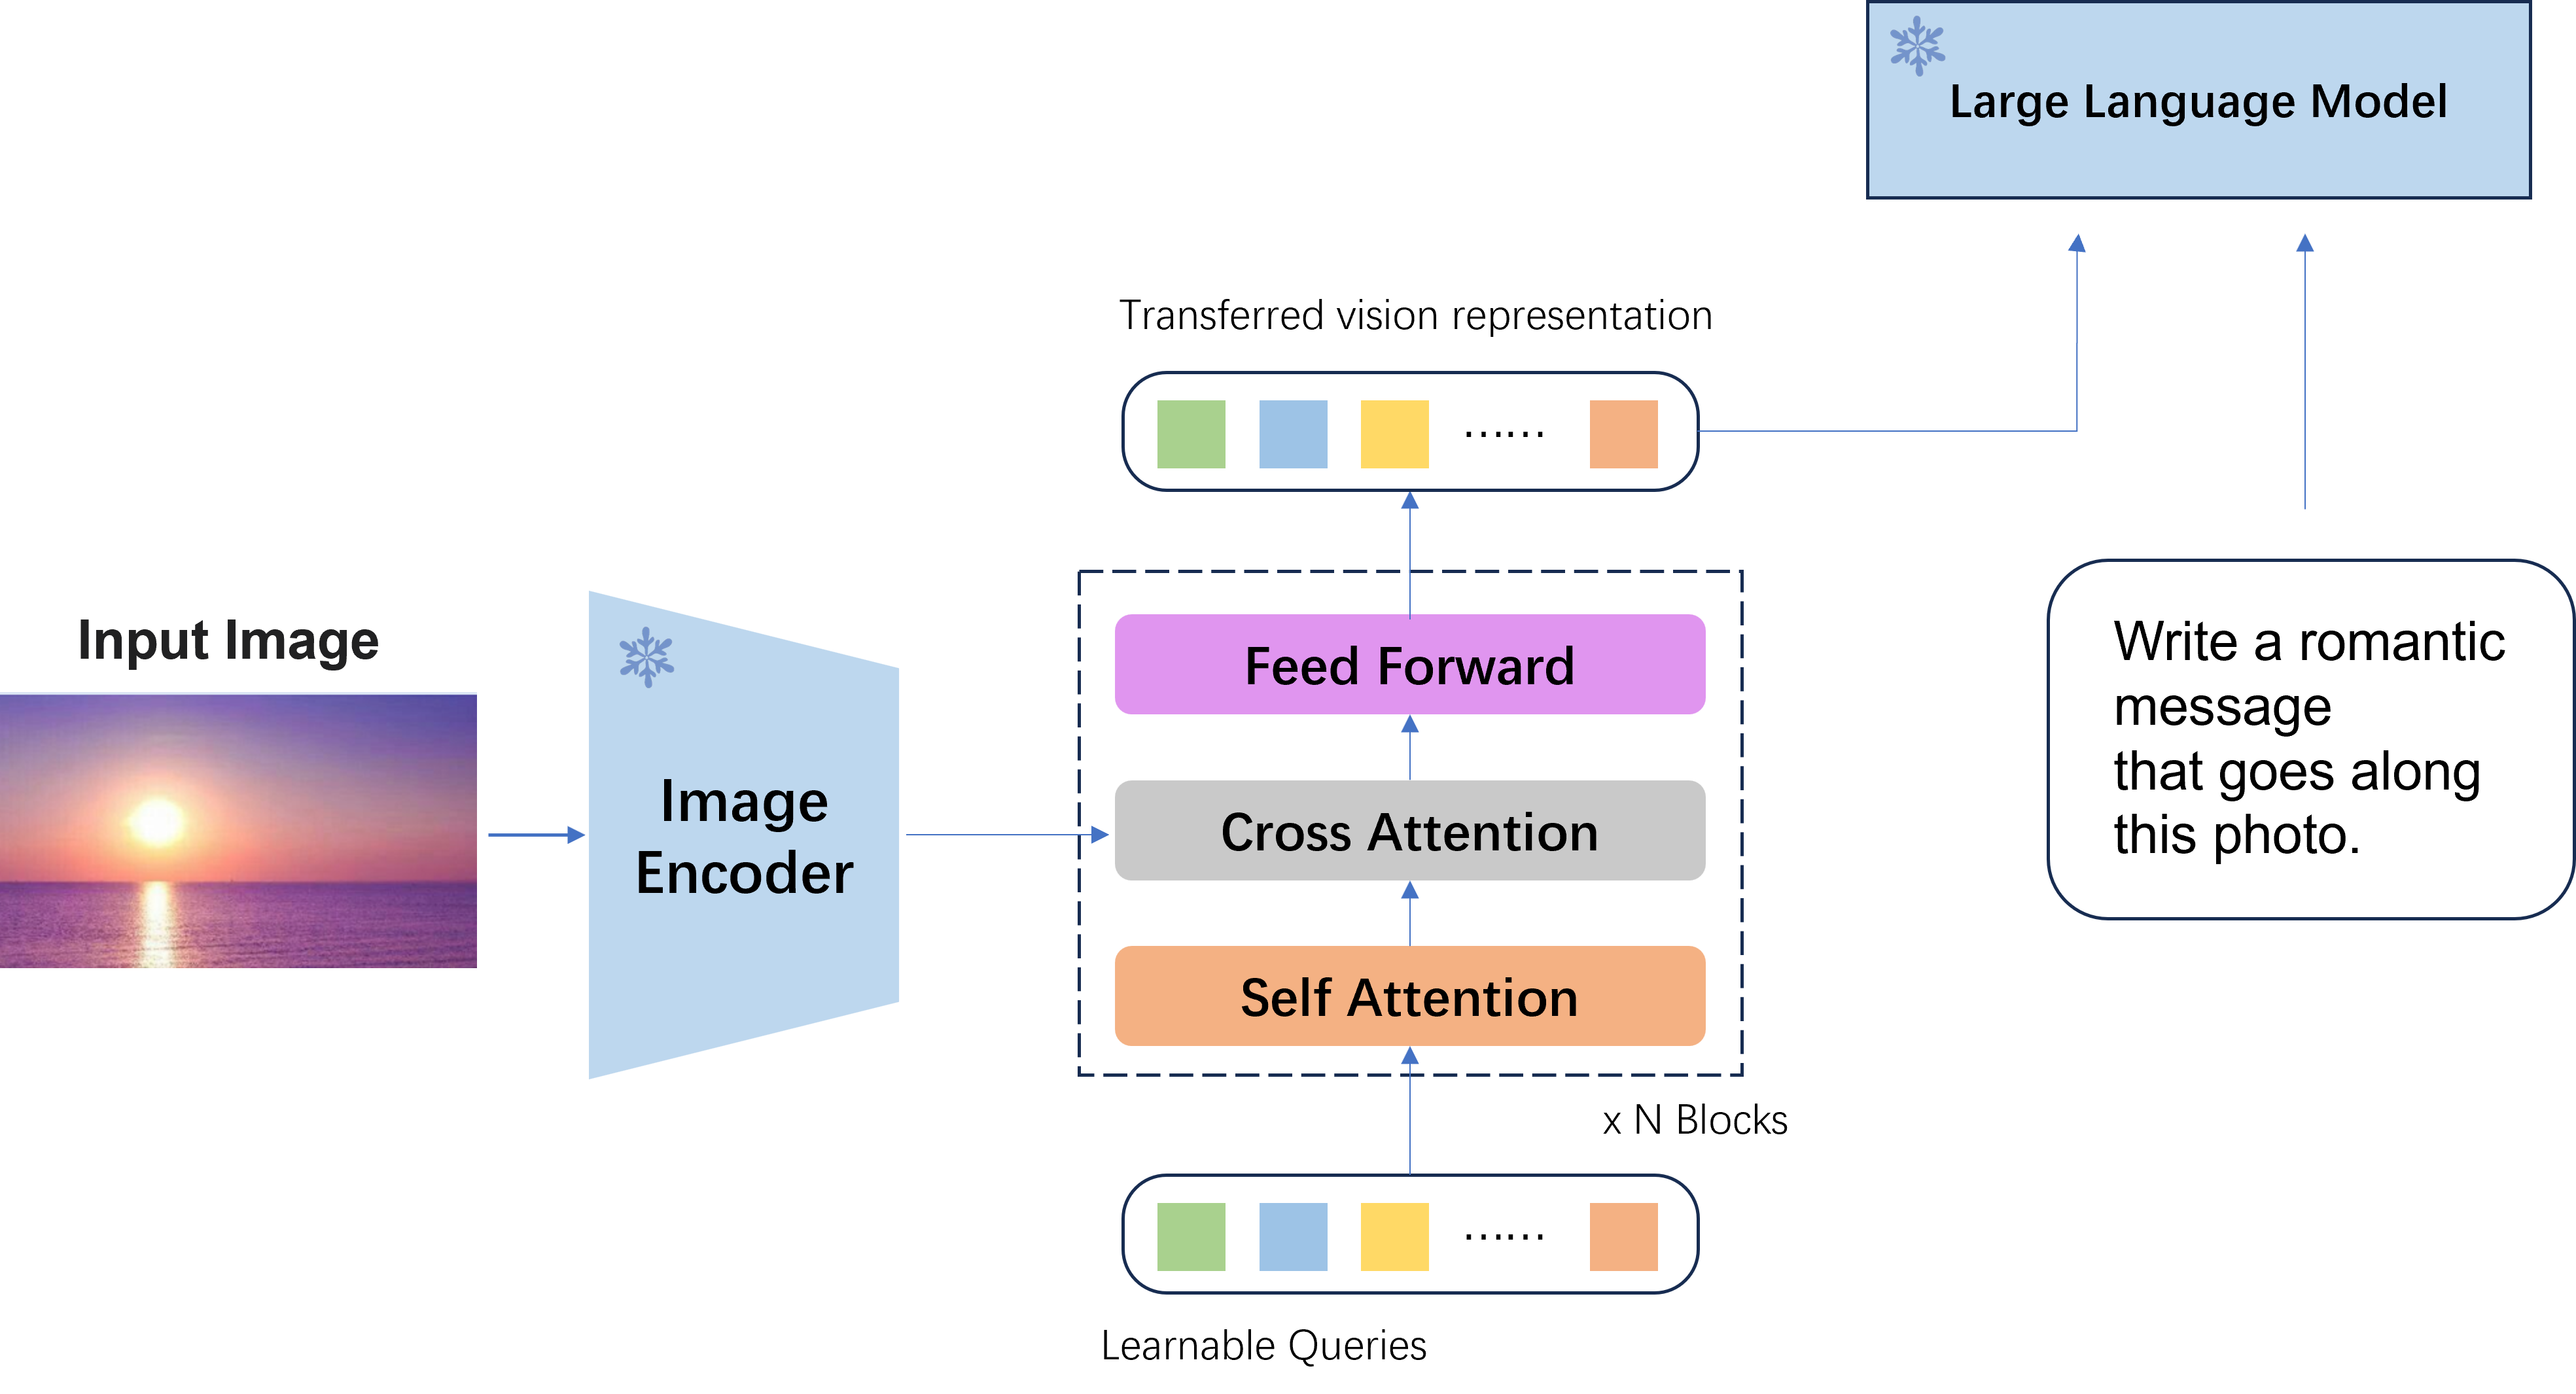
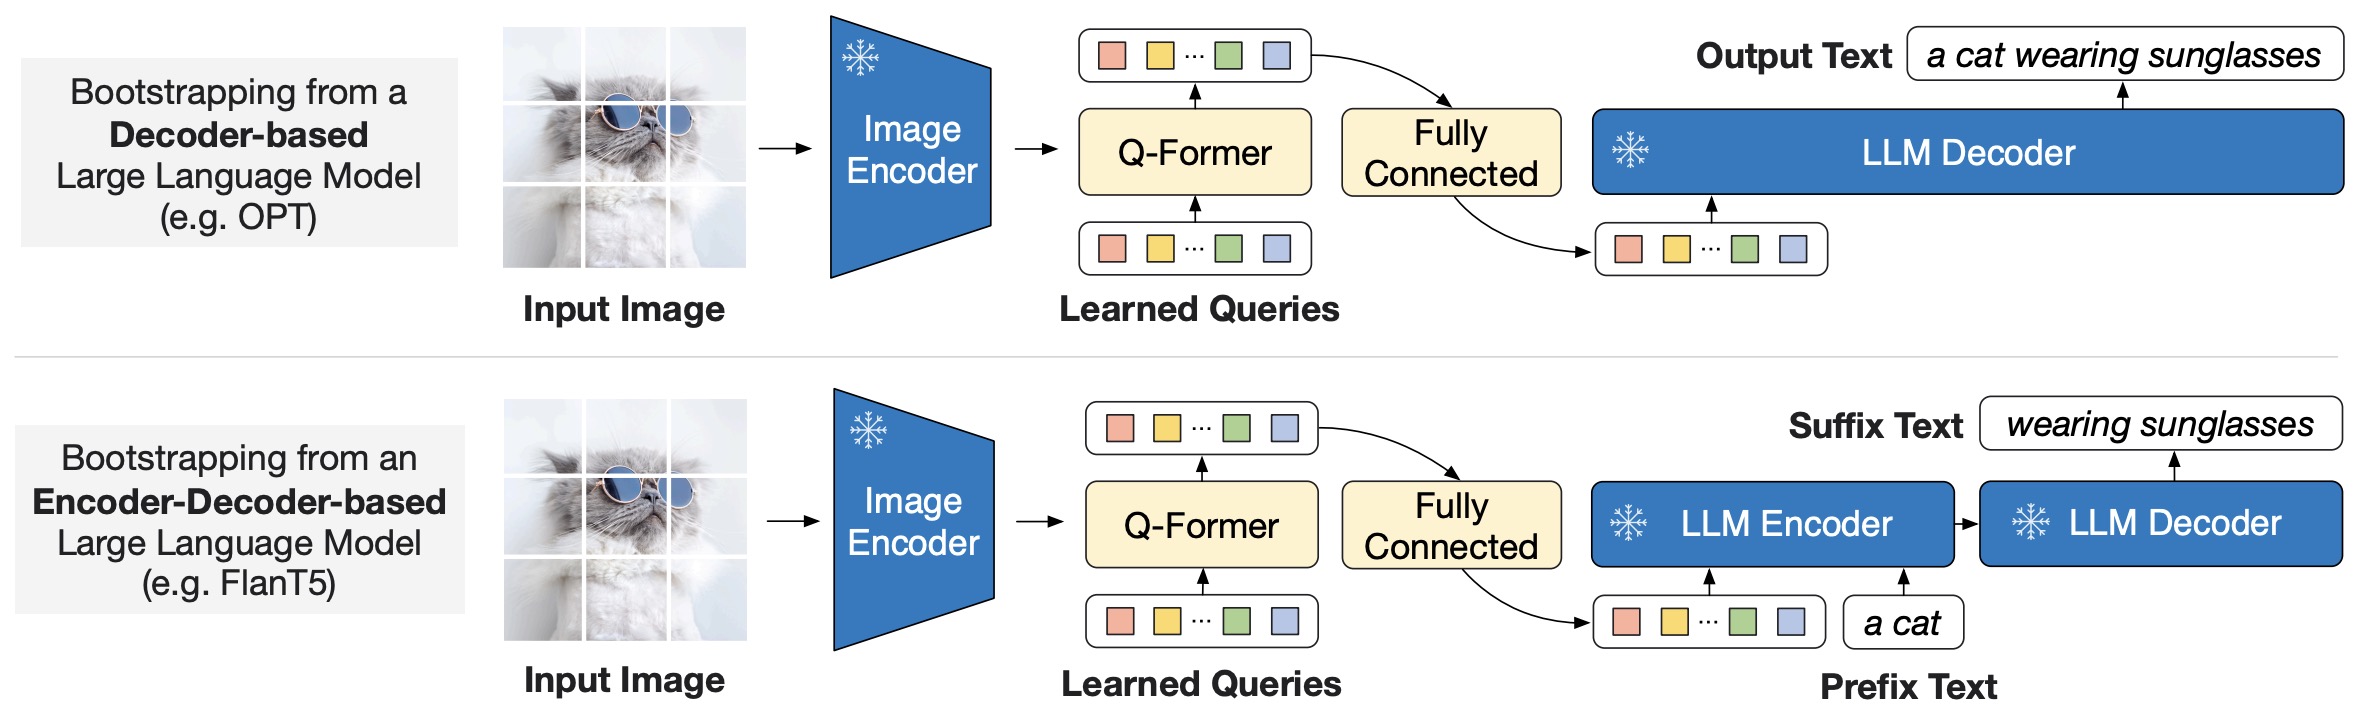
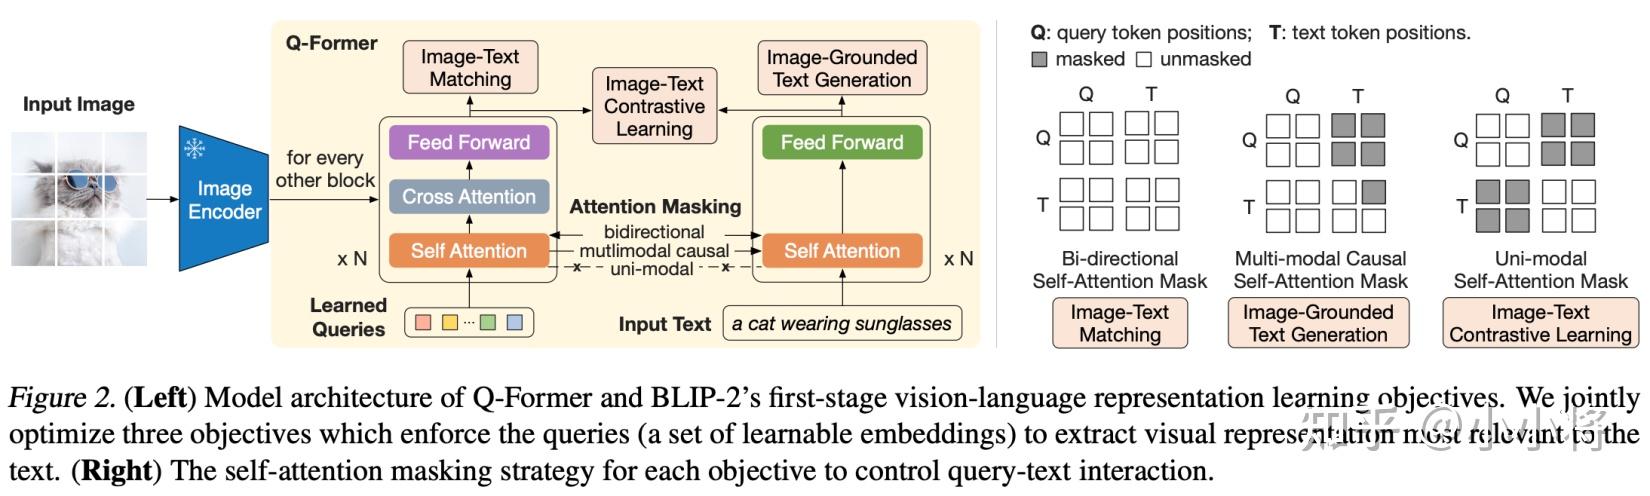
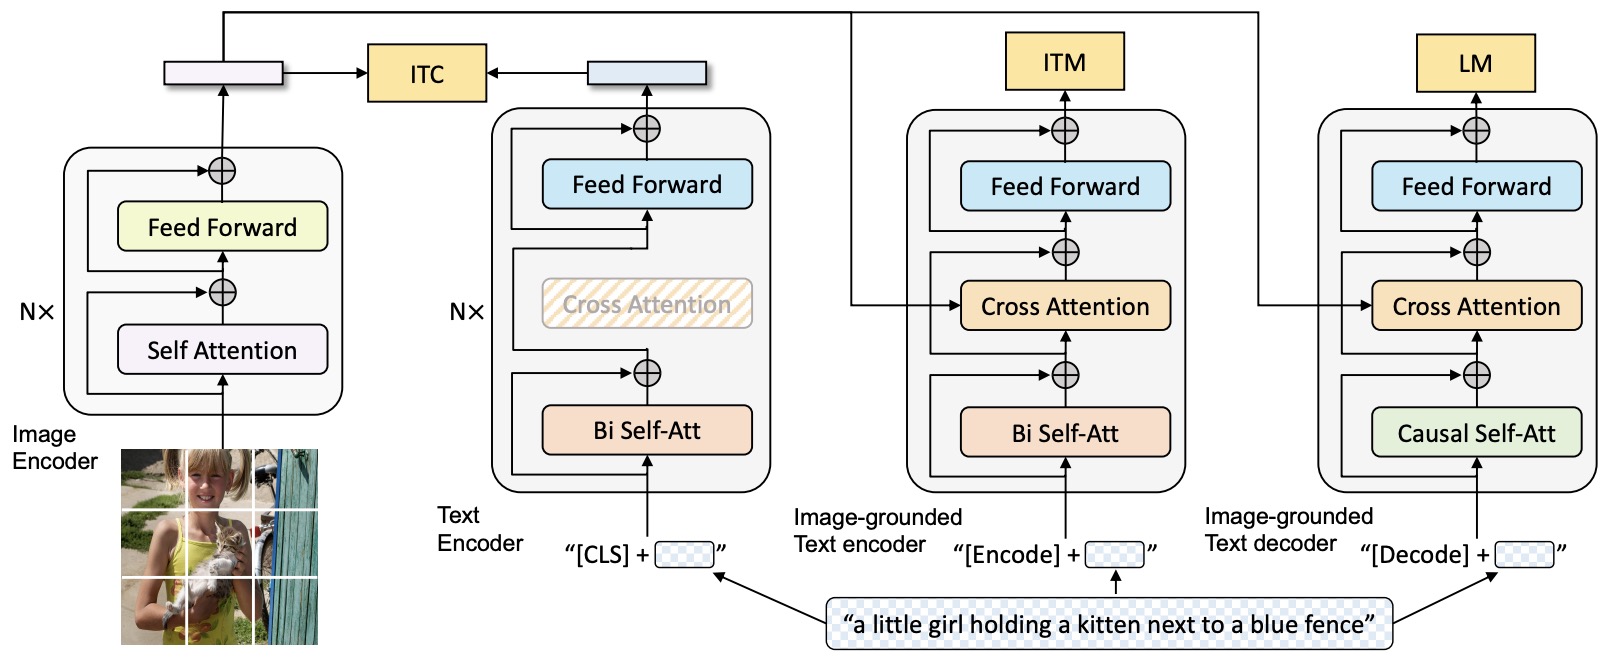
BLIP2——采用Q-Former融合视觉语义与LLM能力的方法_qformer模型-CSDN博客
GitHub - shan18/Perceiver-Resampler-XAttn-Captioning: Generating ...
論文紹介:Flamingo: a Visual Language Model for Few-Shot Learning | PDF
Flamingo — Intuitively and Exhaustively Explained
Vision Language Models | Rohit Bandaru
[论文概览] | 多模态大模型进展概览 - 知乎
The overall framework of MultiModal-GPT. MultiModal-GPT consists of a ...
从Deepmind火烈鸟看多模态研究发展趋势 - 知乎
【DL輪読会】Flamingo: a Visual Language Model for Few-Shot Learning 画像×言語の大 ...
Flamingo Architecture: Multimodal AI Without Catastrophic Forgetting ...
“Bridging Vision and Language: Designing, Training and Deploying ...
多模态大模型系列解读_qformer-CSDN博客
VLM в Нейро: как мы создавали мультимодальную нейросеть для поиска по ...
[2022 NeurIPS] (simple review) 🦩Flamingo: a Visual Language Model for ...
Flamingo - Intuitively and Exhaustively Explained | Towards Data Science
(PDF) MultiModal-GPT: A Vision and Language Model for Dialogue with Humans
Aman's AI Journal • Primers • Vision Language Models
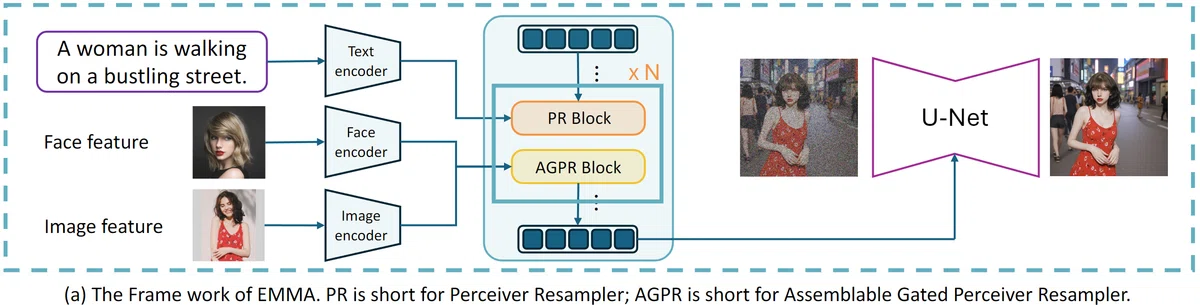
EMMA: テンセントの革新的なマルチモーダル画像生成モデルが仮想人間のSNSを実現|0xpanda alpha lab
[Paper Review] KOSMOS-2.5: A Multimodal Literate Model
OmniLMM-12B:十二亿参数视觉语言模型的性能与效率平衡之道-腾讯云开发者社区-腾讯云
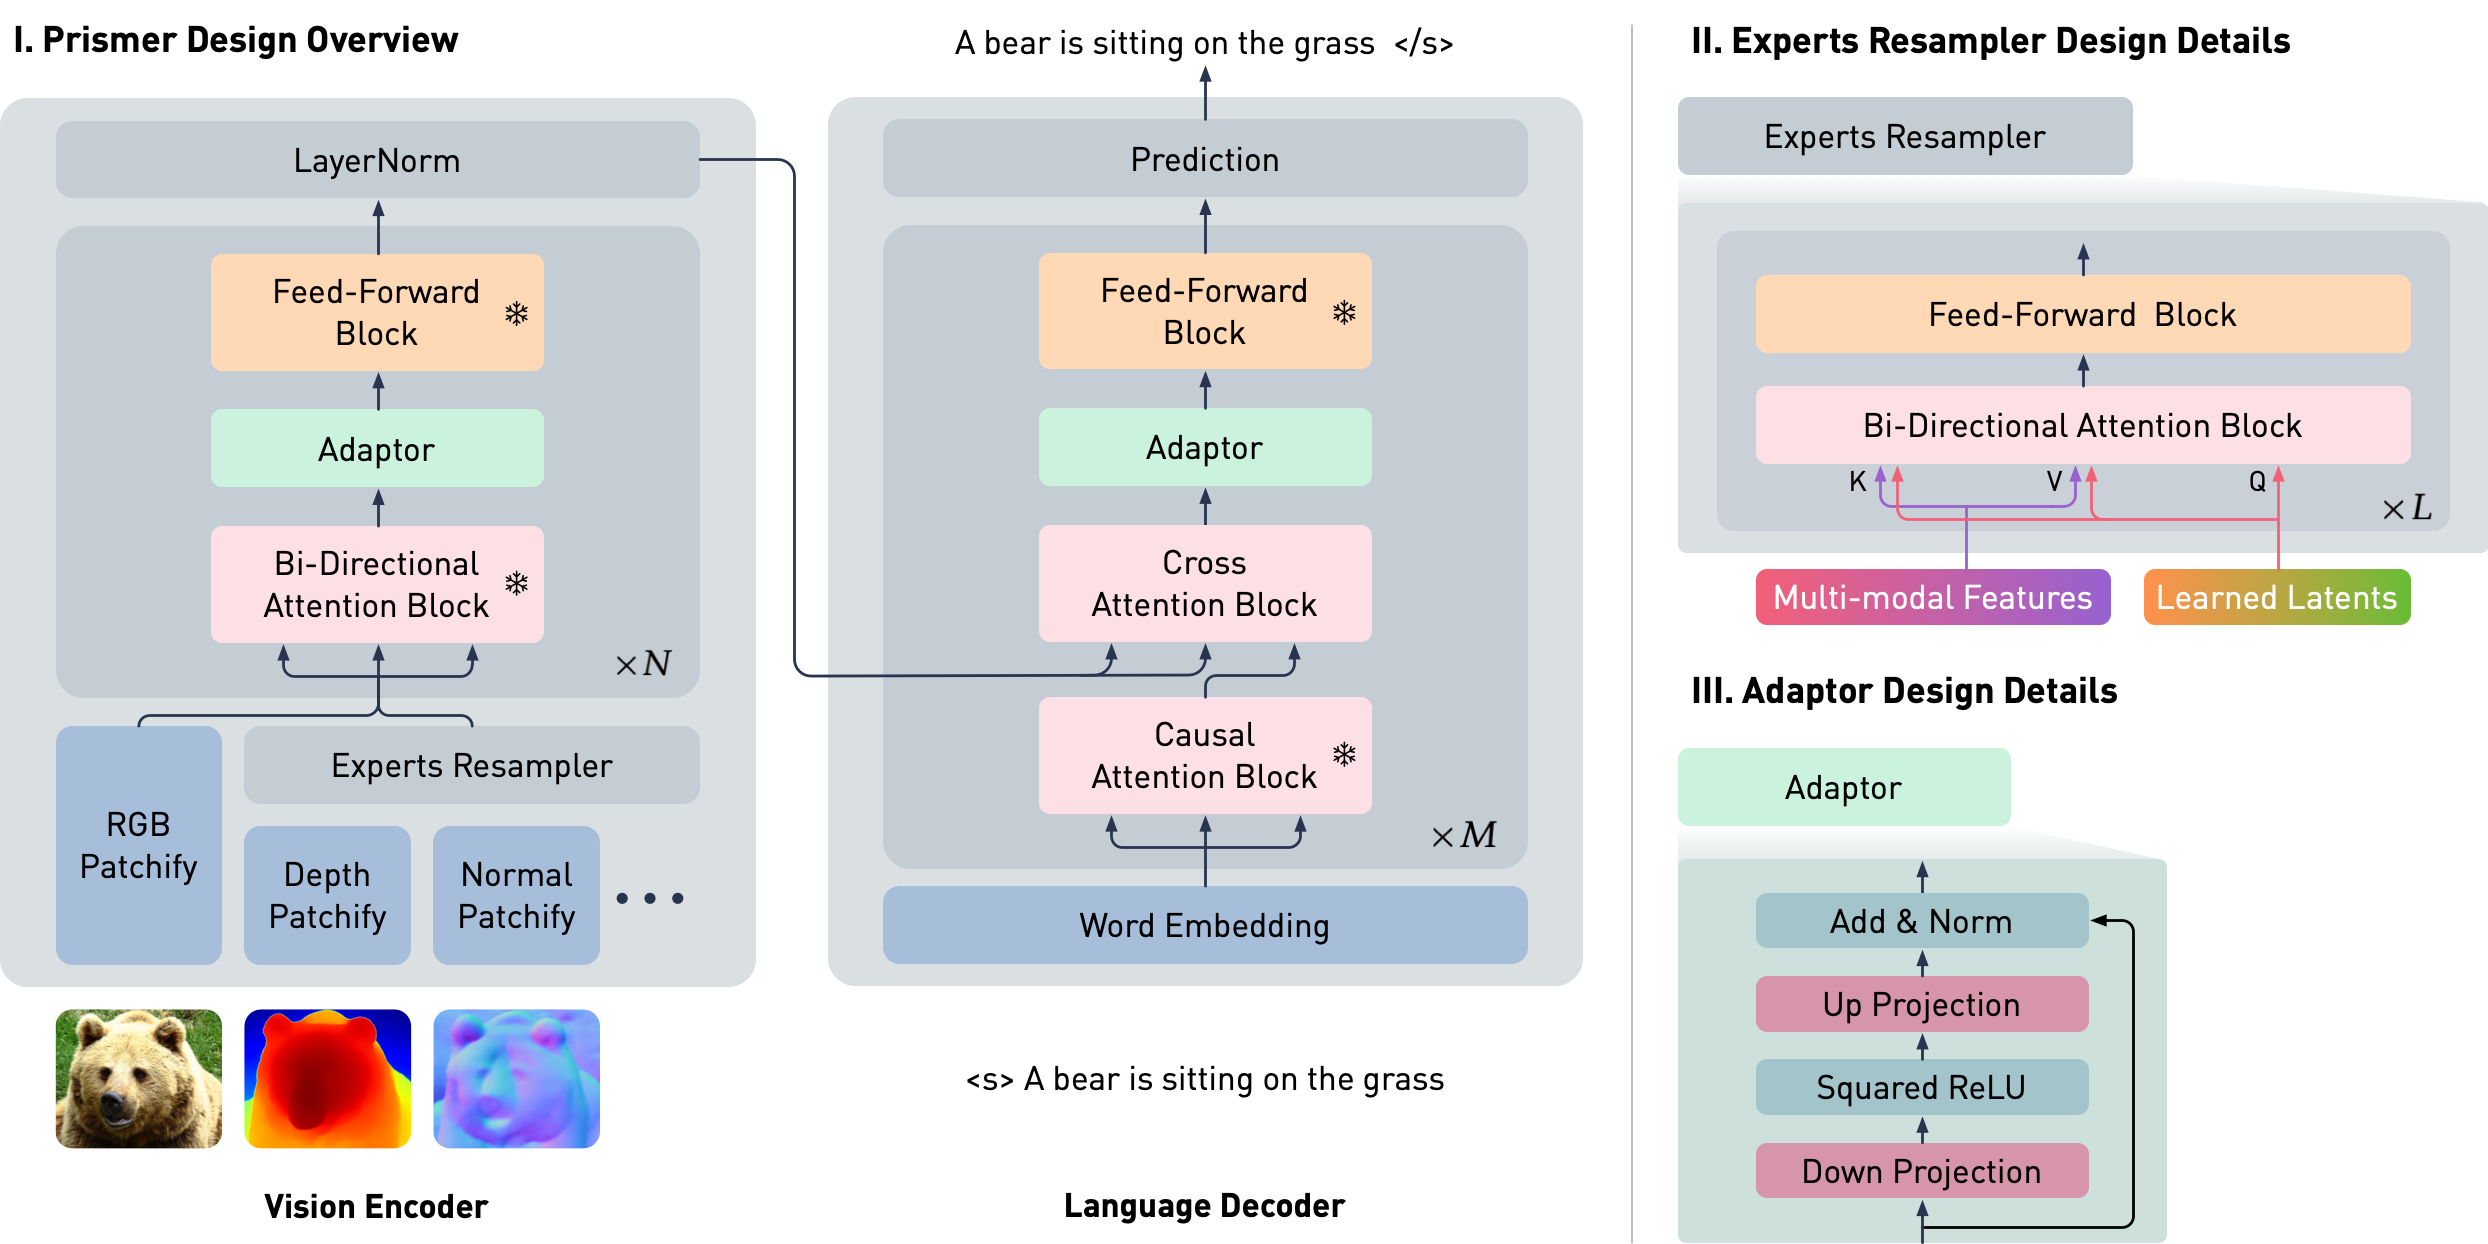
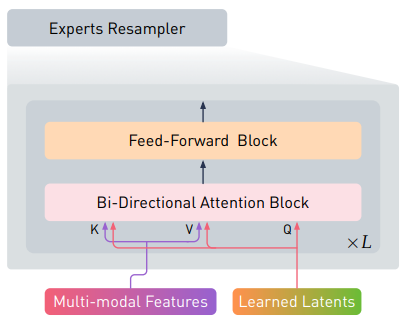
Prismer: A Vision-Language Model with Multi-Task Experts
走行動画を説明するLLMを作成し、80台のGPUで分散並列学習させた話
视觉大型语言模型(vLLMs)——让LLMs学会理解图像和视频,而不仅仅是文本 - 知乎
論文読み:Flamingo: a Visual Language Model for Few-Shot Learning
Vision Large Language Models (vLLMs)
Retrieval-Augmented Egocentric Video Captioning
论文阅读——Flamingo_perceiver resampler-CSDN博客
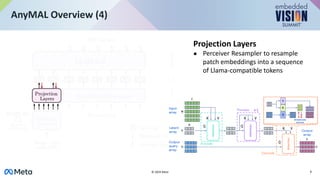
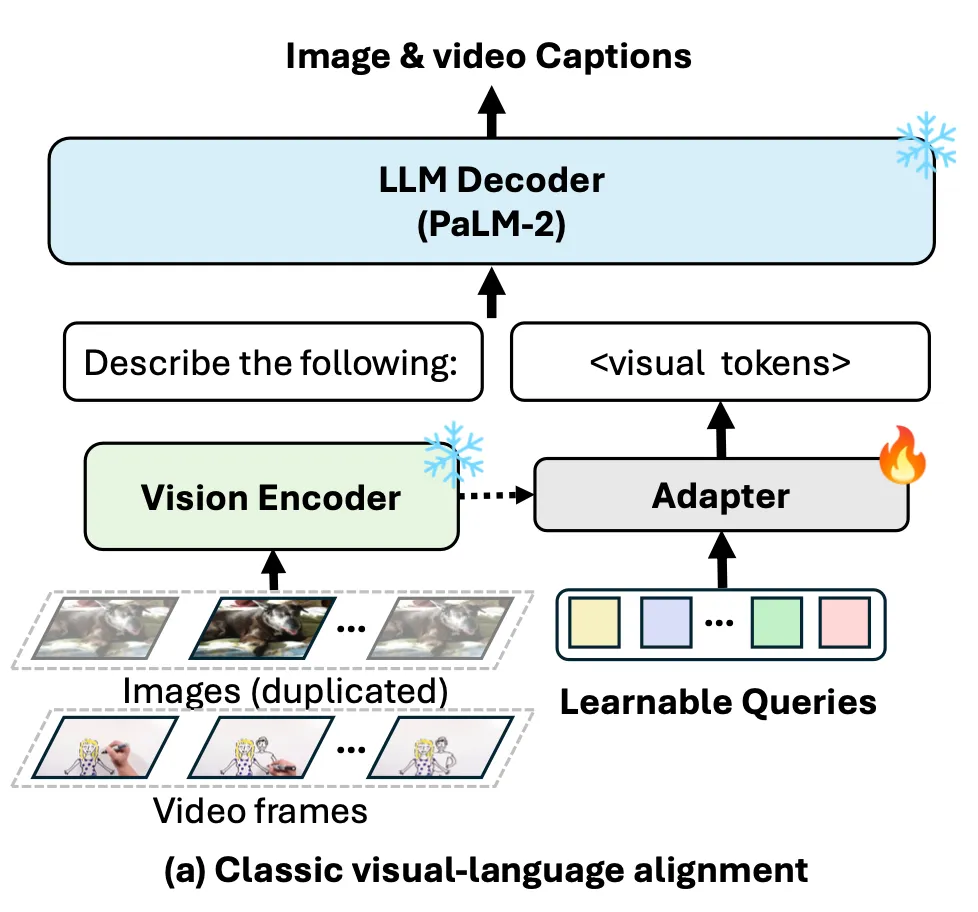
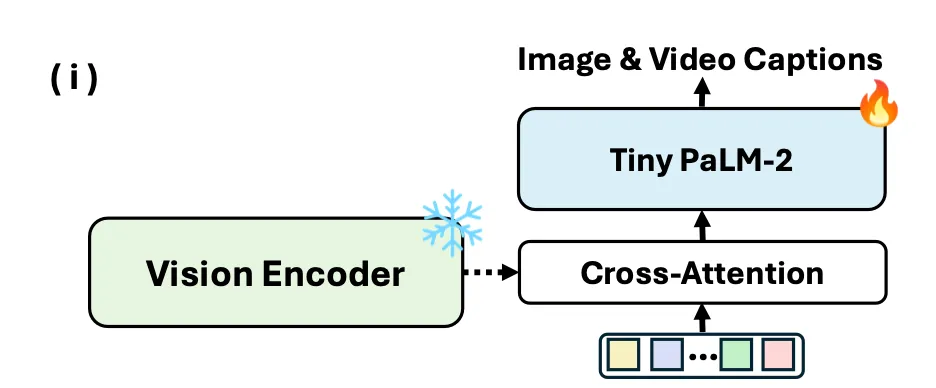
PaLM2-VAdapter
GPT-4的多模态能力是如何实现的? - 知乎
多模态大模型对齐方案 - 知乎
基于LLMs的多模态大模型(Flamingo, BLIP-2,KOSMOS-1,ScienceQA)_flamingo大模型-CSDN博客
RT-VLA: Real-Time Vision-Language-Action Models via Knowledge Distillation
ai大模型与LLM语言分析-CSDN博客
探索VLM架构:训练后的实验与深度思考-CSDN博客
Understanding Flamingo - DeepMind's VLM Architecture | PDF
Flamingo 논문 리뷰하기
多模态大模型: 盘点&Highlights part3——Gemini系列-CSDN博客
Prismer: A Vision-Language Model with An Esemble of Experts
Read Like a Radiologist: Efficient Vision-Language Model for 3D Medical ...
[2312.08914] CogAgent: A Visual Language Model for GUI Agents
CVPR'23 最新 70 篇论文分方向整理|包含目标检测、图像处理、人脸、医学影像、半监督学习等方向 - 知乎
【硬核干货】多模态大模型开发实战:小白程序员的AI进阶之路_svit-6模型-CSDN博客
Efficient GPT-4V level multimodal large language model for deployment ...
TOPOS: High-Fidelity and Efficient Industry-Grade 3D Head Generation
視覚、言語、音声、行動など220のタスクをカバーする120以上のデータセット
Image-video Encoder - 知乎
视觉语言机器人的大爆发:从RT2、VoxPoser、OK-Robot到Figure 01、清华CoPa_figure 01模仿学习-CSDN博客
Wayformer Paper Reading | Fuwei's Tech Notes
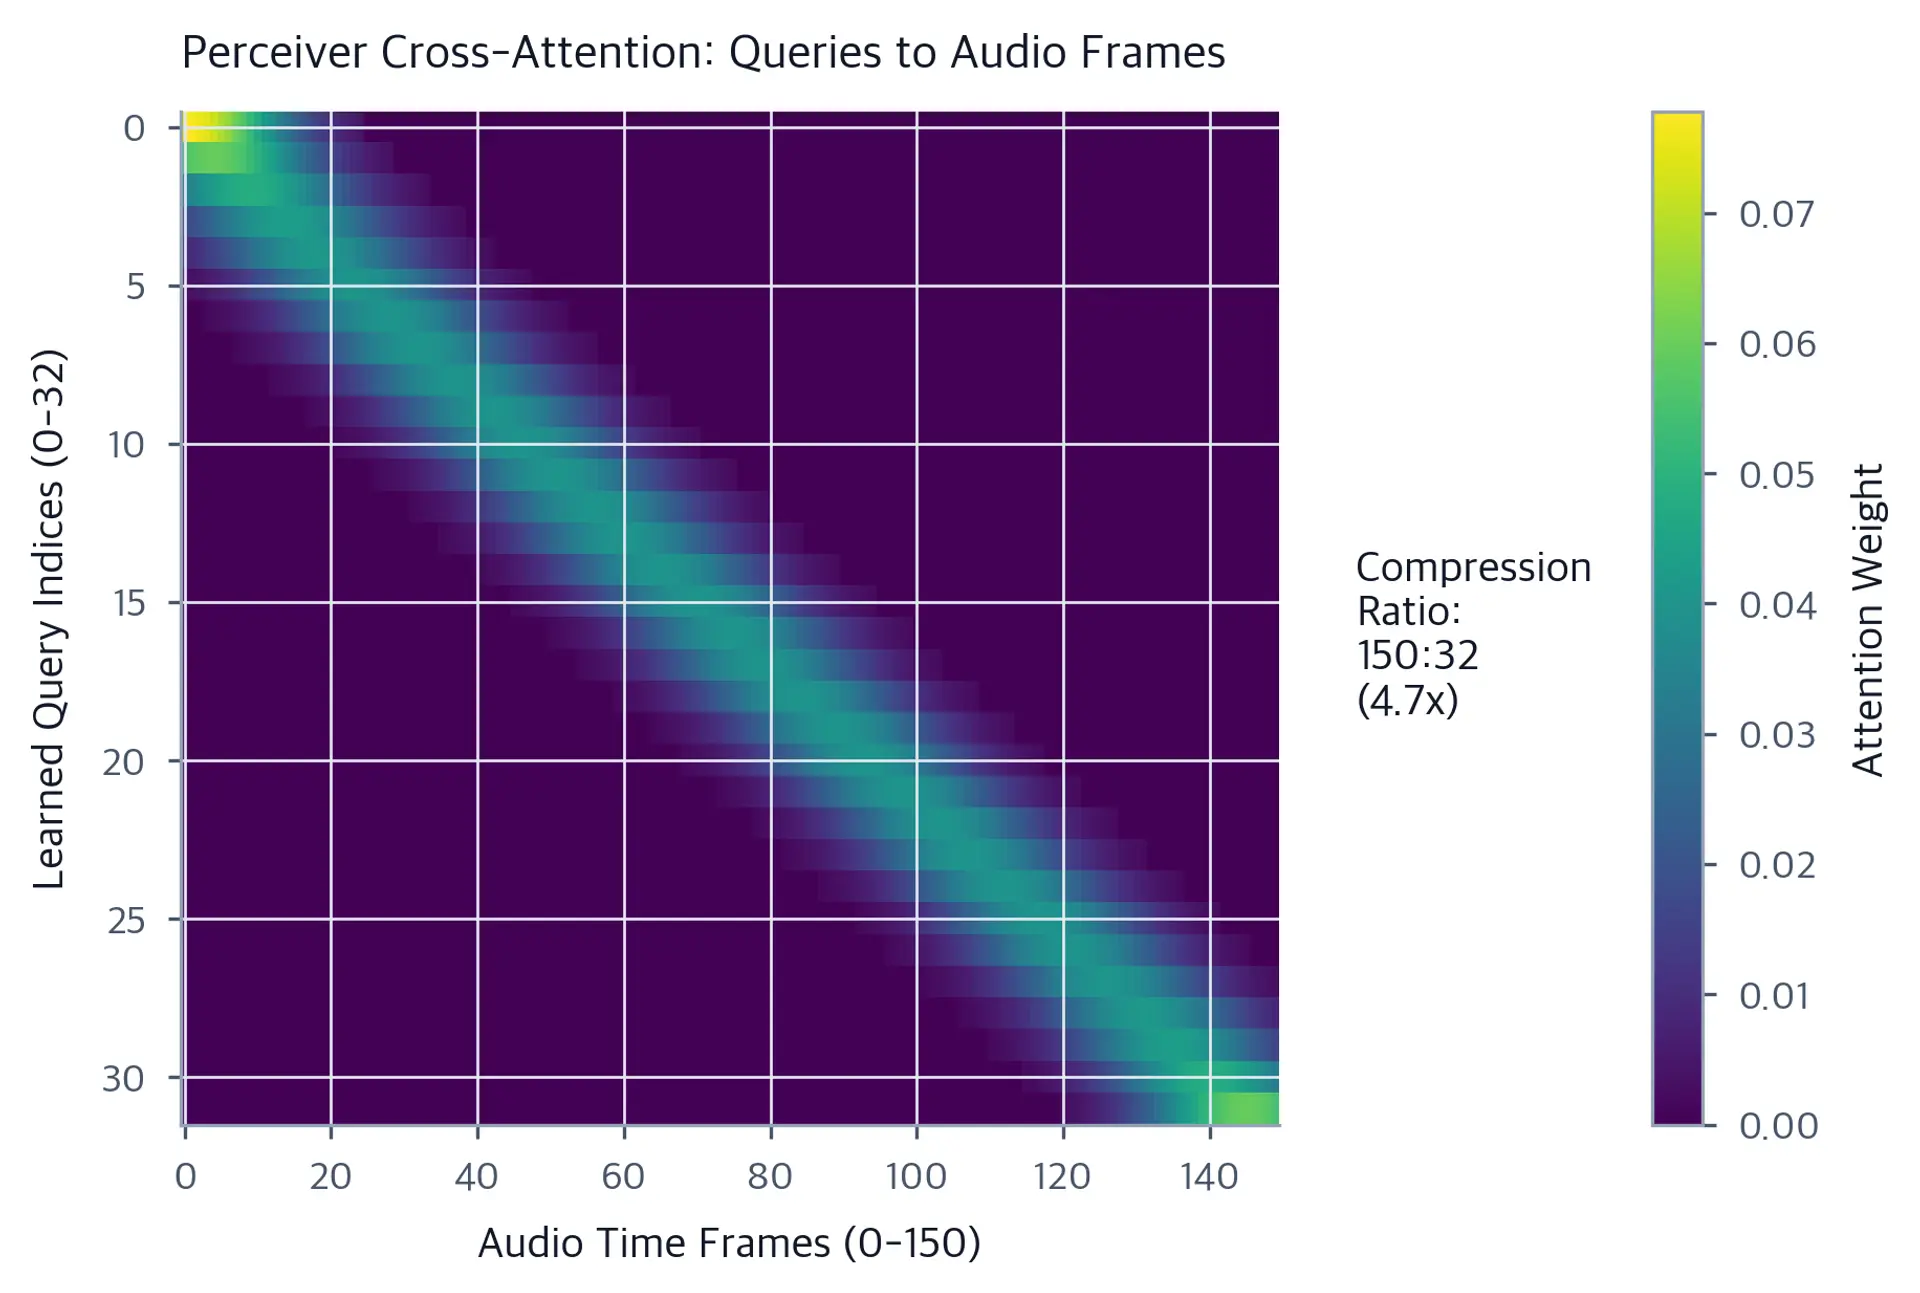
Speech-Language Integration: Connecting Audio to LLMs - Interactive ...
Deepmind Flamingo a Visual Language Model for Few Shot Learning 2022 ...
多模态中文LLaMA&Alpaca模型 VisualCLA - 知乎
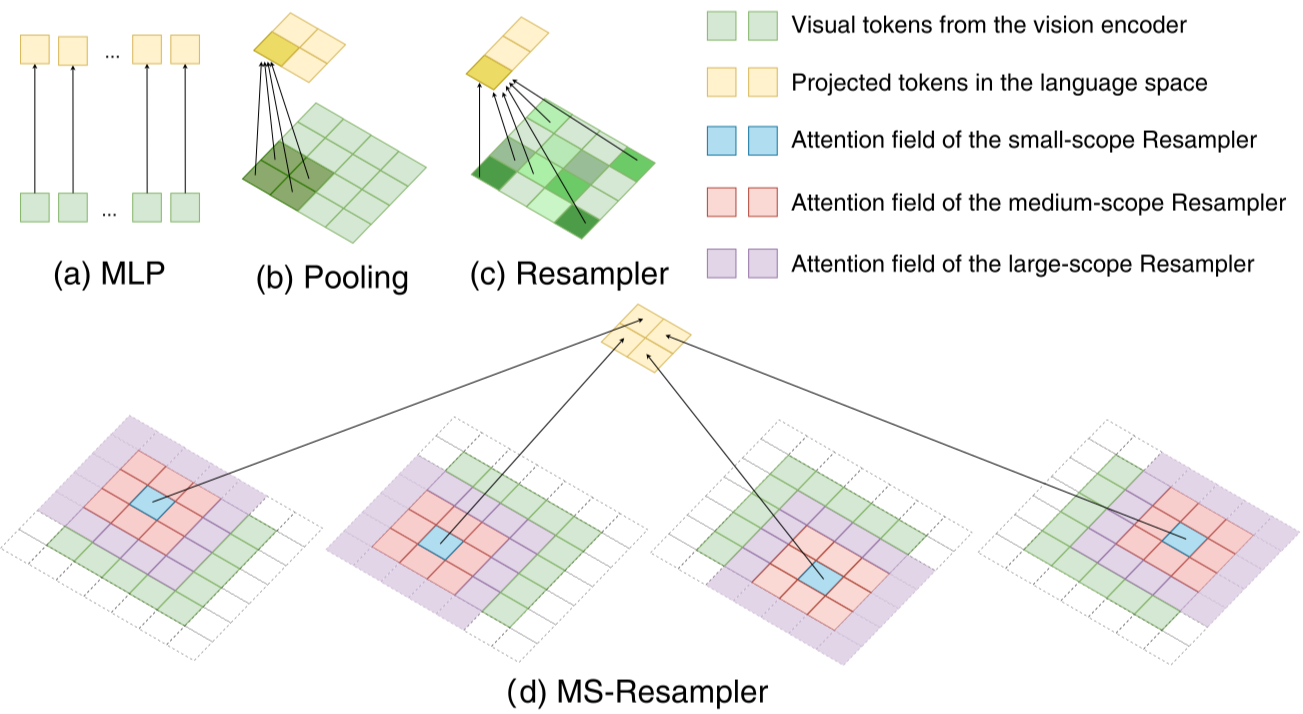
[논문 리뷰] MS-Resampler: Multi-Scope Visual Resampling for Efficient ...