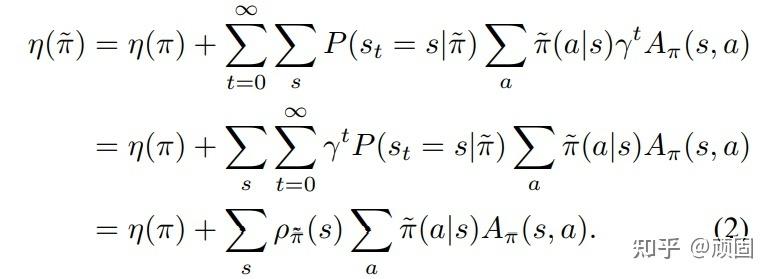Showing 120 of 120on this page. Filters & sort apply to loaded results; URL updates for sharing.120 of 120 on this page
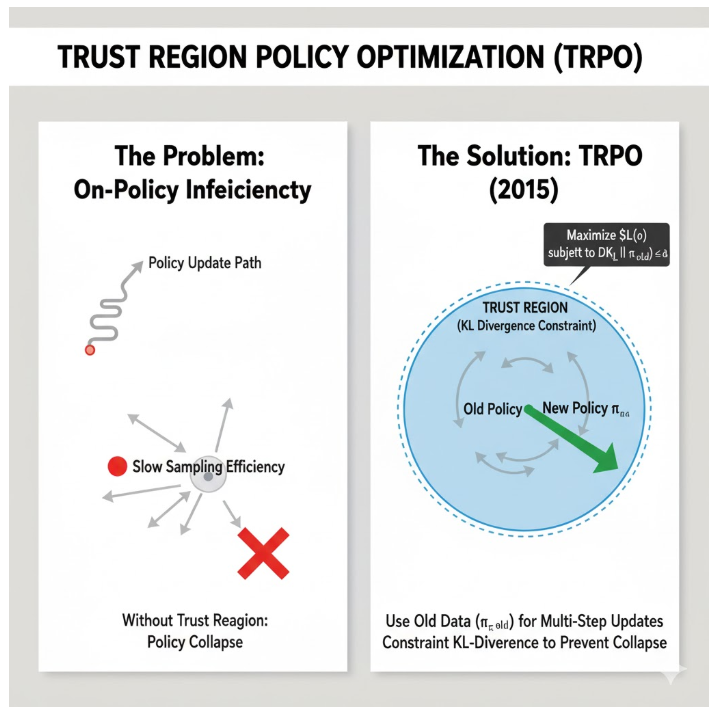
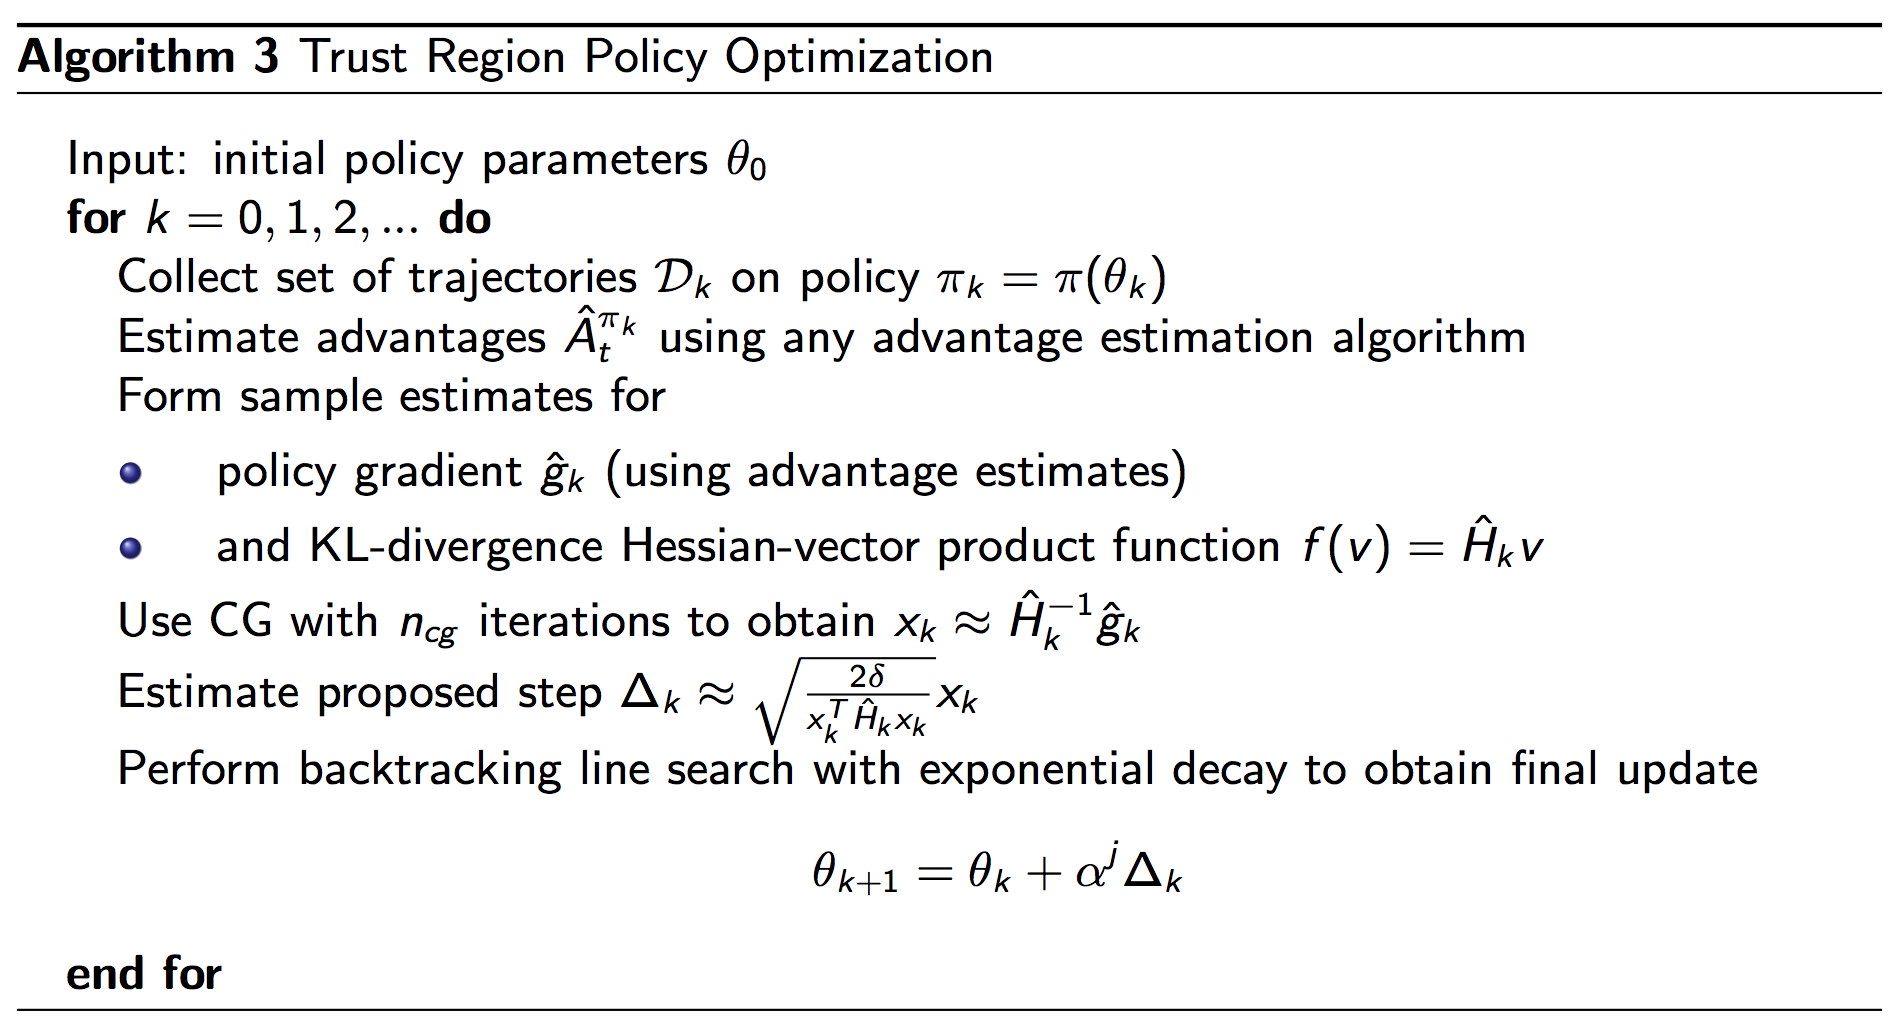
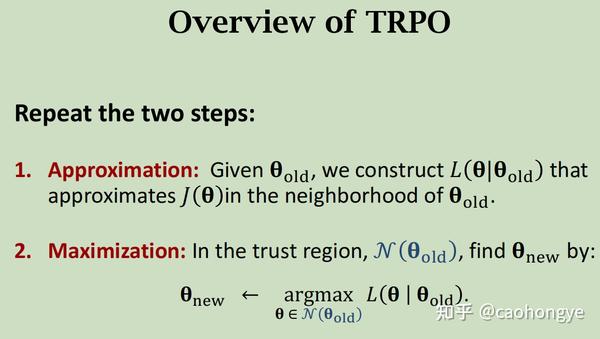
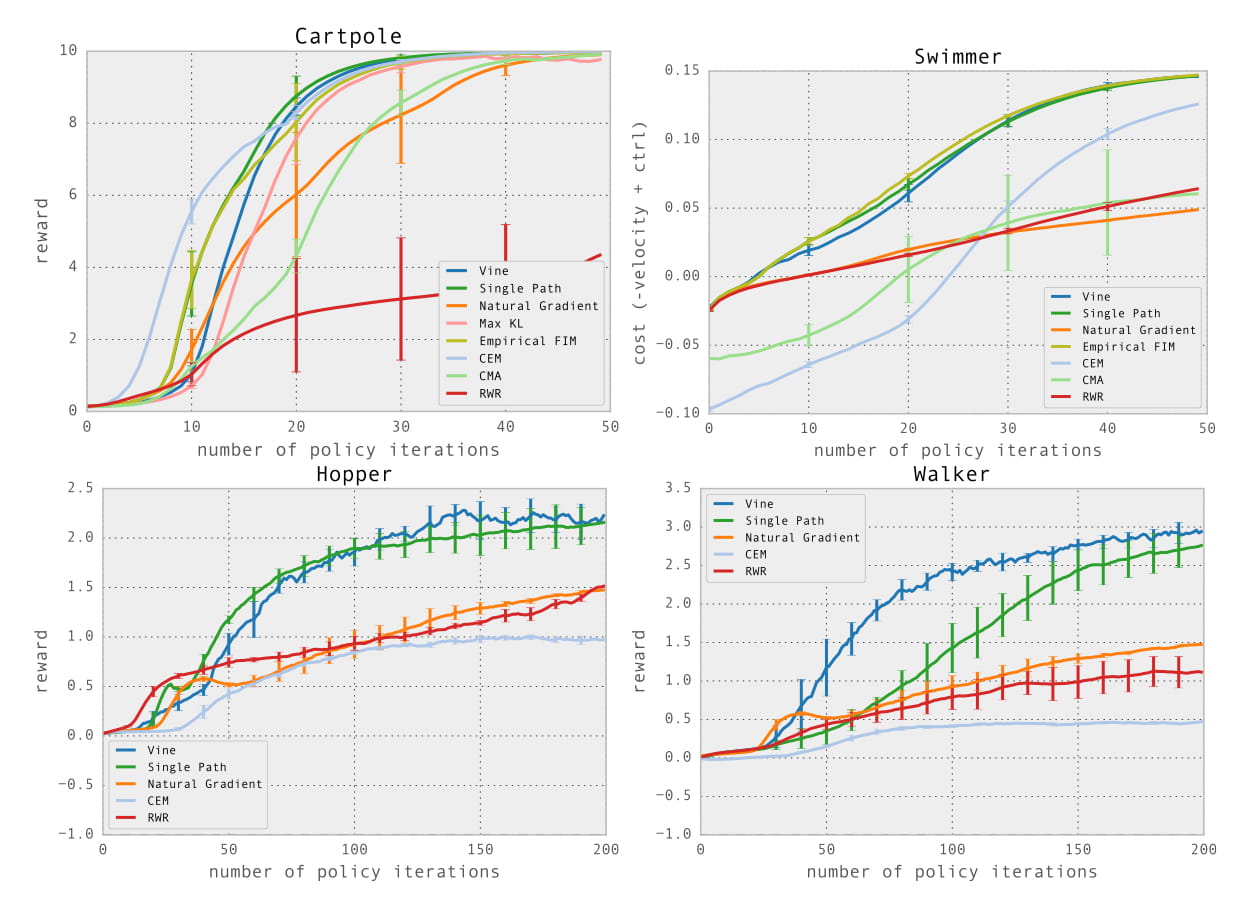
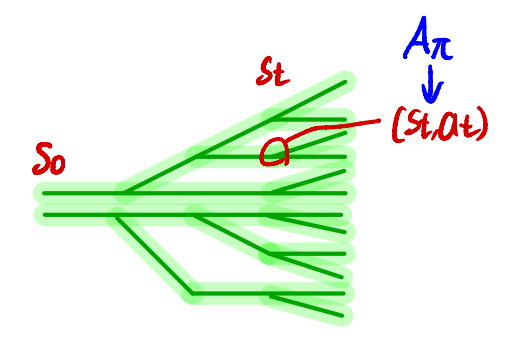
Visualization of the TRPO algorithm concept. | Download Scientific Diagram
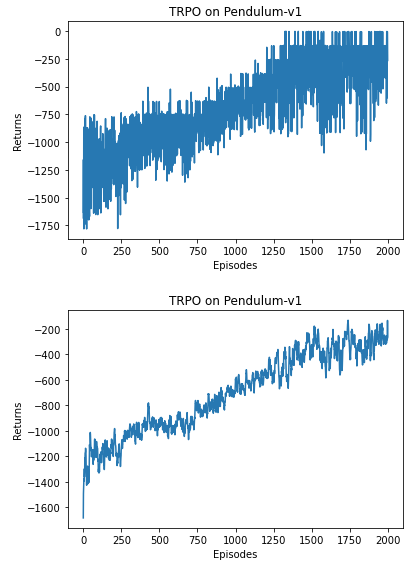
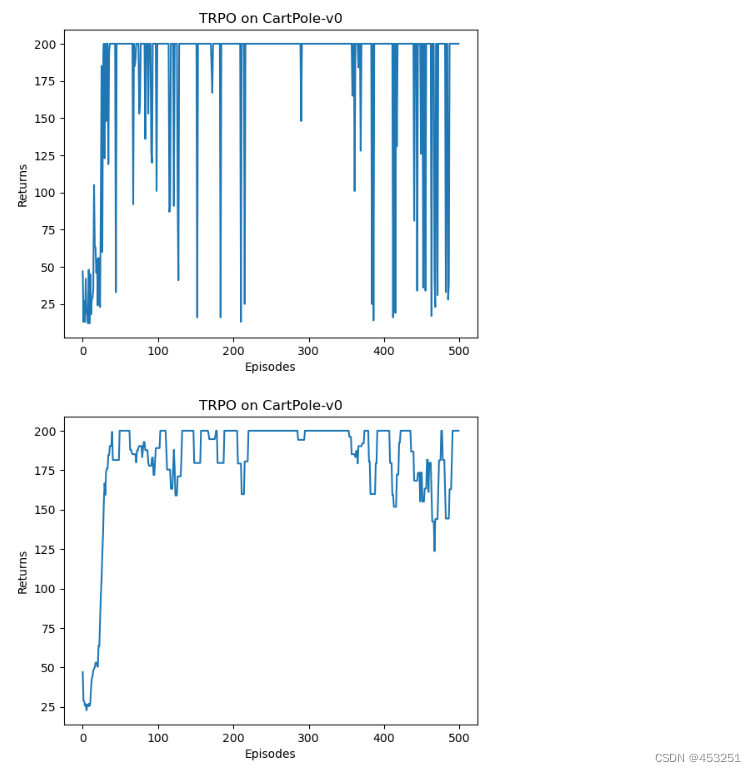
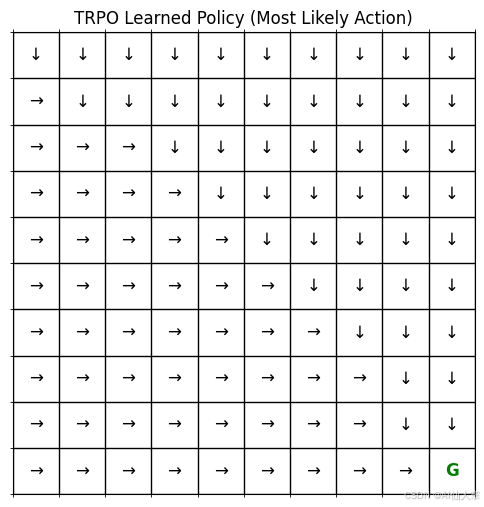
result of training three times with the TRPO algorithm | Download ...
UofT RL Course - Lecture 51: TRPO Algorithm - YouTube
the performance of a single recommended item with TRPO algorithm under ...
Model-based TRPO framework. | Download Scientific Diagram
TRPO 算法 | JoyRL Book
Speeding up TRPO through parallelization and parameter adaptation
强化学习 | TRPO | PPO | 超详细 | 手写笔记(2) - 知乎
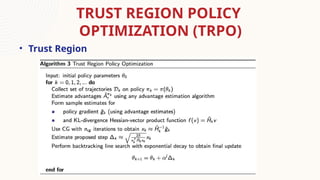
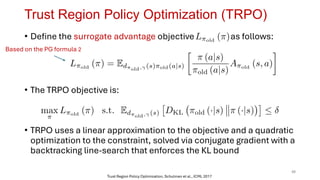
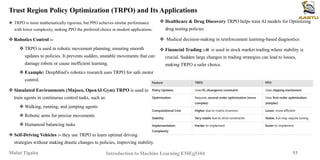
TRPO PPO in reinforcement learning.pptx
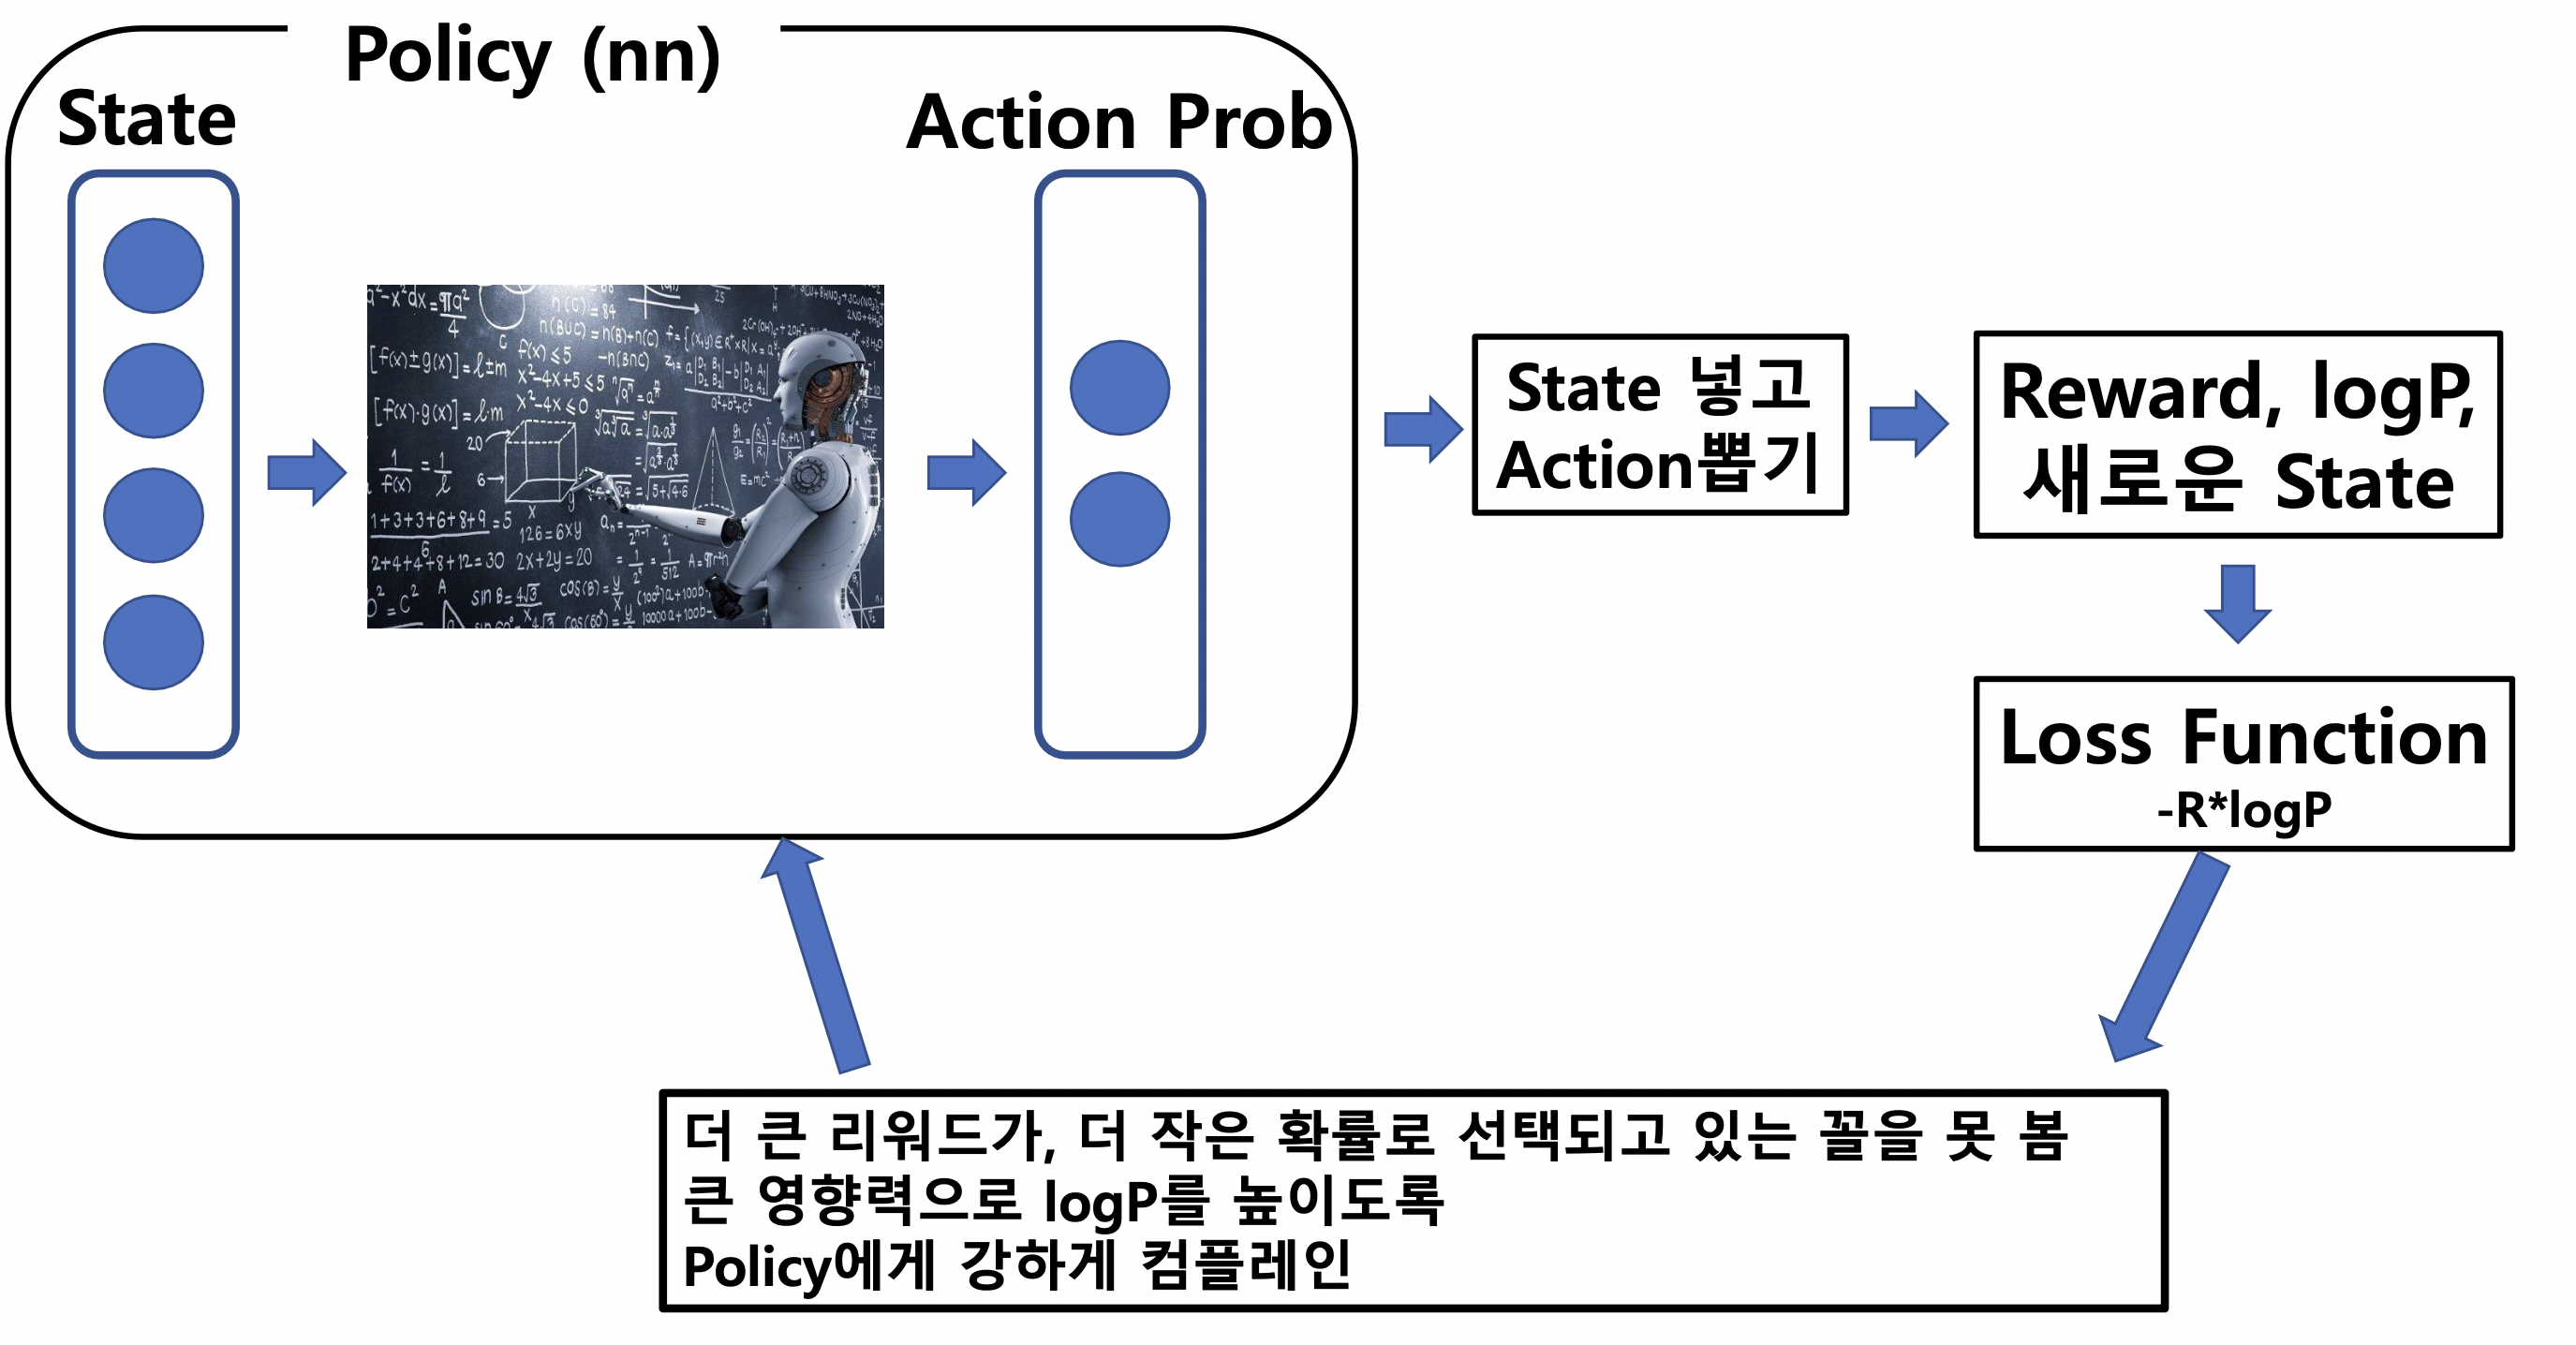
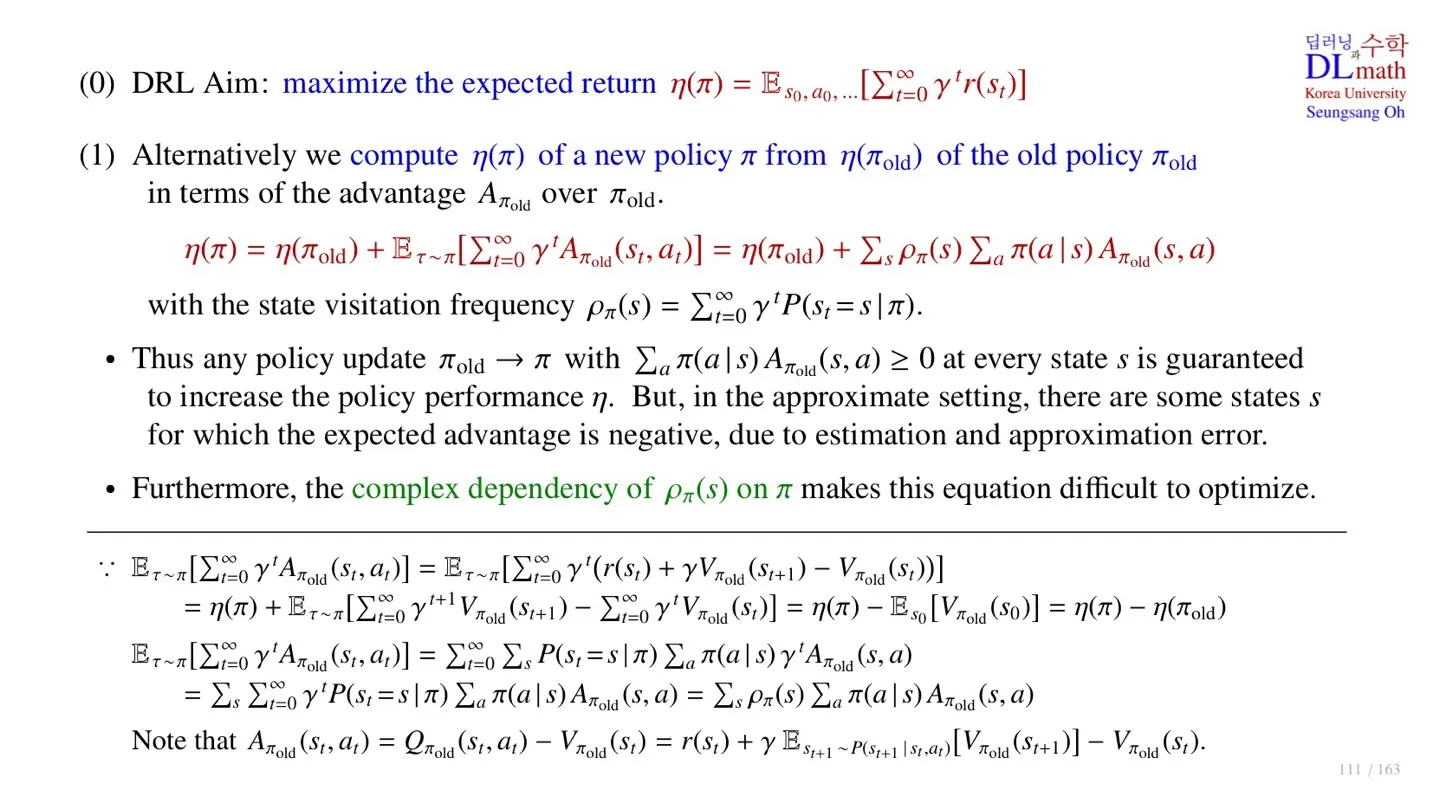
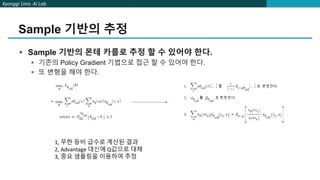
[Deep Reinforcement Learning] 28강 TRPO 2
[HUFS RL] 강화학습 : Reinforcement Learning: TRPO (Trust Region Policy ...
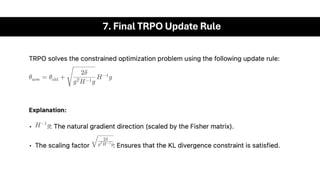
TRPO 算法
TRPO with best hyper-parameter configurations, with average of 5 runs ...
trpo | Figma
Evaluation of the training progress of TRPO algorithm. 50 episodes were ...
[Deep Reinforcement Learning] 29강 TRPO 3
GitHub - AdamFattum/TRPO: TRPO - Trust Region Policy Optimization A ...
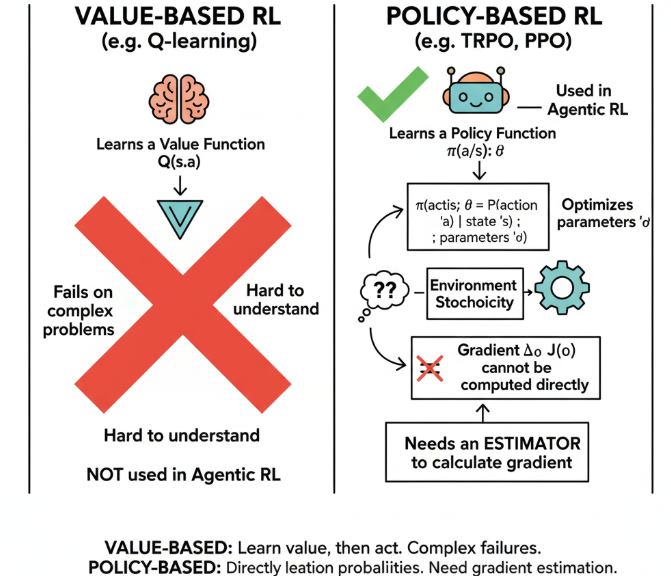
【Agentic RL 专题】三、深入浅出强化学习算法 TRPO 和PPO_trpo模型 复杂-CSDN博客
Comparison of PPO and TRPO robustness. | Download Scientific Diagram
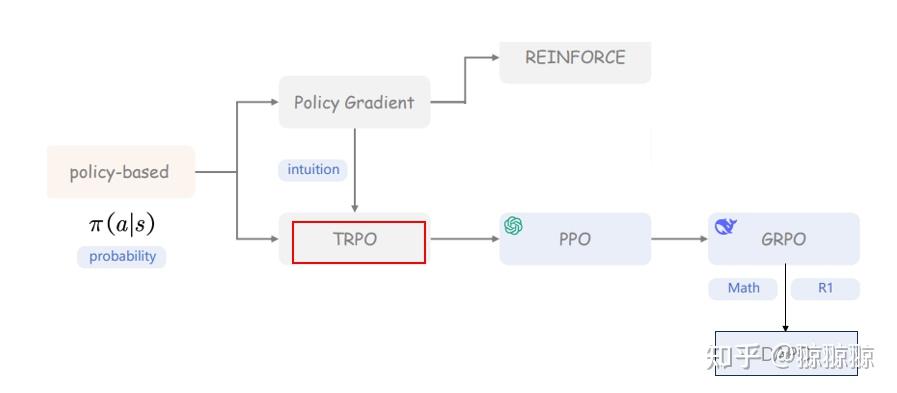
Trust Region Methods: From REINFORCE to TRPO to PPO
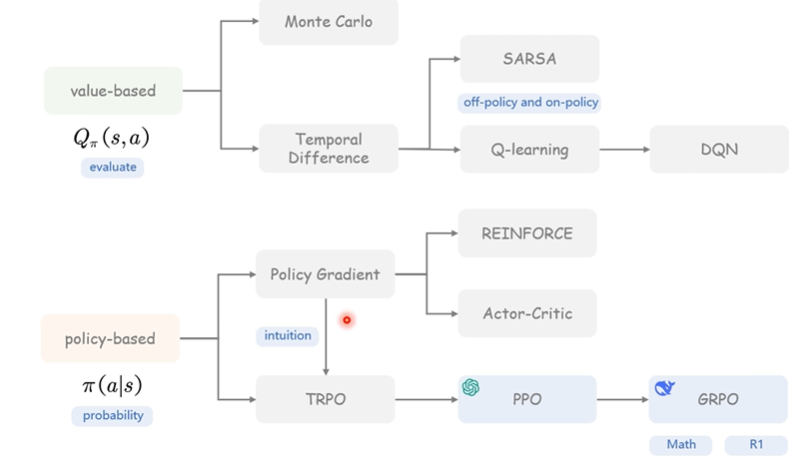
一文全面入门强化学习:从基础概念、策略梯度、REINFORCE、RLOO、TRPO到PPO、GRPO算法_强化学习 trpo ppo-CSDN博客
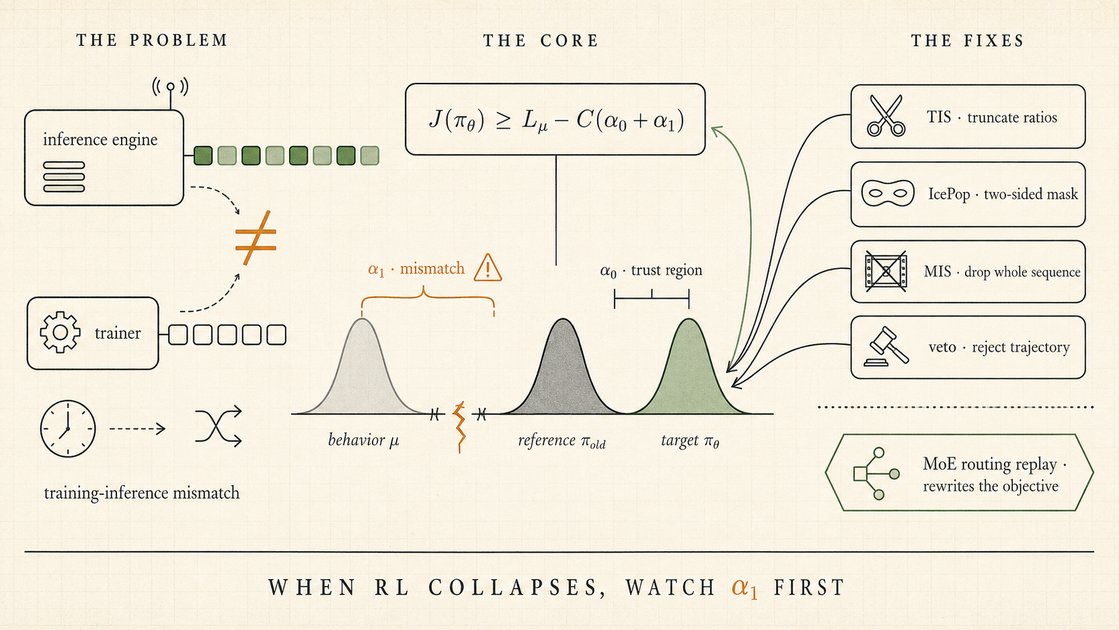
From Two Policies to Three: Extending TRPO under Behavior–Reference ...
Average training returns of PPO and TRPO on MuJoCo environments. The ...
Performance of TRPO with and without VIME on the high-dimensional ...
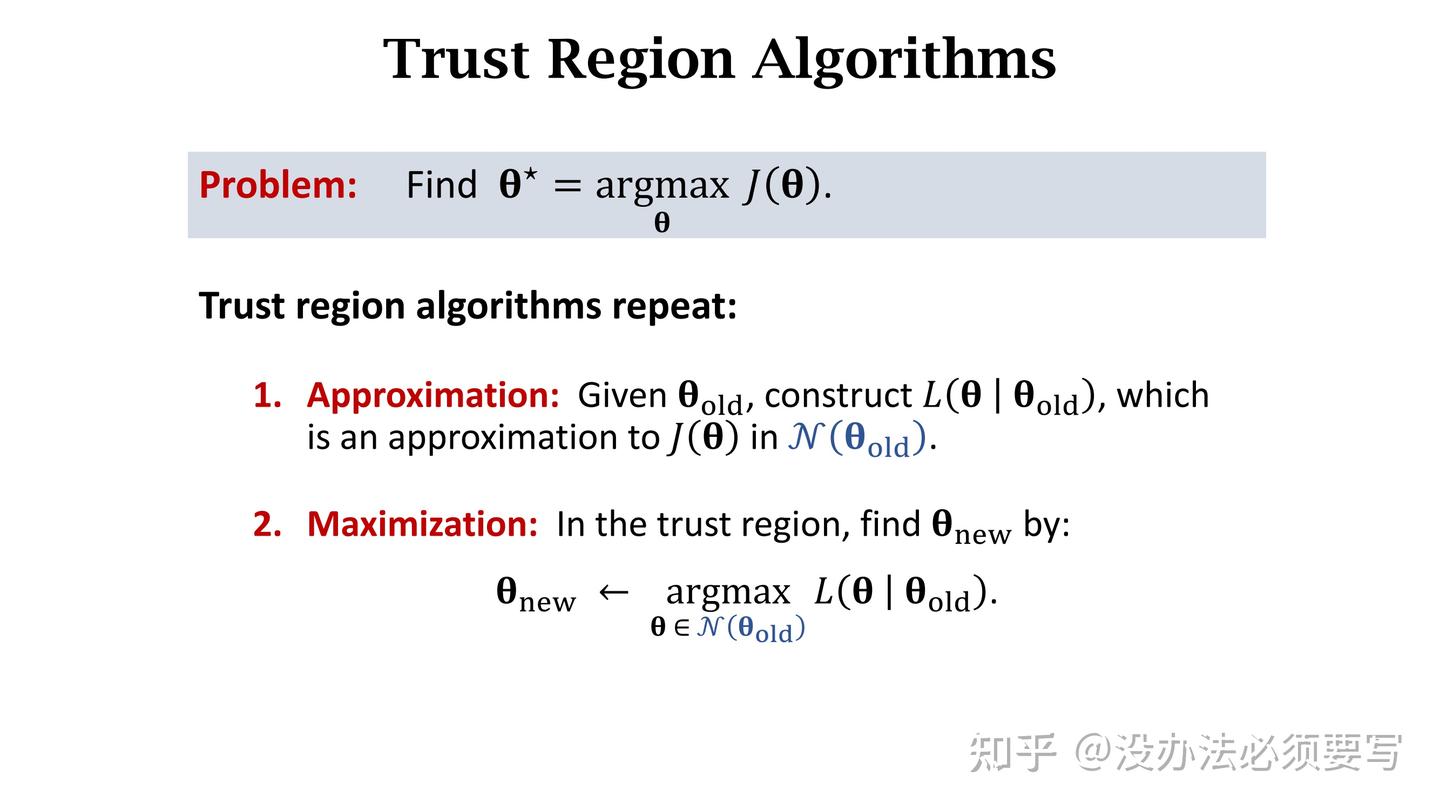
Trust Region Policy Optimization
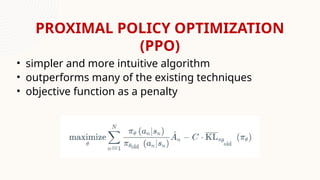
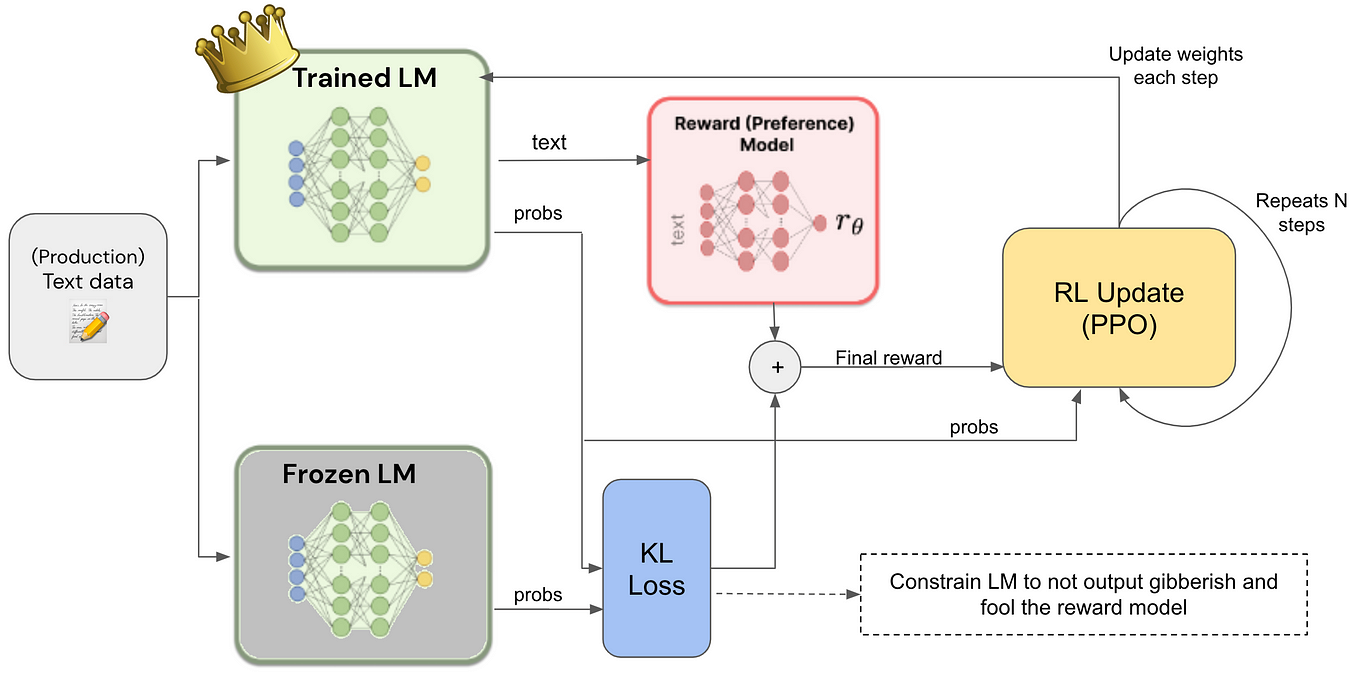
Proximal Policy Optimization (PPO) Explained | Towards Data Science
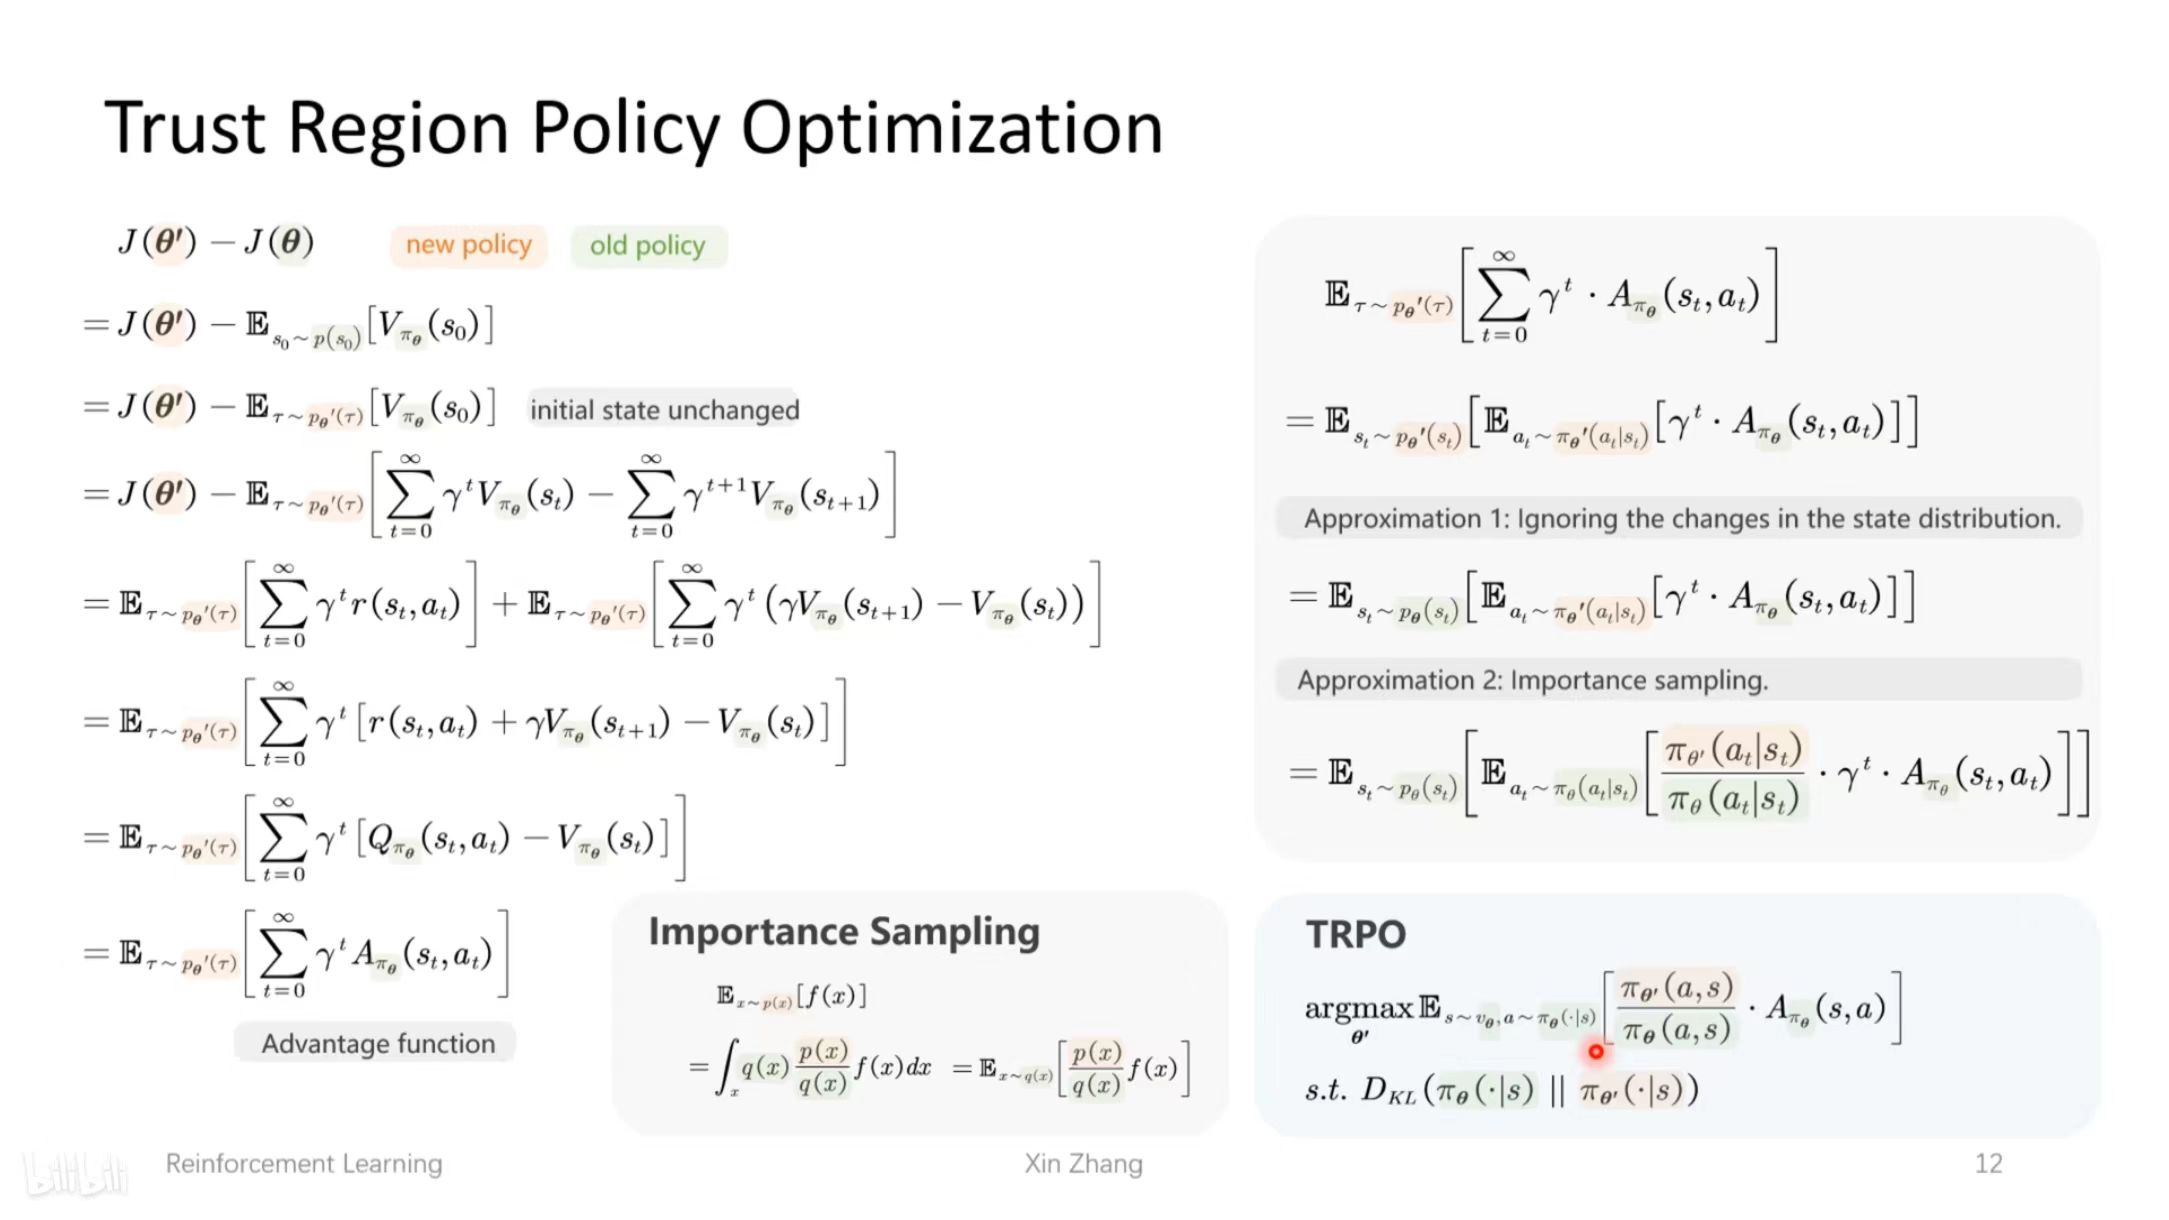
Trust Region Policy Optimization (TRPO) - 知乎
王树森深度强化学习笔记19:置信域策略优化(Trust Region Policy Optimization,TRPO) - 知乎
Trust Region Policy Optimization (TRPO) Explained | Towards Data Science
A Deep Dive into LLM Optimization: From Policy Gradient to GRPO
14. Trust Region Policy Optimization (TRPO) — 심층강화학습
Deep RL Bootcamp Lecture 5: Natural Policy Gradients, TRPO, PPO - YouTube
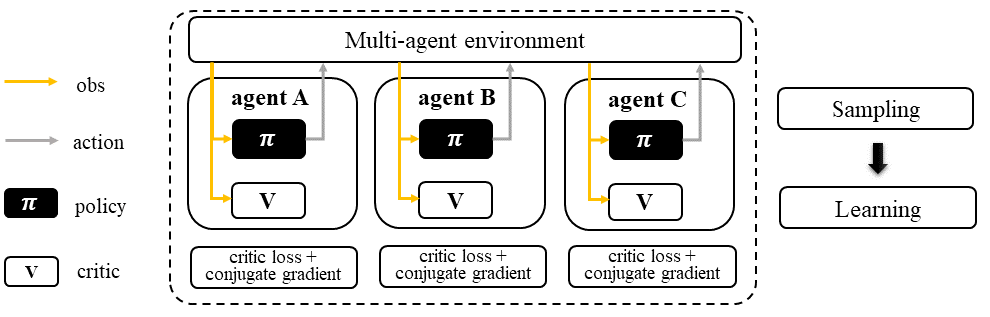
Trust Region Policy Optimization Family — MARLlib v1.0.0 documentation
Networks used to represent policy in TRPO. | Download Scientific Diagram
Trust Region Policy Optimization (TRPO) Explained | by Wouter van ...
【RL Base】强化学习:信赖域策略优化(TRPO)算法-腾讯云开发者社区-腾讯云
【图解LLM · RL】之:PPO/GRPO/TRPO/GAE/策略梯度/A2C/优势函数/重要性采样/Actor-Critic - 知乎
Deep Reinforcement Learning
【ICLR 2018】模型集成的TRPO算法【附代码】_trpo算法 demo-CSDN博客
Reinforcement-Learning-in-LLM-such-as-GPT-and-Deepseek.pdf
Reinforcement Learning for LM/VLM Reasoning | PDF
[1709.06560] Deep Reinforcement Learning that Matters
Proximal Policy Optimization (PPO) - Explained | Dilith Jayakody
Trust Region Policy Optimization (TRPO) - A Quick Introduction | Dilith ...
강화학습 알고리즘: TRPO(Trust Region Policy Optimization) | L__107
强化学习小记——观其大略 - 知乎
Lecture 10, Reinforcement Learning, Proximal Policy Optimization | PDF
RL - Trust Region Policy Optimization (TRPO) | NIUHE
TRPO_trpo算法-CSDN博客
从DeepSeek-R1中了解强化学习的策略优化,从PPO, TRPO到GRPO - 知乎
RLHF笔记-从策略梯度到PPO - 知乎
近端策略优化算法(Proximal Policy Optimization Algorithms, PPO) - 凯鲁嘎吉 - 博客园
Trust Region Policy Optimization (TRPO) 背后的数学原理_trpo算法的思路-CSDN博客
《动手学强化学习》笔记 第二部分 强化学习进阶 第11章 TRPO算法 - 知乎
TRPO算法详解-CSDN博客
在强化学习中,为什么TRPO和PPO算法属于On-Policy的算法? - 知乎
PPO: Proximal Policy Optimization Algorithms - 知乎
强化学习学习之:TRPO,PPO 算法-CSDN博客
[강화학습] Trust Region Policy Optimization (TRPO) 정리 - 재야의 숨은 초보
Implementing Trust Region Policy Optimization (TRPO) and Proximal ...
TRPO(trust region policy optimization) | PPTX
Luc Coupal blog | Do implementation details matter in Deep ...
TRPO与PPO - 知乎
Trust Region Policy Optimization (TRPO)
从传统RL到Agentic RL - 知乎
PG,TRPO,PPO,GRPO,DPO原理梳理-CSDN博客
个人认为写得最好的TRPO讲解_surrogate model reinforcement learning-CSDN博客
LLM基础学习05:TRPO/PPO/DPO理论解析及基于GRPO训练的Qwen2.5-1.5B-Instruct在GSM8K上的效果验证 - 知乎
动手学强化学习笔记-TRPO算法_trpo算法 csdn-CSDN博客
强化学习 | TRPO(Trust Region Policy Optimization)_wx60ee4c080349a的技术博客_51CTO博客
Learning agile and dynamic motor skills for legged robots | PPTX
培训大语言模型:从TRPO到GRPO |迈向数据科学 - OurCoders (我们程序员)
从TRPO到GRPO-CSDN博客
(WIP)TRPO, Trust Region Policy Optimization | helpingstar
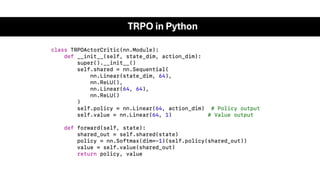
信赖域策略优化TRPO算法详解:python从零实现_trpo python 实现-CSDN博客
一文全面入门强化学习:从基础概念、策略梯度、REINFORCE、RLOO、TRPO到PPO、GRPO算法 - 知乎
7.5.TRPO与PPO - 知乎
【DRL-17】TRPO vs. PPO - 知乎
LLM Optimization: Optimizing AI with GRPO, PPO, and DPO
强化学习 safe RL小综述 从TRPO出发 捋清CPO | CUP - 知乎
Comprehensive Introduction to Reinforcement Learning in AI and Control ...
Regularization coefficient variations for TRPO. Cited implementation ...