Showing 113 of 113on this page. Filters & sort apply to loaded results; URL updates for sharing.113 of 113 on this page
Training large ViT models on ImageNet-1K. For wall time training ...
Vit Large - a Hugging Face Space by FSU-Pulsar
Vision Large Language Models (vLLMs)
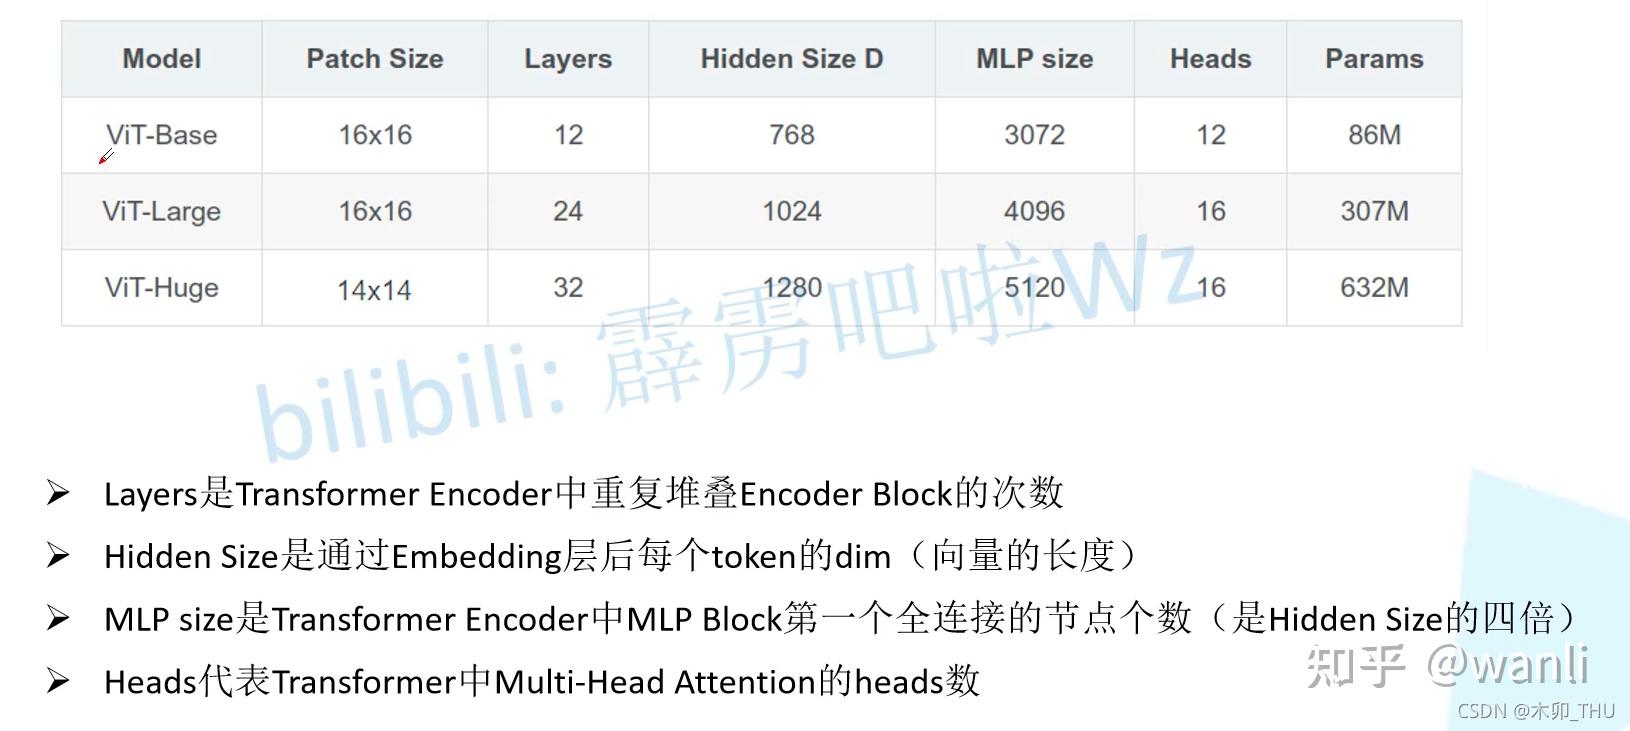
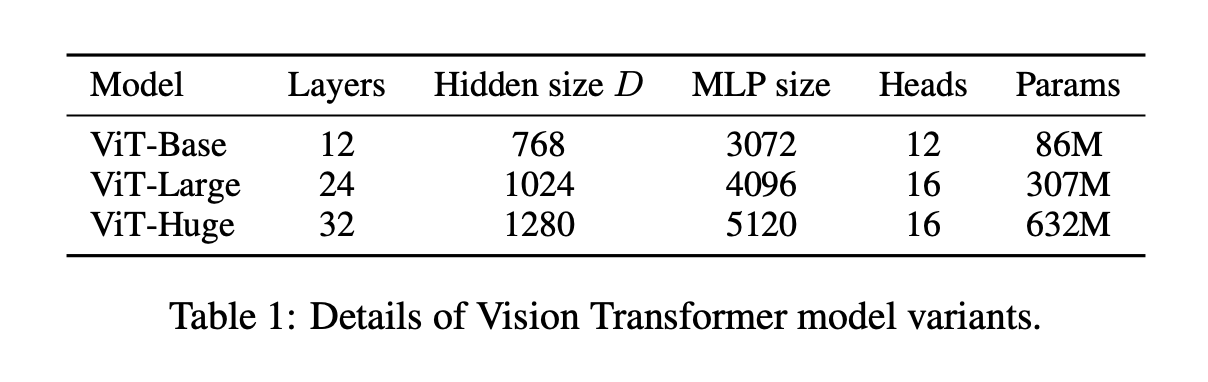
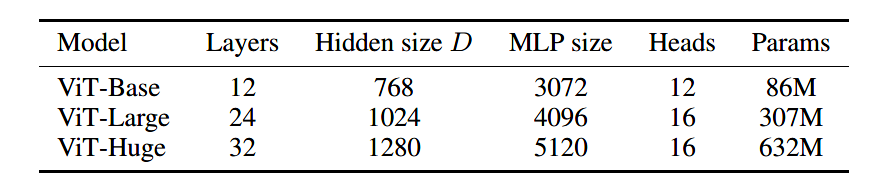
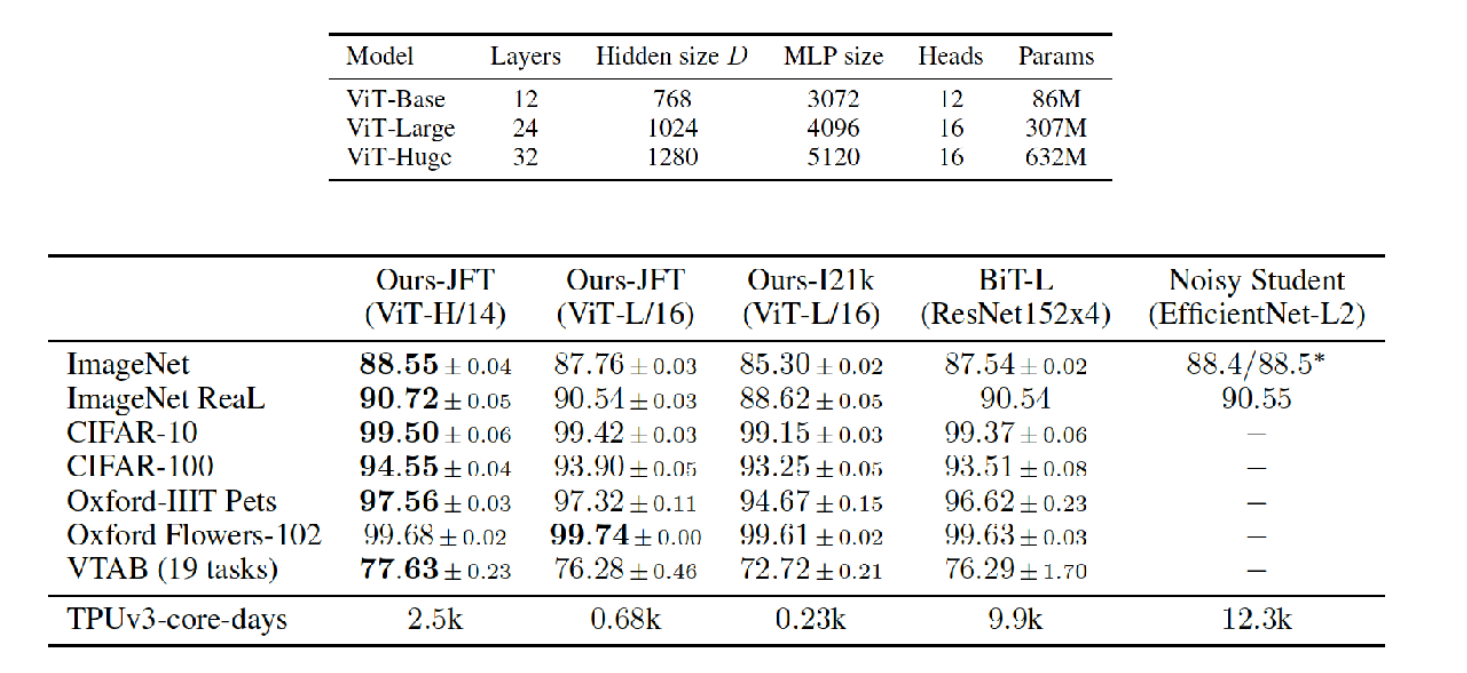
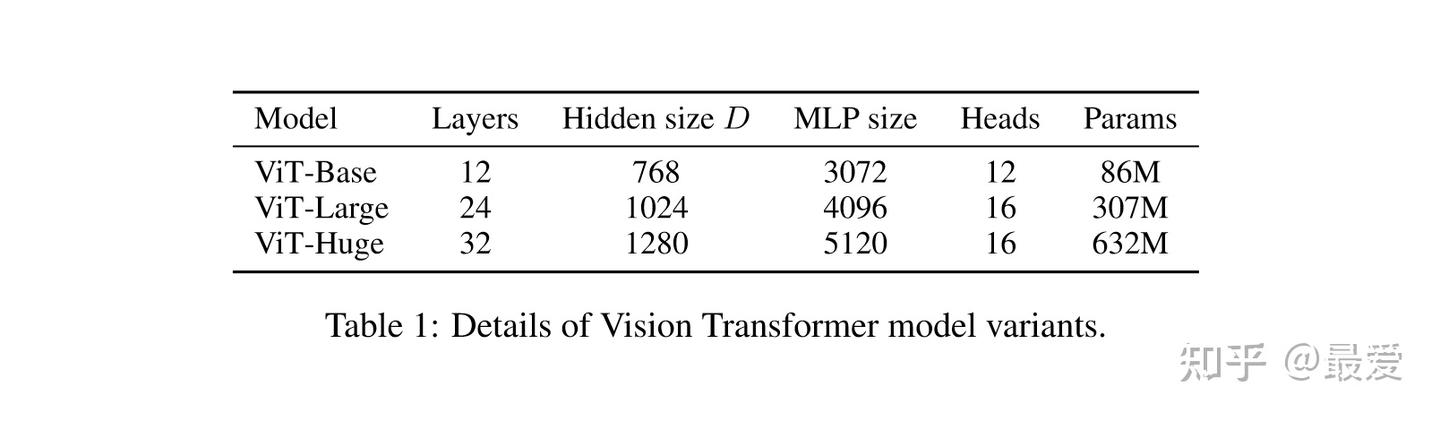
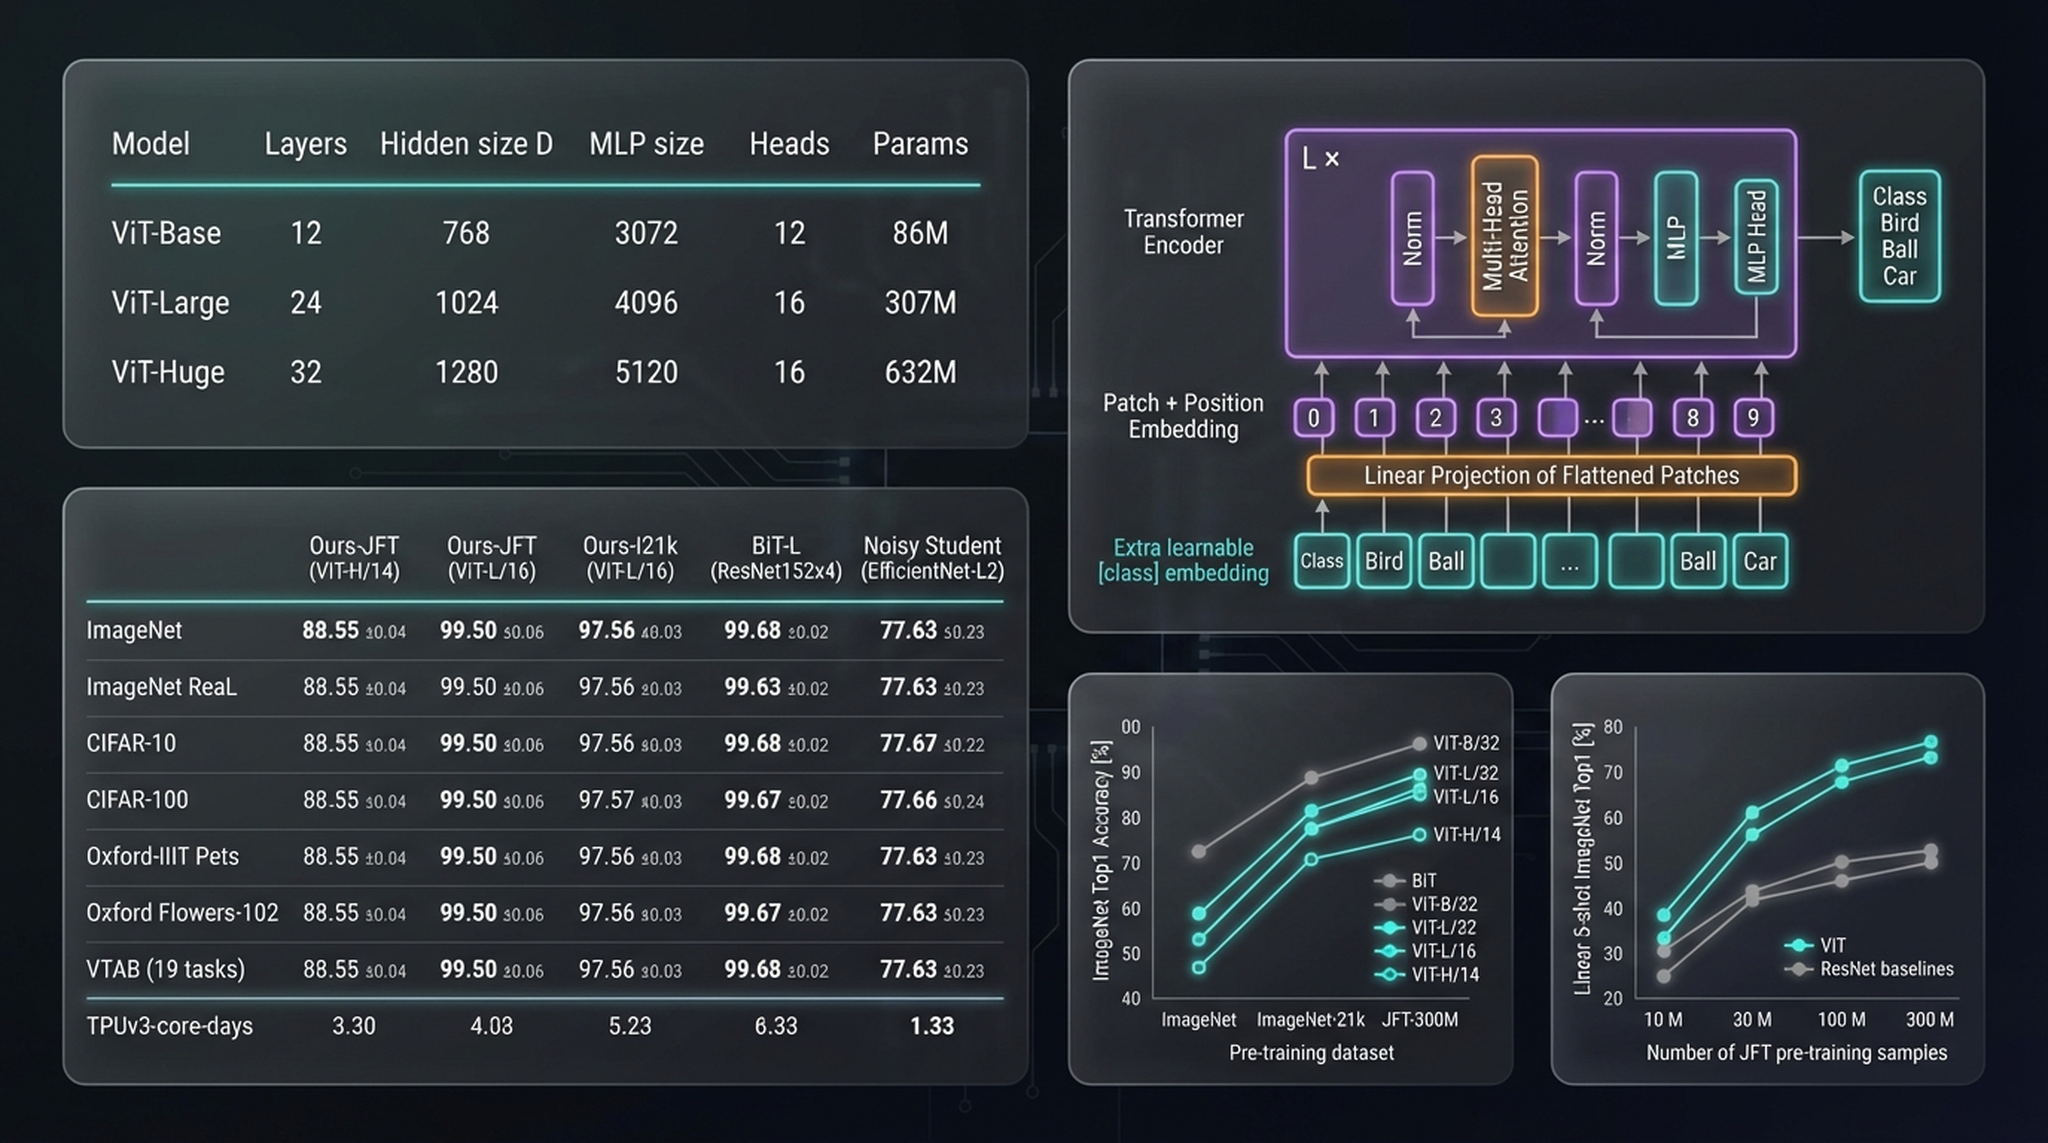
The three basic ViT architectures, namely ViT-Base, ViT-Large and ...
ViT 模型变体 (一) - 知乎
ViT - 溶err
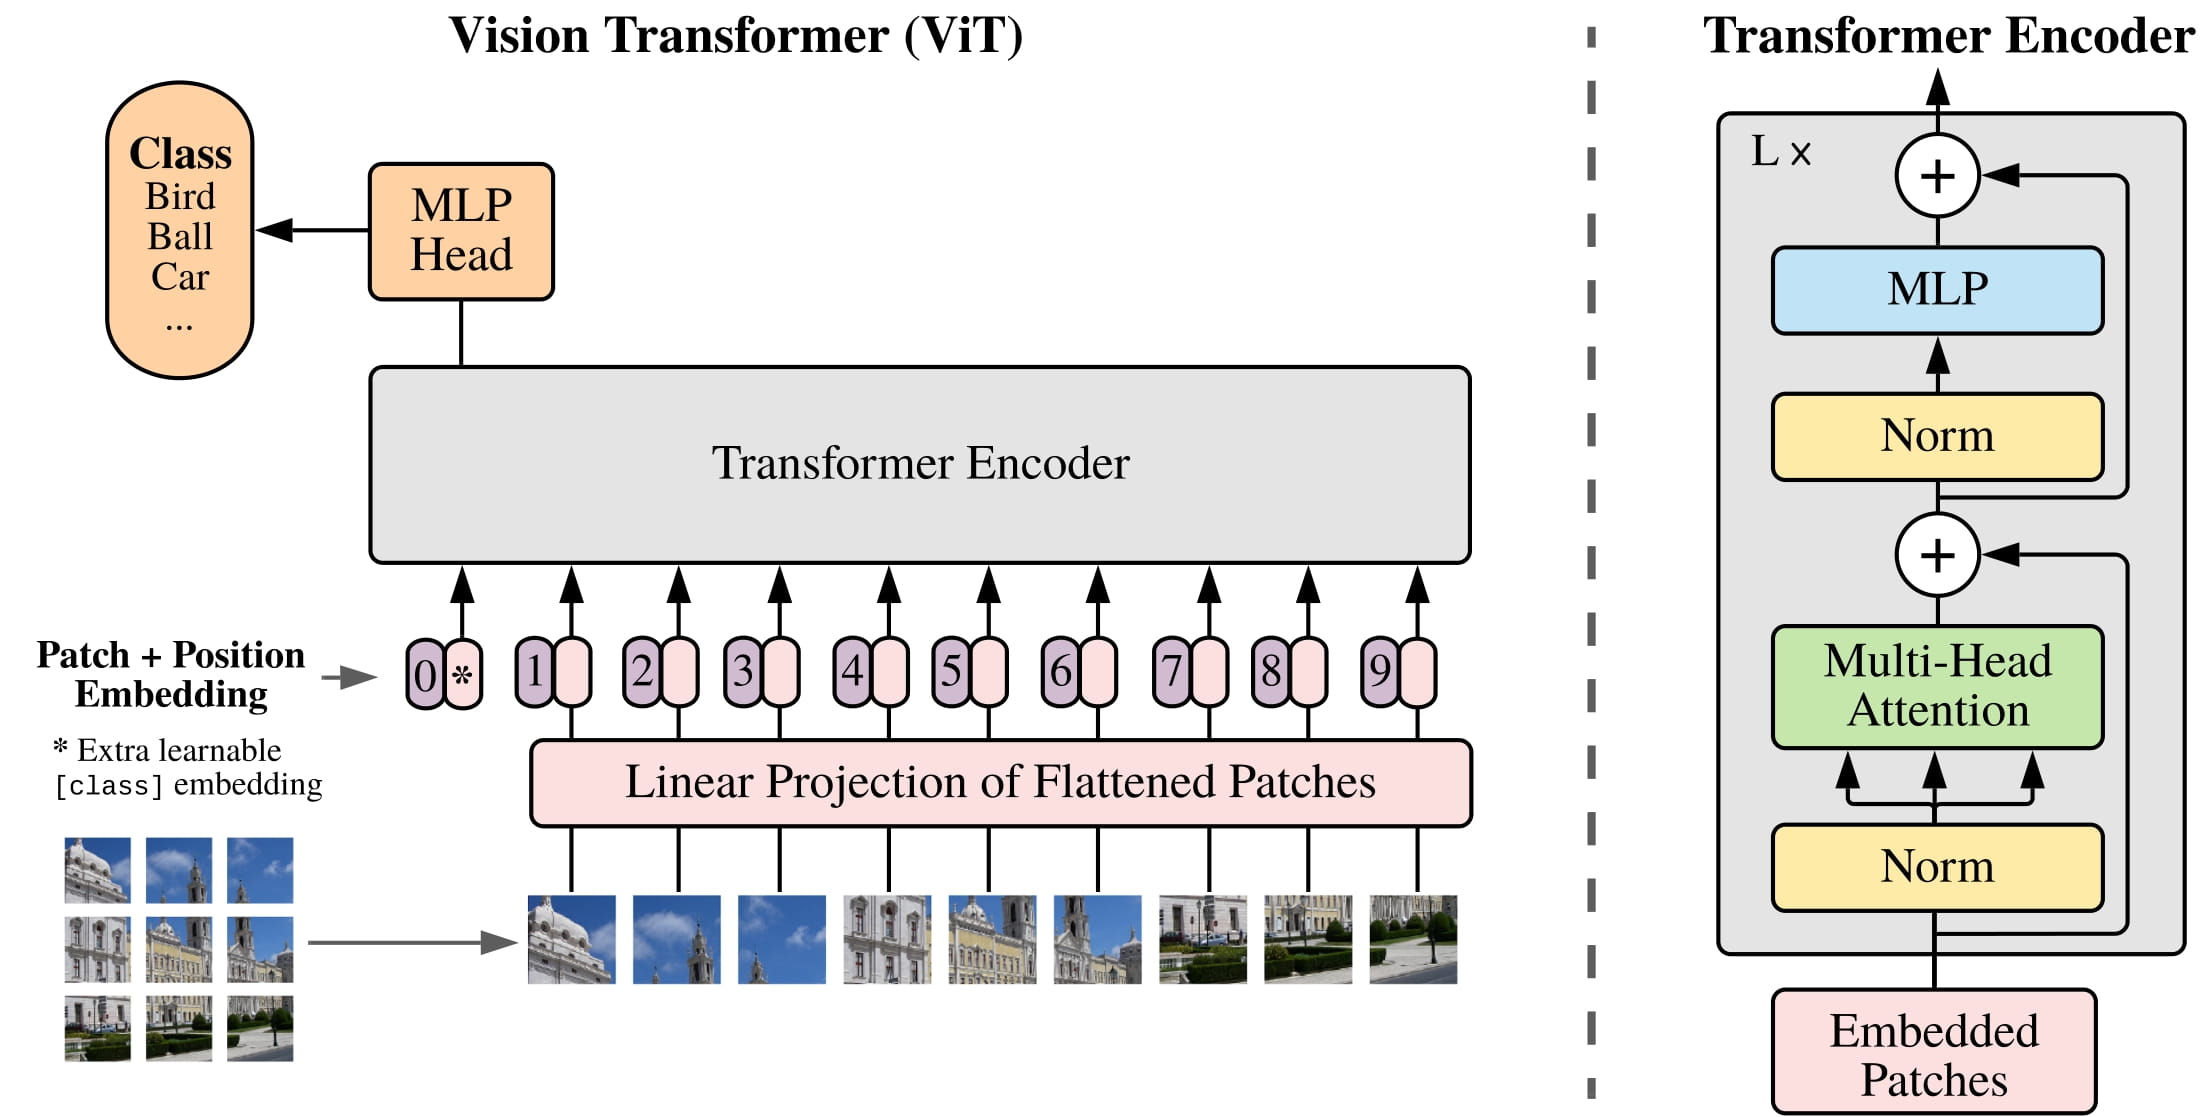
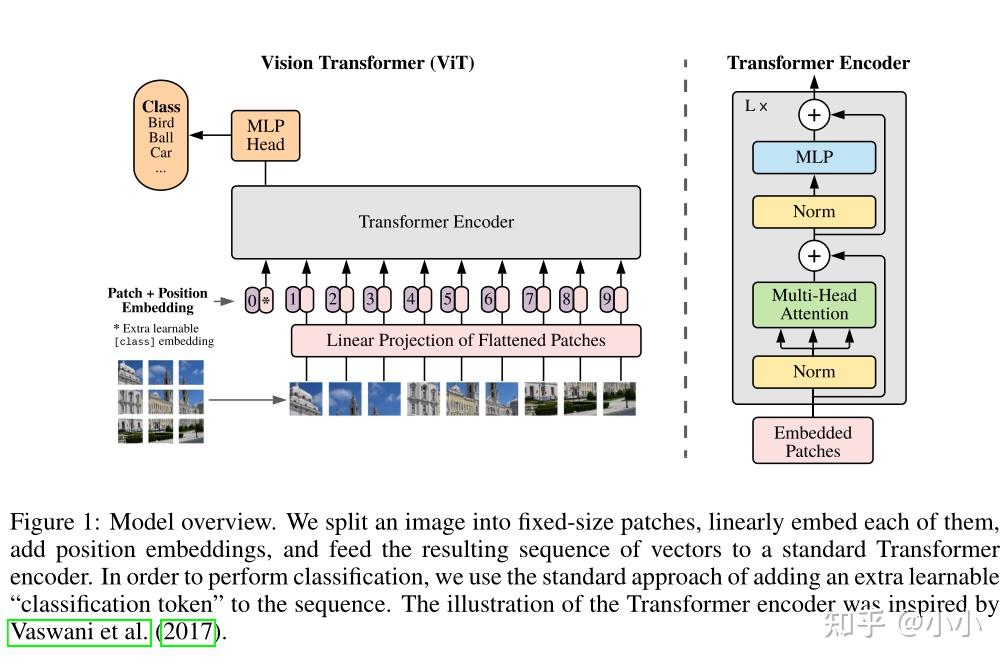
极智AI | 谈谈 ViT 的意义和实现细节 - 知乎
ASK-ViT: A Model with Improved ViT Robustness through Incorporating SK ...
多模态大模型应用实践(二)- 基于 ViT 和 Pairwise 的智能酒店首图选择 | 亚马逊AWS官方博客
From Large Language Models to Large Multimodal Models: A Literature Review
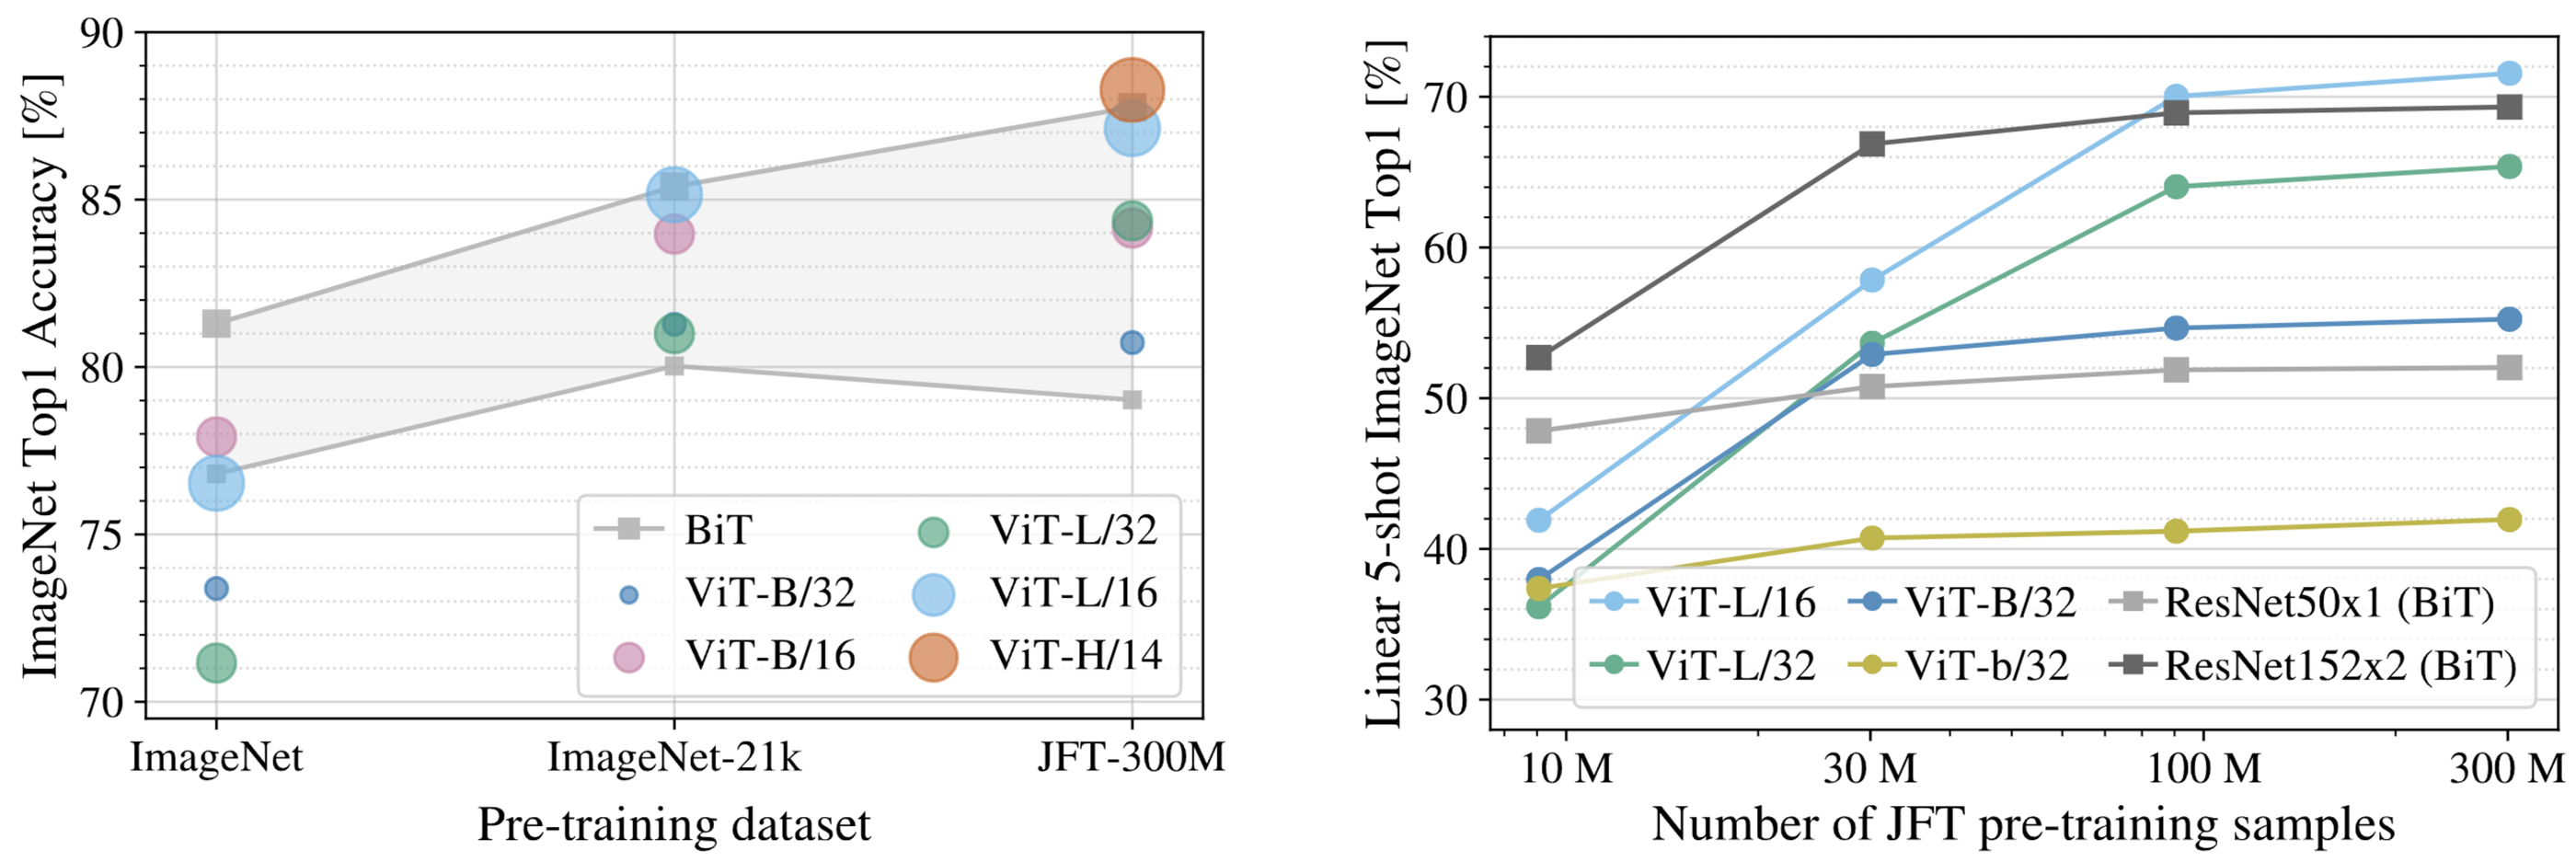
ICLR2021 | ViT | 一张图像相当于 16×16 的词:大规模图像识别的 Transformer 模型_vit16模型和vit ...
Metric3d Vit Large-api - a Hugging Face Space by zeidImigine
Taxonomy of Vision ViT architectures. | Download Scientific Diagram
來自 Kakao Brain 的全新 ViT 與 ALIGN 模型 - Hugging Face 文件
Timm-vit Large Patch14 Dinov2.lvd142m - a Hugging Face Space by slenthekid
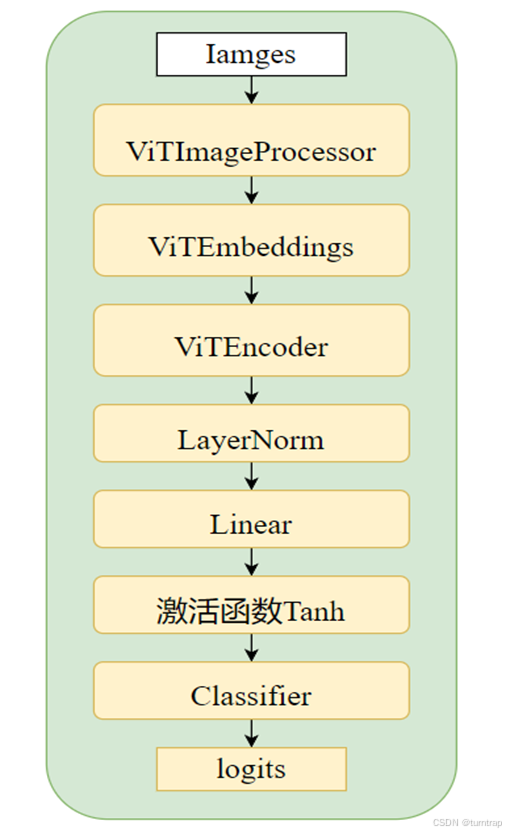
Deep learning image classification strategy. (a) ViT model architecture ...
U-ViT: A ViT Backbone for Diffusion Models - 知乎
VIT~~6_vit模型的输入可以是文本吗-CSDN博客
ViT: 简简单单训练一个Transformer Encoder做个图像分类 - 知乎
CV大模型系列之:全面解读VIT,它到底给植树人挖了多少坑全面图解CV大模型开山之作: Vision Transform - 掘金
【ViT】AN I MAGE IS WORTH 16 X 16 WORDS :TRANSFORMERS FOR IMAGE ...
Vision Transformer(ViT)网络详解 - 知乎
第九节 基于huggingface加载openai/clip-vit-large-patch14-336视觉模型demo-CSDN博客
Visual Transformer (ViT)模型详解-CSDN博客
Vision Transformer (ViT)及各种变体_vit架构-CSDN博客
Google Colab
DeepGlint-AI/mlcd-vit-large-patch14-336 · Hugging Face
ViT:视觉Transformer backbone网络ViT论文与代码详解-轻识
mrgiraffe/vit-large-dataset-model-v3 at main
vit-large-patch32-384
Vision Transformer (AN IMAGE IS WORTH 16X16 WORDS, TRANSFORMERS FOR ...
【光电智造】5款图像相似性搜索算法全面对比,CLIP、EfficientNet 、ViT、DINO-v2、BLIP-2!-电子工程专辑
Vision Transformer (ViT)
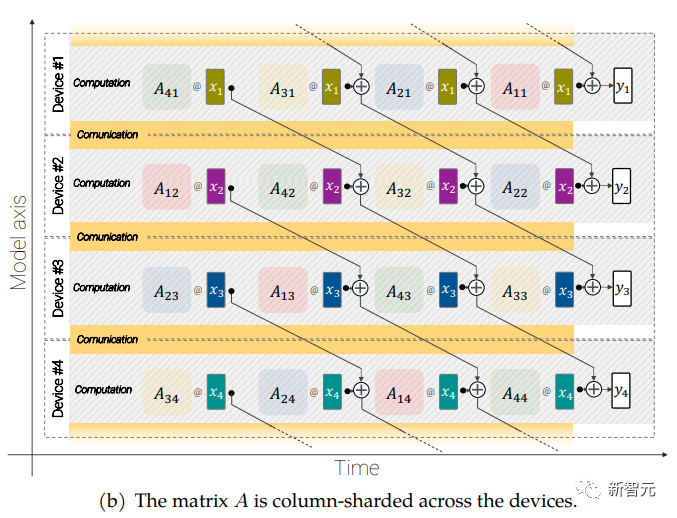
面向异构集群的大模型高吞吐量混合并行推理-科研动态-中国石油大学(北京)人工智能学院
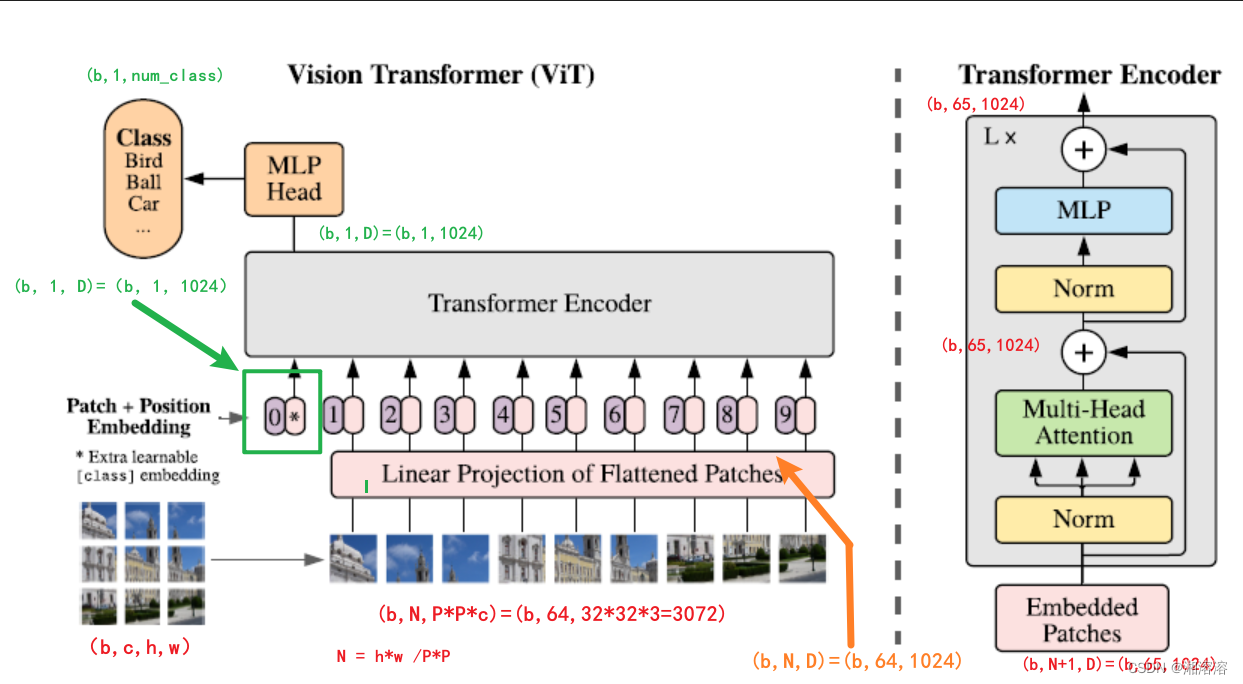
Vision Transformer(VIT)原理总结_为什么视觉编码器输出图像patchs第二个维度多1-CSDN博客
WeiWei-XPU/random-initial-ViT-large-trajectory-plot-model · Hugging Face
李沐精读论文:ViT 《An Image Is Worth 16x16 Words: Transformers For Image ...
【图像识别】Vision Transformer_extract class token-CSDN博客
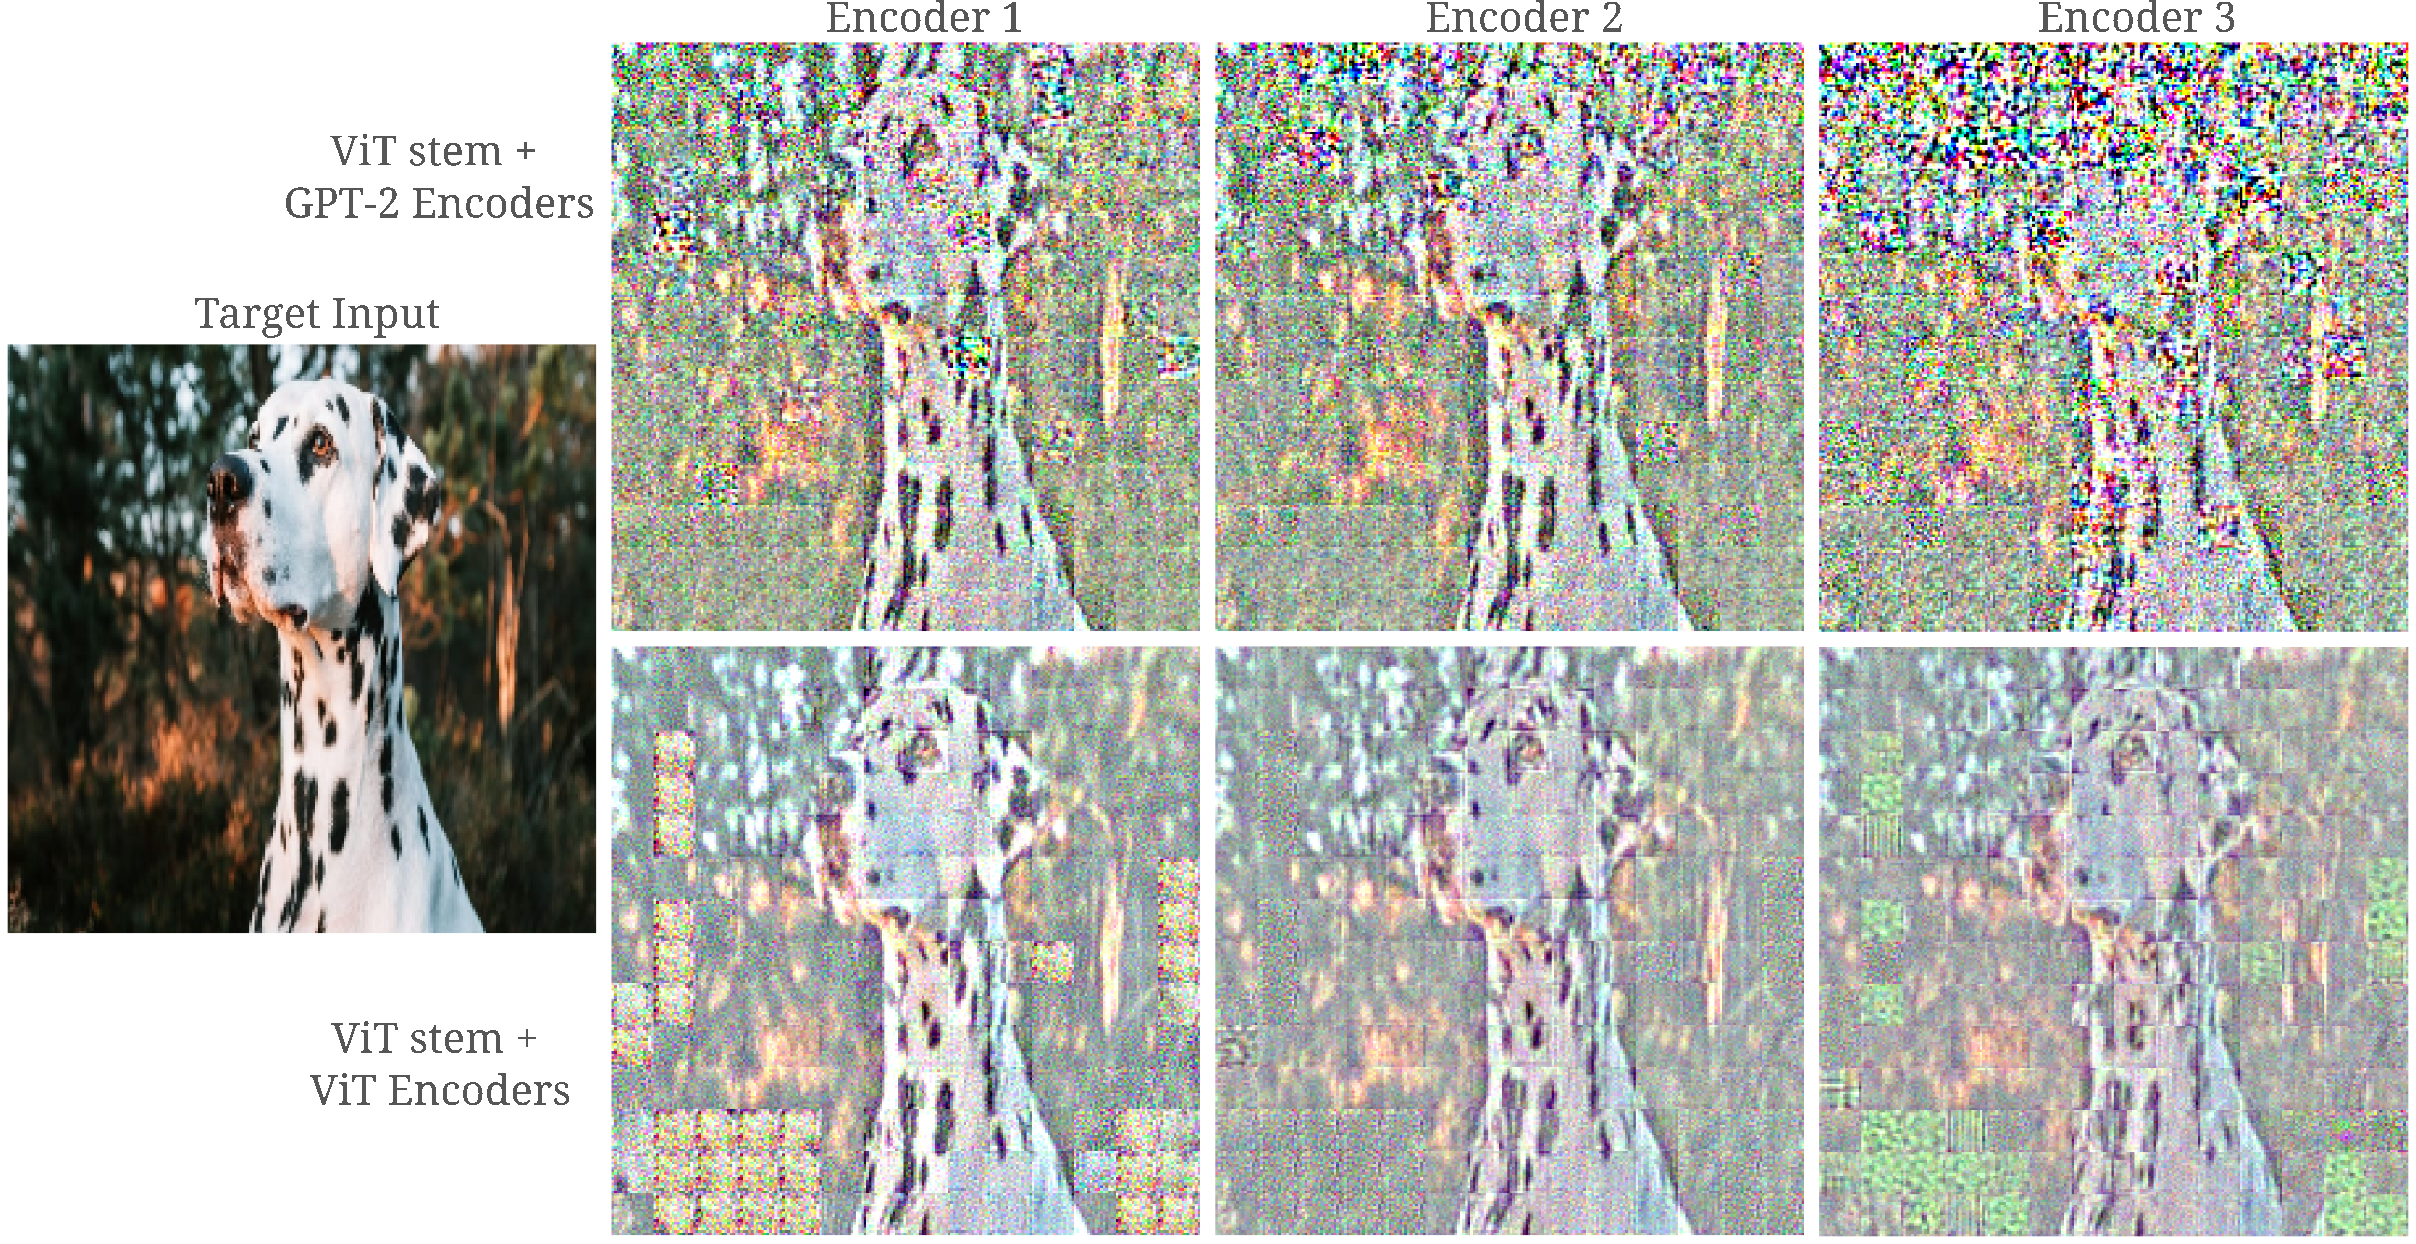
GitHub - animeshbchowdhury/visualizing-vision-models: Evaluating the ...
ViT常见的模型规格以及源码记录_vit模型大小-CSDN博客
ViT: Transformers for Image Recognition At Scale - 知乎
openai/clip-vit-large-patch14 · How to use openai/clip-vit-large ...
Transformer(四)ViT and SimpleViT - 知乎
【Pytorch】论文复现 Vision Transformer (ViT)_vit复现-CSDN博客
DunnBC22/vit-large-patch32-384-Breast_Histopathology_Images · Hugging Face
Vit代码-CSDN博客
【Transformer系列】深入浅出理解ViT(Vision Transformer)模型-CSDN博客
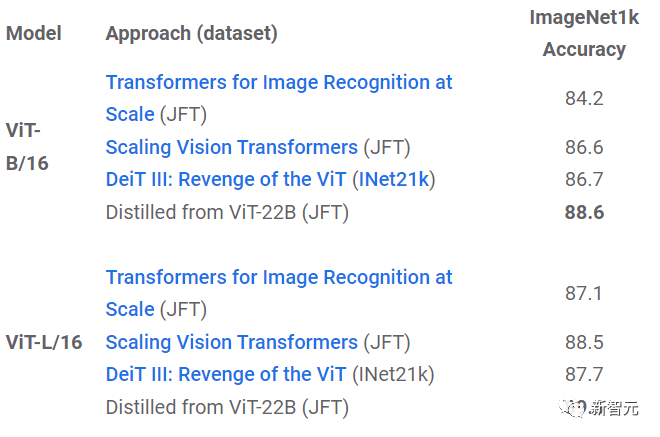
Google AI Introduces ViT-22B: The Largest Vision Transformer Model 5.5x ...
一文搞懂 ViT(Vision Transformer)-CSDN博客
[논문 Review] An image is worth 16x16 words: Transformers for image ...
OFA-Sys/chinese-clip-vit-large-patch14-336px · Hugging Face
Vision Transformer (ViT)初识:原理详解及代码_vit-transformer代码-CSDN博客
openai/clip-vit-large-patch14 · 模型在MNIST上正确率只有63.5%,这河里吗?
11.1 Vision Transformer(vit)网络详解 - 哔哩哔哩
Vision Transformer (ViT) Architecture | GeeksforGeeks
ViT论文详解-CSDN博客
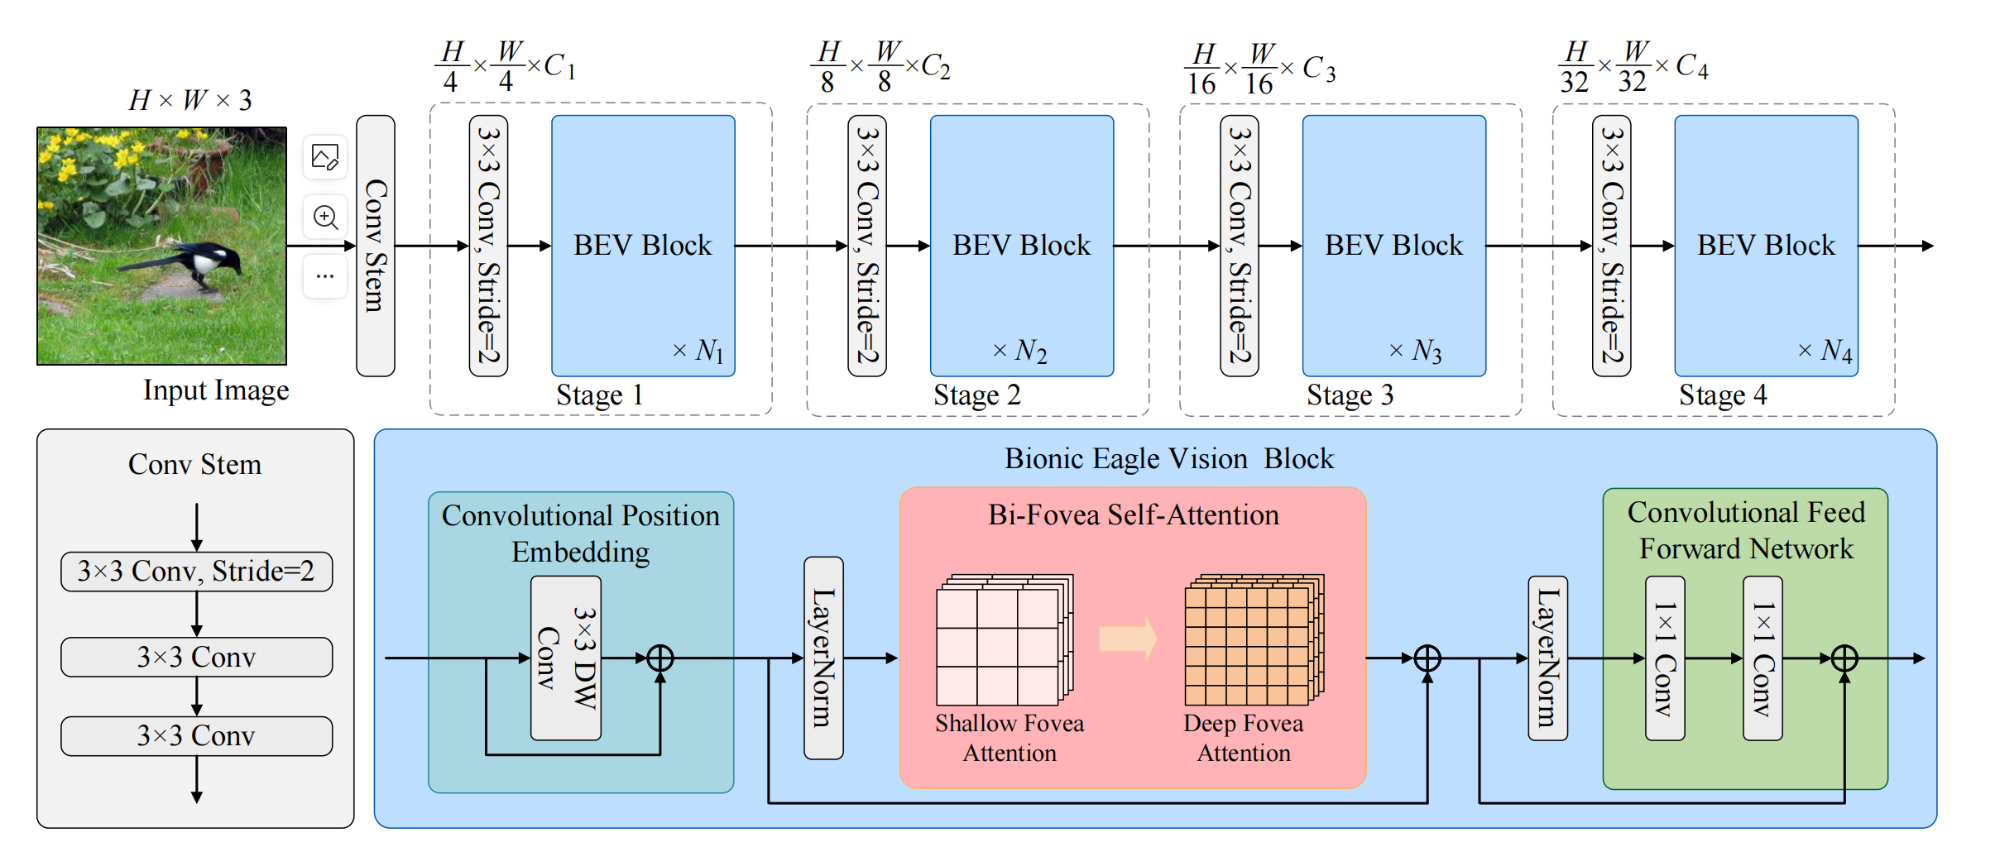
EViT:借鉴鹰眼视觉结构,南开大学等提出ViT新骨干架构,在多个任务上涨点-CSDN博客
【深度学习】深刻理解ViT - 技术栈
最新轻量级vit综述!后Transformer时代如何发展? - 知乎
Training efficiency (accuracy v.s. training wall-time) of ViT-Large ...
Transformer and Mixer Features | Form and Formula
Vision Transformer(ViT)论文解读与代码实践(Pytorch)-CSDN博客
CV开启大模型时代!谷歌发布史上最大ViT:220亿参数,视觉感知力直逼人类_vit huge 参数量-CSDN博客
JEANAPR/openai-clip-vit-large-patch14 at main
Bick/clip-vit-large-patch14-finetuned-fruits-360_vitlarge · Hugging Face
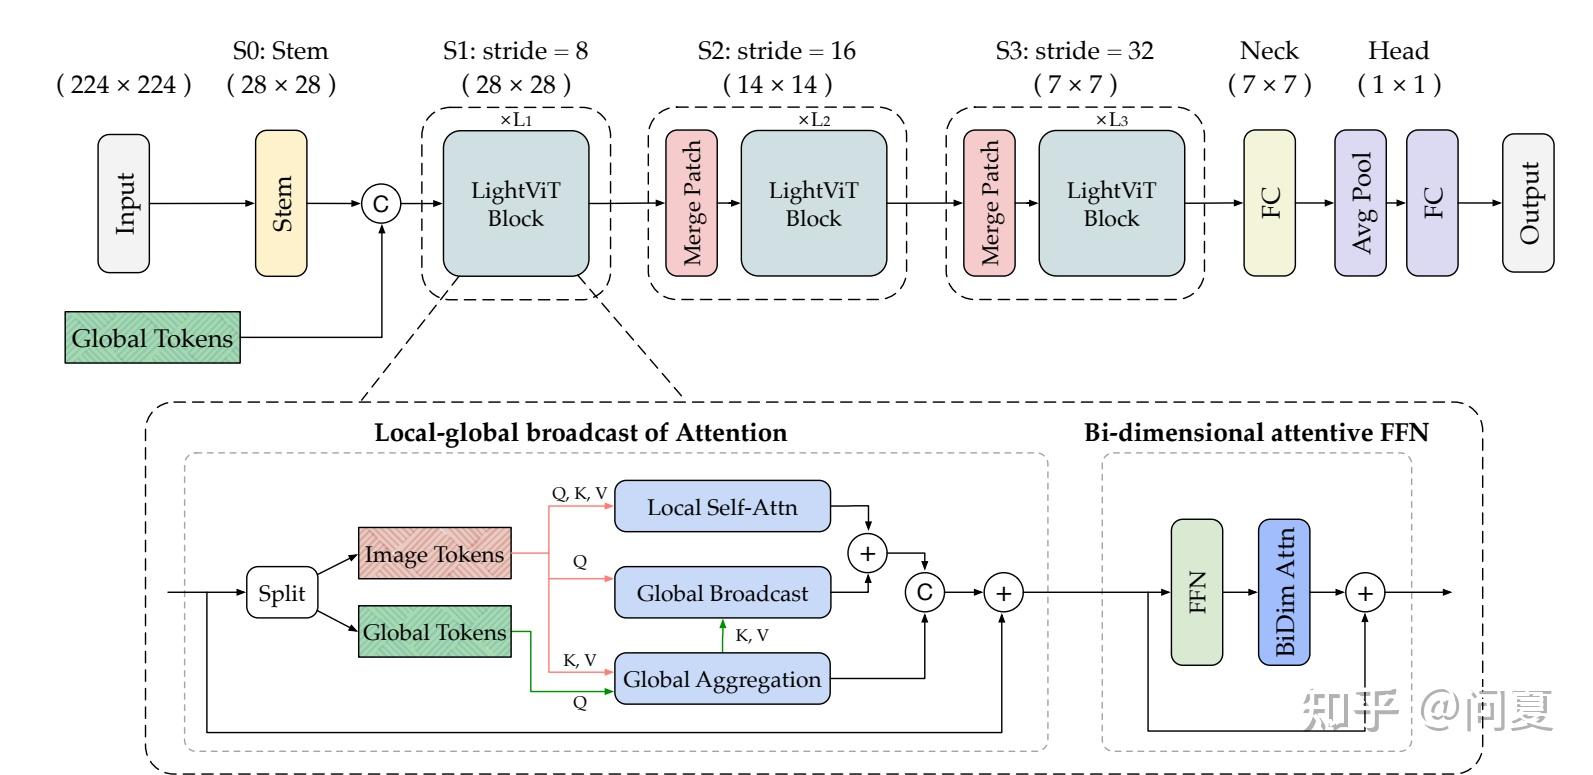
LightViT:无卷积的轻量化ViT - 知乎
LLM_log #009: An Image is Worth 16×16 Words — From Transformers to ...
VIT大模型浅要了解_vit-base-patch16-224-CSDN博客
AIGC:文生图模型Stable Diffusion_clip-vit-large-patch14-CSDN博客
Vision Transformers (ViT) Explained | Pinecone
《Vision Transformer (ViT)》论文精度,并解析ViT模型结构以及代码实现_vit论文下载-CSDN博客
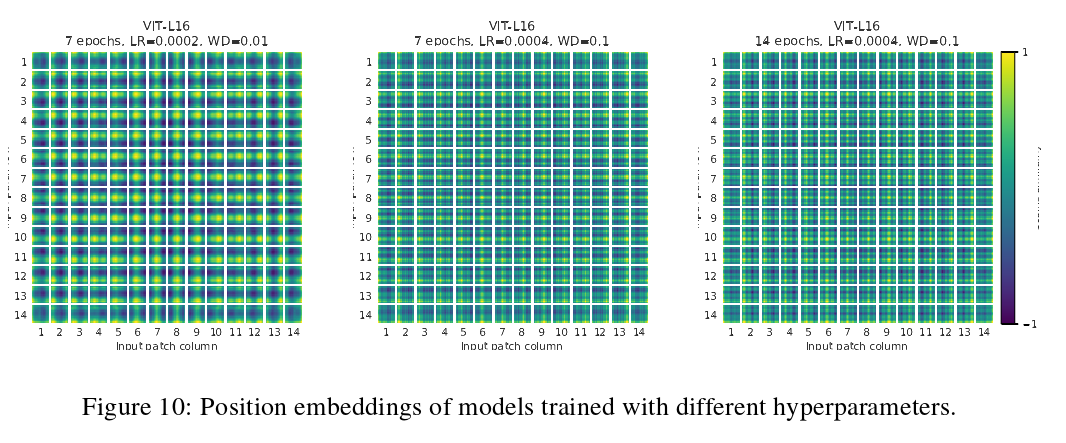
图解Vit 3:Vision Transformer——ViT模型全流程拆解(Layer Normalization, Position ...
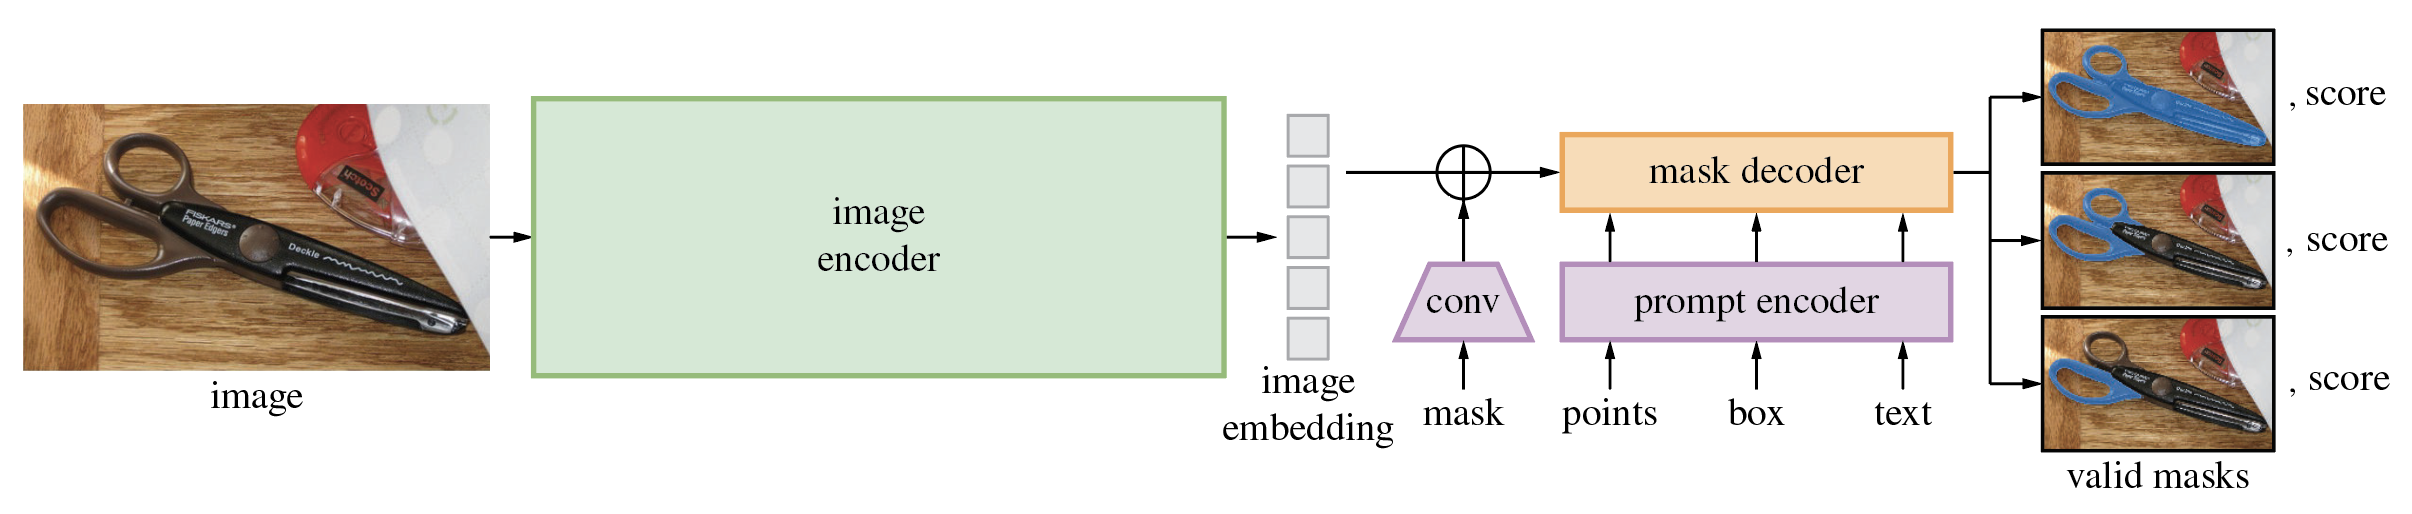
facebook/sam-vit-large · Hugging Face
Language Model Representations and Features | Form and Formula
Vision Transformer (ViT) Notes | Wenwen Kong
What are the most used architectures nowadays? : r/computervision
VILA를 사용하는 NVIDIA 하드웨어의 시각적 언어 모델 - NVIDIA Technical Blog
zch0414/clip-vit_large-slice_scan_study-dualdinotxt1568 · Hugging Face
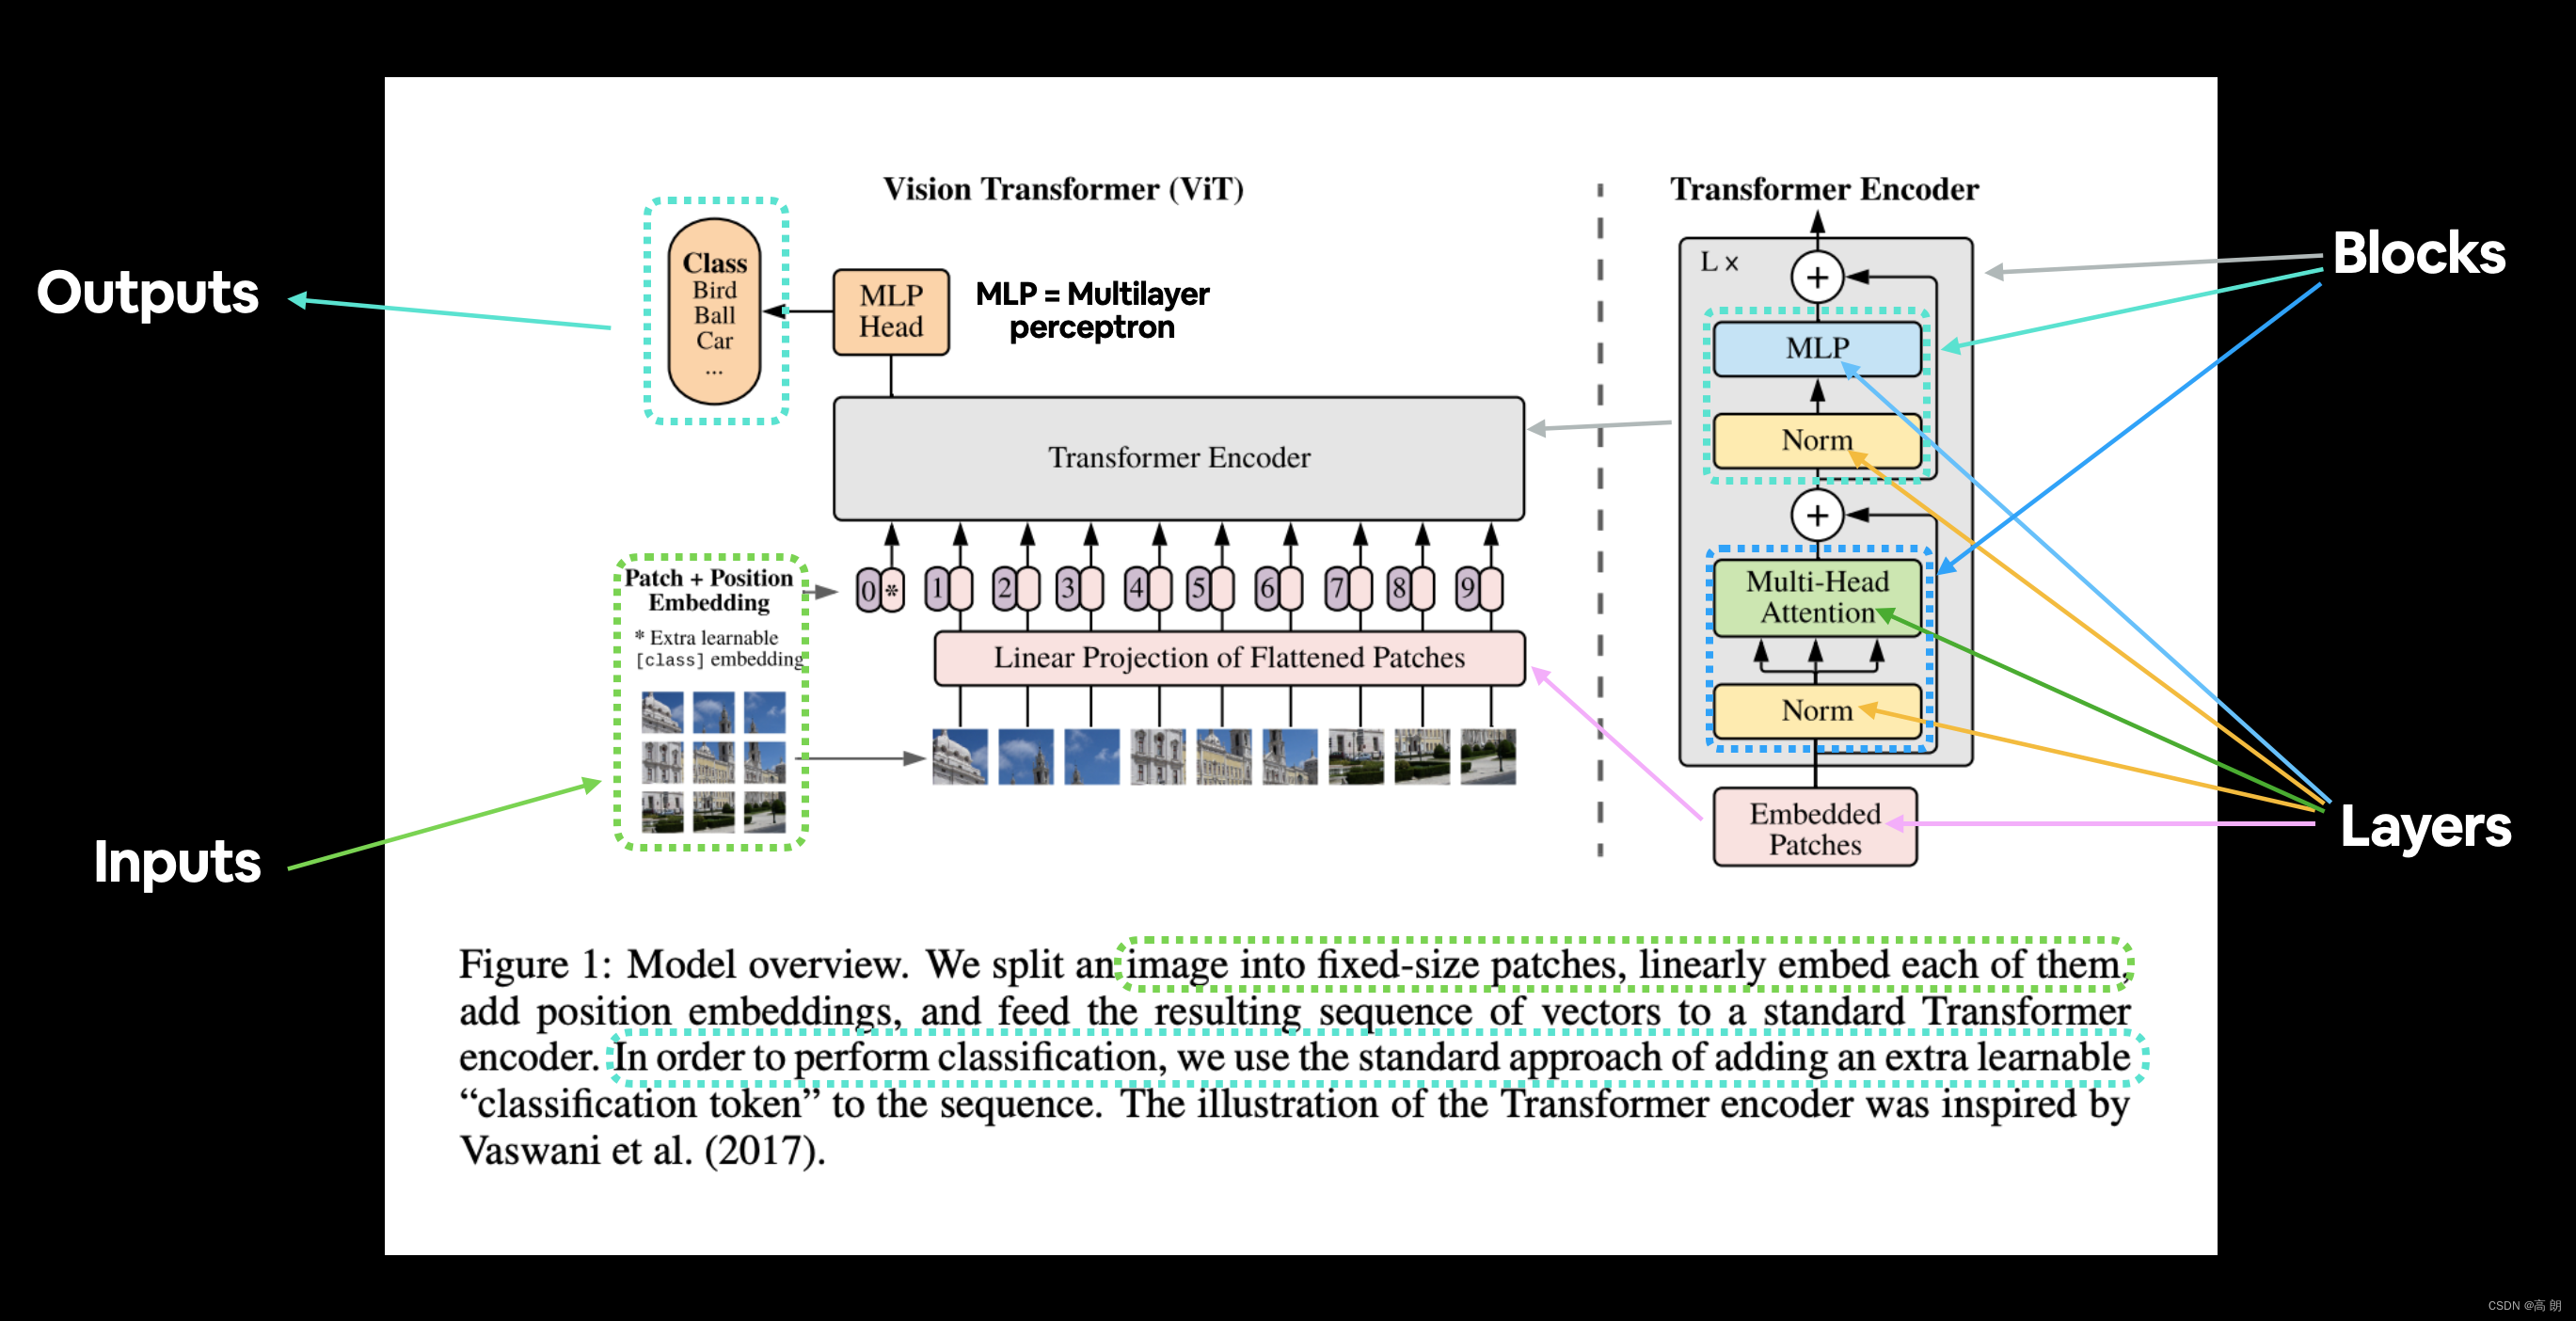
08. PyTorch Paper Replicating - Zero to Mastery Learn PyTorch for Deep ...
tangg555/clip-vit-large-patch14-336-finetuned-openai-clip-vit-large ...
视觉常用Backbone大全:VisionTransformer(ViT)_vit模型-CSDN博客
Vision Transformer (ViT) 介绍 | 文艺数学君
【ViT(Vision Transformer)】(一) 中英双语_inspired by the transformer scaling ...
touchtech/fashion-images-perspectives-vit-large-patch16-384-v1 ...
CNN vs. Vision Transformer: A Practitioner’s Guide to Selecting the ...
marcioverde/openai-clip-vit-large-patch14-336 at main
多模态大模型的技术底座:ViT的baseline_vit 底座-CSDN博客
ViT:An Image is Worth 16x16 Words: Transformers for Image Recognition ...
使用tritonserver完成clip-vit-large-patch14图像特征提取模型的工程化。-CSDN博客
论文笔记2:ViT(2020) - 知乎
UnipaPolitoUnimore/vit-large-patch32-384-melanoma · Hugging Face
AI研究趨勢討論(三)--強強聯手打造新世代里程碑(CNN與ViT結合) - iT 邦幫忙::一起幫忙解決難題,拯救 IT 人的一天
cjwbw/clip-vit-large-patch14 | Run with an API on Replicate
一篇文章搞懂Vit-RGTS - 知乎
【计算机视觉】Vision Transformer (ViT)详细解析_vit模型-CSDN博客
全面超越ViT,美团、浙大等提出视觉任务统一架构VisionLLAMA-腾讯云开发者社区-腾讯云
CLIP ViT-Large Patch14 Review, Pricing & Alternatives 2026 | AI Indigo ...
openai/clip-vit-large-patch14 · Convert weights to .safetensors
[2501.09221] ASCENT-ViT: Attention-based Scale-aware Concept Learning ...
Towards Fast, Memory-based and Data-Efficient Vision-Language Policy
clip模型_clip的vit的部分的模型-CSDN博客
【多模态LLM】以ViT进行视觉表征的多模态模型1(BLIP、BLIP-2、InstructBLIP)_vit llm-CSDN博客
ViT: Vision transformer - DeepSchool
Fine-tuned Models for openai/clip-vit-large-patch14 – Hugging Face
ViT(Vision Transformer)论文速读 - 哔哩哔哩