Showing 120 of 120on this page. Filters & sort apply to loaded results; URL updates for sharing.120 of 120 on this page
Zero grad on single parameter - PyTorch Forums
Zero grad optimizer or net? - PyTorch Forums
Zero Grad Pytorch : CUDA Automatic Mixed Precision examples – IQLV
Zero Grad | LinkedIn
Zero Grad | Cairo
ZERO GRAD TRAILER (1988) - YouTube
Zero Grad on LinkedIn: join us 😎
Data Analysis Instructor job at Zero Grad in Cairo, Egypt – Apply on Wuzzuf
Zero Grad - عايز تتعلم AI & Machine Learning و مش عارف... | Facebook
Zero Grad on LinkedIn: one of our talented students 😉
Post from Zero Grad
Zero Grad - YouTube
Zero Grad - 📌 تجهيز البيانات (Data...
Zero grad in residual vq · Issue #25 · facebookresearch/encodec · GitHub
Zero gradient in firt layer - autograd - PyTorch Forums
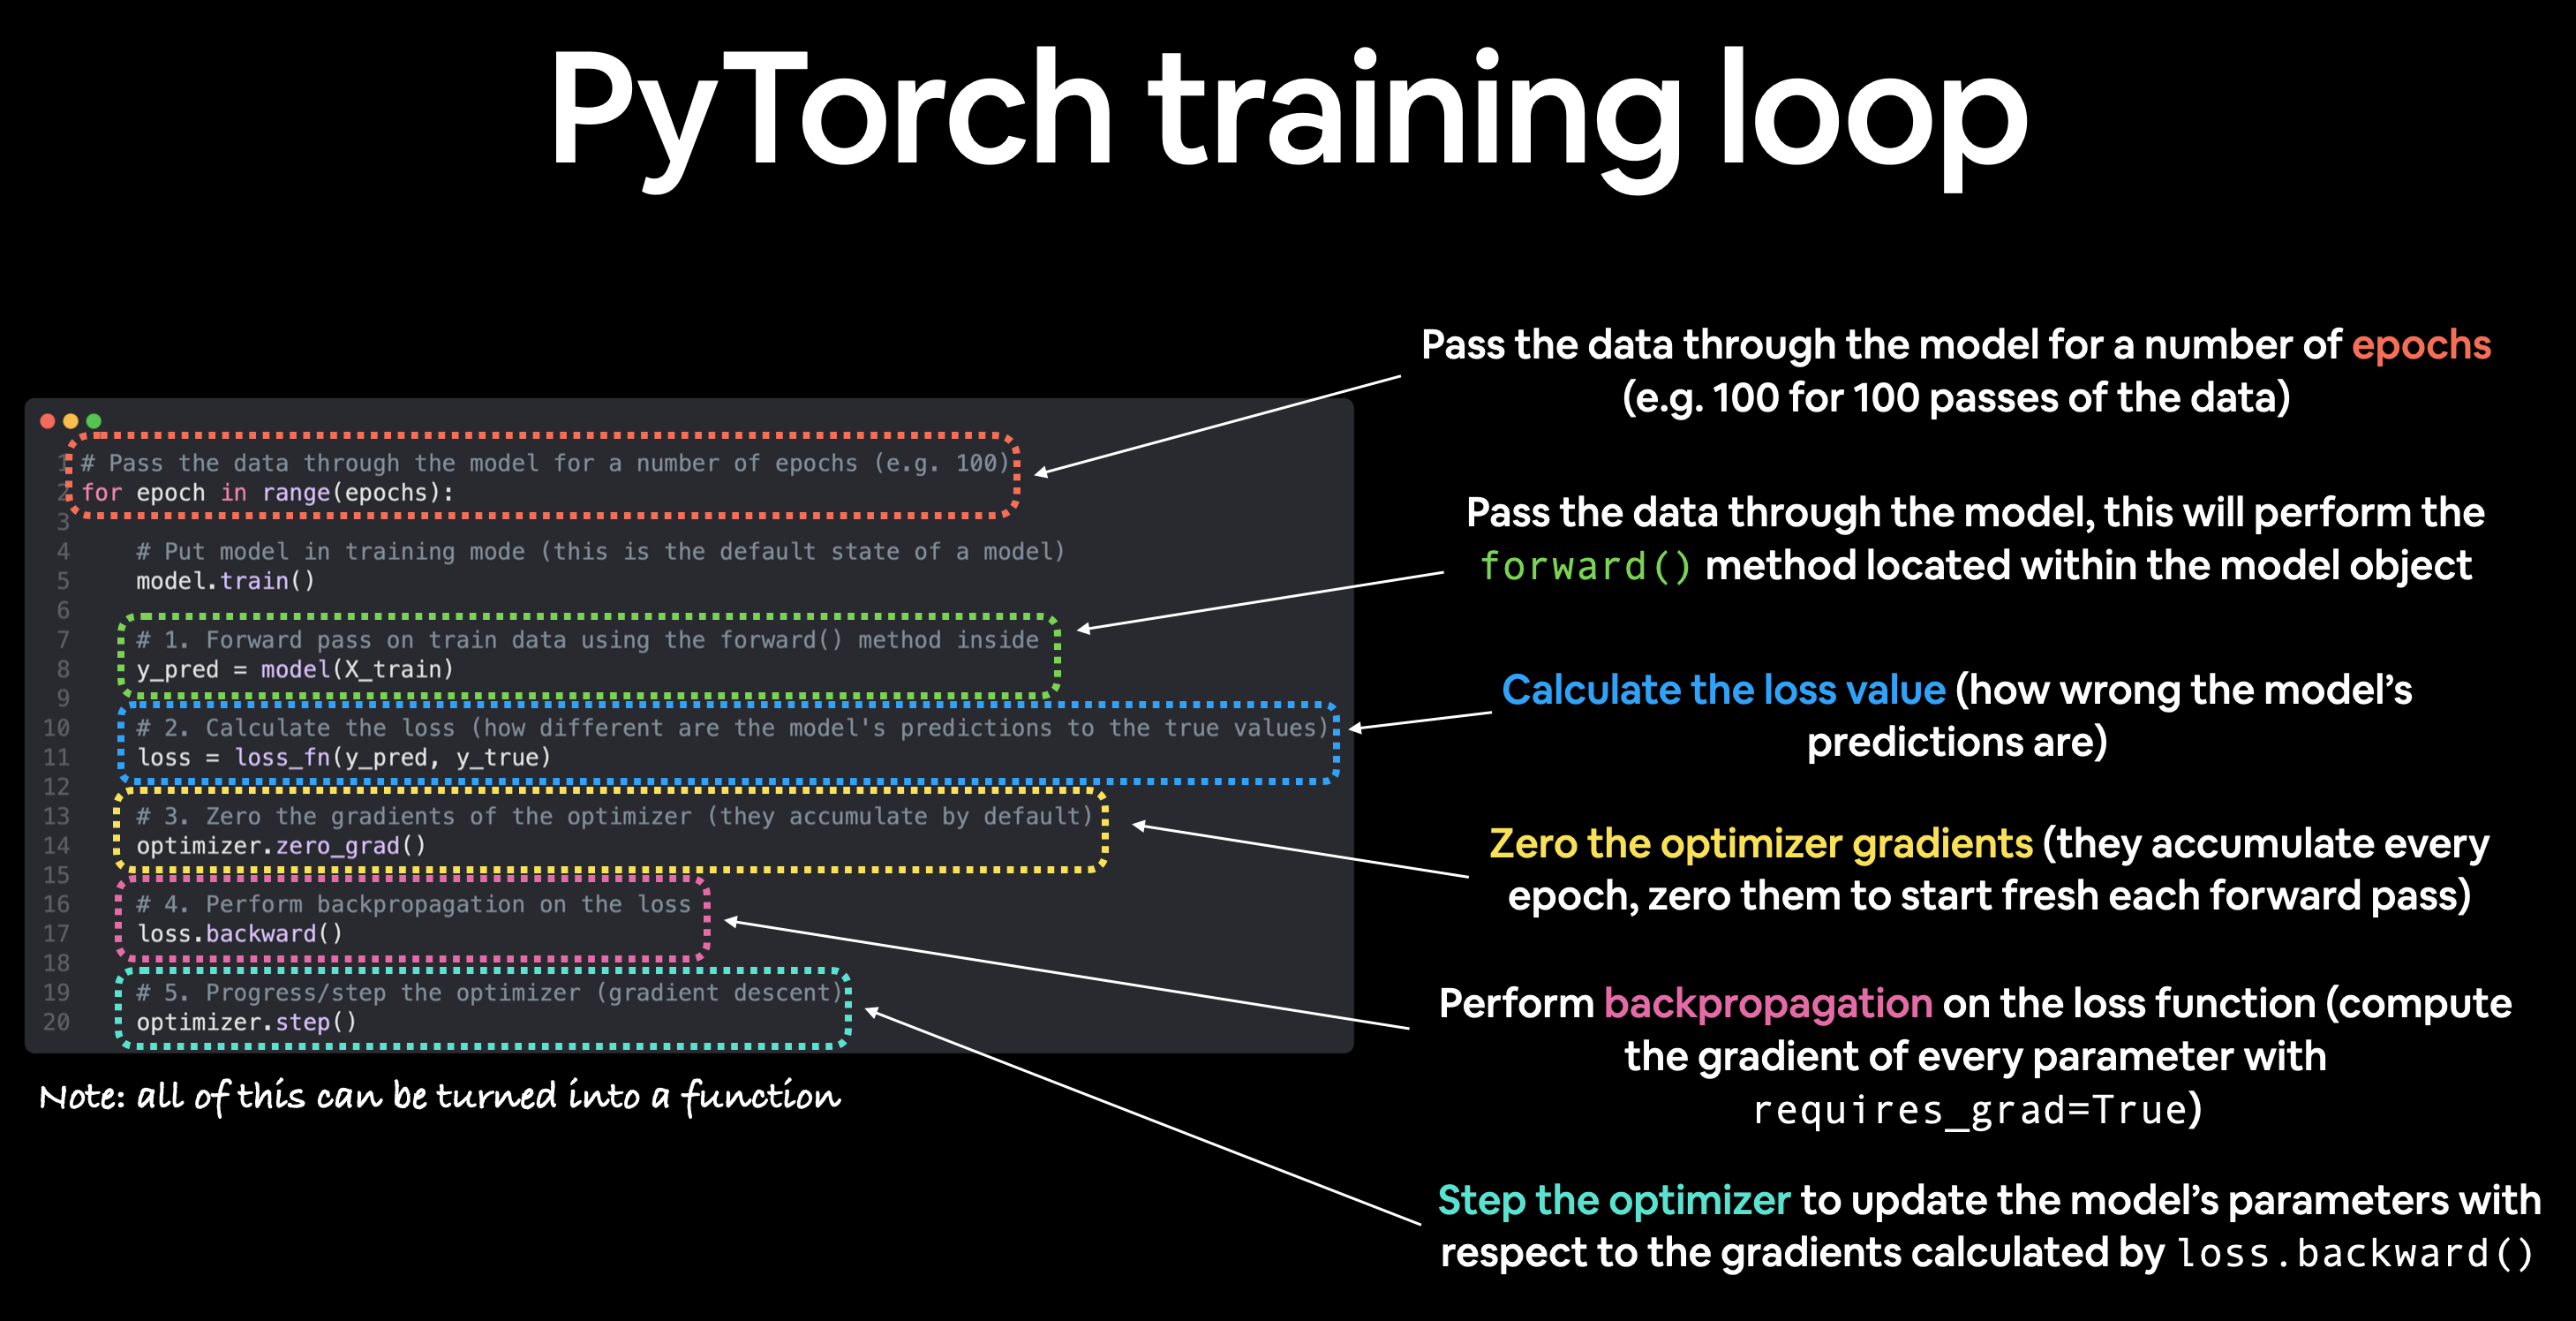
Zero PyTorch Gradients | optimizer.zero_grad()
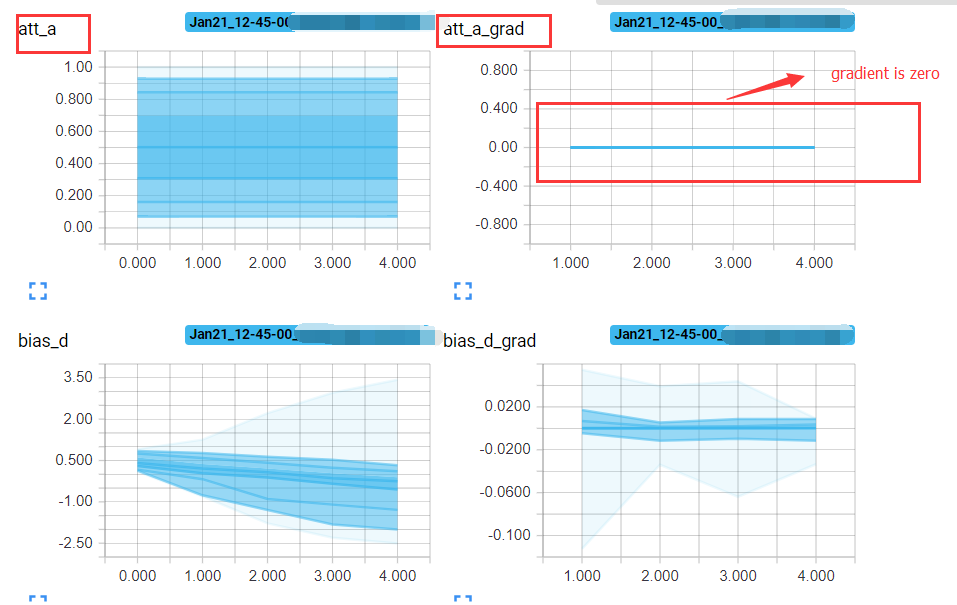
Training sometimes starts and remains with zero gradient values ...
关于pytorch中zero_grad() 梯度清零_paddle zero grad-CSDN博客
The gradients of the weights of my model approach to zero - autograd ...
Pytorch Zero Out Gradient , PyTorch – FHHLTF
autograd grad_outputs are zero · Issue #6976 · pytorch/pytorch · GitHub
Gradients are always zero - autograd - PyTorch Forums
Cosinus In Grad Tabelle : Kosinusrechner – VSMSP
Why Do We Need to Zero Out Gradients in PyTorch?
Zero Degree Technology | OilQuick
optimizer.zero_grad()和loss.backward()_不加optimizer zero grad会怎么样-CSDN博客
PyTorch zero_grad | What is PyTorch zero_grad? | How to use?
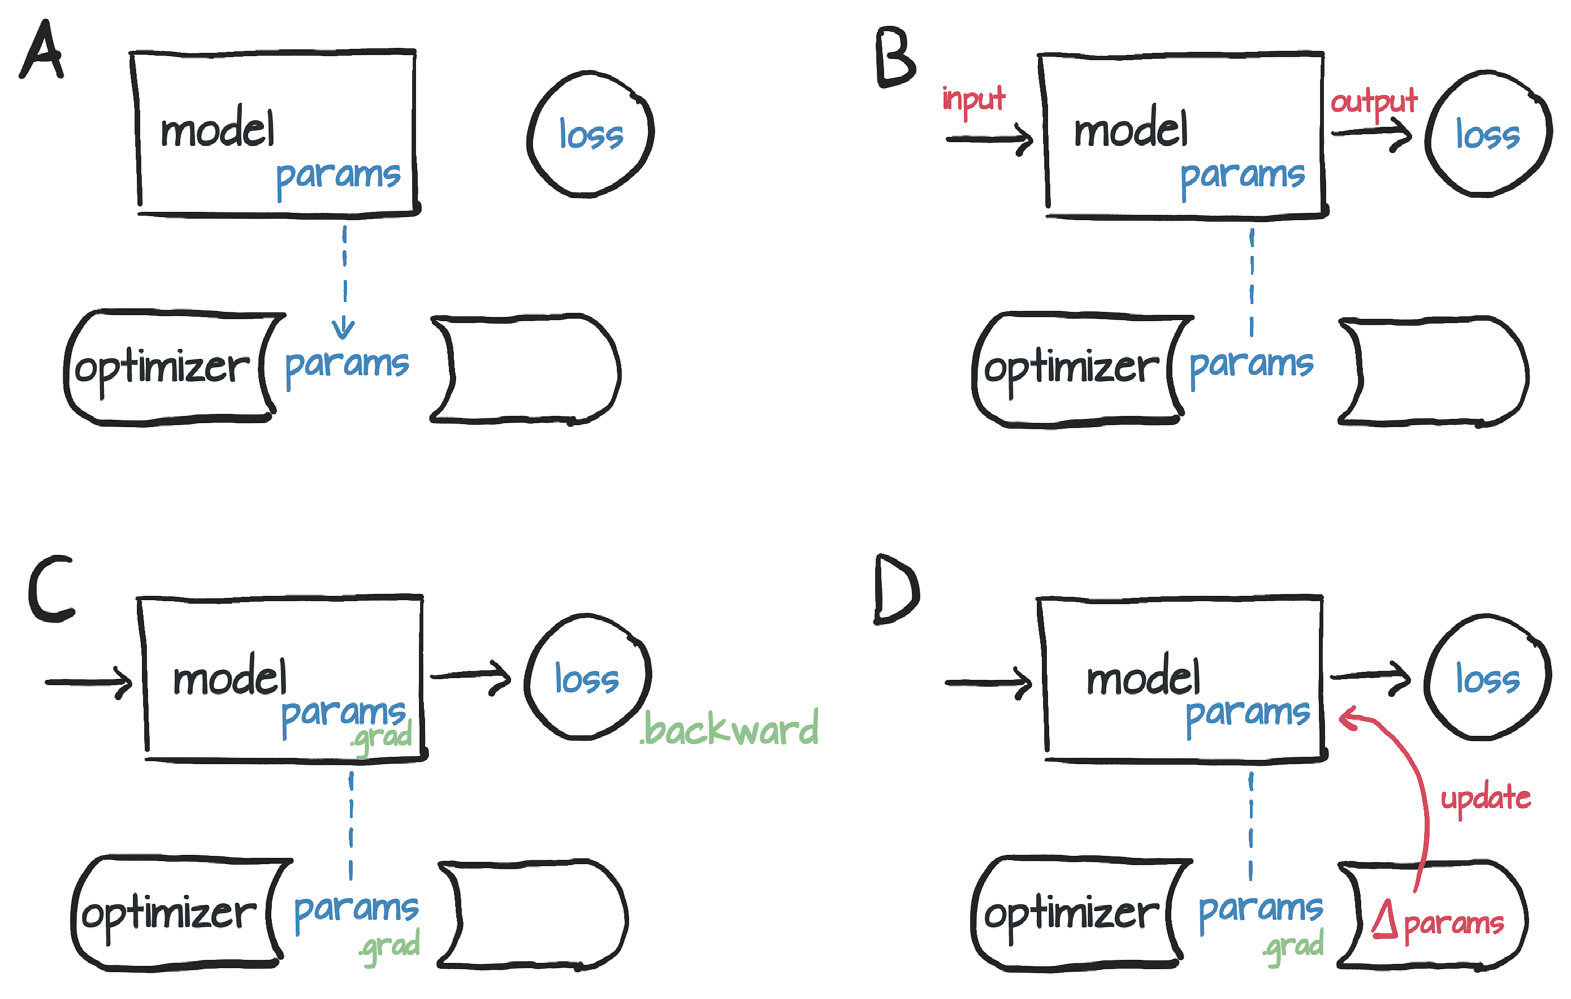
【PyTorch入門】Tensor の「自動微分」と「誤差逆伝播」を徹底解説|Tensorとoptimizerで学ぶ学習の流れ - ぶつりやAI
PyTorch 模型训练之并行篇
【PyTorch】PyTorch 核心机制及其常用模块_nn.batchnorm2d-CSDN博客
Optimizer.zero_grad
Pytorch优化器及其内置优化算法原理介绍 - 知乎
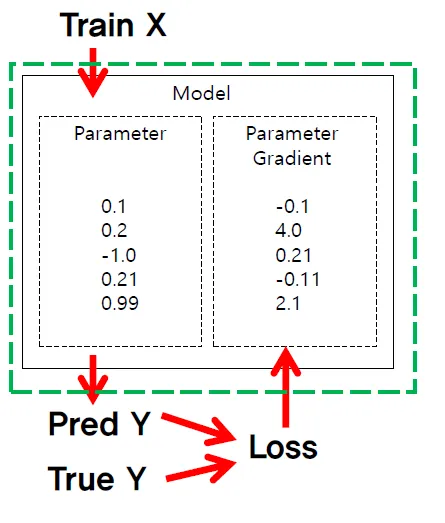
[파이토치 기초] model.zero_grad() , optimizer.zero_grad() 쓰는 이유?
with torch.no_grad中optimizer.step和.zerograd顺序问题 - 知乎
A weird zero_grad problem - autograd - PyTorch Forums
PyTorch の zero_grad() は何をしているか
optimizer.zero_grad()-CSDN博客
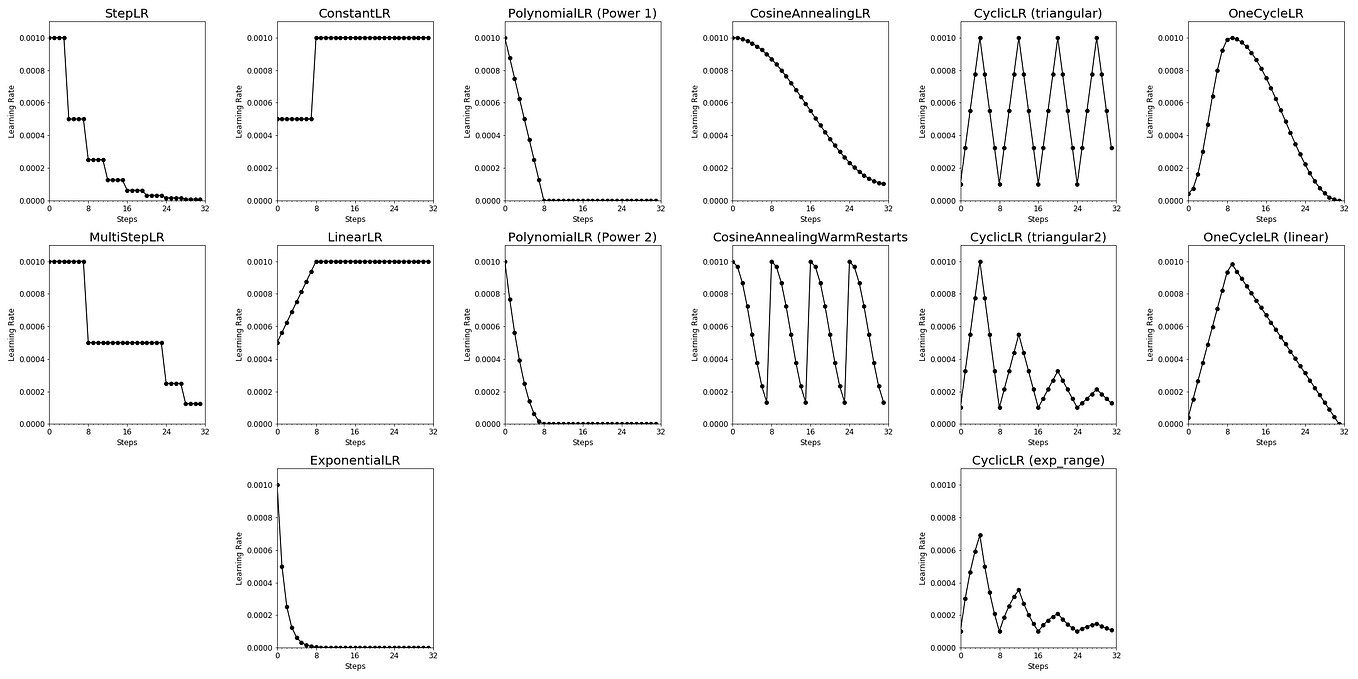
Pytorch学习笔记(7):优化器、学习率及调整策略、动量_pytorch优化器学习率和正则化-CSDN博客
python - Why do we need to call zero_grad() in PyTorch? - Stack Overflow
PyTorch Training Loop: Don't Forget optimizer.zero_grad() | Yokeswaran ...
pytorchのモデル/オプティマイザのzero_grad()の違い - 学んだことメモ
some question about the position of 'optimizer.zero_grad()' · Issue ...
Gradient Accumulation in Detectron2 - autograd - PyTorch Forums
In PyTorch, why do we need to call optimizer.zero_grad()? | by Lazy ...
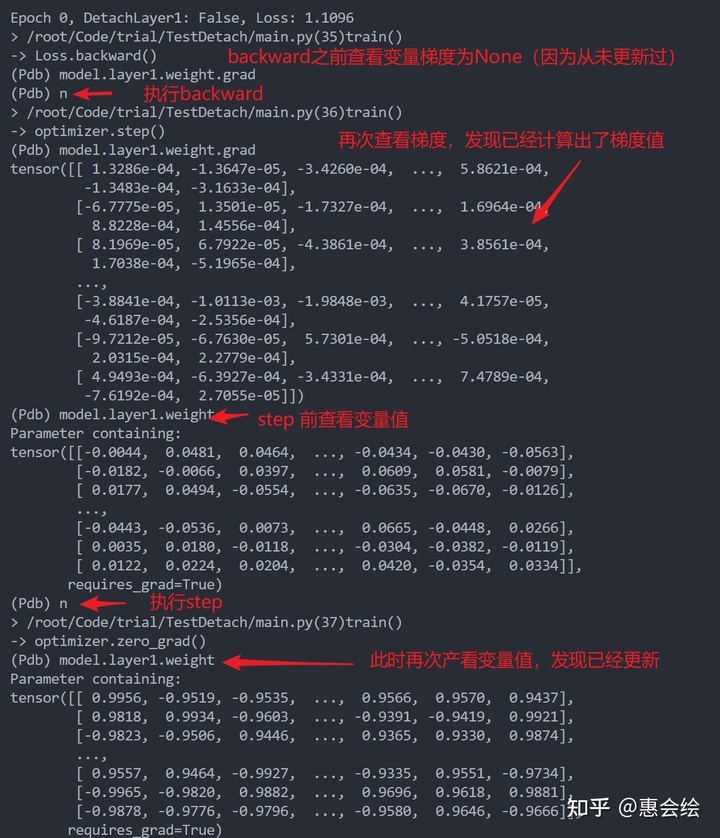
【截图留存】理解optimizer.zero_grad(), loss.backward(), optimizer.step() - 知乎
pytorch tensor维度;tensor求导 backward、获取梯度grad;optimizer梯度更新zero_grad、step ...
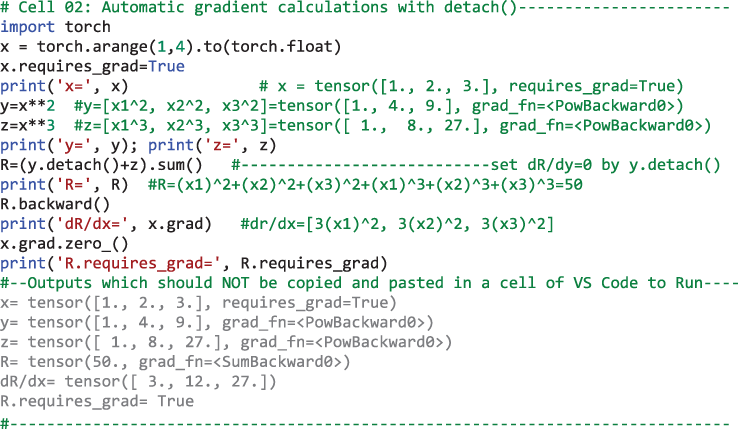
关于pytorch中使用detach并不能阻止参数更新这档子事儿 - 知乎
通俗讲解Pytorch梯度的相关问题:计算图、no_grad、zero_grad、retain_grad、detach和backward ...
Why Parameters's Gradient is Zero? - autograd - PyTorch Forums
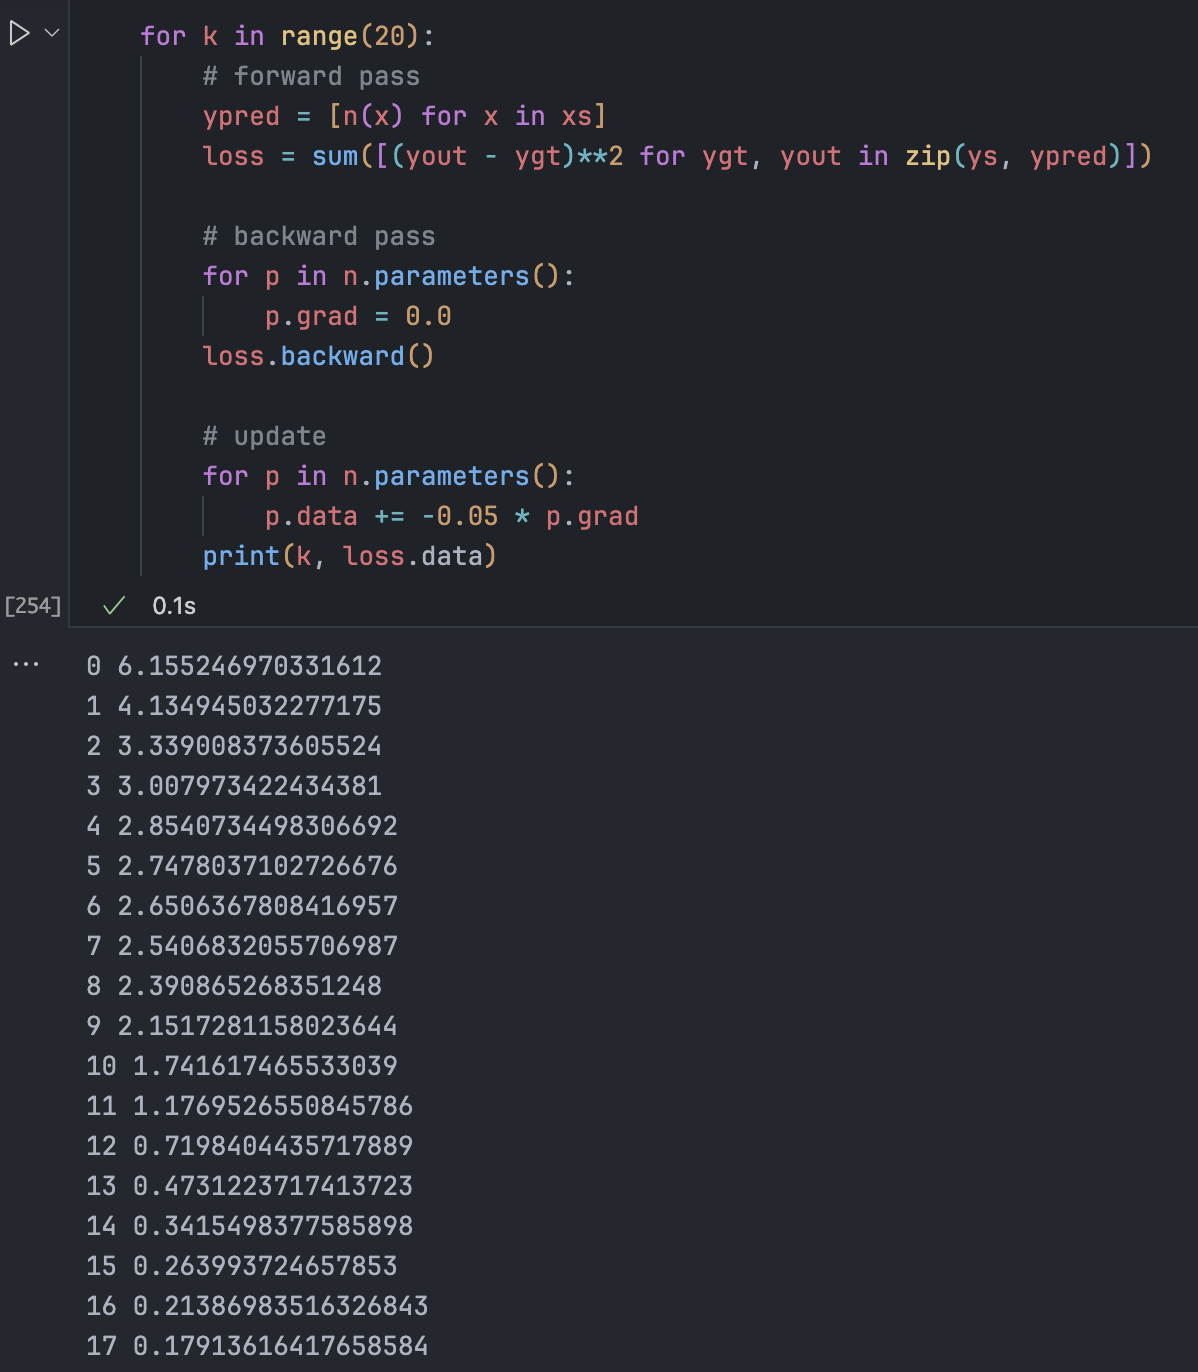
Building a Minimal Autograd Framework from Scratch :: SAO Blog
optimizer.zero_grad()에 관한 질문입니다 - 인프런 | 커뮤니티 질문&답변
深度学习:GoogLeNet核心思想详细讲解 - 知乎
PyTorch tarining loop and callbacks · All things
PyTorch优化器详解:zero_grad()、loss.backward()、step() 的妙用_损失函数 zerograd-CSDN博客
Medium
optimizer.zero_grad()는 왜 사용하는가?
PyTorch zero_grad() Explained: Accumulation, Confusion, and Solutions
pytorch复习笔记--loss.backward()、optimizer.step()和optimizer.zero_grad()的用法 ...
Why "netD.zero_grad()" is not required before "errD_fake.backward()" in ...
Understanding the Placement of zero_grad() in Training Loops: Does It ...
[pytorch] nn.module의 zero_grad VS optimizer의 zero_grad의 차이
Pytorch的grad、backward()、zero_grad()_runtimeerror: only tensors of ...
The position where you write *optimizer.zero_grad()* · mrdbourke ...
用单GPU微调 LLM_gpu显存 llm-CSDN博客
通俗讲解Pytorch梯度的相关问题:计算图、with torch.no_grad()、zero_grad()和backward ...
#zero_grad #machinelearning | Ahmad Mostafa
pytorch: Model.zero_Grad () and Optimizer.zero_Grad (), Net.parameters ...
Overall structure of proposed zero-shot Grad-TTS. | Download Scientific ...
PYTHON : Why do we need to call zero_grad() in PyTorch? - YouTube
About optimizer.zero_grad() · Issue #1 · caoymg/APR-PyTorch · GitHub
What's the difference between model.zero_grad() and optim.zero_grad ...
deep learning - Pytorch model gets no gradients updates (All gradients ...
Gradient of output is 0 - autograd - PyTorch Forums
[读书笔记] Deep Learning with Pytorch -- Chapter 4 | Pims的博客
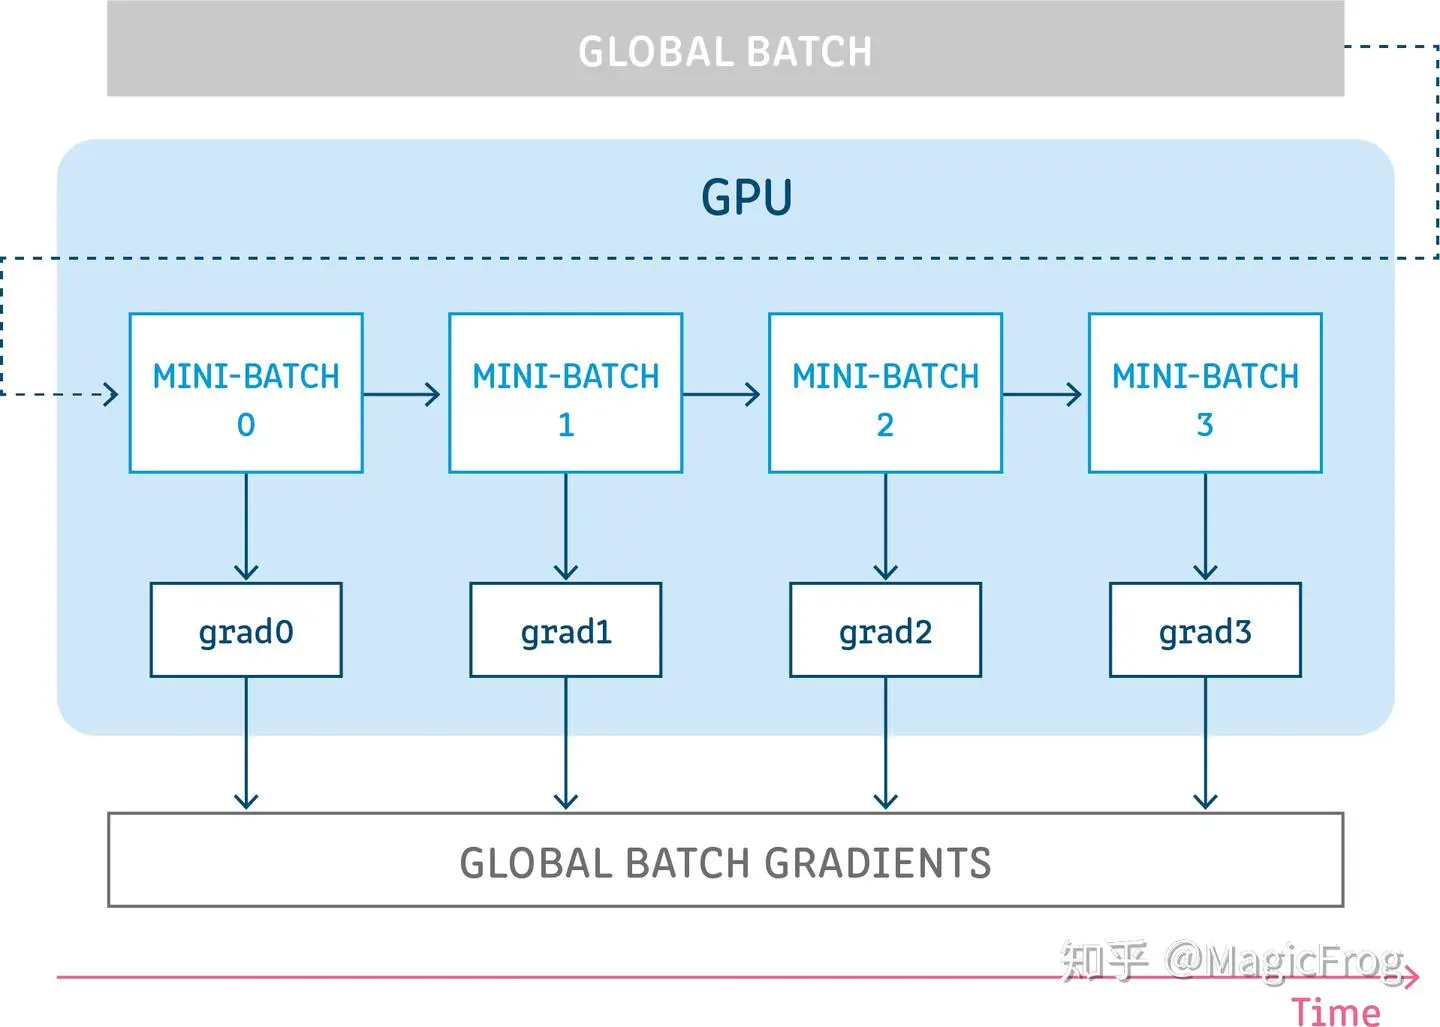
pytorch里巧用optimizer.zero_grad增大batchsize - 知乎
Box vini analcolici 0.0% | Black Label Collection – Zerogradi
leaf node、detach()、with no_grad()、.grad_fn()、requires_grad、Grad Modes ...
[딥러닝 홀로서기] Lec10. Assignment #1 Review
torch关于训练:零梯度zero_grad()、分离detach、更新step-EW帮帮网
فرصة 😉 | Ahmad Mostafa
Why do we need to call zero_grad() in PyTorch? - YouTube
Londtren Große 0-Grad-Schlafsäcke für Erwachsene, kaltes Wetter ...
Mathematical tools for computer vision - Book chapter - IOPscience
PyTorch tutorial: a quick guide for new learners
关于 pytorch 中使用 detach 并不能阻止参数更新这档子事儿-极市开发者社区
详解 PyTorch中optimizer.zero_grad()的作用及其影响: How optimizer.zero_grad ...
Python :Why do we need to call zero_grad() in PyTorch?(5solution) - YouTube
Ahmad Mostafa على LinkedIn: طالب جامعة ومهتم بمجال AI & Machine ...
掌握 PyTorch 梯度清零:从 zero_grad() 到 set_to_none=True 的性能优化
【知识】深度学习中,应该先zero_grad还是先backward?-腾讯云开发者社区-腾讯云
torch函数学习_torchsize三个数和四个数-CSDN博客
الفترة القادمة محتاجين نركز أكثر مع الطلبة | Zero Grad
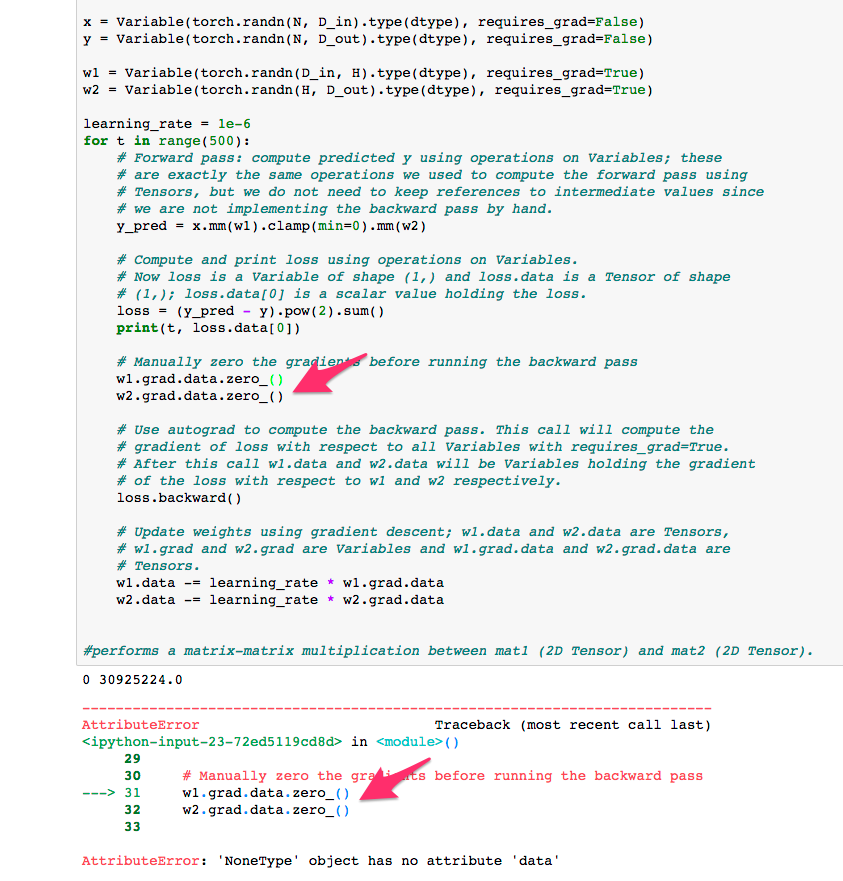
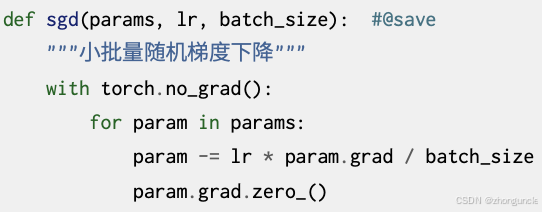
pytorch 踩坑笔记之w.grad.data.zero_() - 去冰七分糖 - 博客园
[Tacotron2/PyTorch] zero_grad() unexpected keyword argument · Issue ...
Google Colab
解决 PyTorch 梯度累积:optimizer.zero_grad() 机制详解与实践
LoRA Mathematics: Low-Rank Adaptation Formulas & Gradients ...
Why there isn't a `set_to_none` option for `zero_grad()` in libtorch ...