Showing 120 of 120on this page. Filters & sort apply to loaded results; URL updates for sharing.120 of 120 on this page
Zero grad optimizer or net? - PyTorch Forums
Zero grad optimizer or net? - Uncategorized - PyTorch Forums
Zero Grad Pytorch : CUDA Automatic Mixed Precision examples – IQLV
Zero grad on single parameter - PyTorch Forums
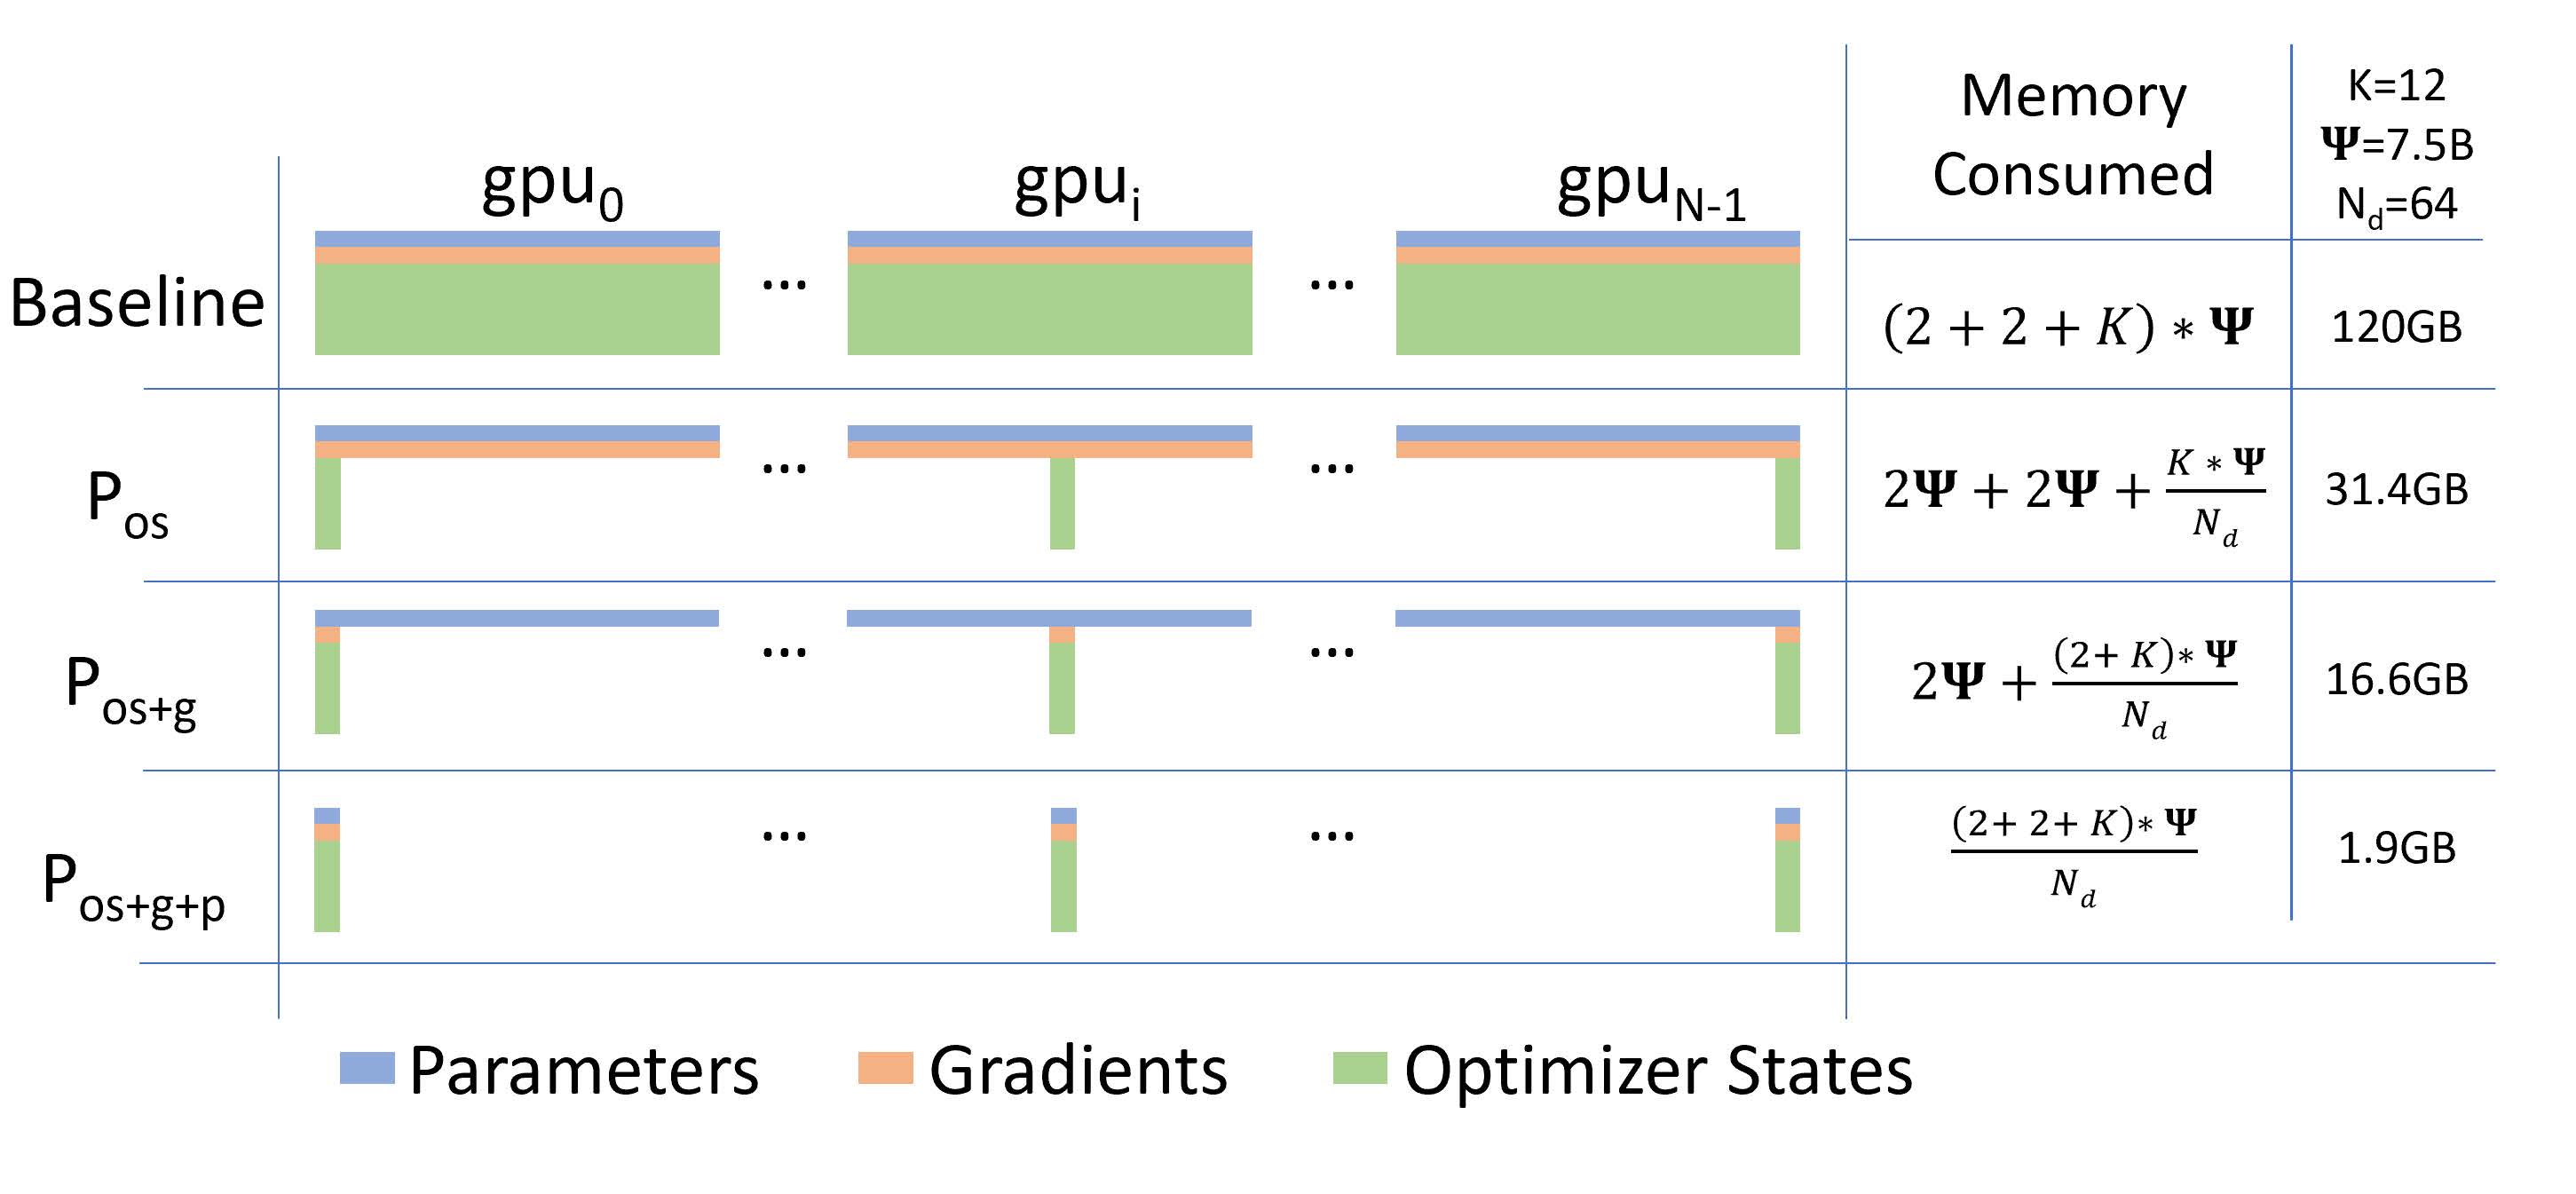
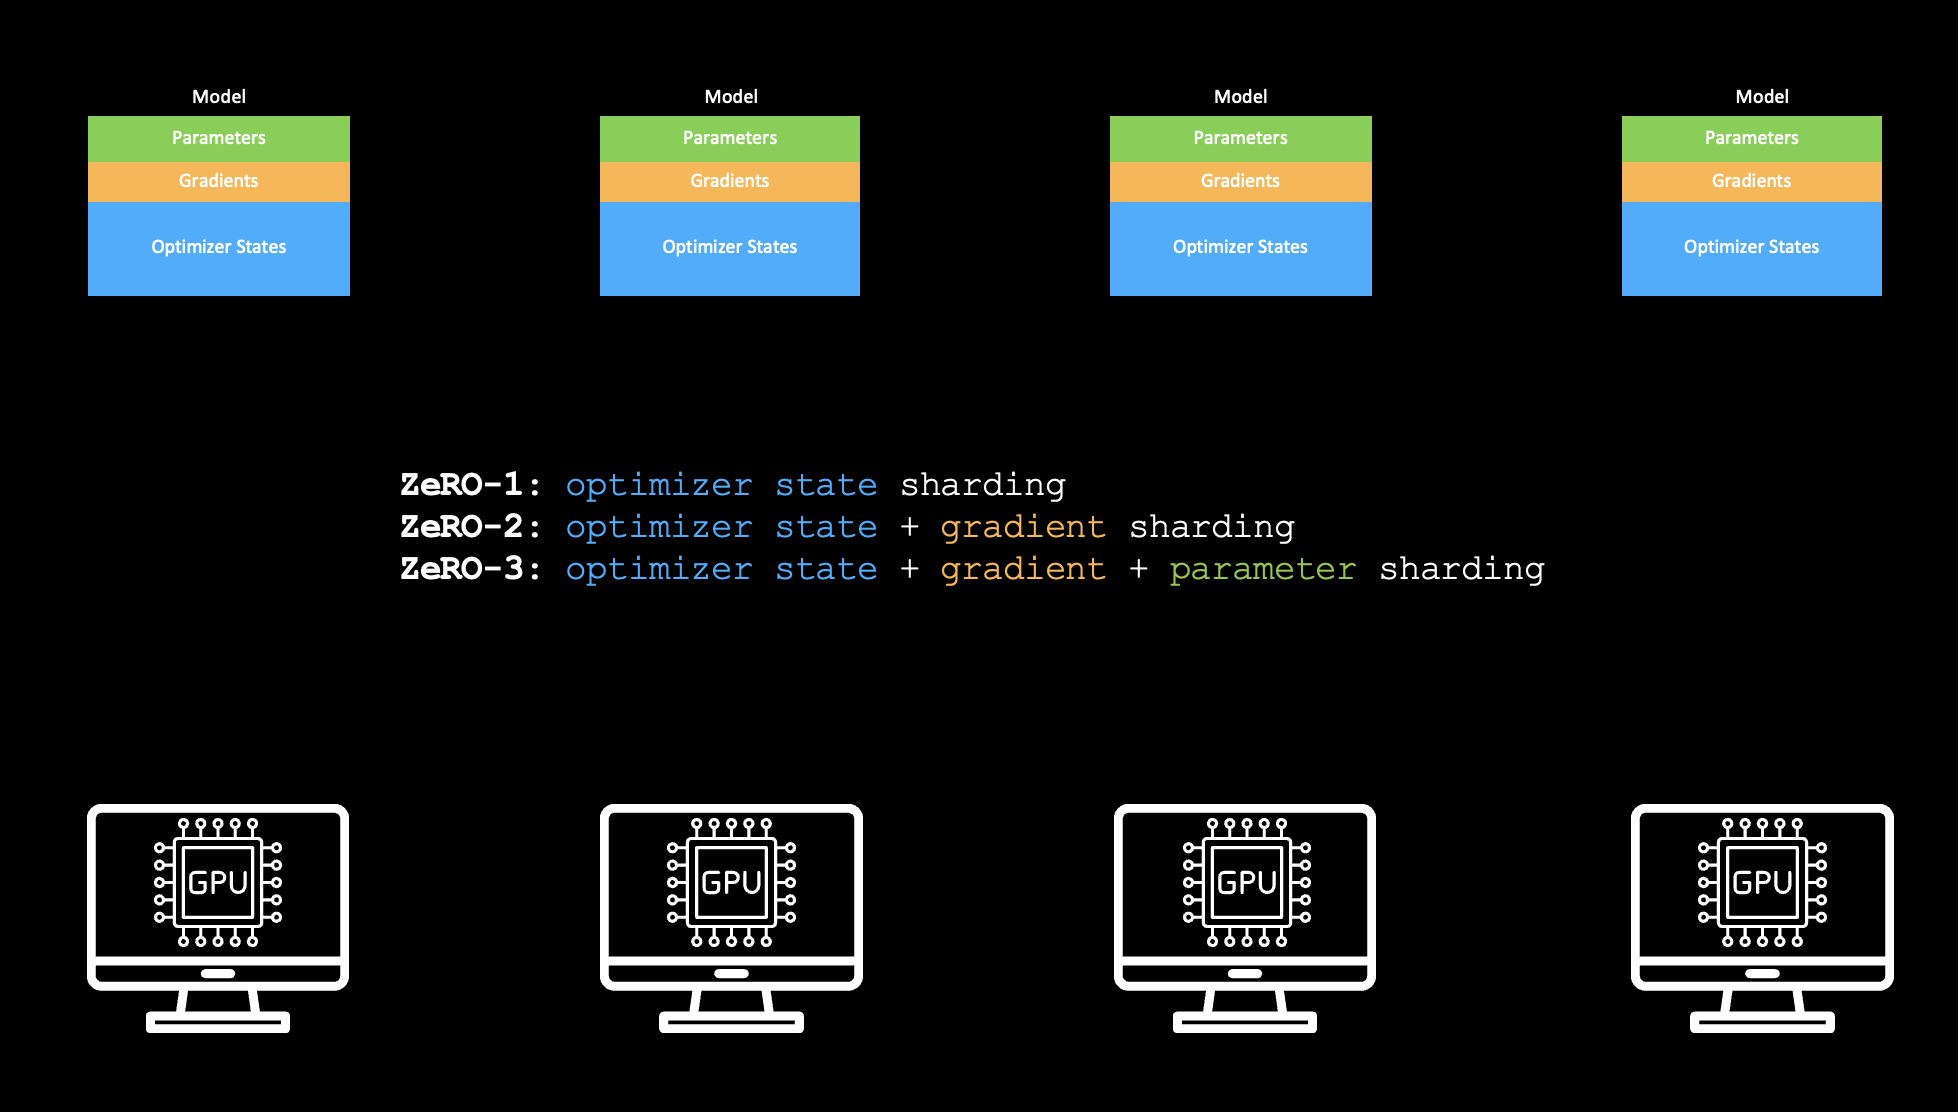
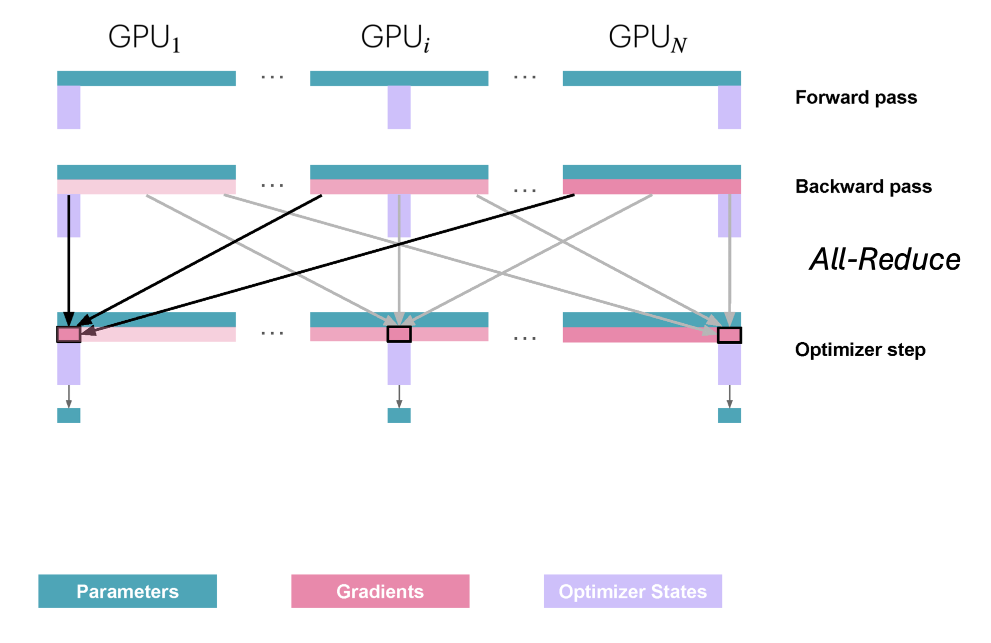
Zero Redundancy Optimizer (ZeRO) - OneFlow
Zero Redundancy Optimizer (ZeRO) 系列解析 - 知乎
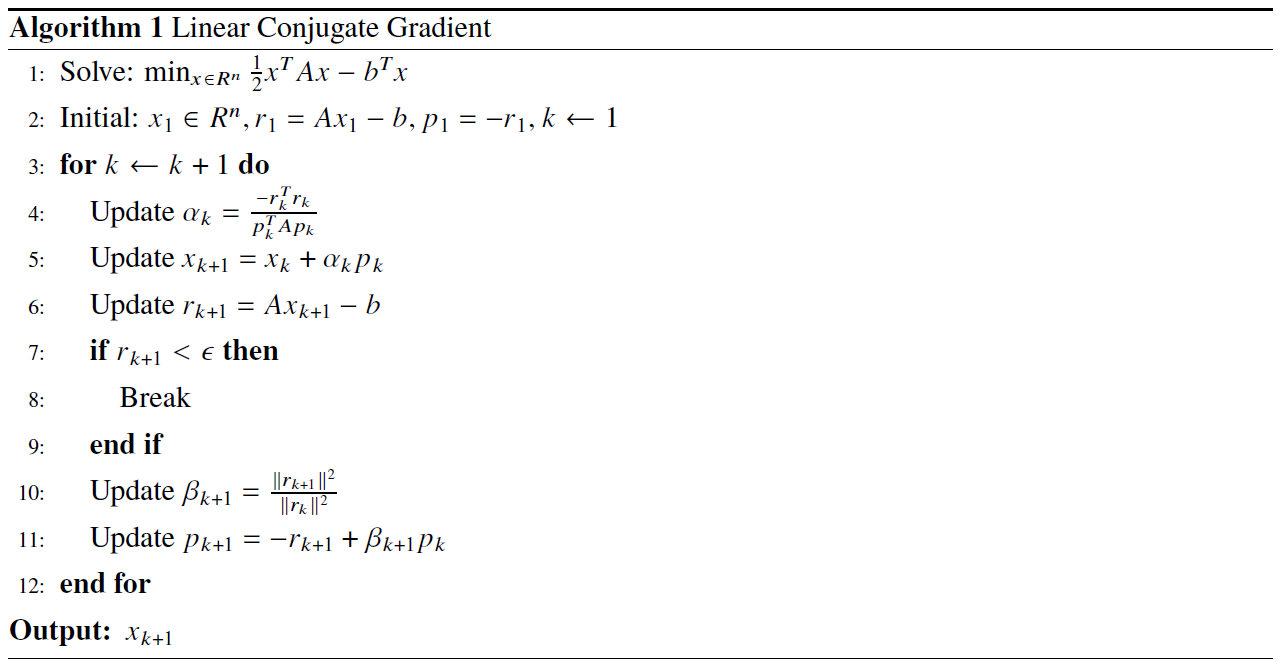
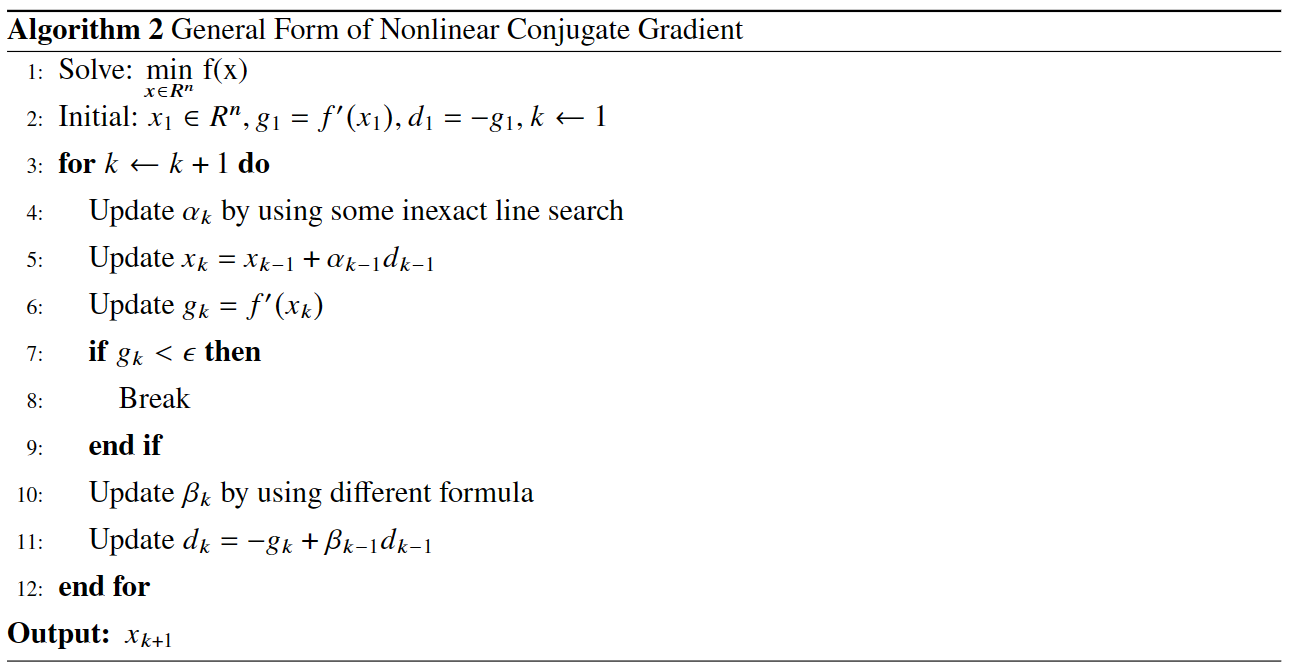
GitHub - RyunMi/NCG-Optimizer: PyTorch optimizer based on nonlinear ...
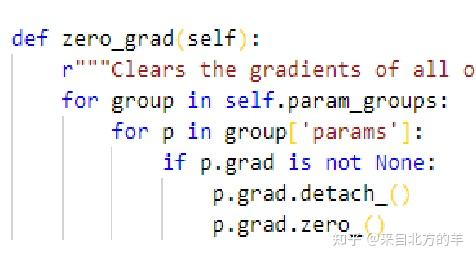
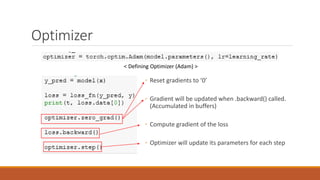
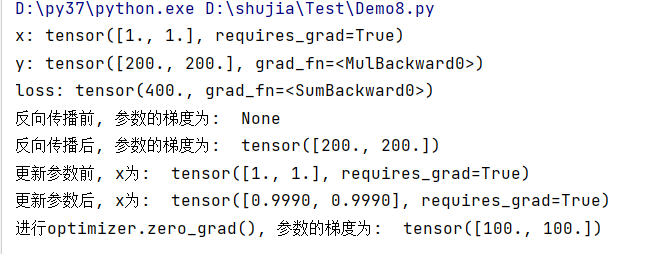
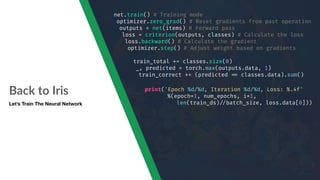
Zero PyTorch Gradients | optimizer.zero_grad()
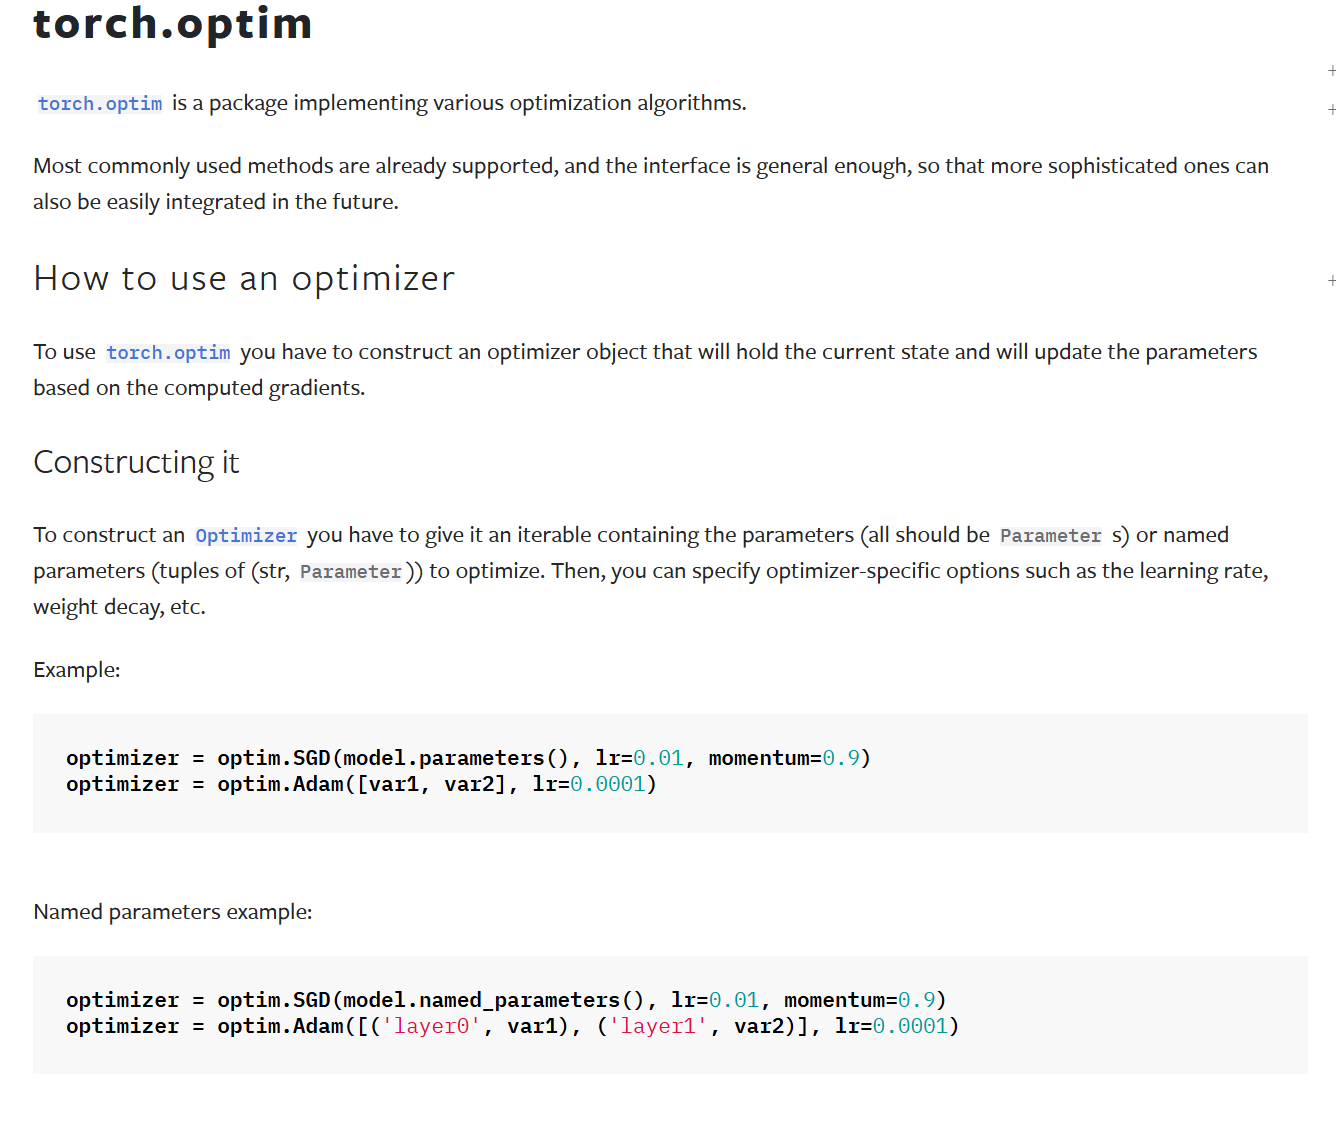
PyTorch optimizer | How to use PyTorch optimizer?
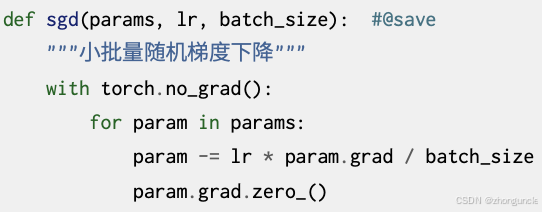
optimizer.zero_grad()和loss.backward()_不加optimizer zero grad会怎么样-CSDN博客
Why Do We Need to Zero Out Gradients in PyTorch?
ZeRO: Zero Redundancy Optimizer,一篇就够了。 - 知乎
optimizer
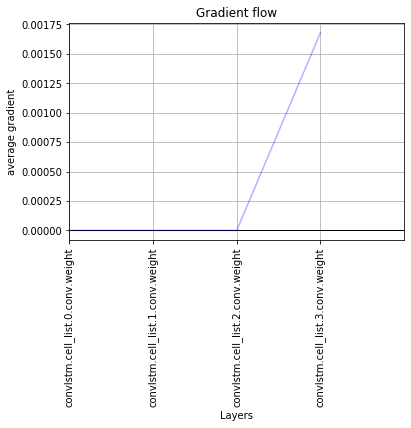
Gradients are always zero - autograd - PyTorch Forums
PytorchAPI的使用及在GPU的使用和优化_pytorch optimizer gpu-CSDN博客
Optimizer ignoring loss? - PyTorch Forums
关于pytorch中zero_grad() 梯度清零_paddle zero grad-CSDN博客
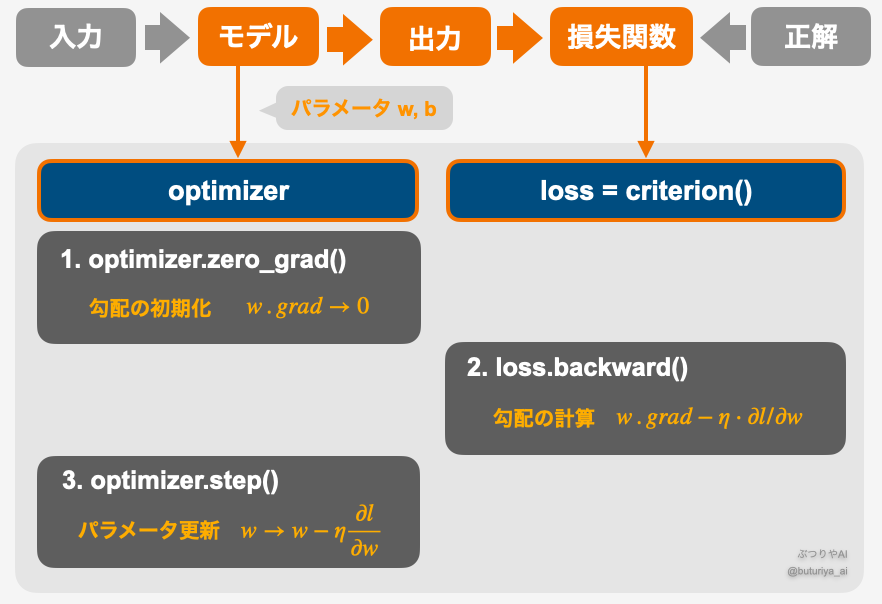
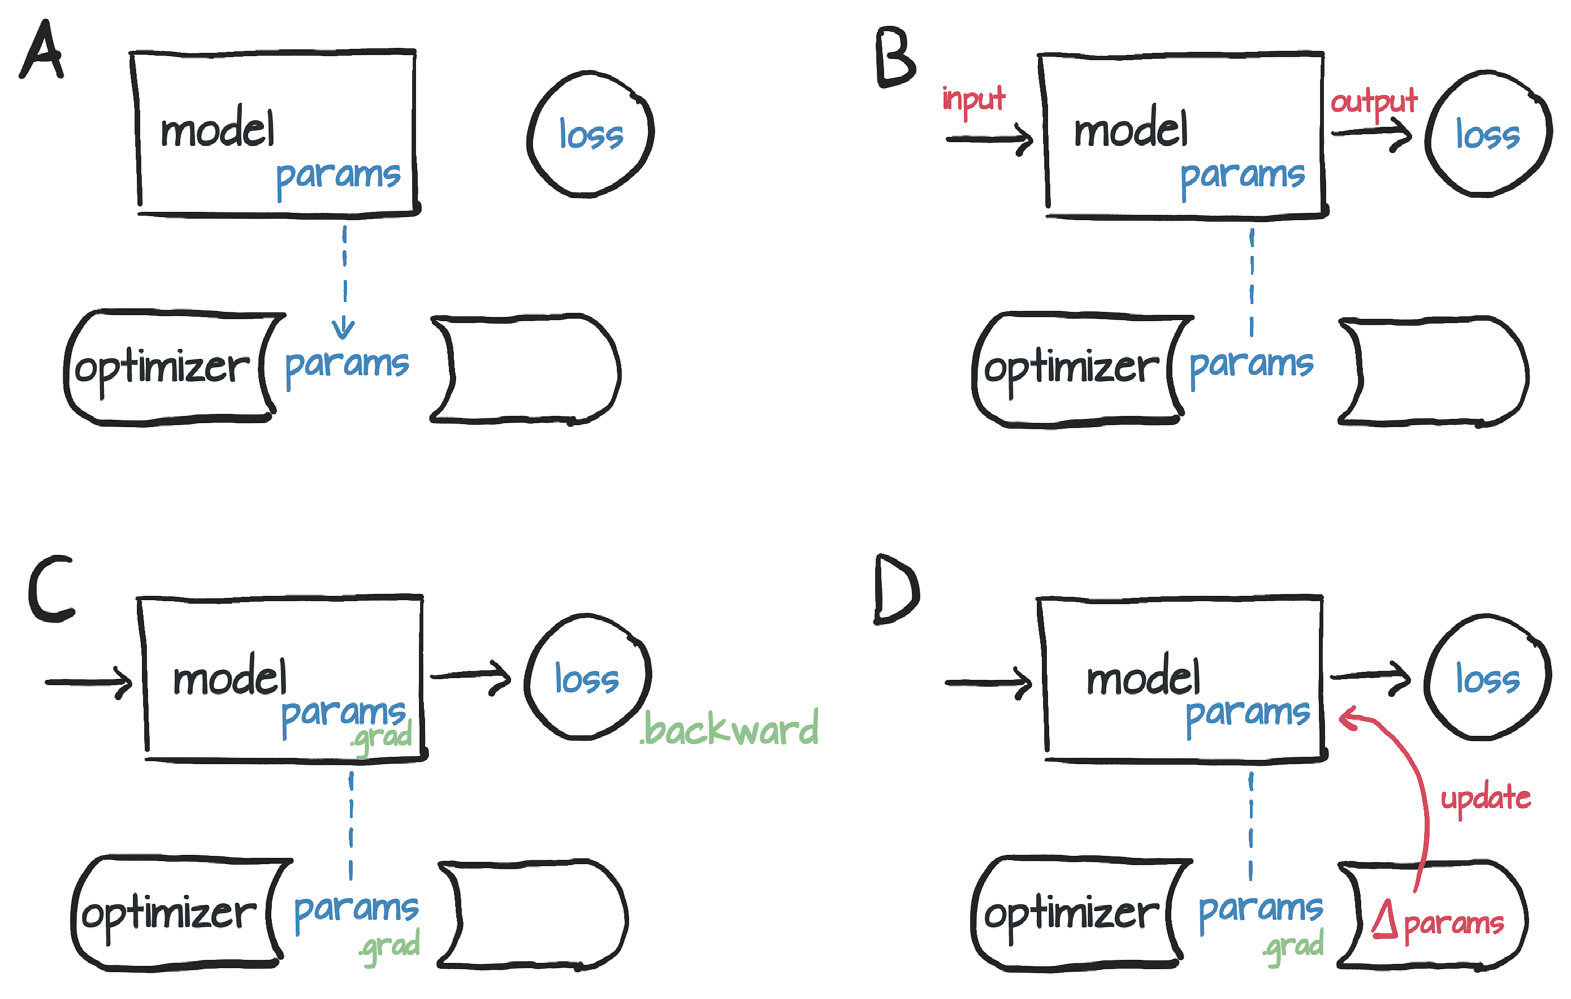
【PyTorch入門】Tensor の「自動微分」と「誤差逆伝播」を徹底解説|Tensorとoptimizerで学ぶ学習の流れ | ぶつりやAI
PyTorch Training Loop: Don't Forget optimizer.zero_grad() | Yokeswaran ...
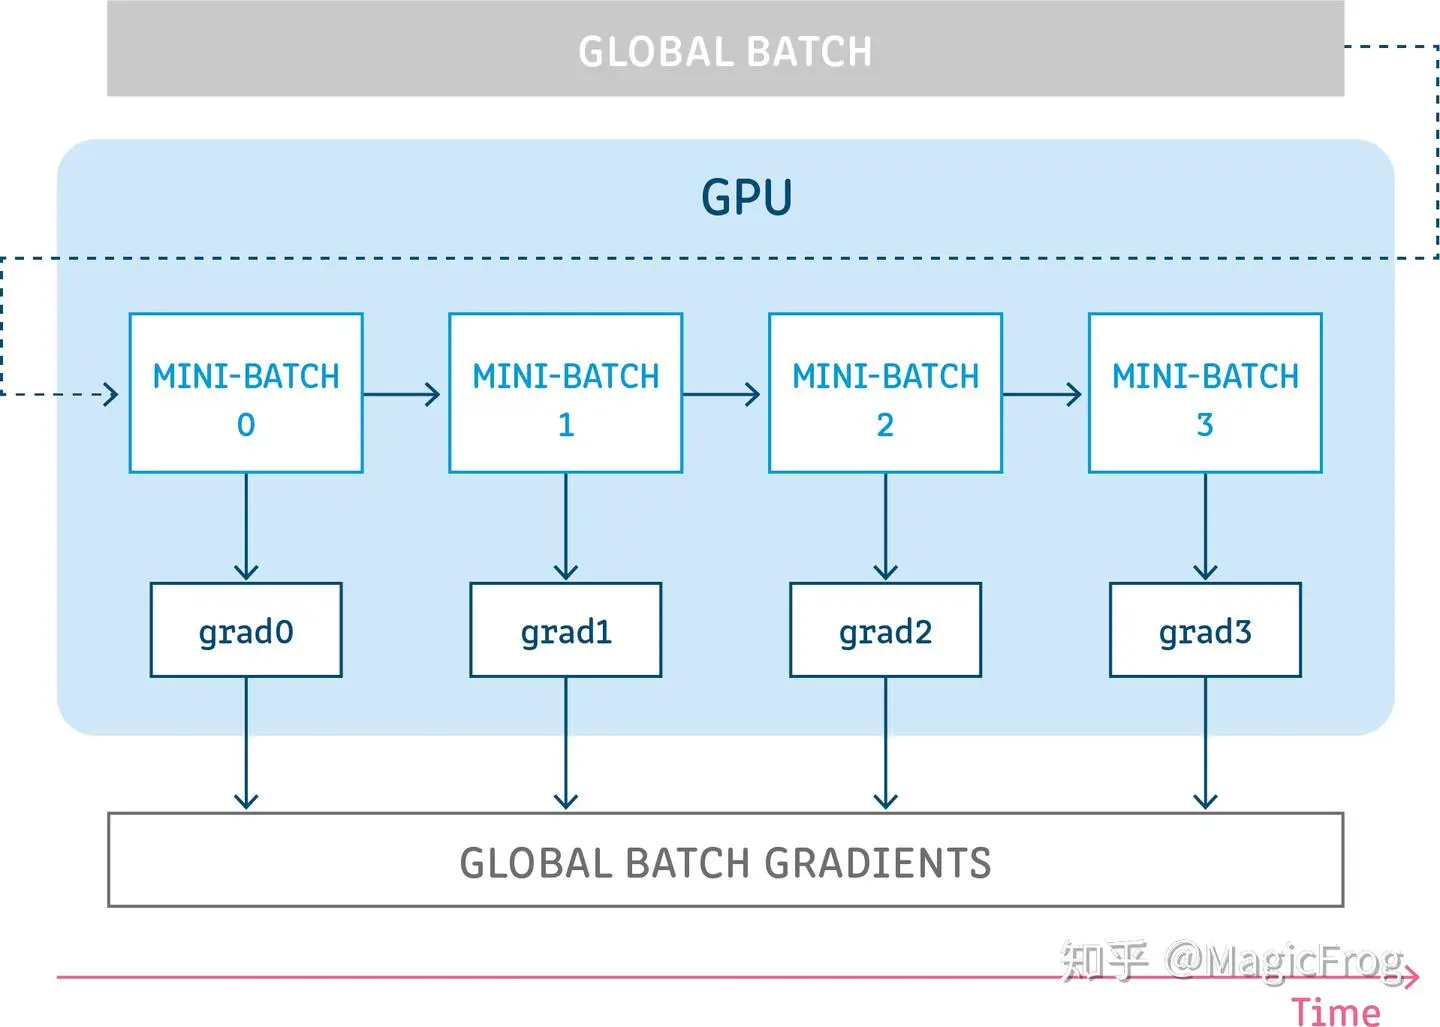
PyTorch 模型训练之并行篇
optimizer.zero_grad()-CSDN博客
【pytorch系列】优化器optimizer的使用与常用优化器-CSDN博客
【PyTorch】PyTorch 核心机制及其常用模块_nn.batchnorm2d-CSDN博客
Gradient Accumulation in Detectron2 - autograd - PyTorch Forums
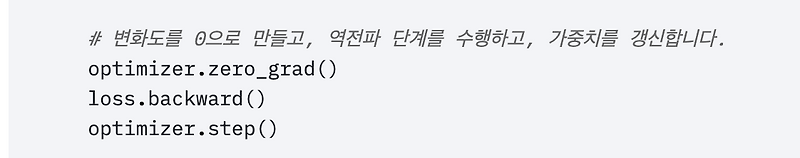
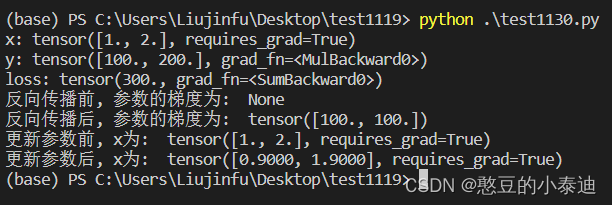
【截图留存】理解optimizer.zero_grad(), loss.backward(), optimizer.step() - 知乎
with torch.no_grad中optimizer.step和.zerograd顺序问题 - 知乎
optimizer.zero_grad()는 왜 사용하는가?
optimizer.zero_grad()에 관한 질문입니다 - 인프런 | 커뮤니티 질문&답변
python - Why do we need to call zero_grad() in PyTorch? - Stack Overflow
pytorch复习笔记--loss.backward()、optimizer.step()和optimizer.zero_grad()的用法 ...
[파이토치 기초] model.zero_grad() , optimizer.zero_grad() 쓰는 이유?
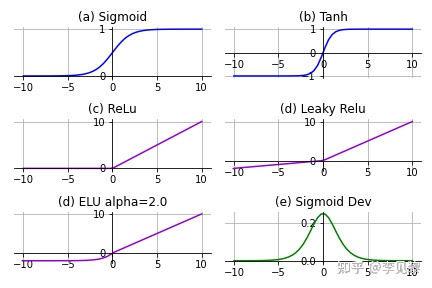
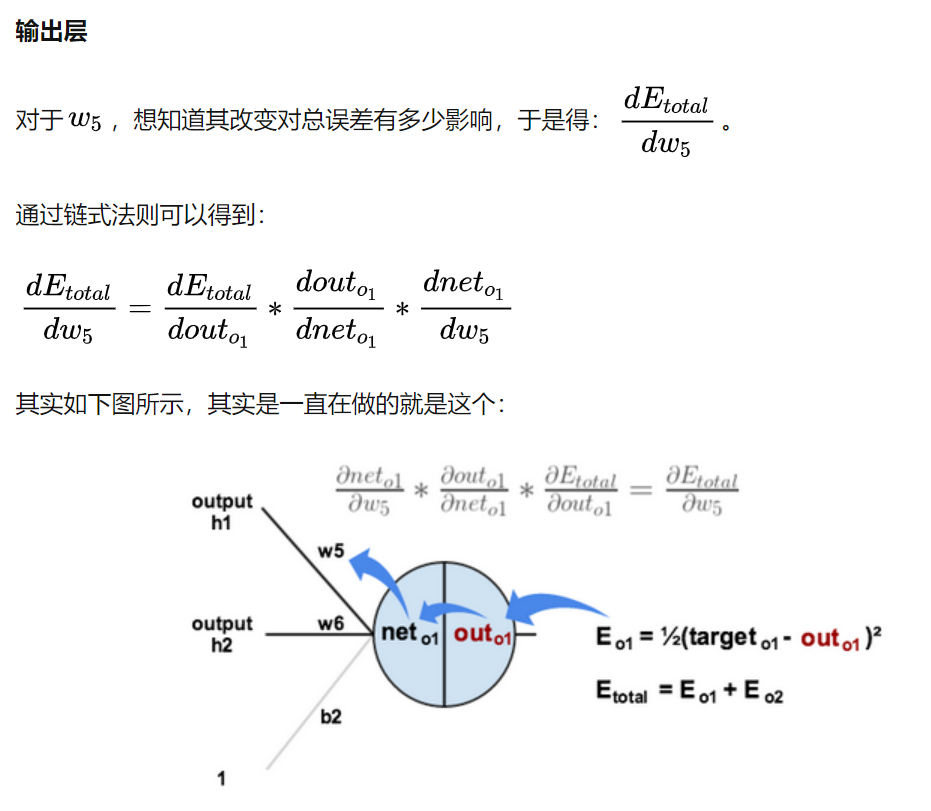
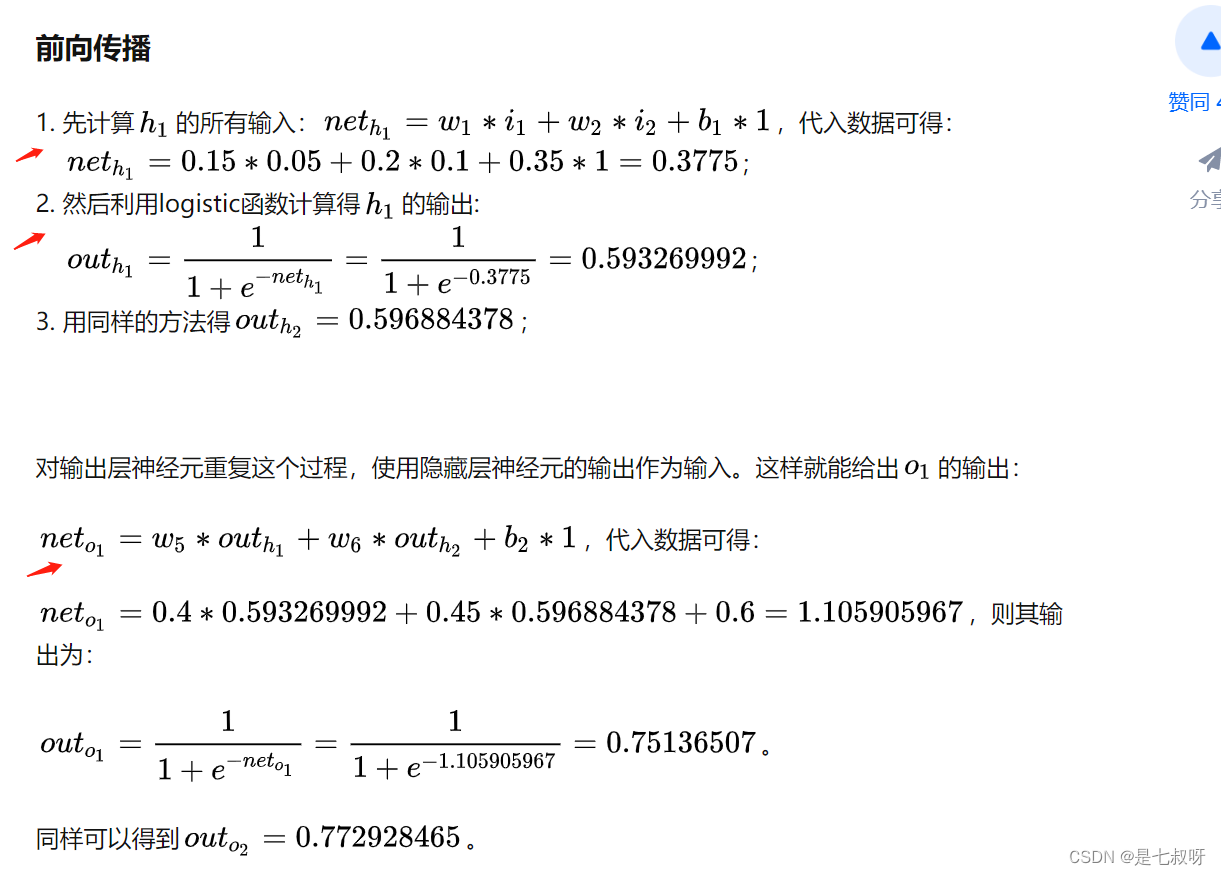
[深度学习]激活函数(Sigmoid等)、前向传播、反向传播和梯度优化;optimizer.zero_grad(), loss ...
pytorch里巧用optimizer.zero_grad增大batchsize - 知乎
[读书笔记] Deep Learning with Pytorch -- Chapter 4 | Pims的博客
About optimizer.zero_grad() · Issue #1 · caoymg/APR-PyTorch · GitHub
some question about the position of 'optimizer.zero_grad()' · Issue ...
[pytorch] nn.module의 zero_grad VS optimizer의 zero_grad의 차이
The position where you write *optimizer.zero_grad()* · mrdbourke ...
PyTorch: Connection Between loss.backward() and optimizer.step ...
Using Optimizers from PyTorch - MachineLearningMastery.com
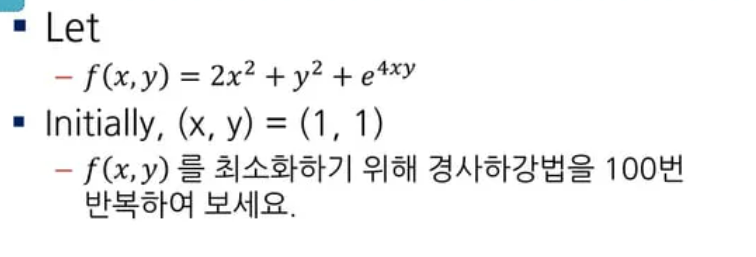
[딥러닝 홀로서기] Lec10. Assignment #1 Review
pytorch学习笔记十二:优化器_pytorch 优化器-CSDN博客
Decentralized optimization and multiple dimension optimization ...
pytorchのモデル/オプティマイザのzero_grad()の違い - 学んだことメモ
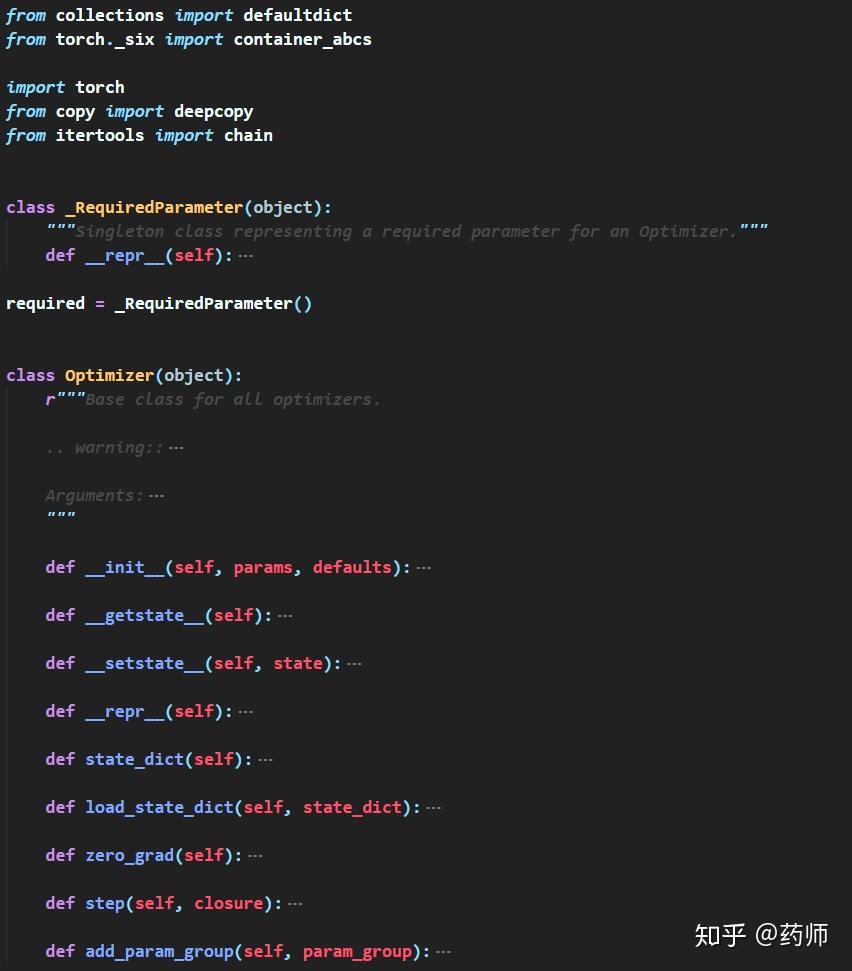
Custom Optimizers in Pytorch - GeeksforGeeks
A weird zero_grad problem - autograd - PyTorch Forums
PyTorch tarining loop and callbacks · All things
In PyTorch, why do we need to call optimizer.zero_grad()? | by Lazy ...
Google Colab
Pytorch学习笔记(7):优化器、学习率及调整策略、动量_pytorch优化器学习率和正则化-CSDN博客
【PyTorch】优化器 torch.optim.Optimizer - 知乎
pytorch tensor维度;tensor求导 backward、获取梯度grad;optimizer梯度更新zero_grad、step ...
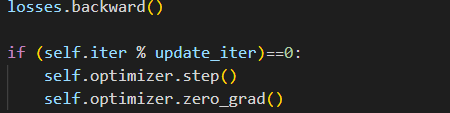
Option of doing optimizer.zero_grad(set_to_none=True) with accumulate ...
AWS Neuron周辺のre:Cap - Speaker Deck
Pytorch优化器及其内置优化算法原理介绍 - 知乎
41 optimizer.zero_grad()
《Pytorch深度学习实践》ch4-线性回归-CSDN博客
pytorch学习笔记:优化器_optimizer state-CSDN博客
Make True the default for set_to_none in Optimizer.zero_grad for 2.0 ...
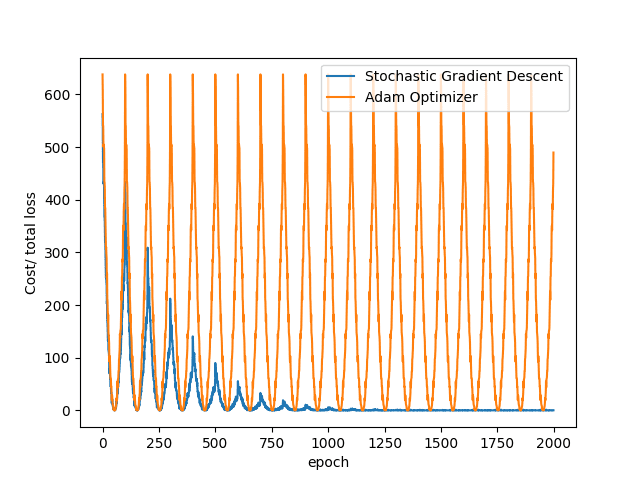
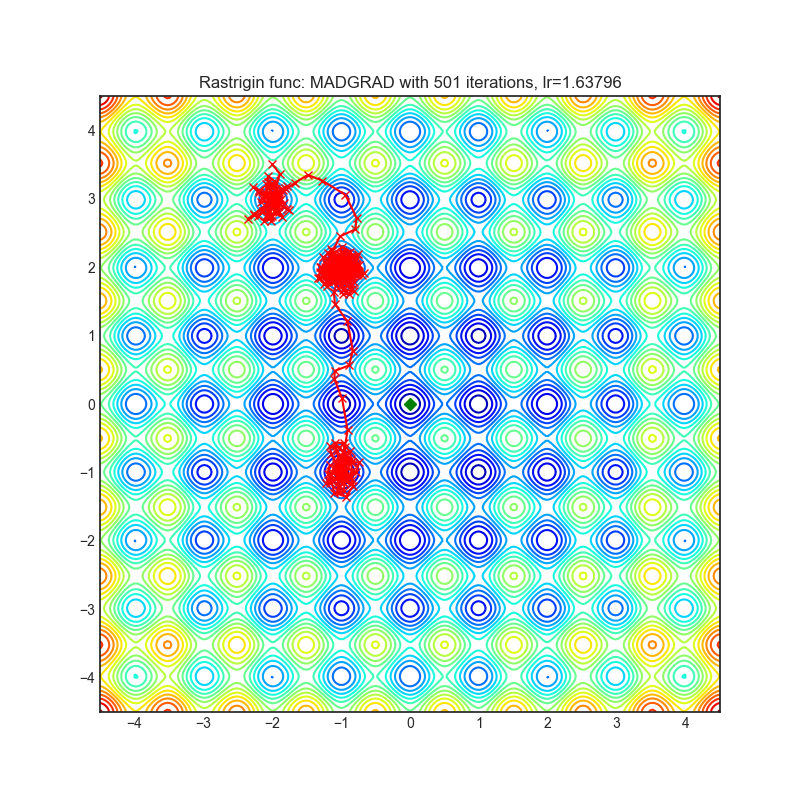
Pytorch——可视化不同的优化器效果_优化器可视化-CSDN博客
optimizer和loss.backward()相关函数_optimizer.backward(loss)-CSDN博客
pytorch-- 多维特征处理_maxout pytorch-CSDN博客
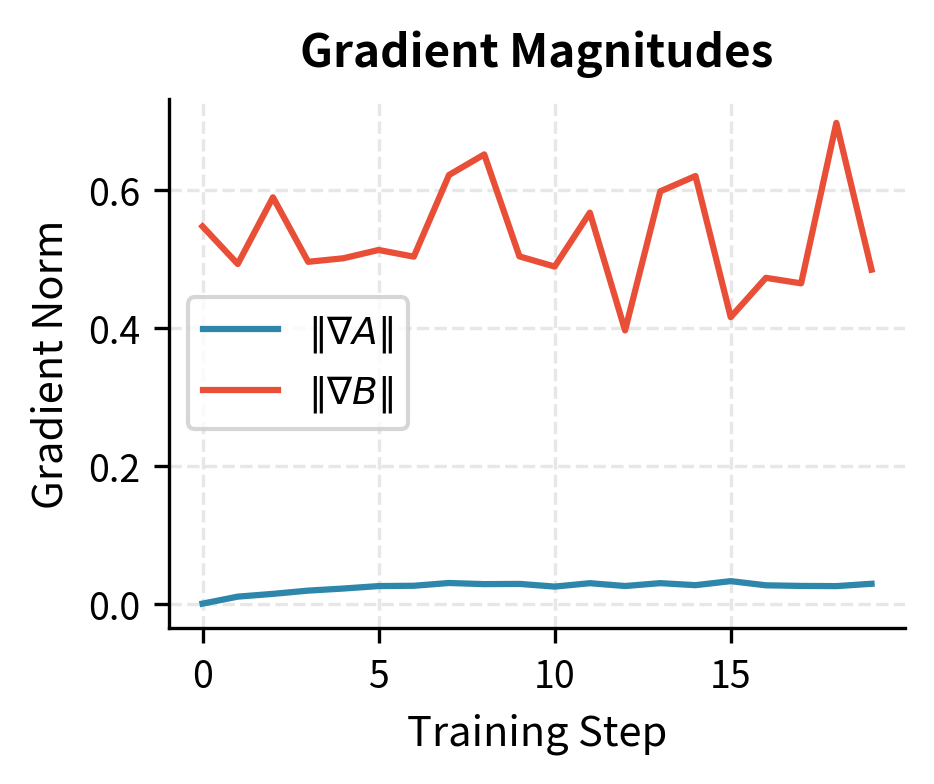
LoRA Mathematics: Low-Rank Adaptation Formulas & Gradients ...
Gradient of output is 0 - autograd - PyTorch Forums
PyTorch and Transfer Learning | PDF
optimizer.zero_grad()の意義
8.24 学习-CSDN博客
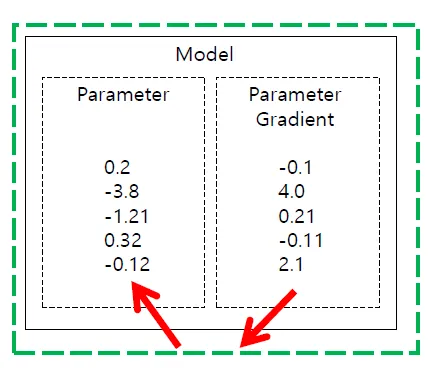
optimizer.zero_grad和model.zero_grad有啥区别? - 知乎
[12일차] 강화학습
From Single GPU to Clusters: A Practical Journey into Distributed ...
PyTorch の zero_grad() は何をしているか
PyTorch优化器详解:zero_grad()、loss.backward()、step() 的妙用_损失函数 zerograd-CSDN博客
Allow fused optimizer's `zero_grad` to call `_foreach_zero_` · Issue ...
深度神经网络将requires_grad设为True梯度全为0,step()后还会更新梯度问题的原因_optimizer.step()后有梯度 ...
第七章 Pytorch构建模型详解【构建CIFAR10模型结构】_cifar10 模型结构-CSDN博客
【第1周】深度学习基础-CSDN博客
解决 PyTorch 梯度累积:optimizer.zero_grad() 机制详解与实践
[PyTorch] AutoGrad&Optimizer
pytorch: Model.zero_Grad () and Optimizer.zero_Grad (), Net.parameters ...
Issue with LBGFS optimizer: `optimizer_.zero_grad` no longer called ...
Medium
Transformer 估算 101 - 智源社区
처음부터 시작하는 딥러닝 유치원 Ch08(1) - Linear Regression
optimizer.zero_grad() loss.backward() optimizer.step()原理和使用方法 - 知乎
model.zero_grid()与optimizer().zero_grid() - 知乎
深度学习常用优化器全图鉴(公式 & PyTorch 代码) - 知乎
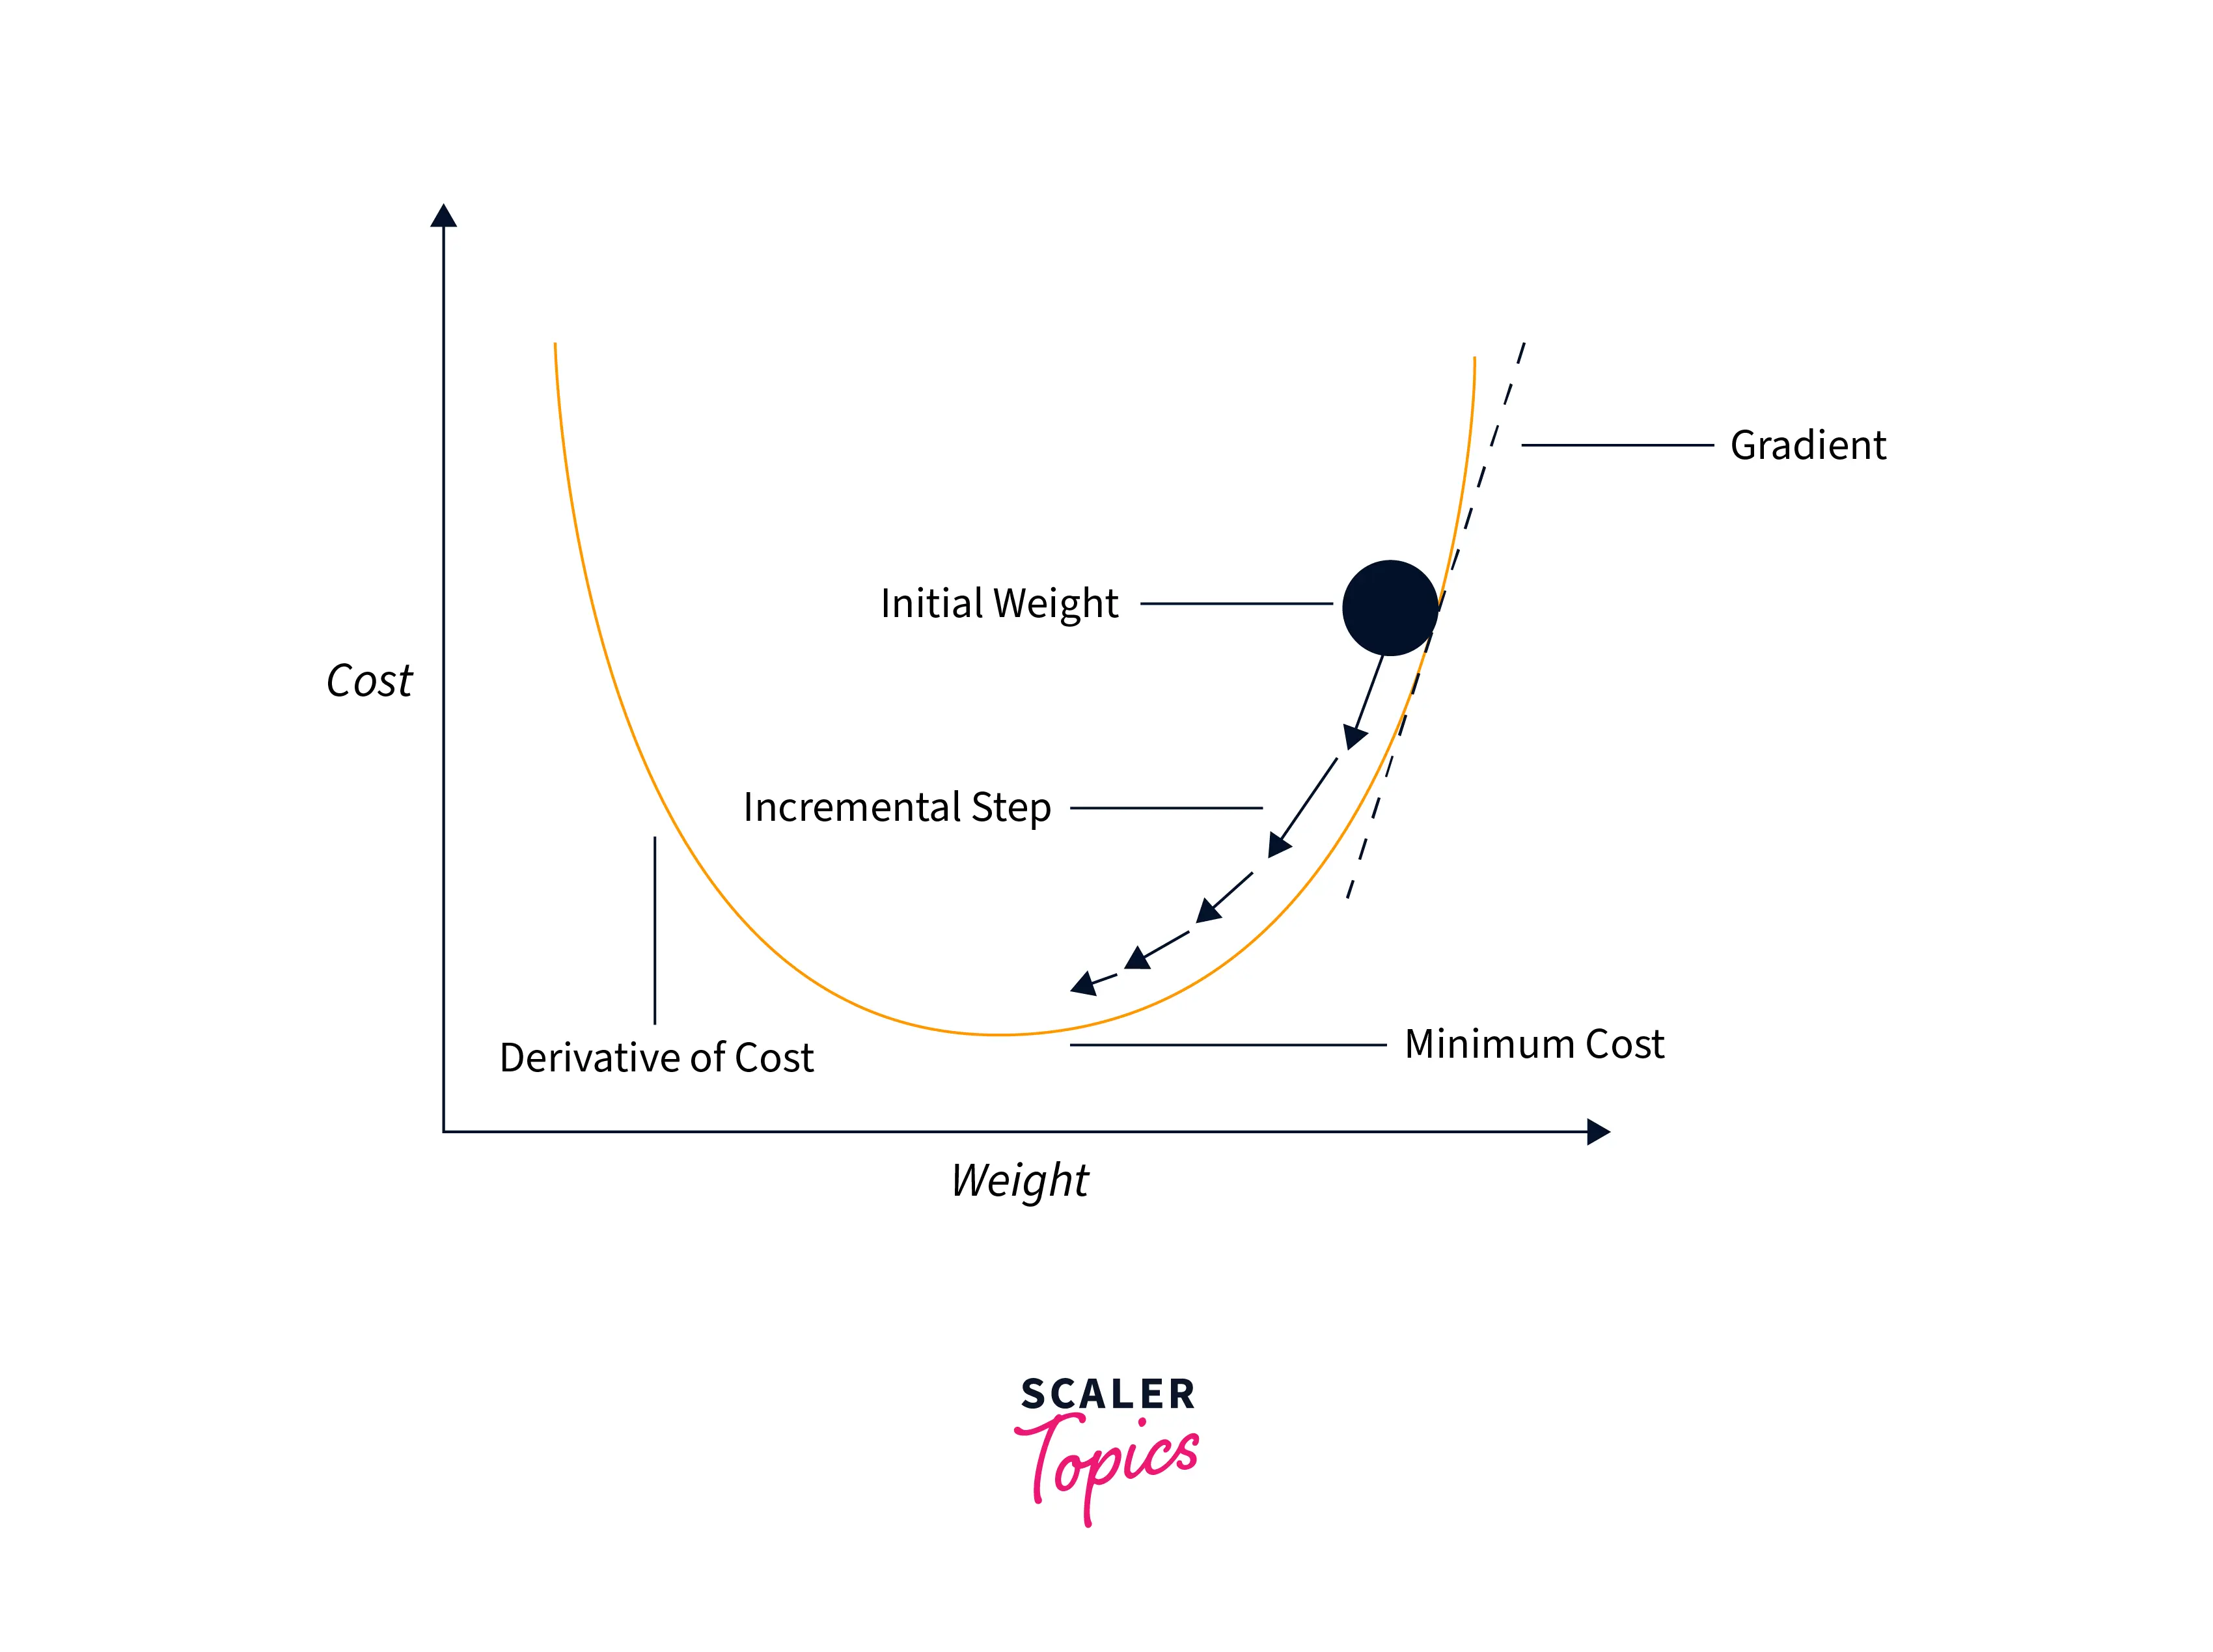
Gradient Descent with PyTorch – Mastering AI Bootcamp
对比pytorch的优化器实现及使用方法 - 知乎
GitHub - jettify/pytorch-optimizer: torch-optimizer -- collection of ...
ncg-optimizer · PyPI
【Pytorch 深度學習筆記】Autograd 自動微分機制與 Optimizers 優化器 | Yaoの程式小窩
Introduction to Model Optimization in PyTorch
Backward is too slow - PyTorch Forums
Pytorch学习记录(updating)_pytorch loss记录-CSDN博客
Machine learning with py torch | PDF
深度学习:GoogLeNet核心思想详细讲解 - 知乎
What's the difference between model.zero_grad() and optim.zero_grad ...
深度学习之PyTorch(下)损失函数、参数更新方法、附经典案例在PyTorch中的应用-CSDN博客